posts/a16z-osworld-computer-use-agents.md
agent 用电脑超过人类了,你还是不敢把浏览器交给它
a16z 今天发了篇计算机操作 agent 的报告,里面有个细节比所有跑分都扎眼。他们采访了一个每月跑几百万次自动化任务的买家,问他底层用的是哪家模型,对方答不上来。不是商业机密不方便透露,是真不知道,也从来没想过要去知道。供应商在底下换模型,就像云厂商换硬件,他只管任务有没有跑完。
a16z 给这事下了个判断,我觉得可以直接刻在每个做 agent 产品的人桌上。当你最重度的用户都不再看榜单,榜单就不再是故事本身。
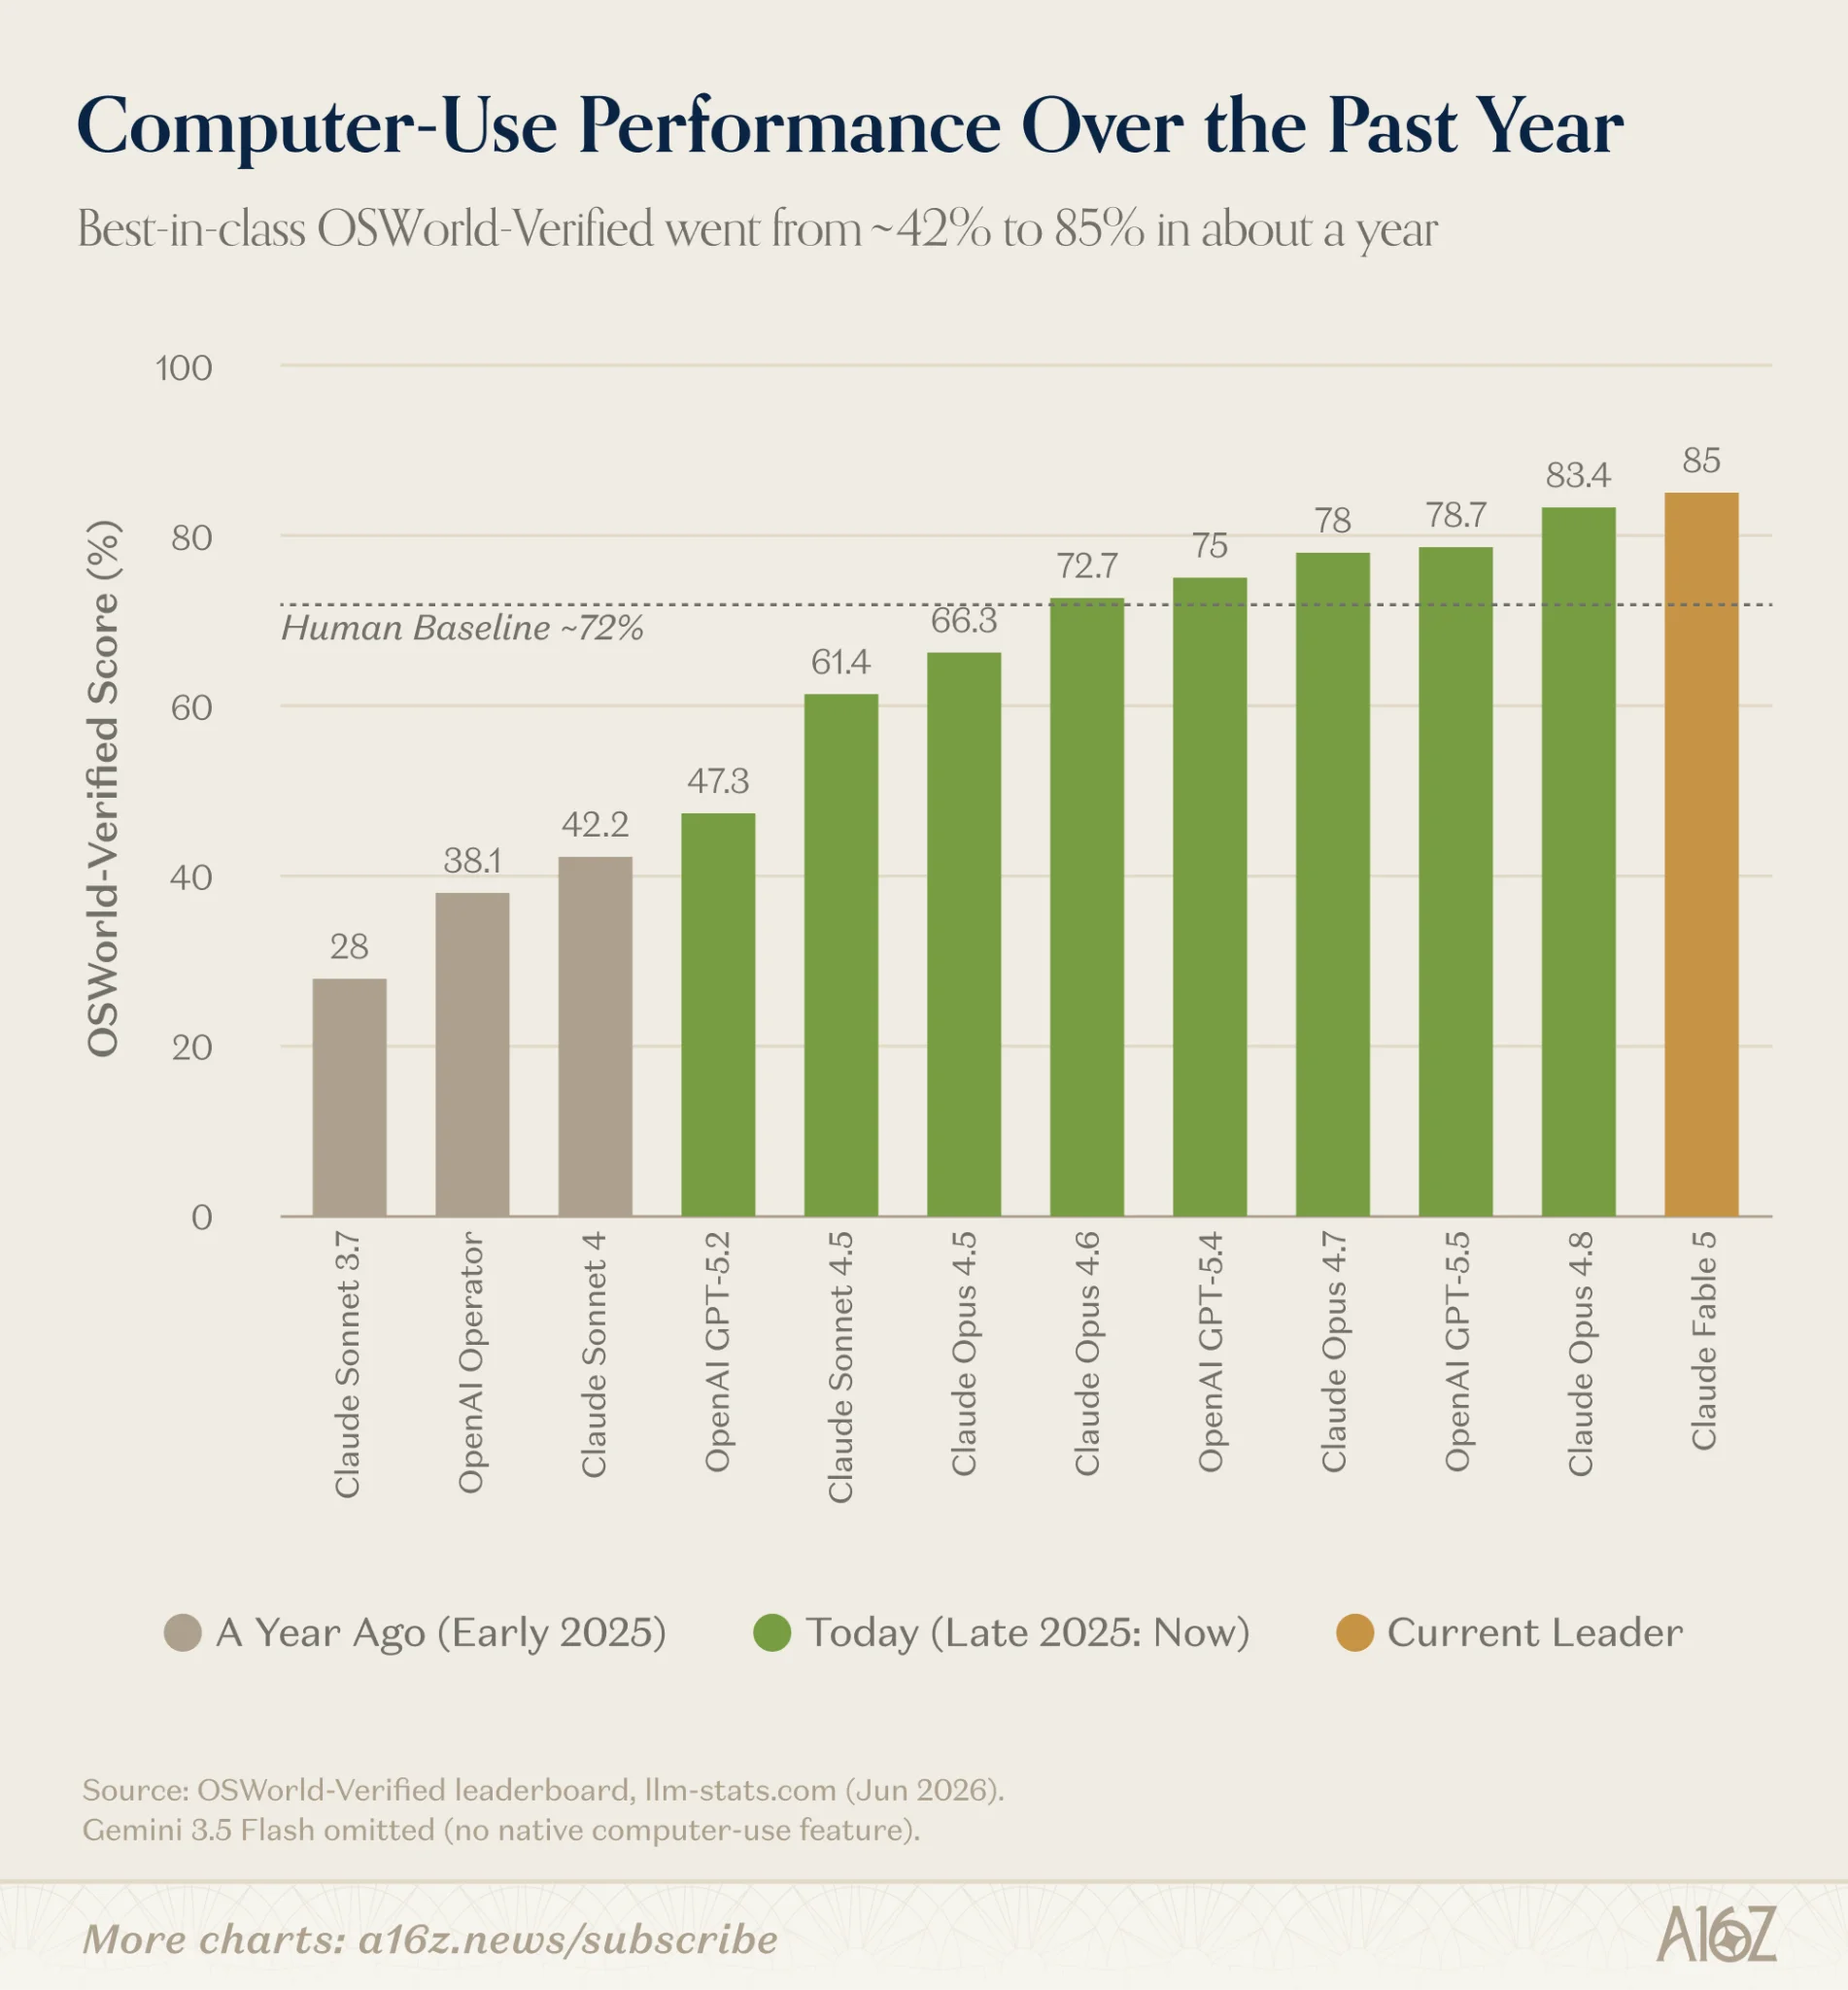
先把数字摆出来。报告引用的是 OSWorld-Verified 的成绩,这个基准你可以理解成让 agent 真的坐在一台电脑前干活,Ubuntu、Windows、macOS 上的真实桌面任务,改设置、填表单、倒腾文件、跨应用搬数据,按任务完成率打分。一年前最好的模型考 42 分,今天最好的考到 85 分,Claude Fable 5 领跑。而人类测试员在同一套任务上的成绩,大概 72 分。
也就是农历还没过完两个年,agent 用电脑这件事就从「demo 都磕磕绊绊」变成了「比人类测试员考得高」。
好家伙。
按互联网的惯性,接下来的故事应该是各家发布会轮流刷分,媒体轮流写「AI 已经能替你打工」。但 a16z 这篇报告有意思的地方恰恰是往反方向走的,他们没有停在 85 分,而是去找了一圈真正把 computer-use agent 跑在生产环境里的公司,一家家问,你们到底在为什么付钱。
答案跟榜单几乎没关系。
我自己的日常工作就是给模型搭脚手架的,行话叫 harness,人话就是让模型真正能干活的那层工程,重试、验证、超时看门狗、上下文管理全堆在这层。所以读到报告里那句「决定生产部署成败的是模型周围的一切」时,我是真的想拍桌子。不是因为它新,是因为终于有人拿着采访数据把这话讲出来了。
先讲讲 85 分为什么不等于能用。
OSWorld 算的是任务完成率,85 分翻译过来就是 100 个任务里挂了 15 个。听着还行对吧,但业务流程的逻辑不一样,一条流程要每一步都成功才算成功。你想想看,一个后台流程串五步,每步 85 分,整条链路的成功率就掉到 44 分了。更要命的是,后台工作不吃「差不多」这一套,如果每个输出都得有人复查一遍,那等于一个人力都没省下来。
报告里打了个比方我很喜欢,这跟现在写代码的处境一模一样,稀缺的早就不是写代码本身,是敢为这段代码作保。
然后是那 15 分到底失败在哪。报告总结出两类翻车姿势,我搬运一下,因为这两类我在自己的活儿里全都撞见过。
第一类,输出没法交叉验证。举的例子是让 agent 从合同里把付款条款抄进 ERP,合同写的是 net 60,就是 60 天账期,agent 读成了 net 30。这条记录看起来完美,格式对、字段全、肉眼检查毫无破绽,没有任何告警会响。直到发票开出去,对方财务打电话过来,才有人知道错了。
第二类更阴间,任务跑完的那一刻根本没有成功信号。例子是让 agent 去保险门户提交理赔,页面显示「已收到」,任务标记完成,皆大欢喜。两天后理算员往办公室打了个电话,说保单号需要人工确认一下才能继续。如果当初是个人提交的,接起电话三十秒就搞定了。可是提交的是 agent,它根本不知道有这么通电话存在,那笔理赔就安安静静地卡死在流程里。
没有报错,没有异常,没有日志。就是一通没人接的电话。
这两个例子的共同点是,翻车成本和跑分完全不对称。agent 答对 85 题给你省的钱,可能不够一单 net 60 读成 net 30 的损失。做 agent 产品真正的门槛在这,不在榜单上。
那生产环境里现在到底什么在跑,什么跑得动。
报告的措辞是 protocol following,我翻译成「照章办事」。标准化、重复、路径清清楚楚的活儿,agent 干得最稳。更新 CRM 记录、登录政府和保险门户扒数据、处理零售订单、跑 ServiceNow 的 IT 工单。这些活儿的共同点是没有干净的 API,人类原本就是靠手动点 UI 在续命,agent 接的就是这段。
几个真实案例的数字有点子牛逼。一家消费品数据平台每月跑一千五百万到两千万次门户交互,他们的玩法是把 agent 当成「自愈兜底」,平时跑的还是手写爬虫脚本,等哪天零售商门户半夜改版把脚本干趴了,agent 自己上去诊断、修复、接着跑,工程师连报错都没看见。就这一手,让他们把维护爬虫的团队砍了一半。一家全球系统集成商跑着 27 条 computer-use 工作流,每天处理一千五到两千一百张 IT 工单。还有家做招聘的,候选人面试一结束 agent 就把数据填进招聘系统,用的还不是前沿模型,理由朴素得可爱,便宜的模型把我们要的都干了,而且干得不错。
注意一个细节,这些公司没有一家是把 ChatGPT 的 agent 模式或者 Claude 消费版拿来干活的。全是裸 API 加自己搭的执行环境,沙箱虚拟机、编排、验证、重试逻辑,一层层自己糊。模型厂商给的是一双手,怎么让这双手在客户的流程里不闯祸,是买家花钱买的东西。
报告里有个工程模式我必须单独拎出来讲,因为这是我见过对「agent 到底该在流程里站哪」最清醒的回答。
好几家公司不约而同用了同一招。agent 把工作流跑通第一遍之后,系统把这条路径缓存成确定性代码,之后的每一次执行都是跑代码,又快又便宜还不会抽风。模型退到幕后,只有代码断掉的时候才被叫回来,诊断、修复、重新缓存,然后接着退休。
你品品这个设计。跑代码的时候,agent 不在场。出事的时候,agent 才上场。它不是劳动力,它是那个待命的老师傅。
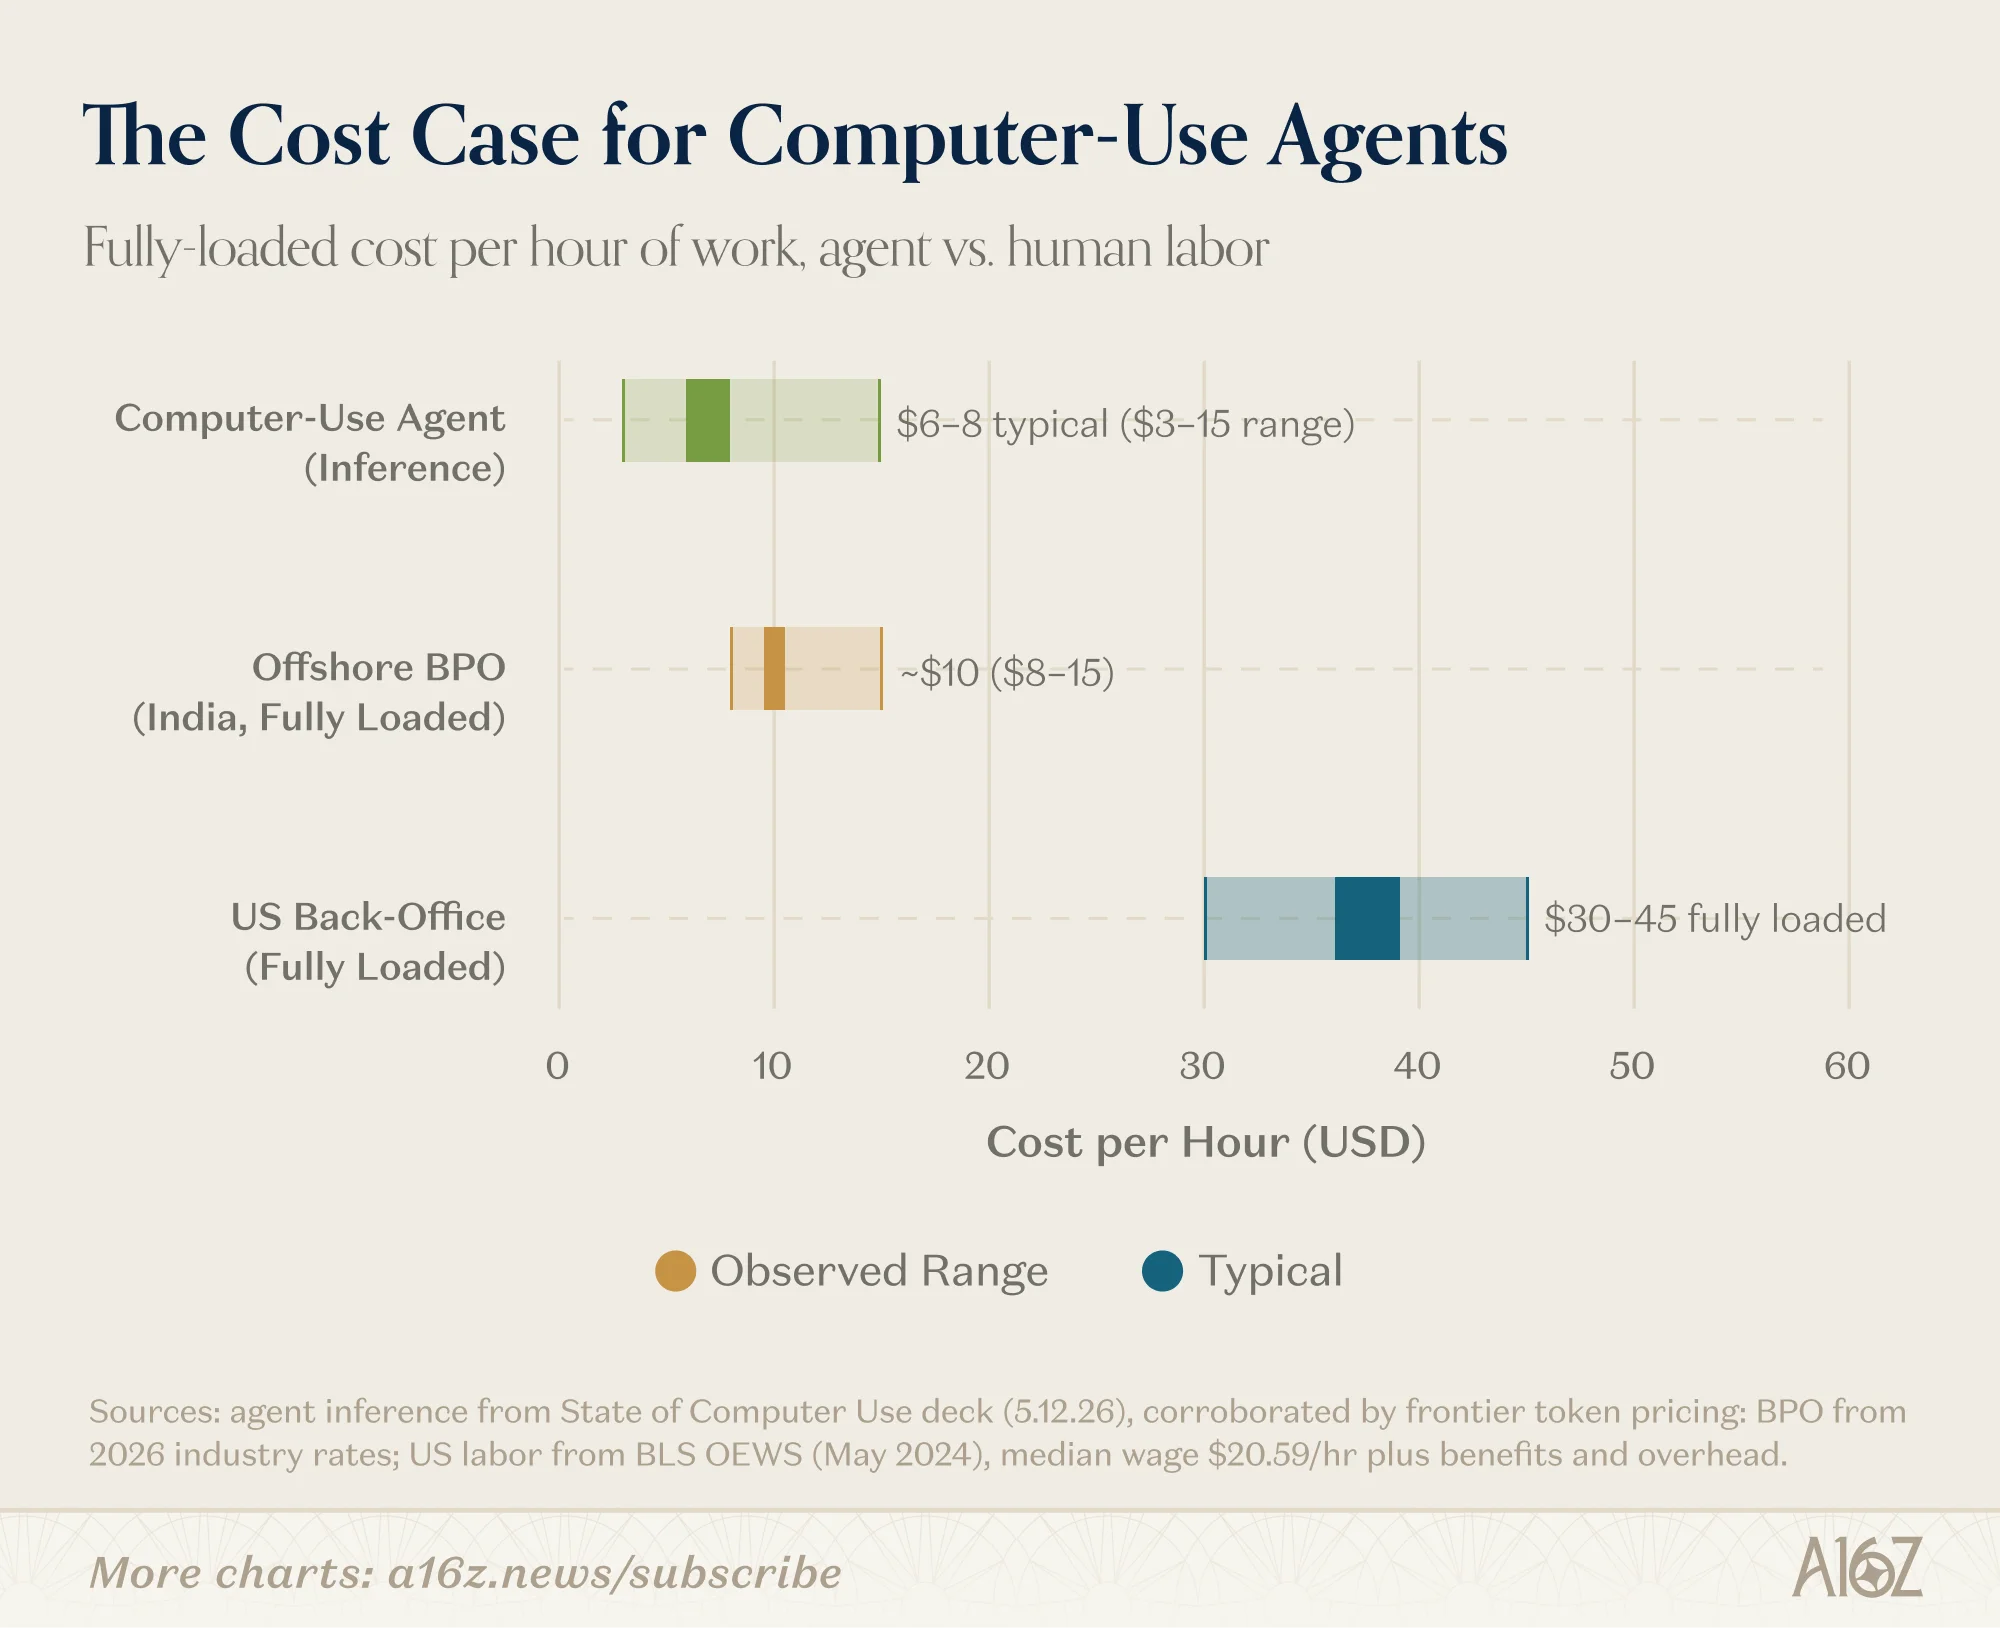
这套模式还顺手回答了成本问题。报告给的数字是,让前沿模型一帧截图一帧截图地盯着屏幕操作,一小时大概 6 到 8 美元,浮动区间 3 到 15,取决于截图频率和上下文背多重。对比一下,离岸外包一小时全成本约 10 美元,美国本土后台人力 30 到 45 美元。纯 agent 模式对外包只能算打平,但套上缓存这层壳,重复执行的部分成本几乎归零,账一下子就算得过来了。
速度反而是 agent 的短板,这点报告也没藏着。人两三分钟点完的活儿,agent 在纯截图模式下要八到十分钟。真正的卖点从来不是快,是它一天二十四小时在线,是需求翻十倍的时候不用招人。
写到这我想稍微泼一点冷水,给同样在做 agent 创业的朋友。
报告里最扎心的一段其实是讲护城河的。搭一个 computer-use agent 曾经很难,你得跟 Selenium、Playwright 或者后来的 Stagehand 搏斗,得自己录 DOM 拼流程。但这层执行层正在飞速变成大路货,跟当年 Claude Code 把 coding agent 的脚手架抽象掉是同一个剧本。点对按钮这件事,很快就不值钱了。
那什么值钱。报告的答案是 context,一家公司到底怎么干活的那些部落知识。内部黑话、格式偏好、出事了找谁、什么情况该升级给人、怎么验证输出是对的。这些东西全都写在 runbook 里、藏在权限配置里,甚至就存在某个老员工录的一段操作视频里。没有一条是通用的,每一条都专属于一家公司甚至一个组。
买家选供应商的标准也朴素到让人清醒。能不能不加班就看到省了多少小时,一个初级工程师能不能把它跑起来。就这两条。没人问你用的是不是最新模型。
怎么说呢,模型能力在这个市场里正在变成水电煤。你不会因为电压稳就爱上某家电网,你只会因为停电记住它。
往后看,报告点了三个方向,准确率、延迟、成本。延迟那条里藏了个我觉得最值得盯的信号,有团队已经不靠截图了,直接读操作系统的无障碍树来定位界面元素,快一大截。还有家叫 Standard Intelligence 的公司在拿一千一百万小时的视频数据训练通用电脑操作模型,30 帧每秒。一帧一帧截图这个又慢又贵的循环,看起来是个能被解掉的临时税,不是永久成本。
多 agent 编排那块倒是坦白,现在生产环境跑的几乎全是单 agent,一个模型一个任务一个会话。规划器拆任务、执行器并行跑的架构人人都在聊,但没有标准框架,做得好的团队全在手搓。谁能把这层编排抽象出来,谁就是下一个 Claude Code。
说实话这篇报告我读完最大的感受不是兴奋,是一种踏实。过去一年这个领域的叙事一直飘在「agent 元年」「数字员工」这种词上面,而这篇东西全程在聊账期、工单、爬虫维护团队砍一半,土得掉渣,但每一个数字都是有人真金白银付过钱的。
一个行业开始聊这些土问题的时候,才是真的要成了。
回到开头那个说不出模型名字的买家。我猜他不是不关心技术,是他关心的问题已经换了一层,从这玩意聪不聪明,换成了这玩意出事的时候找谁。榜单像灯塔,离港的时候人人都盯着看,可真出了海,你性命所系的是船板上每一条接缝。
85 分是模型厂商的成绩单。剩下那 15 分,是我们这些搭脚手架的人的饭碗,也是你敢不敢把浏览器交出去的全部理由。
原报告在这,做 agent 的朋友值得完整读一遍,Can Agents Use a Computer Yet?,还有他们一年前那篇铺垫,The Rise of Computer Use and Agentic Coworkers。基准细节见 OSWorld,各家分数在 llm-stats.com 都能查到。文里提到的浏览器自动化老三样,Playwright 和 Stagehand,做过爬虫的都懂那种半夜被改版搞死的痛。