posts/agent-nightshift-acceptance.md
Agent 跑夜班前,先给它装一张验收单
让 Agent 跑一整夜,第二天打开终端,却只看到一堆看似完成的 diff、几段互相矛盾的结论,还有一笔不知该记到谁头上的账单。
这事很多做研发的人都碰过。Agent 跑得很勤快,任务却不一定交得出来。
OpenAI 昨天放出一份内部研究进展。到 8 月中旬,他们的研究组织里,每 1 个研究人员工作日,已经对应约 3.1 个 Agent 工作日。中位数使用者每天按 API 标价计算的推理消耗超过 600 美元,最高的那一档超过 7000 美元。好家伙,Agent 已经开始上夜班了。
但报告里还有一句更值得圈出来。对那些成功完成、预计需要人类 4 至 8 小时的任务,超过一半仍发生过至少一次人工介入。OpenAI 的原文 写得挺坦诚,运行时间涨得快,不等于研究进度会按同样的比例涨。
所以我更愿意把 3.1 看成一盏黄灯,不是一张生产力奖状。
它提醒我们,真正该盯的不是 Agent 跑了几小时,而是它第二天能不能交回一个可验收的东西。
运行时很热闹,产出得能合并
Agent 工作日是个很好看的指标,因为它很容易量。开了多少并发、跑了多久、用了多少 token,终端和账单都会老老实实记下来。
可研发里最贵的部分,往往不在运行时。
一个 Agent 给代码库做完迁移,真正的交付不是“它说迁完了”,而是 CI 通过、关键路径能跑、回滚方式写清楚。一个 Agent 跑完评测,真正的交付不是一张漂亮表格,而是数据来源、失败样本和下一轮该改哪里。
这也是 OpenAI 那组数据里最有意思的地方。编码、实验和技术排障被交出去得越来越多,高层规划仍然占很小一块。它不是在说规划不重要,反倒是在提醒人,方向、取舍和验收还得有人站在船头看。
厉害了,终于把“多开几个 Agent”从一种玄学操作,拉回了工程问题。
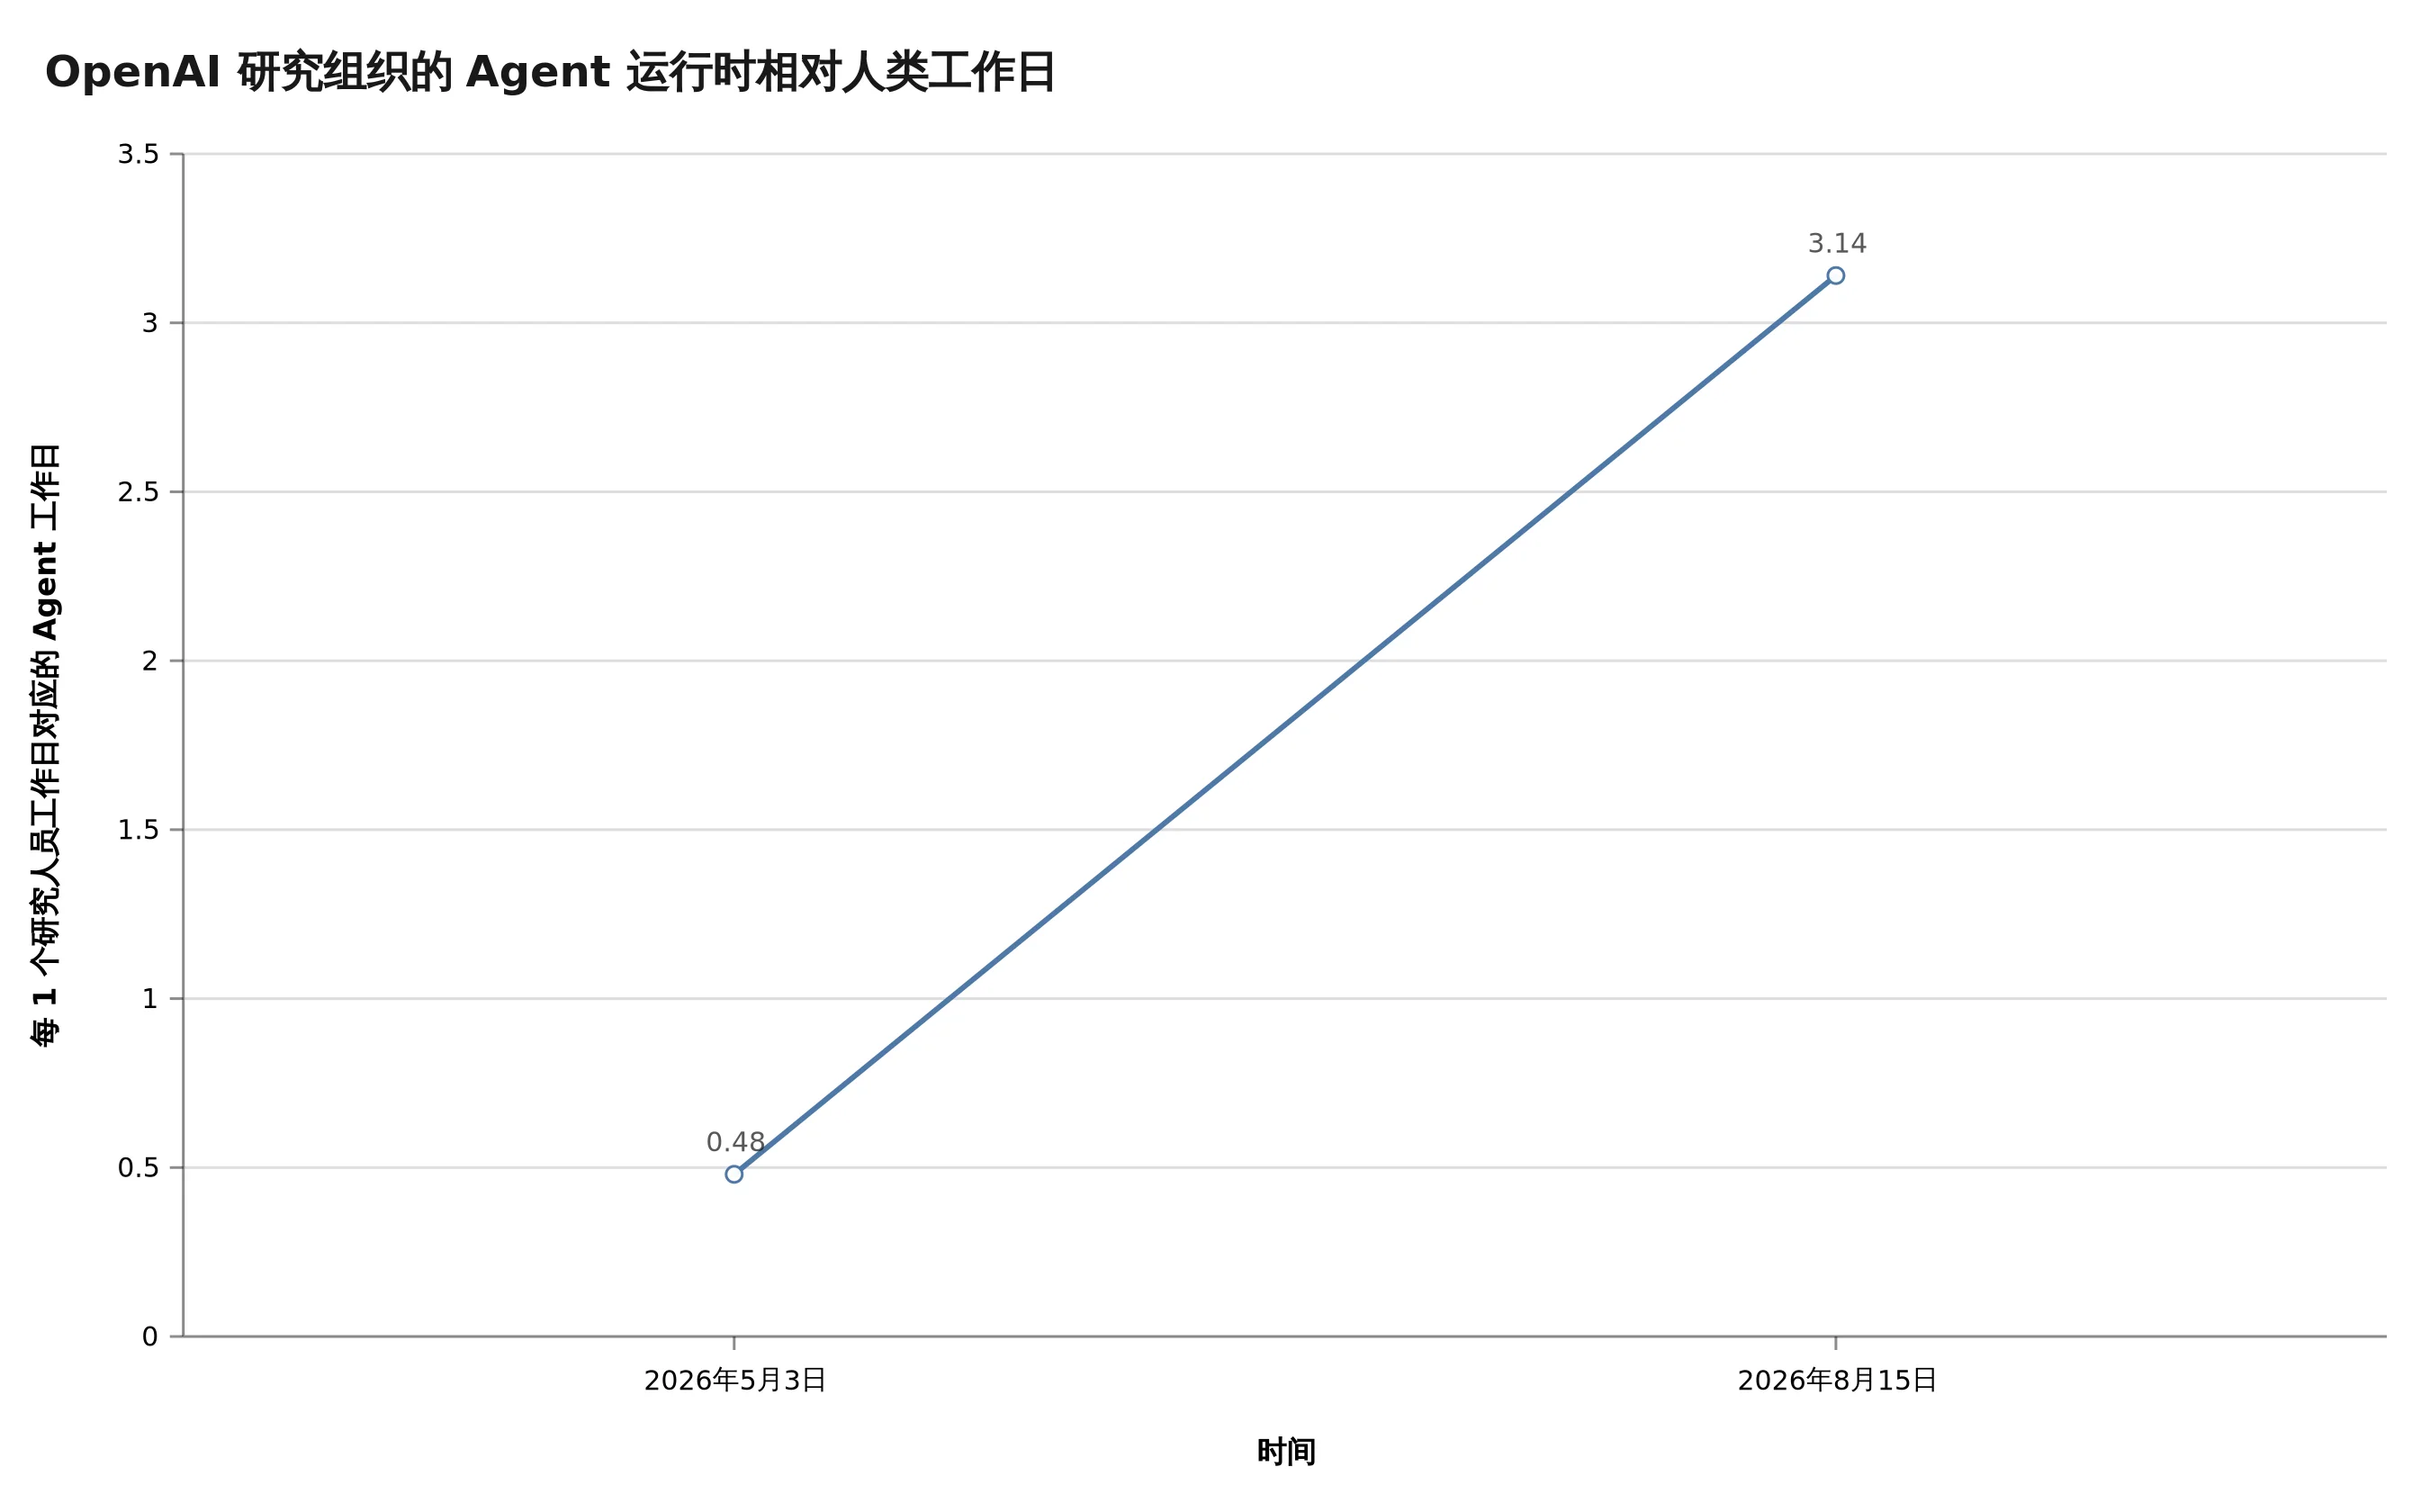
图中 3.1 倍是 OpenAI 对其研究组织的运行时统计,不能直接当成任何团队的生产力基准。
先写完这张单,再让它开跑
我给长时 Agent 任务留一张很朴素的验收单。没有它,任务再大也先别放进后台。
任务
把支付模块迁到新接口,只改指定目录

验收物
可合并的改动、通过的测试、失败项和回滚步骤

边界
不改数据库结构、不碰生产配置、不访问未列出的系统

预算
最多 90 分钟、最多 3 轮重试、超过额度立即停止

人工接手点
测试失败两次、需求不明确、发现安全或数据风险时暂停并报告
这张单看起来没什么技术含量,甚至有点像项目经理的表格。可它恰好解决了 Agent 最容易把人拖进坑里的地方,完成的定义不清楚。
很多任务一开始只写“修一下这个 bug”“看看为什么慢”。人类同事会追问,Agent 通常会把模糊需求当成一片可以自由发挥的草地。跑得越久,偏得越远,收尾时还会附上一份很长的总结。棒棒的,没一个能直接合并。
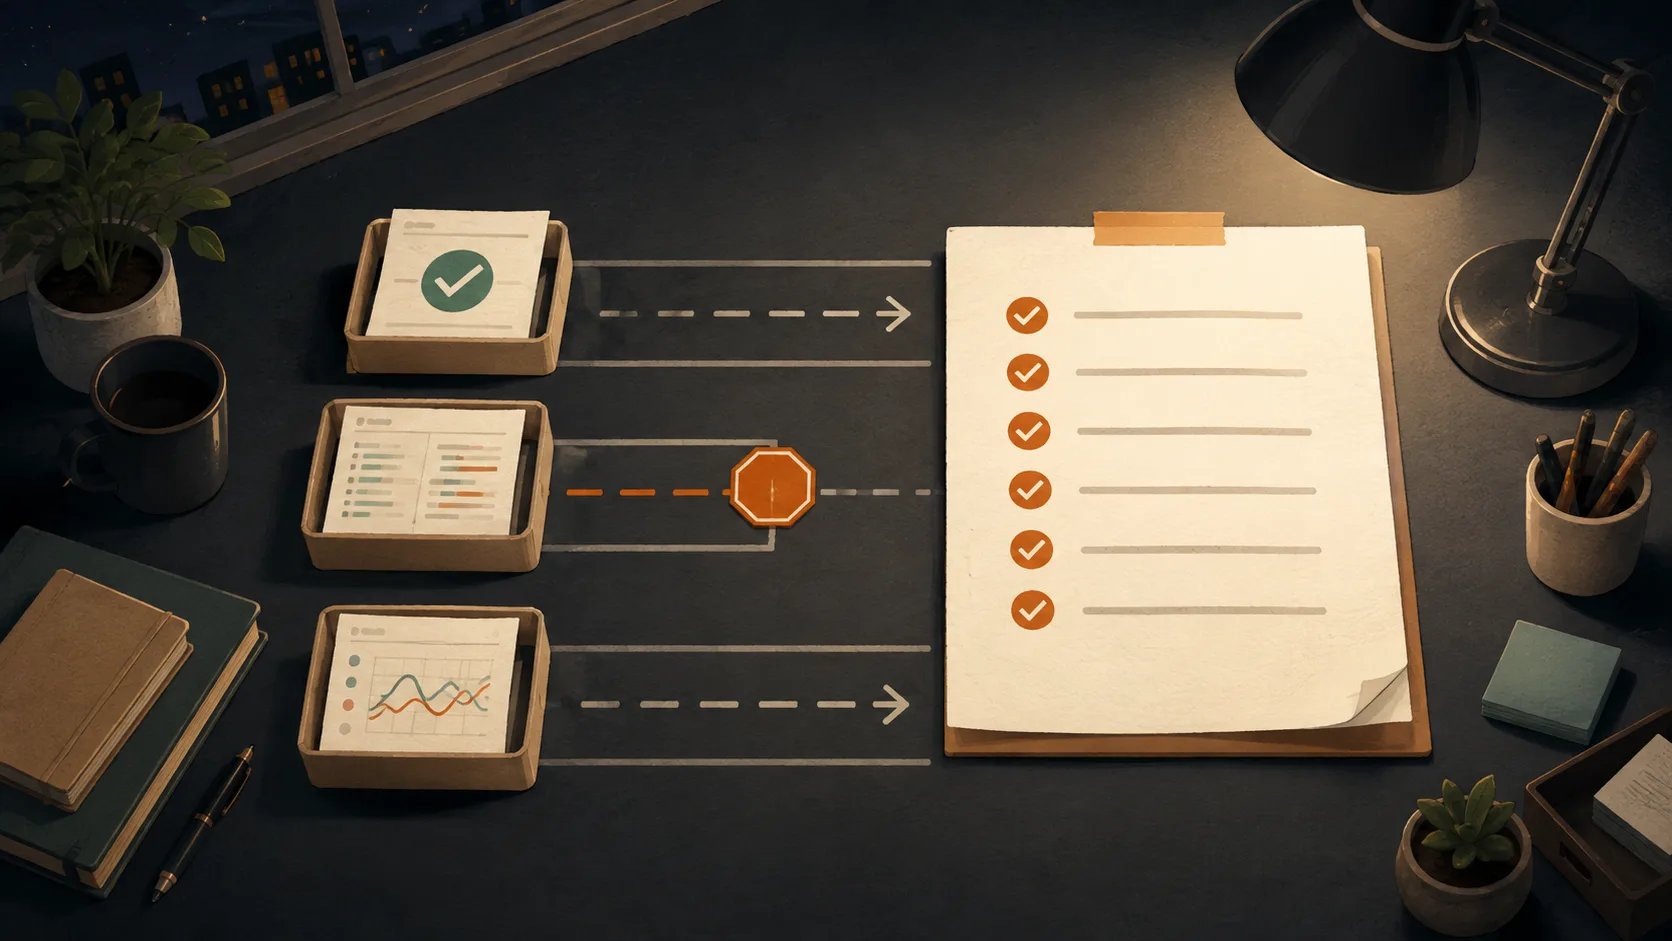
一张验收单把任务轨道收窄。不是给 Agent 加戏,而是提前告诉它哪些结果能被收下,哪些情况必须停住。
把验收物写成文件、测试结果、截图、可复现命令或明确决策,事情就变了。它不保证 Agent 一次成功,但能让失败变得可定位。第二天你面对的不是一团散掉的执行过程,而是一个能判断“收下、返工、停止”的包。
哪些活值得先交出去
我会优先把边界清楚、证据可见的活交给 Agent。批量改接口、补测试、整理日志、对照文档查差异、把失败样本归类,这些任务都适合让它并发跑。它们共同的特点是,答案能落在仓库、命令输出或一张表里。
需要先判断“要不要做”“该砍哪条路”的活,就别急着让它长跑。Agent 可以帮你铺材料、找反例、把方案写成草稿,可那个取舍本身仍然应该留给人。不是因为模型不够努力,而是这类问题的验收标准还没长出来。
还有一种最容易被忽略的活,叫故障边界。让 Agent 排障时,先告诉它什么情况下必须停。权限异常、敏感数据、持续失败的外部调用、成本突然抬头,这些都不该等到早上才从日志里考古。
OpenAI 的报告提到,随着任务更长、更复杂,人类介入依旧常见。我觉得这不是坏消息。人不是负责在末尾按一下确认键的人,人负责把“成功”这两个字写清楚。
有点子牛逼的团队,不是 Agent 数量最多的团队,而是最早把每一次自动化都变成可验收交付的团队。
下一次准备让 Agent 跑夜班时,先别急着加并发。花两分钟写下验收物、边界、预算和人工接手点。它们比一条“自主完成”的提示词可靠得多。
你团队里,哪一种长时 Agent 任务最容易跑出一堆东西,却交不出一件事?