posts/agent-plugins-portability-spec.md
Agent Plugins 只统一了箱子,没统一钥匙
一个合法的 Agent Plugin,核心 manifest 可以只有两行。
{
  "$schema": "https://agent-plugins.org/schemas/1.0.0/plugin.schema.json",
  "name": "reports-plugin"
}
没看错,两行。
Google 8 月 6 日的官方文章宣布加入 Agent Plugins 核心维护组。此前维护者已经来自 Amazon、Cursor、Microsoft、OpenAI 和 Vercel。大家想解决的麻烦很朴素,一个 skill 加一段脚本,再配一个 MCP server,在第一个客户端跑得挺好,搬到第二个客户端时,目录、manifest、传输配置全要重包一遍。
代码没变,盒子先分叉了。
好家伙,Agent 生态卷了两年模型、工具和协议,终于有人开始认真统一纸箱尺寸。
我很喜欢这件事。固定的 plugin.json、skills/ 和 mcp.json,看起来没有任何戏剧性,却可能省掉插件作者大量重复维护。只是我自己的判断稍微冷一点。
Agent Plugins 1.0.0 统一了箱子,还没有统一钥匙。
它能让同一份能力更容易搬家,却没有替你解决谁能安装、谁能执行、凭据放哪、hooks 在不同客户端里是不是同一回事、插件被人换包以后怎么发现。要是把「格式可移植」直接理解成「生产可移植」,很容易在第二个客户端跑出一串特别熟悉的红字。
works on my agent,新时代的 works on my machine。
它真正解决的,是那层最烦的包装
Agent Skills 已经定义了如何给 agent 提供可复用的指令和资源,MCP 也已经定义了如何连接工具与服务。问题出在两者外面,每个客户端都长出自己的目录布局、manifest 字段和发现规则。
同一个报表插件,在 A 客户端里叫 skills/,在 B 客户端里可能还要再写一份路径映射。MCP 配置有的从对象形状猜 stdio,有的要求显式写传输类型。再叠上 commands、hooks 和 agents,插件作者很快就拥有四份几乎一样、又不敢删掉任何一份的配置。
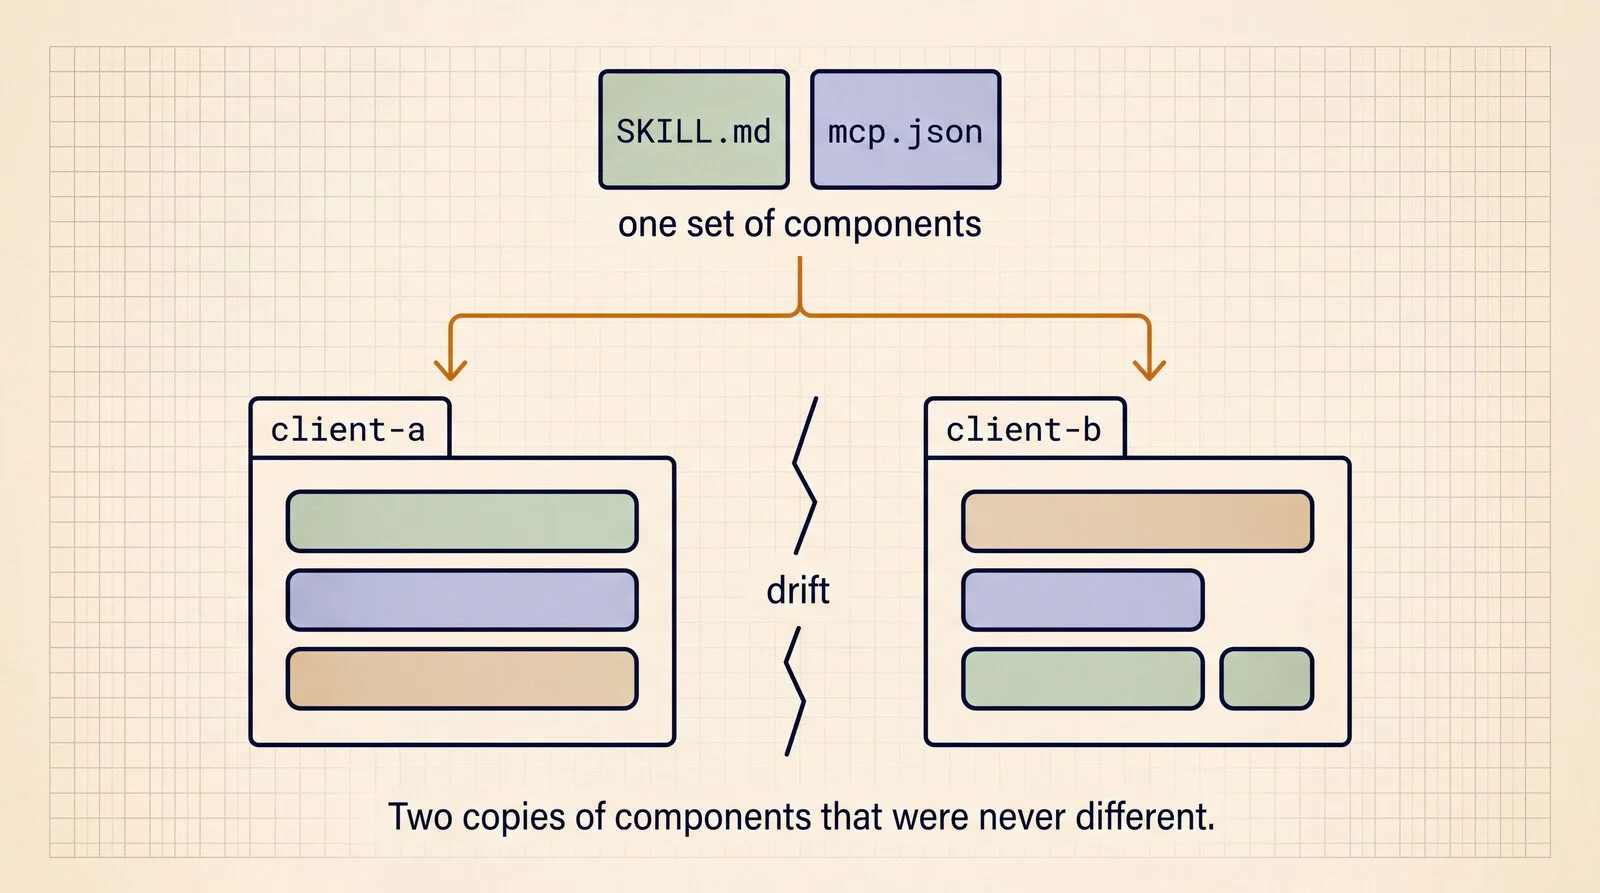
同一组 skill 和 MCP 配置为不同客户端分叉后,最容易发生的就是配置漂移
Agent Plugins 的做法很克制。
插件就是一个目录。skill 放固定位置,MCP server 放固定文件,plugin.json 只管少量元数据。客户端自己的额外能力放进反向域名命名空间,比如 com.example.client/。不认识这块的客户端直接忽略,不影响可移植核心。
这里有个设计我很喜欢。某个 MCP server 启动失败时,客户端要继续加载其它组件,并把失败报出来。一个 server 挂了,不该让同包的 skills 全部陪葬。1.0.0 规范把这种失败边界写得很明确。
做过 agent 工具链的人大概会懂,这种小约束比一张宏大的生态图值钱。生产环境最怕的不是失败,而是一个局部失败顺着加载链条蔓延,最终只给你留下一句插件不可用。
现在至少箱子有了统一尺寸,箱内每件货也能单独报损。
棒棒的。
但这只解决了包装层。再往下走,真正贵的东西才刚冒头。
规范主动留白的地方,正是生产事故爱去的地方
Google 的文章没有装作 1.0.0 包治百病。它直接列出没有覆盖的部分,安装机制、分发协议、权限模型、沙箱、信任与来源验证、用户体验,全都不在 v1 的职责里。
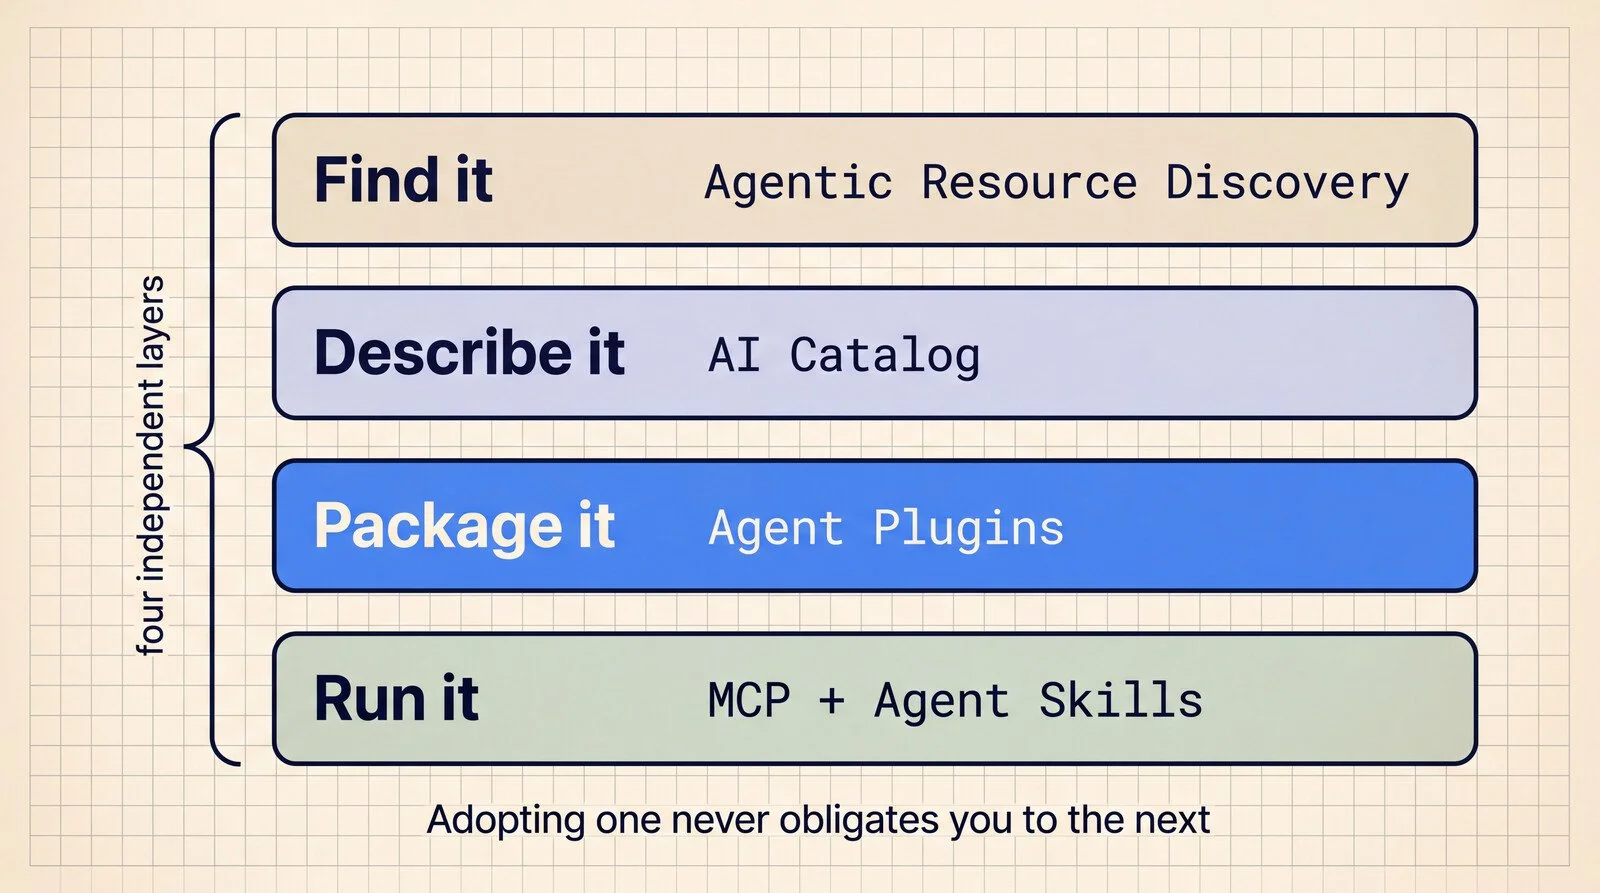
Google 官方把发现、描述、打包、运行拆成四层,Agent Plugins 只负责第三层
这份克制是对的。CLI、IDE 和企业托管平台承担的责任完全不同,硬塞一套审批交互只会造出更大的妥协品。
可从使用者视角看,这些「没有」不能略读。
最先撞上的是凭据。规范明确写着,v1 不定义 OAuth 配置,也没有可移植的凭据引用字段。授权发现、用户交互和凭据存储,都交给客户端管理。同一个 mcp.json 搬到 Codex、Claude Code、Copilot CLI 或 Gemini CLI,server 名字可以一样,登录状态与 token 生命周期却未必能一起搬。
这块需要注意一下。很多插件 demo 会在本机环境变量齐全时跑通,然后作者顺手把目录推到 marketplace。到了团队机器,用户级 token、服务账号、企业代理和短期凭据混在一起,插件有没有越权,已经不是 plugin.json 能回答的问题。
再往下是执行环境。
规范用 ${PLUGIN_ROOT} 给包内文件一个确定锚点,也允许通过 env 显式补环境变量。但裸命令如何查找,仍跟客户端继承的 PATH 有关。macOS 上能找到的 python3,进了 Windows 或企业沙箱可能直接消失。官方建议很直白,包内命令尽量用相对插件根目录的路径,让执行结果更确定。
然后是 hooks。
可移植核心能带走 skills 与 MCP servers,客户端特有的 hooks、commands 和 agents 则进入扩展命名空间。这个逃生舱让规范保持轻巧,也给「看起来装成功,实际少跑了一层保护」留下空间。
AWS 的 Agent Plugins 仓库已经给了很现实的例子。它明确提醒,Claude 特有的自动 hooks 还没有接进 Codex manifest。把 Claude Code 插件转换到 Kiro 时,skills 和 MCP servers 可以保留,hooks 因语义不完全对应会被直接丢掉。
厉害了,插件确实搬过去了,门口的保安没跟上。
如果那段 hook 只是格式化代码,损失可能是 CI 多报几行。如果它负责拦截危险命令、注入租户边界或扫描凭据,少掉它就不是兼容性瑕疵,而是安全模型换了一套。
还有供应链。
v1 不规定安装和分发,也不规定来源证明。谁维护 marketplace、插件更新指向哪个 commit、依赖脚本是否能联网下载、同名插件会不会被替换,这些仍归客户端和组织策略处理。一个标准盒子让好东西更容易分发,也让坏东西更容易长得像好东西。
所以说真的,看到「vendor-neutral」先别只想到自由迁移。中立格式也会把信任判断从厂商封闭商店,挪到每个使用者的安装策略里。
别先测能不能装,先测能力有没有少
如果团队准备把一套插件同时交付给多个客户端,我觉得最值得先建的不是 marketplace,而是一张兼容矩阵。
矩阵的横轴放目标客户端与版本,Codex、Claude Code、Copilot CLI、Gemini CLI,再加实际运行的操作系统。纵轴别只写安装成功,要写组件发现、MCP 启动、权限申请、凭据读取、hook 执行、失败回落和卸载清理。
这里有个很容易踩的坑。插件列表里出现名字,只能证明 manifest 被读到了,不能证明能力完整。测试用例应该故意让一个 MCP server 启动失败,再确认同包 skill 仍能使用,错误也确实可见。然后让 hook 写一个无害标记,逐个客户端核对它到底执行了没有。
再准备一份最小权限凭据。
不要拿开发者本人全权限 token 当兼容测试润滑油。server 需要查报表,就给只读服务账号和短期凭据。需要写对象存储,就把 bucket、路径和动作范围缩到插件实际任务。某个客户端无法安全保存或轮换这份凭据,矩阵里就该标红,而不是先塞进环境变量再说。
第三道闸是版本与来源。
安装时锁 release、commit 或可验证摘要,记录插件版本、客户端版本和 schema 版本。升级前跑同一组契约测试,检查新增的 scripts、MCP 配置与扩展目录。规范要求客户端拒绝不认识的 schema 版本,这很好,但 schema 合法只说明箱子合规,不说明箱子里的脚本值得信任。
体验这一关也不能省。
同一个插件在四个客户端里,触发词会不会都被识别,失败时有没有可读诊断,权限弹窗能不能让普通人看懂,卸载以后会不会留下 token 和可写目录。这些东西不够酷,却决定团队敢不敢把插件从试验环境推向生产。
我也不知道 Agent Plugins 会不会成为最终的统一格式。规范页目前仍把 1.0.0 标成 Working Draft,兼容客户端列表还会继续变化。现在就宣布格式战争结束,多少有点早。
但方向是对的。
GitHub Copilot CLI 的官方文档已经允许通过标准 $schema 进入 Agent Plugins 语义,Google Data Agent Kit也开始用插件把 BigQuery、Spanner、Cloud SQL 等能力带到不同编码 agent。厂商第一次愿意把包装层做成公共基础设施,这一步不华丽,却很关键。
只是别把搬家公司的统一纸箱,当成银行的统一保险柜。
箱子终于能搬了。
钥匙、门禁和签收单,还是得我们自己盯。