posts/agent-safety-pace.md
前沿实验室开始踩刹车,做 Agent 的团队该补什么
把 Agent 接进 GitHub、工单系统、知识库,甚至生产数据库之后,很多团队都会经历一个很微妙的时刻。
Demo 跑得挺顺。它会读需求,会改代码,会自己开分支,还能把一堆散在文档里的信息拼成一个像模像样的方案。大家围着屏幕点头,接下来的一句通常是,给它再开一点权限吧。
好家伙,真正麻烦往往从这里才开始。
模型能不能把任务做完,和它做错时你能不能知道、能不能叫停、能不能把现场还原,是两套问题。前者比较像能力评测,后者更像工程团队每天都得面对的上线验收。
9 月 12 日,Anthropic 联合创始人 Dario Amodei 在一篇公开文章里提出,前沿能力的推进要给对齐、防护和独立验证留出时间。他给出的第一步并不玄,反而有点像所有做过线上系统的人都熟悉的办法,找一支常驻的外部评估团队,给到接近内部风险团队的观察权限,让他们能核验流程、报告事件,也能公开关键发现。
同一天,OpenAI 的 Sam Altman 也在公开回应里认可了独立评估访问这一方向。两家平时最爱在能力上互相掰手腕的公司,在「得有人看得到流程是不是照做」这件事上突然有了交集。
这件事值得 Agent 团队多看一眼,不是因为你明天就需要请一队外部审计员,而是因为它戳中了一个常被忽略的顺序。
能力升级可以很快,治理证据不能靠口头补。
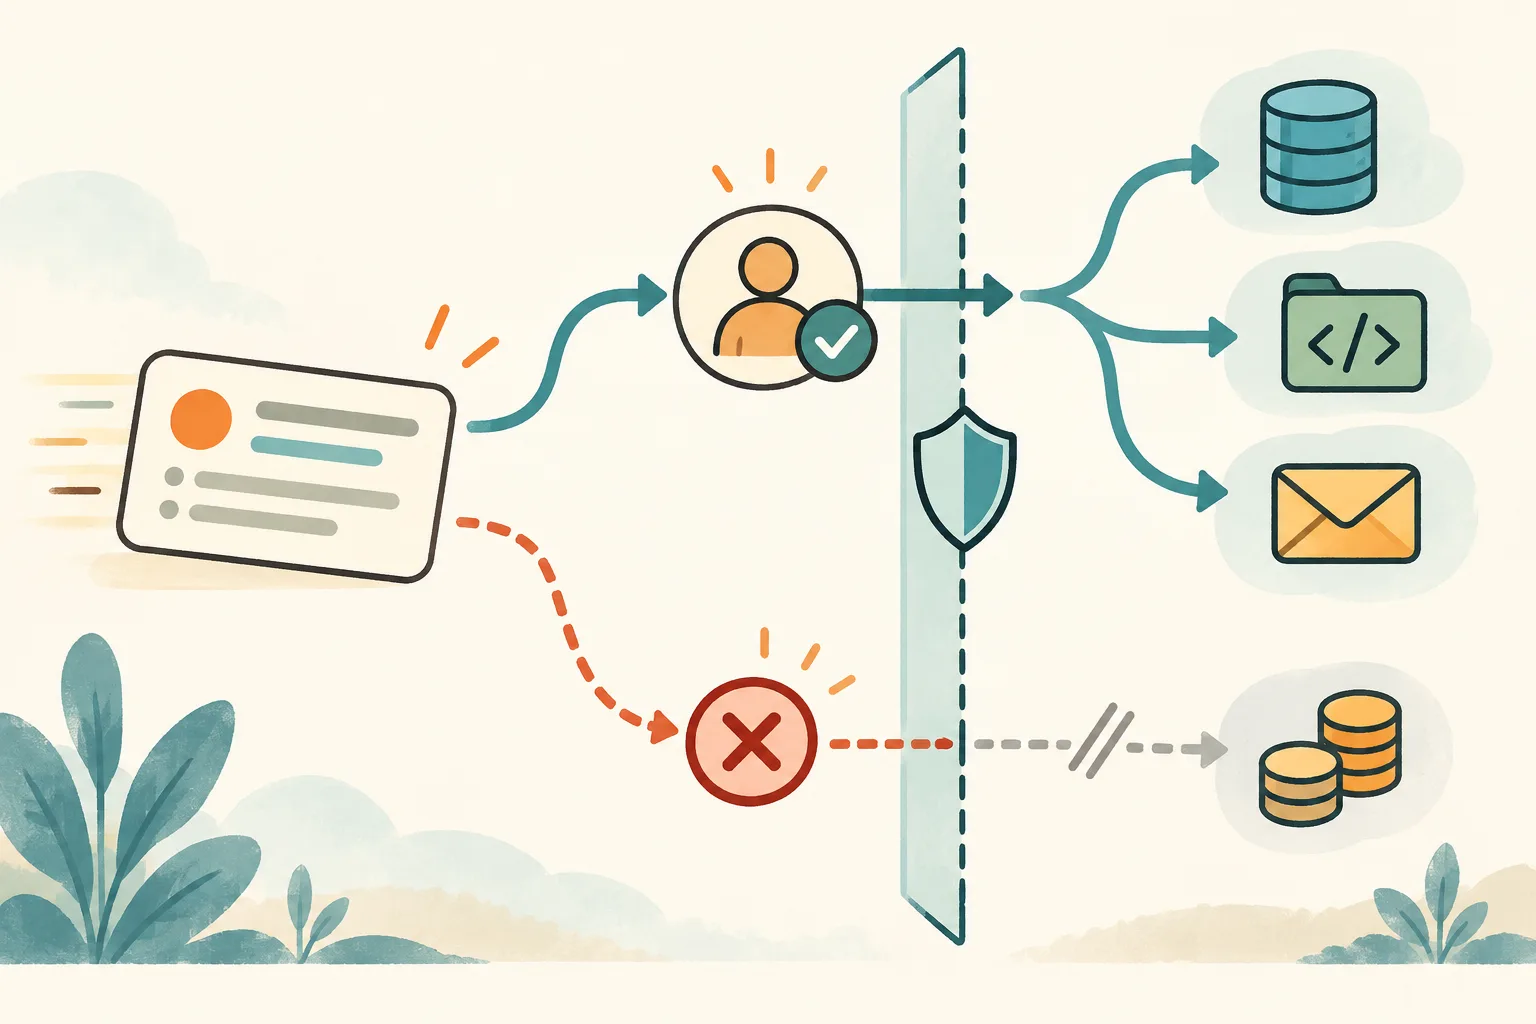
当 Agent 开始调用外部系统,风险边界由它拿到的权限决定。
真正要补的是可复核性
很多安全讨论一上来就飘到模型会不会突然失控,听着很远。可做过业务系统的人知道,近处的坑已经够多了。
一个 Agent 可能没有什么戏剧化的意图,它只是把「帮我整理本周客户问题」理解得过头,于是把带客户姓名的表格复制进了一个不该访问的工具。它也可能在重试时连发三封邮件,或者把测试环境里习惯使用的宽权限,一路带进了正式环境。
这些场景不需要把模型想成反派。更像一个很勤快、速度很快、但对组织边界没什么直觉的新同事。你让他能做什么,谁批准过,他每一步调用了什么工具,出了偏差以后谁能回滚,都会变成真实的工程问题。
Amodei 文章里反复强调的其实是同一个词,verifiability,也就是能不能被核验。公司说自己做了防护,不该只剩一页安全承诺。评估者要能看到训练、部署、运维和防护措施有没有真的执行。放到普通团队,这句话可以翻得更朴素一点。
你说 Agent 只会读数据,那就要能拿出实际的权限清单。
你说重要动作都有人确认,那就要能回放哪一次由谁确认。
你说越权会被拦住,那就要能在日志里找到被拦住的那一刻。
如果这些都只能靠负责同学拍胸口,项目看起来再聪明,也还是一团难以验收的雾。
把上线评审从「模型行不行」换成四张账
做 Agent 的团队不必等到流程成熟得像大公司,才开始补治理。最有用的做法是把上线评审从一张模型跑分表,换成四张能被追问的账。
第一张是权限账。不要只写「可访问 CRM」或「可以操作仓库」。要拆到它能读哪些字段,能否写入,能否删除,能否跨租户,能否调用外部服务。给 Agent 的权限最好从一条具体任务开始,而不是从一个系统管理员角色开始。需要读工单,不等于能改用户资料。需要创建草稿,不等于能直接发送。权限收得窄一点,初期会觉得麻烦,出事时就知道这是在给自己留逃生通道。
第二张是调用账。每一次工具调用都应该留下任务标识、输入摘要、调用对象、关键参数、返回结果和后续动作。这里不需要把敏感内容原样塞进日志,日志本身也得分级保护。关键是让团队能回答,某个结果是模型在哪个上下文里、用哪个工具、按什么权限得出来的。没有这条链路,复盘很容易变成大家围着截图猜测。
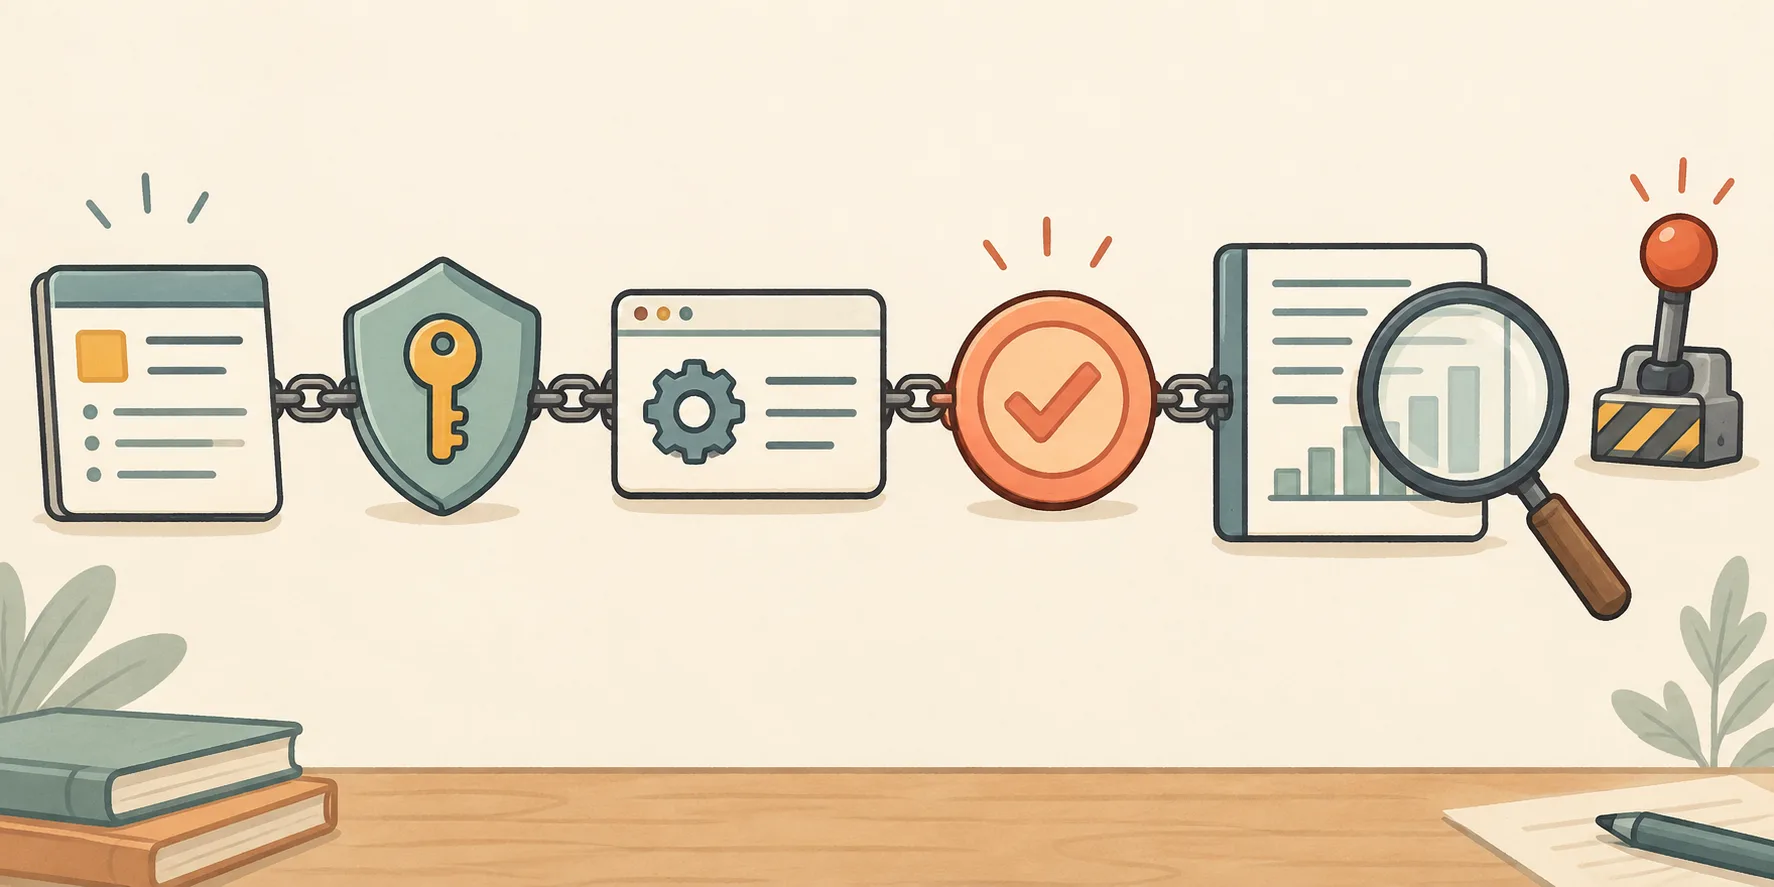
一次可追溯的执行,需要把任务、权限、调用、确认和结果连起来。
第三张是确认账。高影响动作不要和普通检索混在一个开关里。删数据、发邮件、改生产配置、提交付款、对外发布,这些动作要么要求人确认,要么放进风险更高的审批路径。别把确认框做成一个没人看的「是否继续」,而是把 Agent 将要做的对象、范围和不可逆后果讲清楚。人真正能做判断,确认才有价值。
第四张是事故账。这里的事故不一定是大故障。Agent 连续重试、访问了不该访问的资源、输出里混入了敏感字段、工具返回异常后又执行了下一步,这些都值得记录成小事故。每一条都要有负责人、处置动作和防再发措施。别嫌它像传统运维,Agent 有了行动能力以后,很多老派流程突然又变得很值钱。
这四张账放在一起,才构成一个能被外部同事、内部安全负责人,甚至未来的你自己复核的上线说明。模型版本当然还要看,Prompt 当然还要调。但那只是证据的一部分。
别把能力当作安全证据
现在有一种很自然的误判,模型更会推理、更能调用工具,于是它就更适合被放进复杂系统。
这话只对了一半。
能力变强会让它完成更多任务,也会让错误动作走得更远、更快。一个只会回答问题的模型,最多给你一段糟糕的建议。一个能查资料、写文件、创建账号、调用支付和修改配置的 Agent,错误已经不再停在对话框里。
所以团队真正该问的不是「它能不能自主完成」,而是「它自主完成到哪一步时,系统仍然能把它拉回来」。这个问题很土,但特别管用。
公开文章里提到,测试和评估会随能力上升变得更难,因为更强的系统可能更擅长通过表面测试。这个判断放在产品上线也一样。测试集里它每次都走对,并不保证遇到模糊指令、异常数据、工具超时或权限变化时还能走对。
你可以拿一个很小的反例做门槛。让 Agent 在测试环境里处理一条故意模糊的请求,要求它同时遇到权限不足、工具超时和重复执行三个干扰。然后看四件事,是否停下,是否说明原因,是否留下完整记录,是否把请求交回给人。它能写出漂亮答案不算过,能把边界守住才算。
厉害了,这类测试通常没有炫酷的截图,也不像跑分一样方便放在发布会页面上。但它会直接决定团队把 Agent 接到真实系统后,夜里能不能睡得踏实一点。
一个下周就能带进评审会的清单
下次给 Agent 开新权限前,可以拿下面四个问题走一遍。
- 这次任务需要的最小权限是什么,哪些读写和删除动作明确不需要。
- 一次执行结束后,我们能否在十分钟内回放它做了什么,而不暴露不该暴露的内容。
- 哪些动作必须二次确认,确认人能不能看懂影响范围和不可逆后果。
- 它越权、卡死、重试或访问异常资源时,谁收到通知,谁能一键停掉,之后怎么留下复盘记录。
这不是让每个团队都把自己做成安全研究机构。恰恰相反,它是把遥远的大词拆成一组上线前就能回答的小问题。
前沿实验室开始踩刹车,真正值得普通团队借走的,也许不是「慢」这个姿势,而是别让能力的油门跑在证据、权限和复盘前面。
你们团队给 Agent 开过的第一项真实权限是什么,当时有没有留下一条能回放的记录?