posts/agentic-coding-ci.md
CI 任务 6 个月涨 25 倍,测试不能再全跑
如果你们最近开始让 Claude Code、Codex 或 Copilot 多写一点代码,大概会撞见这个场面。
PR 比以前多,评审也快了,合并按钮却卡在 CI。等来的还不总是明确的失败,有时是一串和这次改动没多大关系的红灯。人还可以瞥一眼日志,凭经验判断哪条该管。Agent 不行,它只会继续围着一堆过期信号打转。
代码写得快,本来是好事。可写代码不再是最慢的环节后,测试和验证就会从幕后走到台前。好家伙,瓶颈没有消失,只是换了个地方蹲着。
Anthropic 刚公开了一篇工程复盘。他们的工程师每季度交付的代码量,达到 2021 到 2025 年平均值的 8 倍,其中约 80% 由 Claude 编写。测试总量增长 10 倍,六个月内 CI 任务量增到 25 倍。
这篇复盘最值得看的地方,不是又多了一个 AI 编程数字,而是它把一个很具体的问题摊开了。AI 能把 PR 的供给推高,CI 不能再像过去那样,默认每个改动都跑一次全量测试,再把状态拴在一个单进程里。
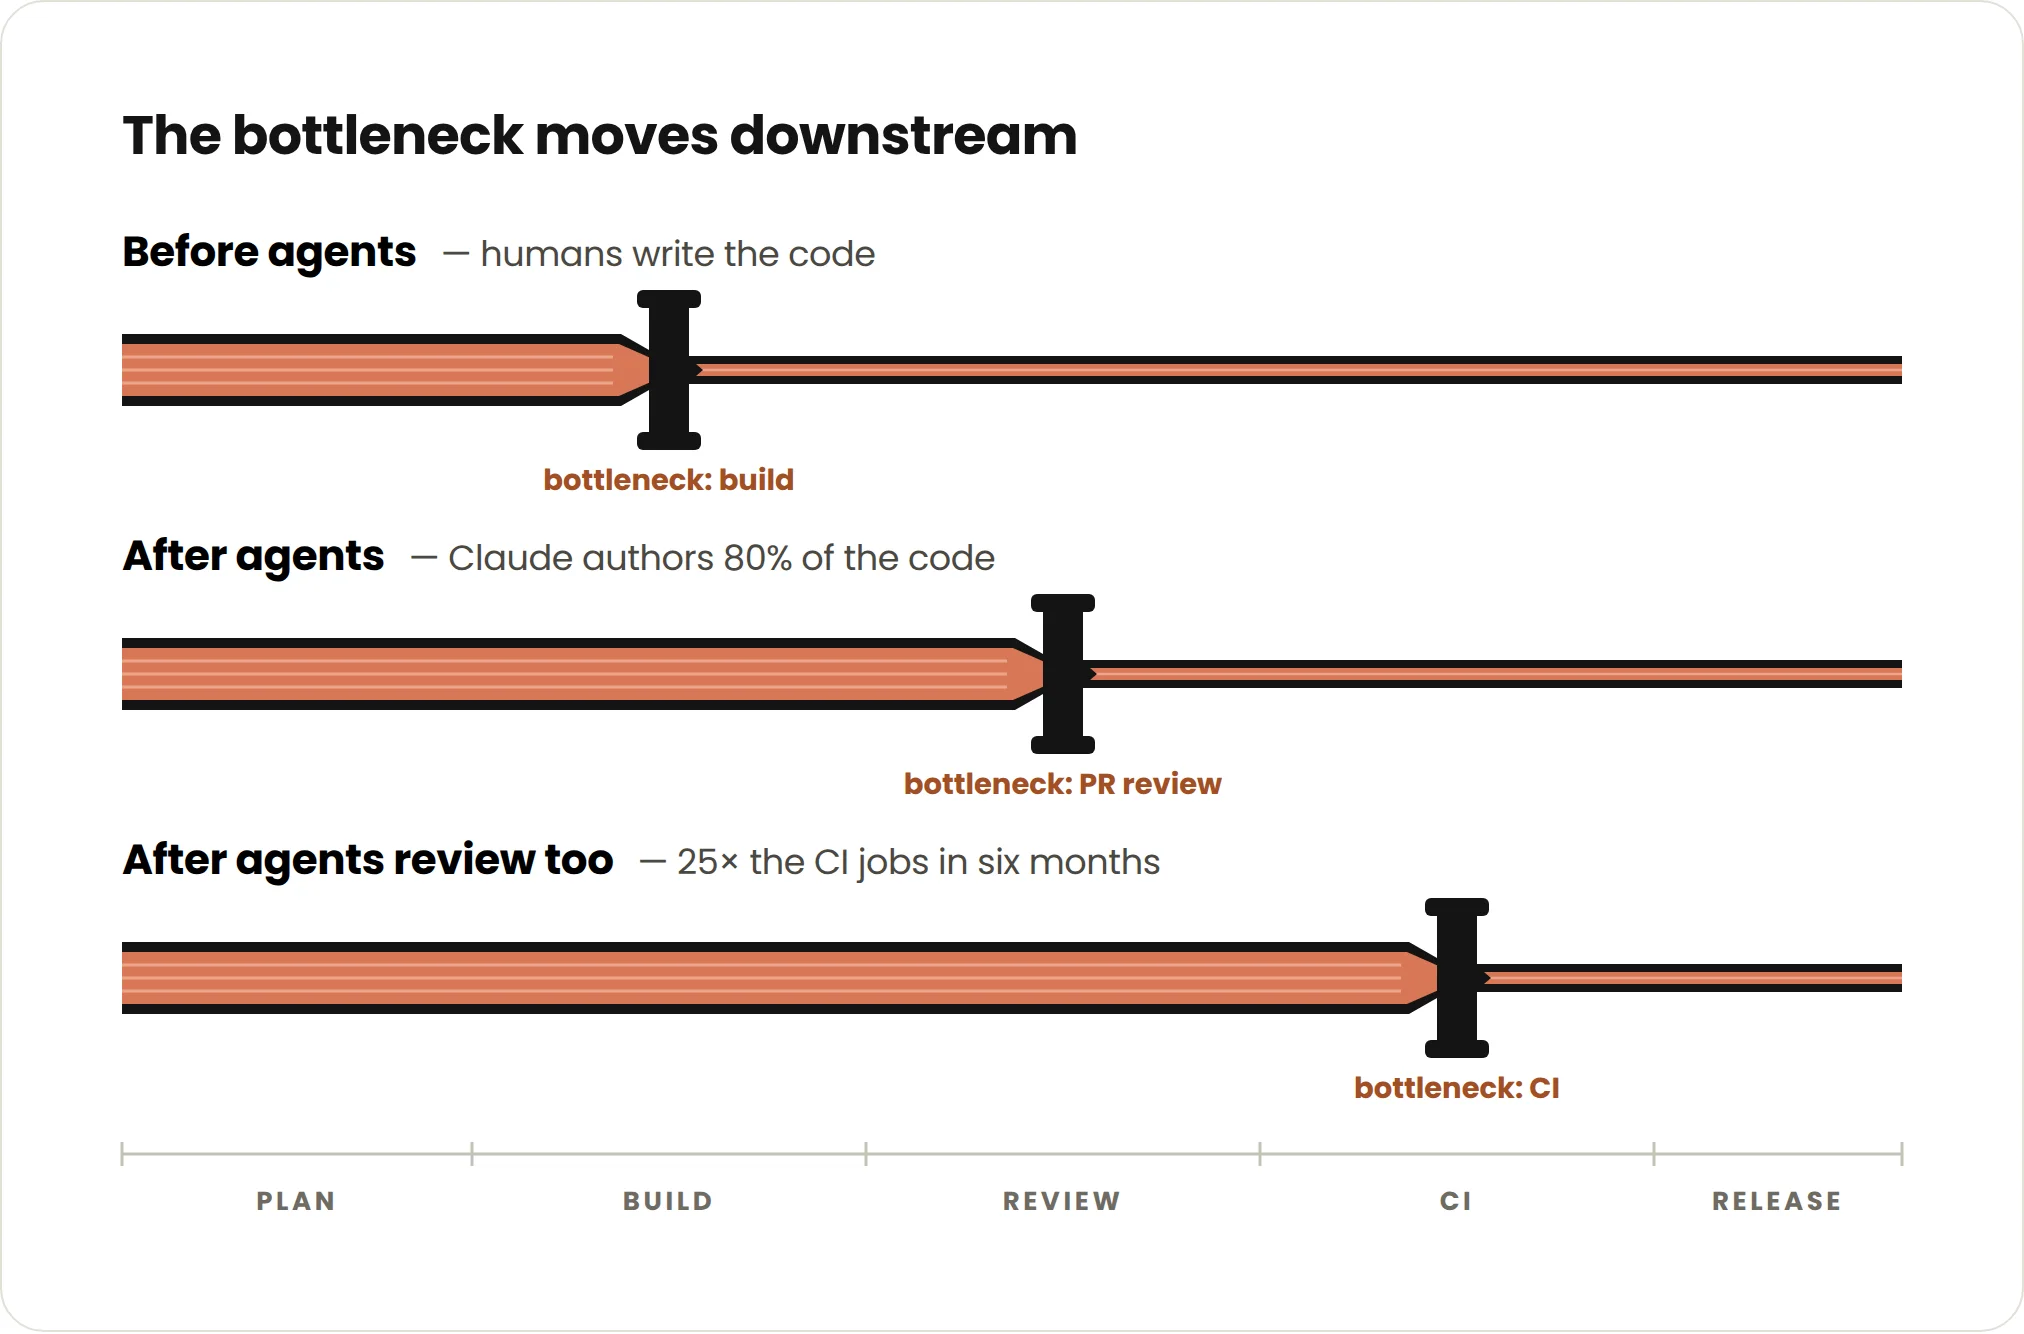
Anthropic 原文的工程示意,代码和审查提速后,压力会落到 CI 这一层。
全量测试的安全感,开始变得很贵
很多团队的测试策略其实很朴素。改了代码,跑一遍。改得多,跑得久一点。只要机器还扛得住,这种安全感相当舒服。
问题是,Agent 倾向于把工作切成更小、更细的 PR。它还会在夜里和周末继续推改动。单个 PR 的改动也许更小,全天总量却被抬高了。CI 的平均负载在涨,突发峰值也在涨。
Anthropic 的做法是测试影响分析,也就是根据历史结果和包的相关性,为每个改动挑出该跑的测试。它不是让模型猜一猜,而是让一个确定性的服务维护两件事。
- 监听器记录每次 CI 运行的测试结果。
- 选择器读取历史,在新的 PR 打开时决定跑哪些测试。
这事听着很基础,却直接影响 Agent 能不能自证。给它一组相关、可信的测试,它可以据此修复和迭代。给它一大串无关红灯,它只会浪费上下文和时间,顺手把 CI 队列再塞满一点。
更麻烦的是,测试选择的正确性不是一次性的。某个测试刚修好,某个依赖刚开始不稳定,某个新测试刚被加进来,这些结果都要尽快进到选择器里。数据一旦落后,选择器会拿旧地图给新 PR 导航。
加机器能救火,救不了曲线
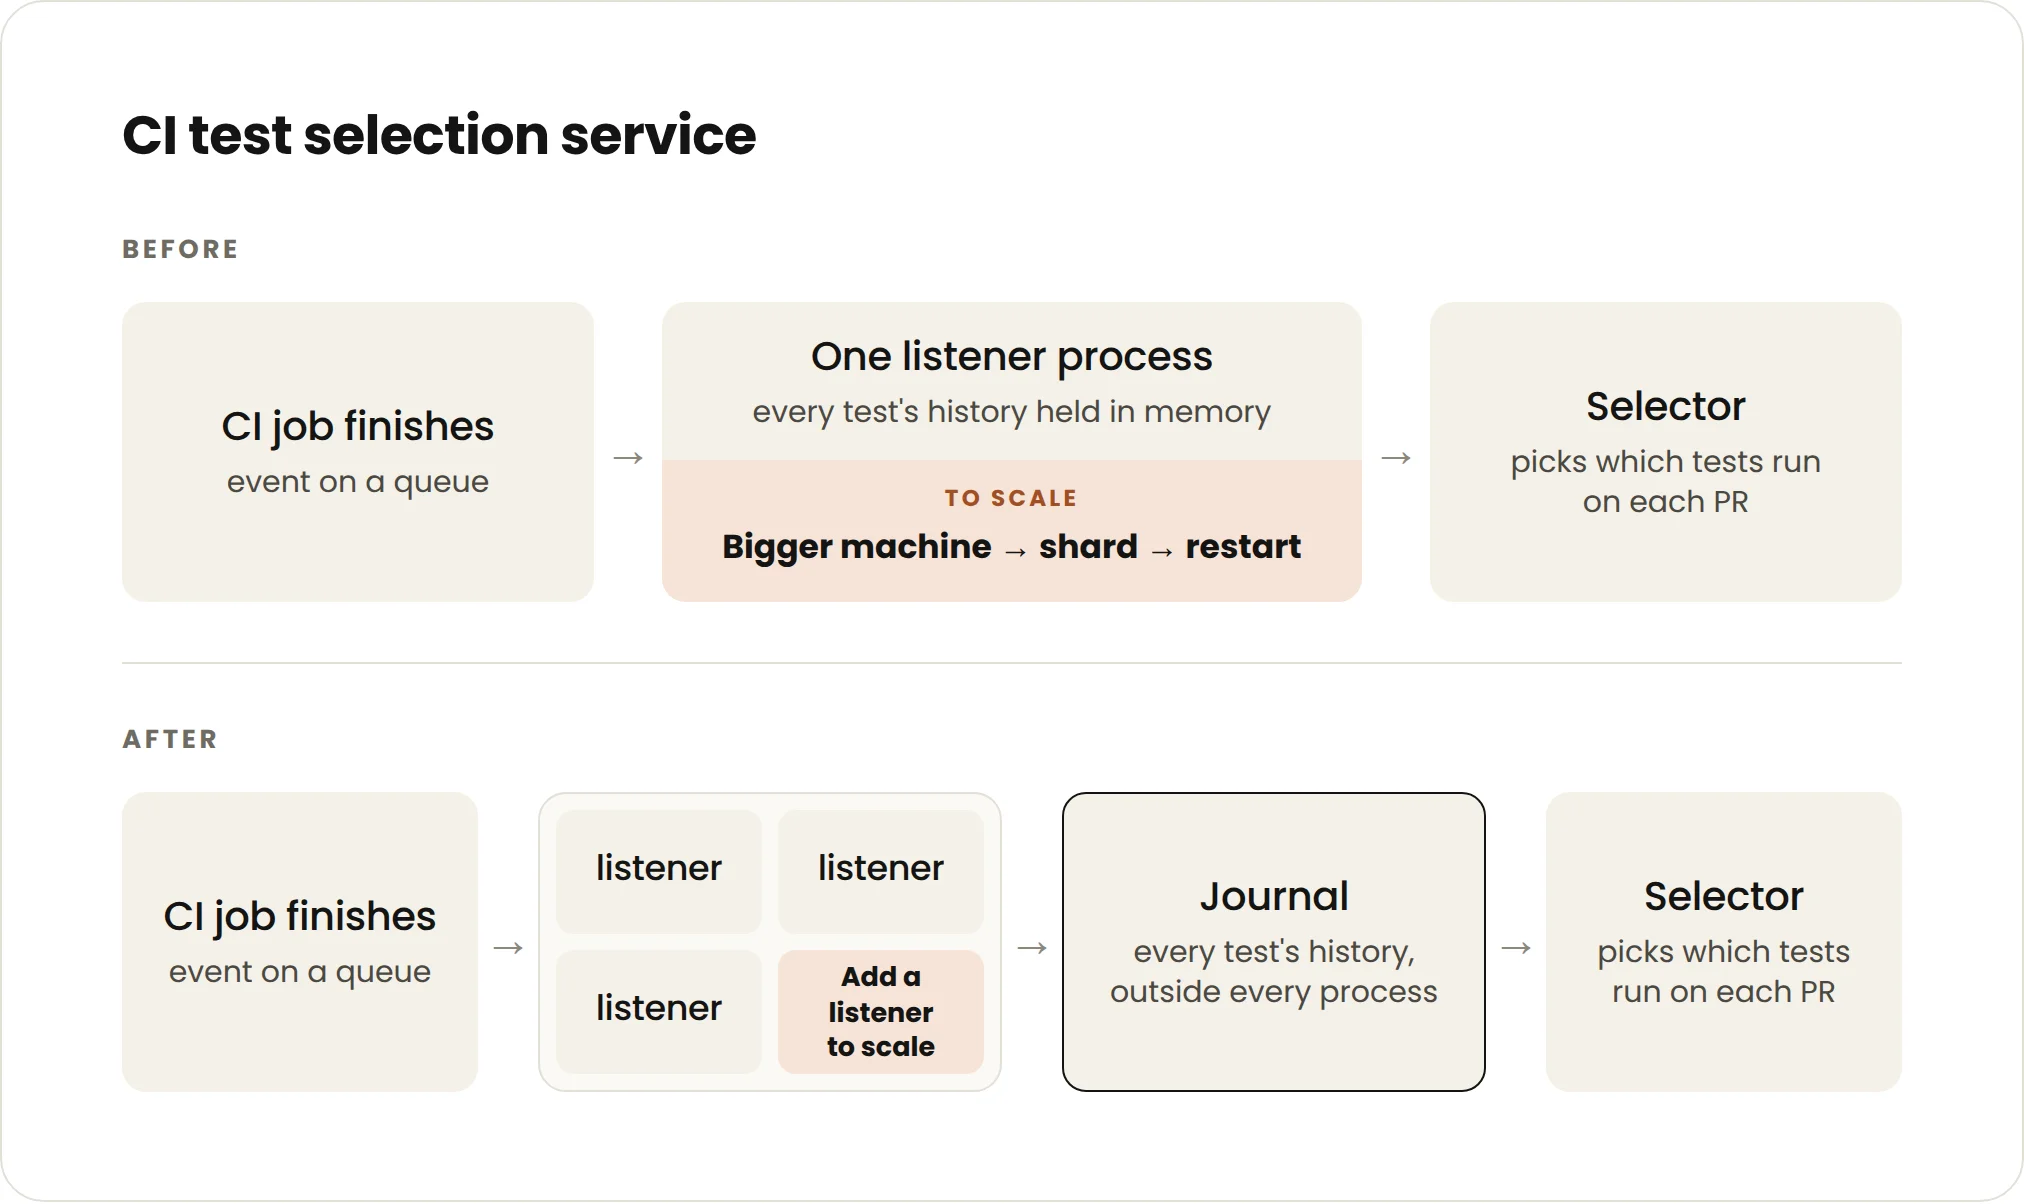
Anthropic 最初把这套服务做成单进程。原因也很常见,测试历史需要持续更新,一个写入者最省心。
后来他们先把核心数翻倍。这个补丁撑了约 70 天。
接着他们把状态按包分片,每个包各有 worker。这个补丁撑了 29 天。
再后来,进程几乎每天到下午就碰内存上限。团队试过修 bug、换内存分配器,也用重启续命。重启能让当下安静一点,却会让监听器慢慢落后。积压超过一小时后,许多任务结果没被记录,选择器开始用陈旧数据安排测试。
这里要分清一件事。原文没有说未测试代码会直接进入生产环境。更现实的后果是,已经修复、普遍不稳定,或者与当前改动无关的测试,仍会被错误地带进来。开发者看到的是一串不值得信任的红灯,平台团队看到的是越来越难解释的队列。
厉害了,AI 把写代码这件事压缩得更快,也把拖延重构的代价放大得更快。
积压曲线变平不是运气,前提是监听器不再被单个进程卡住。
真正该重做的是状态的位置
真正落地的改造并不神秘。团队把进程里那坨历史状态挪到了内存型数据存储中。
任意监听器 worker 接到一条结果后,把事件追加进日志就能继续处理下一条。它不必把所有状态压在自己的内存里。另一个较小的消费者进程,每隔数秒把日志归并成逐测试的历史记录。选择器再从那里快速查询相关数据。
监听器因此变成无状态组件,可以横向扩展。架构会更贵,但更容易扩容,也更容易做内存分析。Anthropic 说,这个重构由一名工程师用了三周完成。一年前,同一件事可能接近一个季度。
这才是本文真正有点子牛逼的地方。过去大家会把提前为 10 倍、20 倍负载设计,叫作过度工程。现在 AI 把实现和重构的成本压低了,那个阈值已经往上移了。不是所有服务都要上分布式系统,但关键链路至少要知道,状态在哪儿、积压在哪儿、扩容时谁会成为唯一的写入者。
如果你的团队刚把 AI 编码接进日常开发,我会先把下面这组指标补出来。它不替你选架构,却能让最危险的那条曲线露出来。
ci_jobs_received_total
ci_jobs_processed_total
test_selector_lag_seconds
test_result_freshness_seconds
full_suite_fallback_rate
看指标时别只盯平均值。更该盯的是输入和输出能不能对上,积压有没有持续变长,系统退回全量测试的频率有没有飙升。一个简单的守恒关系就够了,进来多少 CI 任务,最终就该出去多少处理结果。
现在就能做的三件小事
第一件,挑一个非核心仓库,量一下全量测试和按影响挑选测试的差别。别急着让模型决定不跑什么,先用确定性的依赖、历史失败和测试标签做保守版本。
第二件,把测试选择的状态和执行 worker 分开看。只要有一个进程既存全部历史、又接全部事件,它迟早会成为你们最不想碰的单点。先把状态外置,再讨论怎么分片。
第三件,给 CI 设一个增长假设。Anthropic 的建议很直白,按两季度内 25 倍负载来想。不是说每个团队都会到这个数,而是别再拿去年的线性预估,给 Agent 时代的任务量画明年的容量图。
这几步都不酷,甚至有点像把多年 DevOps 常识重新擦一遍。但当 Agent 开始不停提交代码,旧常识得跑在更高的转速上。真正让人头疼的,往往不是模型突然写错了一行,而是所有人都以为 CI 还会按过去的速度跟上。
你们现在的 CI 最常卡在哪儿,排队、全量测试,还是一堆已经失真的红灯?