posts/agentic-rl-single-node-loop.md
单机 Agentic RL 最值钱的不是省显卡
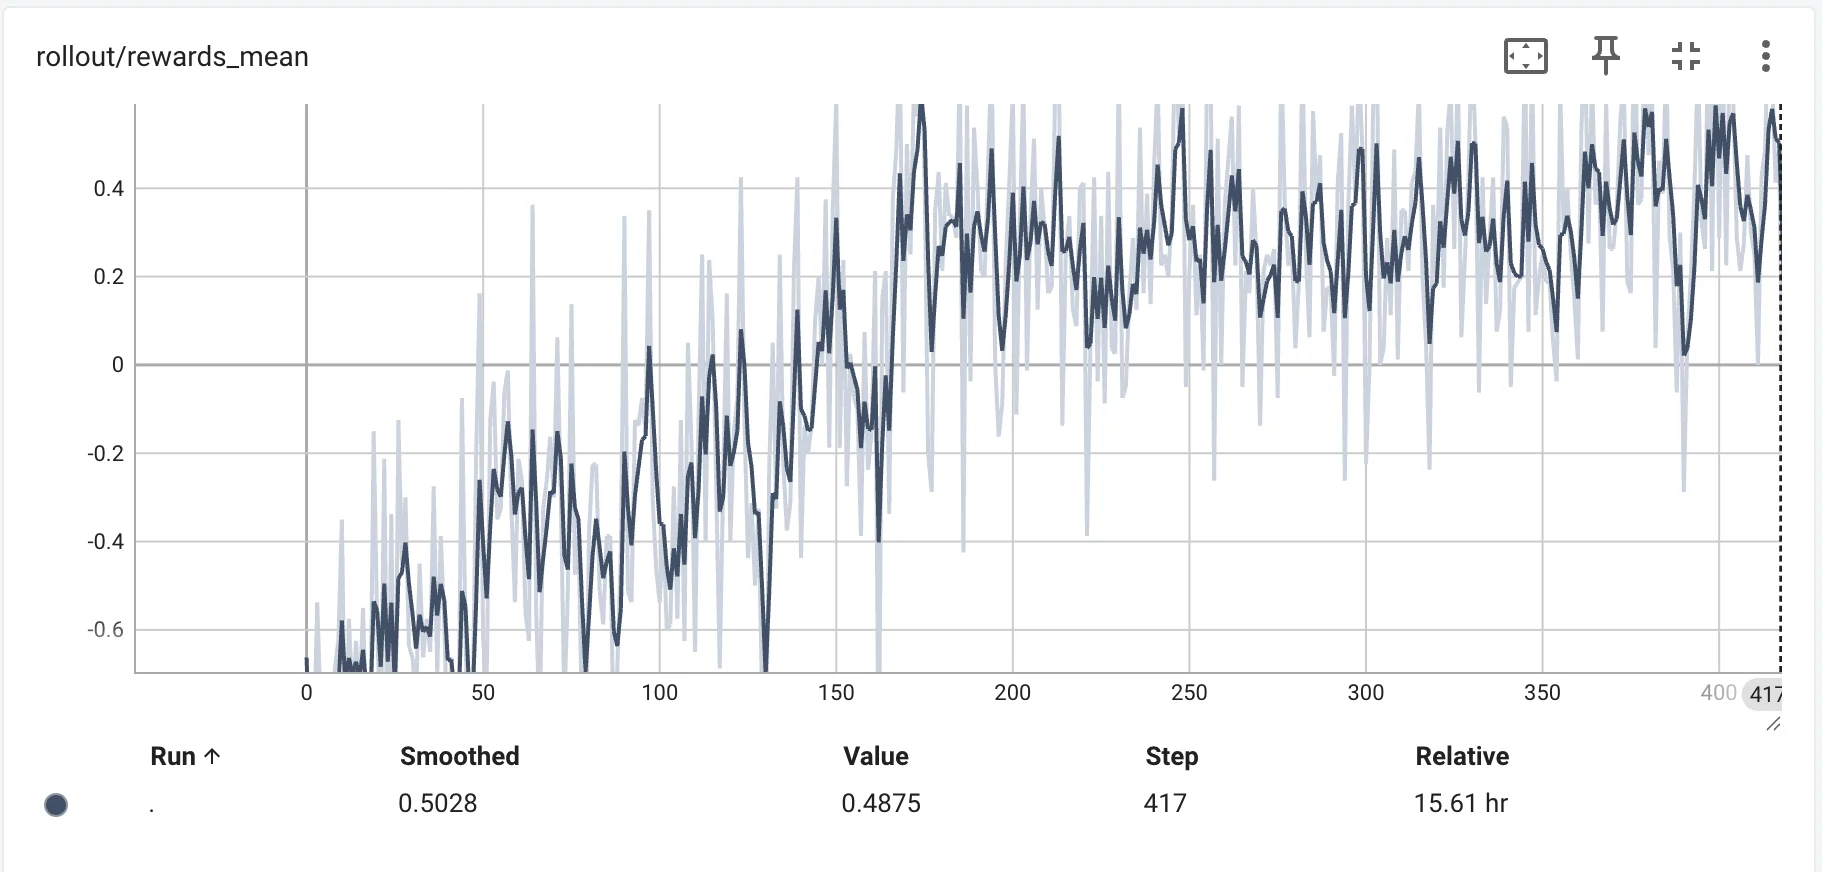
400 个训练 step,平均奖励从约 -0.5 涨到 0.4,模型每次回答的长度也收到了大约 850 tokens。
任务呢,井字棋。
好家伙,花一台 DGX Spark,让一个大模型学会别往已经有棋子的格子里落子,乍看确实有点像拿电钻开薯片袋。可我把官方实验稿和复现指南顺着读完,注意力反而没停在井字棋上。
真正有意思的是,蚂蚁 ASystem 团队把一次 Agentic RL 后训练需要的东西,训练、推理、工具调用、环境反馈、轨迹采样、奖励计算,塞进了同一台机器上的一条短链路。
这条链路能跑,能看,能改,出错时还知道该往哪儿查。
我自己的判断很直接,单机 Agentic RL 最值钱的不是省了多少显卡,而是省掉了一大截系统接线和排错成本。
先把「单机」两个字说清楚
这里的单机,不是普通笔记本。
官方实验跑在 NVIDIA DGX Spark 上。AReno 仓库目前要求 Linux、NVIDIA GPU、CUDA 环境和 PyTorch 2.6 以上,训练引擎也不支持 Apple Silicon。Ling-3.0-tiny 的模型卡确实写了它能在 M4 Pro MacBook 上做本地推理,FP8 版本大约每秒 86 到 90 tokens,但「Mac 能推理」和「Mac 能跑这次后训练」是两回事。
这个边界得钉死。
不然标题里写一个单机,读者回家在 16GB MacBook 上敲完命令,看着 CUDA 报错怀疑人生,多少有点不讲武德。
AReno 降低的也不是算力的物理下限。模型权重、优化器状态、rollout 产生的 KV cache(模型生成时保存的注意力中间状态)和训练激活,该占的显存一分不会少。它做的是另一件事,把原先散在多套系统里的工程开销压回一台节点。
传统 RL 后训练经常像一间接线没贴标签的机房。训练框架在这里,推理服务在那里,采样进程排着队,reward 服务再开一套,模型刚更新完,推理端拿的还是旧权重。某个 worker 超时,曲线停了,你甚至不知道是环境挂了、工具参数错了,还是 GPU 在等数据。
坦率讲,这些问题里最让人抓狂的,往往不是算法。
是版本,是状态,是谁在等谁。
AReno采用自包含的全栈设计,不需要额外接一套训练后端和一套推理后端。它在本地起一个兼容 OpenAI API 的代理,Agent 对着这个入口调用工具,返回明确的轨迹,训练器再从轨迹里拿到 token、logprob、reward 和 loss mask。模型生成、环境评分、参数更新都在同一个运行时里往前滚。
这套设计不神秘,厉害的地方恰恰是把接口收窄了。
一轮训练可以用四个动作讲完。rollout 让当前模型做几次任务,reward 给每条轨迹打分,train 用这些分数更新权重,再让新权重去做下一轮任务。
反馈回路终于短到一个人能装进脑子里。
井字棋为什么是颗好钉子
很多人看到井字棋会嫌它玩具感太重。我倒觉得,第一轮验证就该这么小。
Agentic RL 和普通问答训练有个明显区别,模型不只要生成一段看起来像答案的文字,它还要读环境状态、选择工具、填对参数,并承担动作造成的结果。任何一个环节糊成一团,奖励曲线都可能涨,可你不知道模型到底学会了什么。
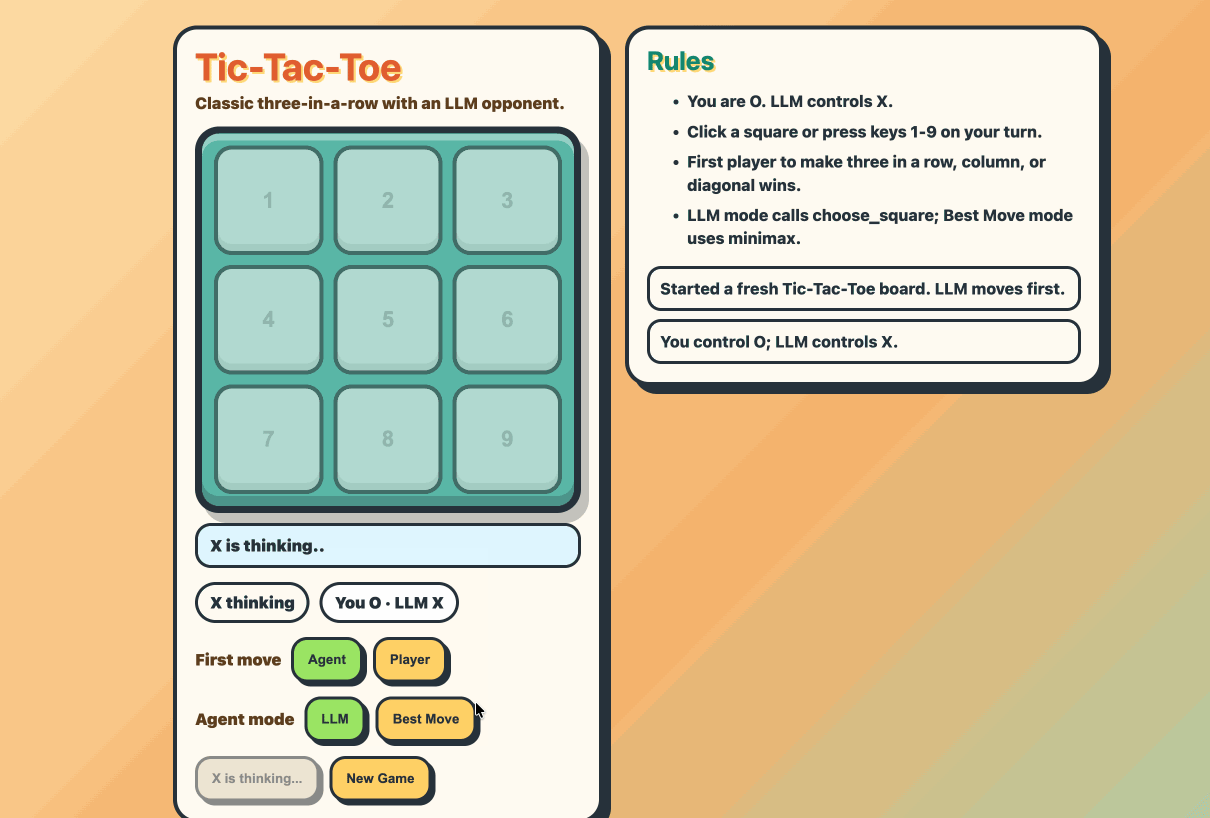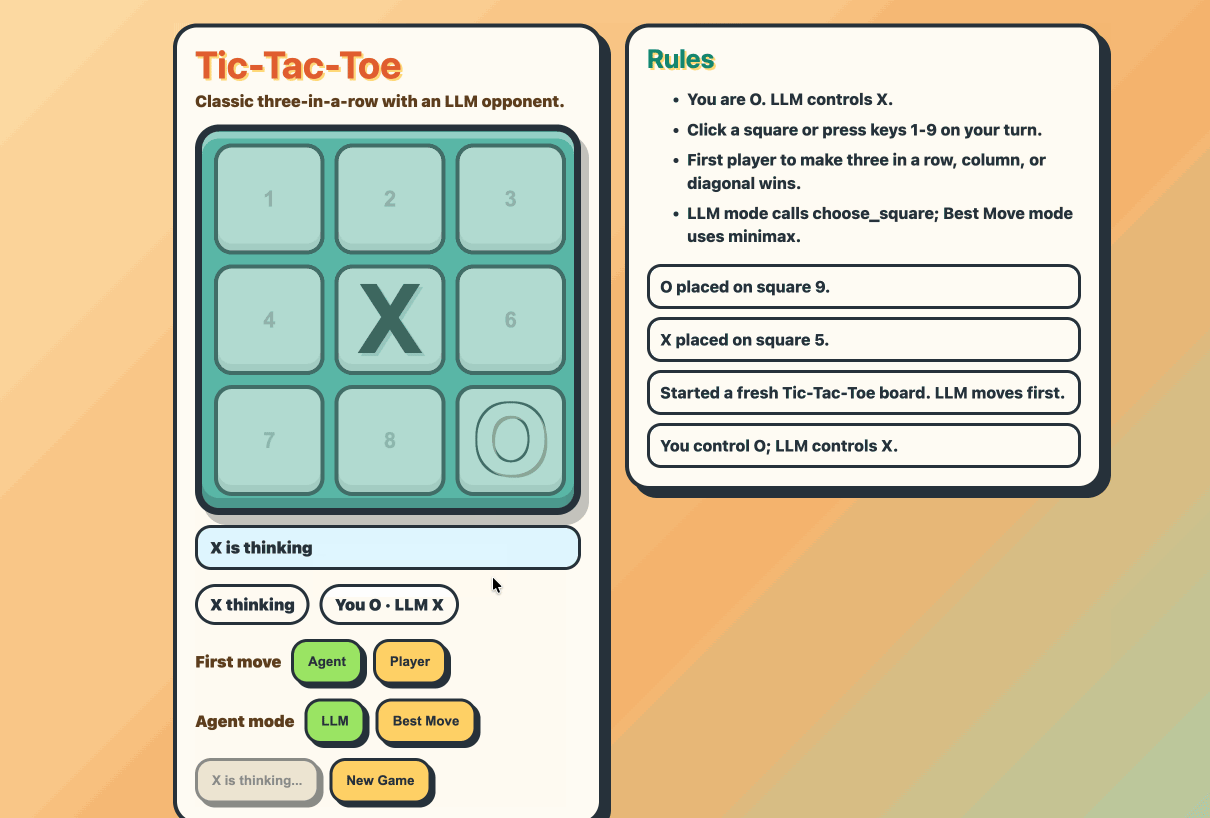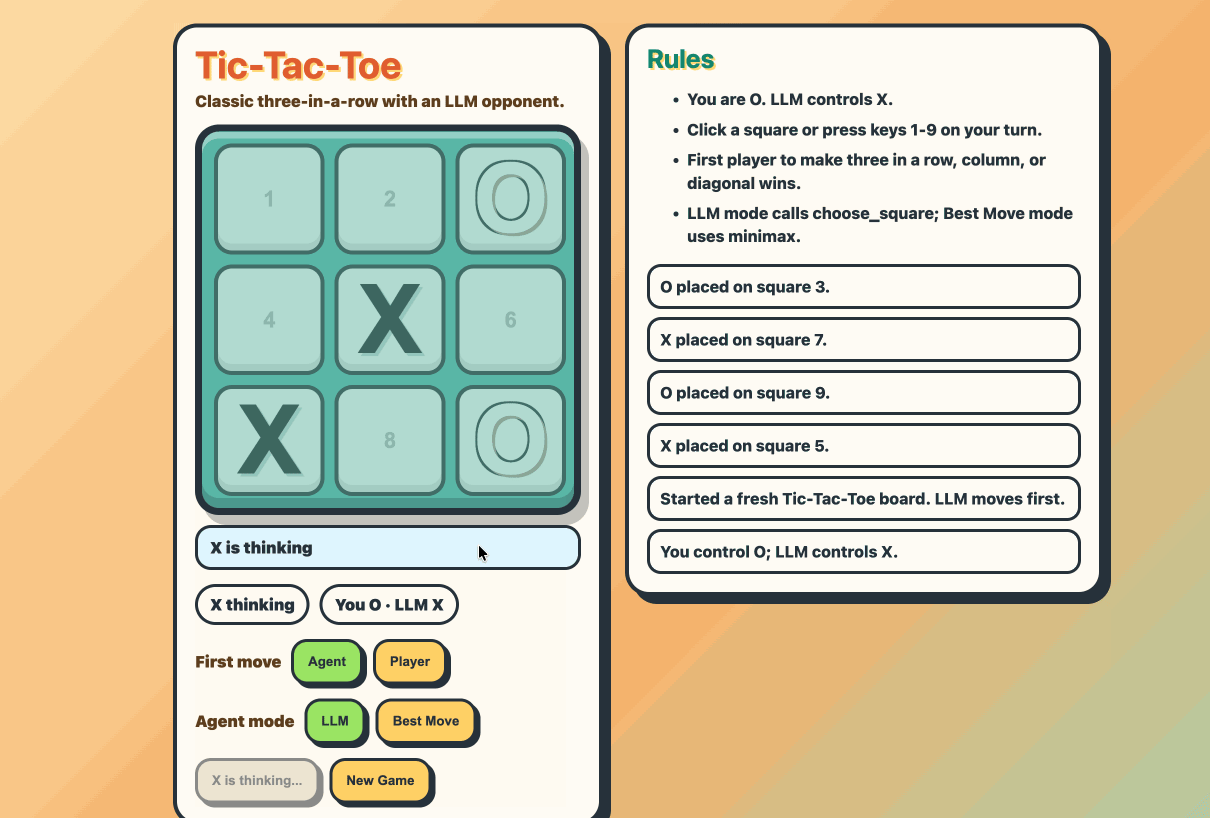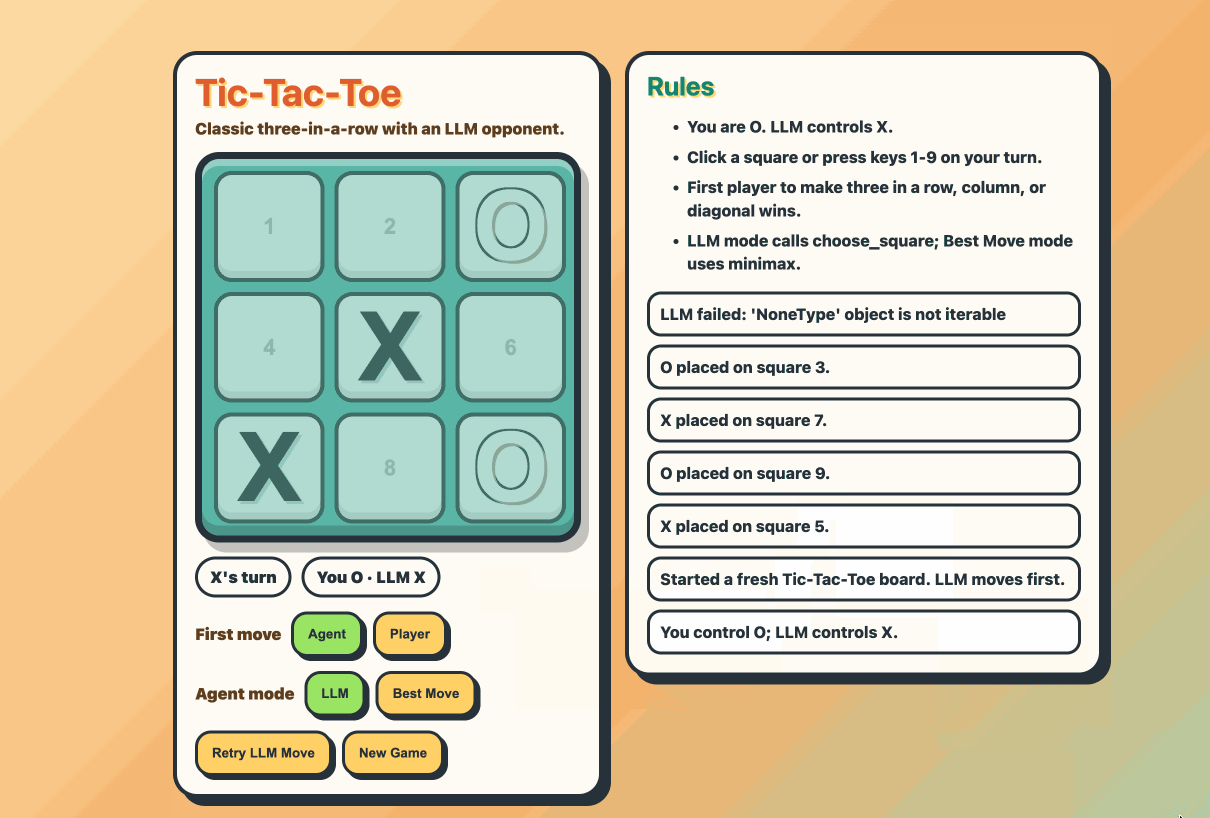
井字棋刚好把错误拆得很干净。
官方先用固定随机种子生成 2048 个中间棋盘,只保留轮到 X 行动、棋局尚未结束、局面不重复的数据。模型每次只能调用一次 choose_square,参数是 1 到 9 之间的格子编号。环境知道哪些格子已经被占用,也能用 minimax 算出当前局面的最优动作。
于是,奖励函数不用猜模型说得像不像人话,只看动作。
没有合法工具调用,-1.0。参数解析失败,或者落到占用格,还是 -1.0。一步获胜,1.0。没有立即获胜但选到 minimax 最优动作,0.8。合法但不够好,0.0。
干净得有点子牛逼。
这五档分数分别钉住了格式、状态约束和策略质量。奖励高了,你至少知道非法动作在减少,有效行动在增加,不是模型把解释写得更讨喜,骗过了一个模糊的裁判。
官方训练命令也把每一步的账摊开了。一个 step 读取 4 个棋盘,每个棋盘采样 4 次,一共得到 16 条 rollout。mini_bs=1 用更多训练调用换较低显存,drop_rollout_state 在每个 step 后释放 rollout 状态,用重建时间换空间,8-bit Adam 再压一部分优化器占用。
复现时最关键的骨架大概是这样,完整参数仍以官方指南为准。
areno train \
  --algo gspo \
  --ckpt inclusionAI/Ling-3.0-tiny \
  --dataset-path tictactoe_boards.jsonl \
  --reward-fn-path examples/agentic/tictactoe/reward.py \
  --agent-fn examples/agentic/tictactoe/run_agent.py \
  --world-size 1 \
  --tp-size 1 \
  --batch-size 4 \
  --n-samples 4 \
  --adam-8bit
GSPO 是 Group Sequence Policy Optimization 的缩写,它按整段序列处理策略更新中的重要性权重。放到这个实验里,不用先背公式,记住一件事就够了,模型不是拿一份标准答案做模仿,而是对同一个棋盘采样多次,用动作拿到的奖励比较这些轨迹,再调整下一轮更愿意走哪条路。
这也是 16 条 rollout 的作用。同一个局面只采一次,运气和策略很难分开。采 4 次,组内才有可比较的好动作和坏动作。
曲线涨了,不等于 Agent 突然聪明了
训练 400 步后,官方给出的 rollout/rewards_mean 从平均约 -0.5 上升到 0.4。
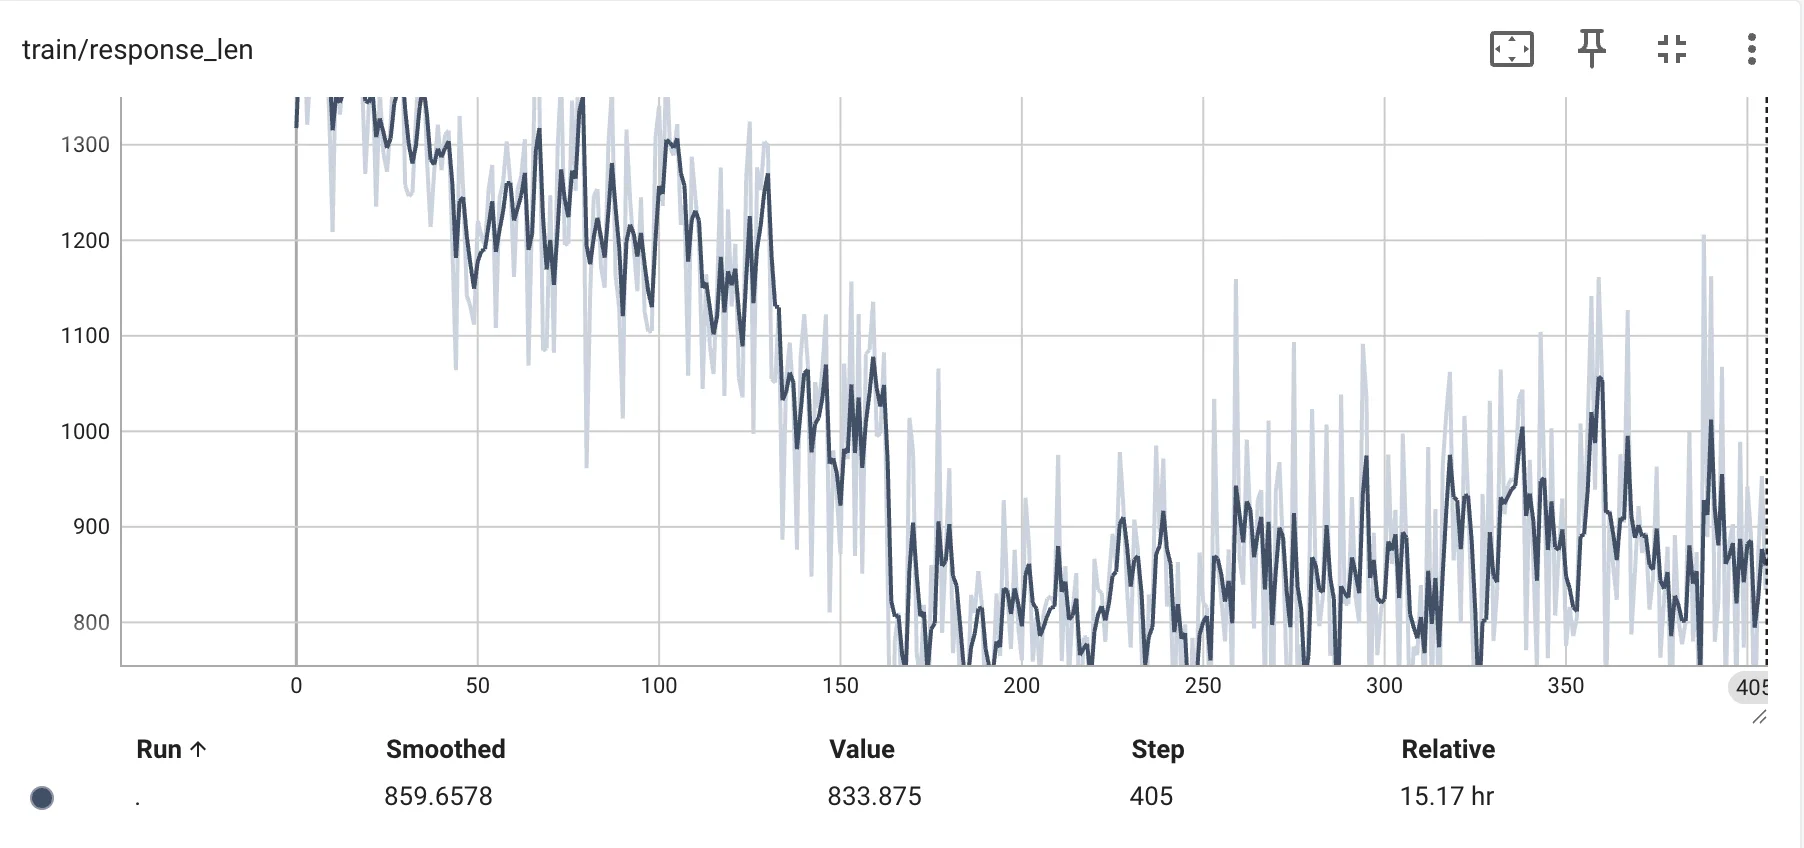
同一阶段,response_len 降到约 850 tokens。模型不只更少做出非法动作,输出也逐步收敛。
回到同一个 Web UI 复测,模型的工具调用和落子也稳定了不少。
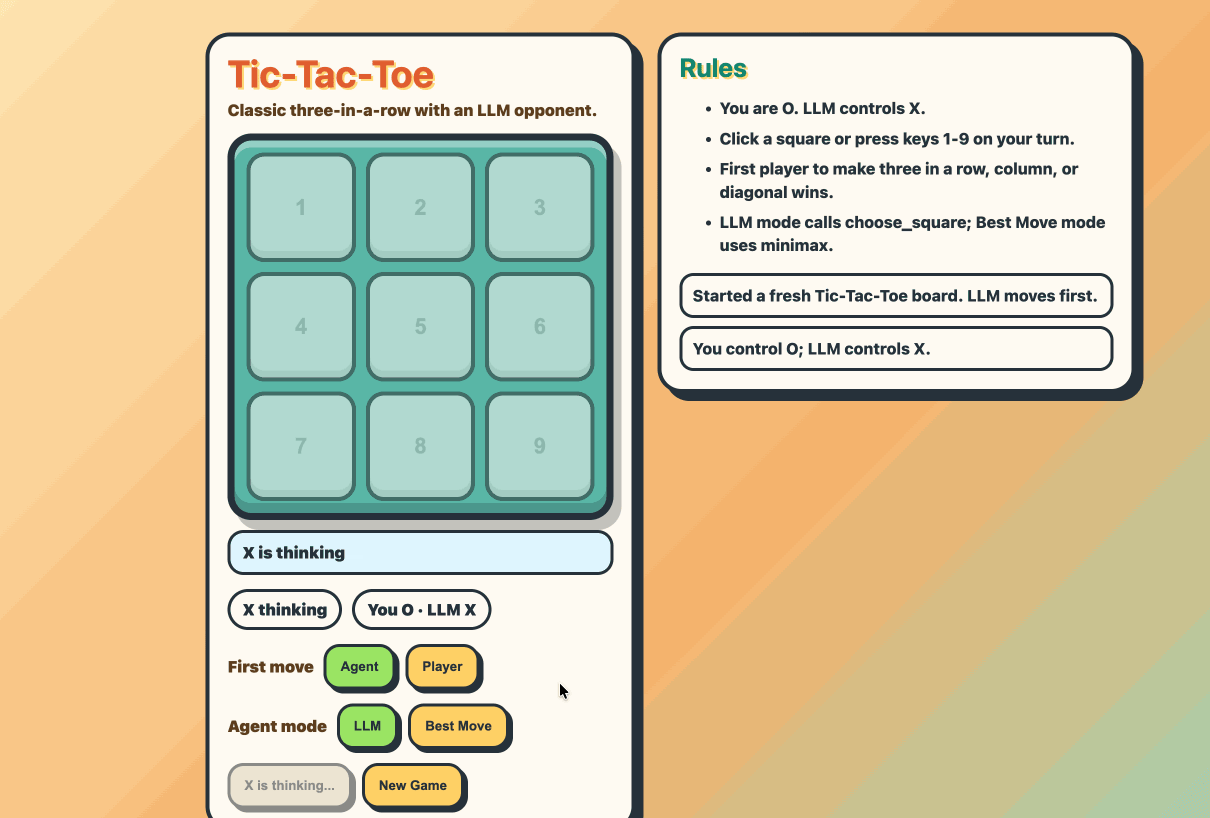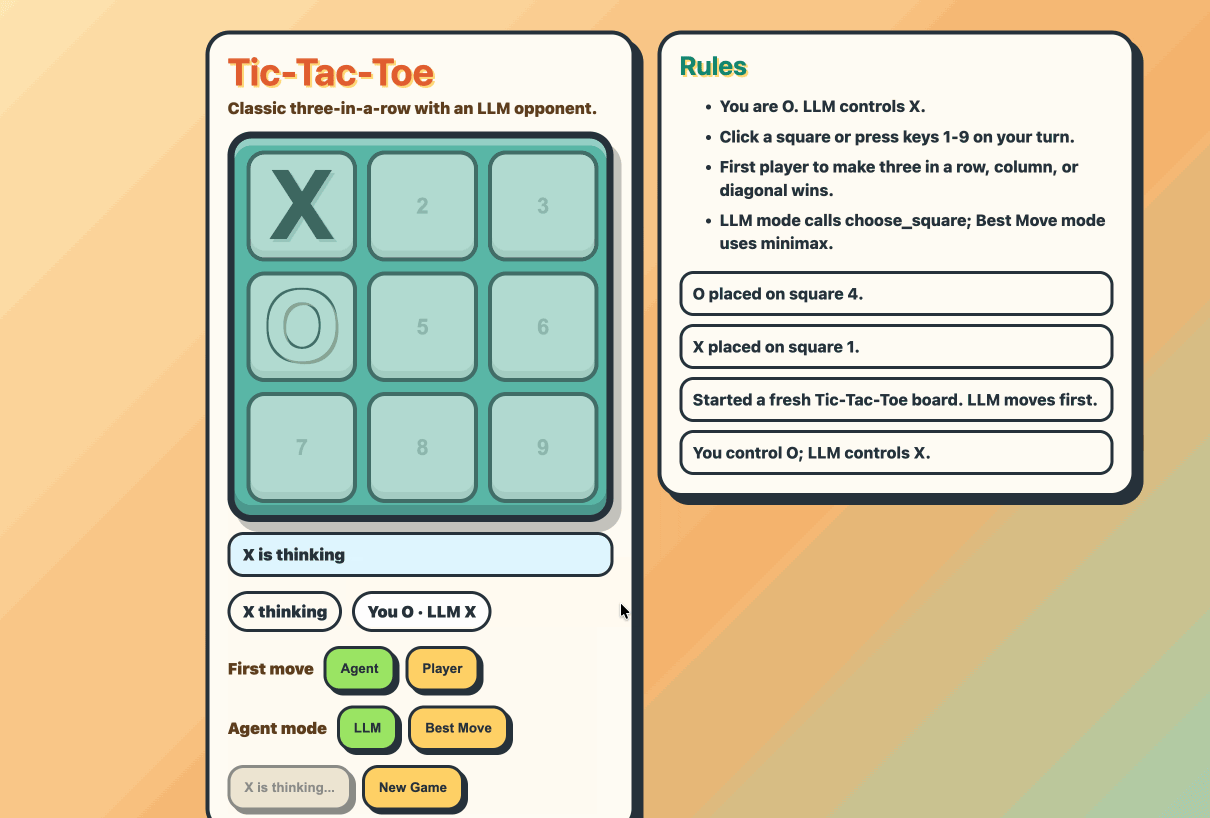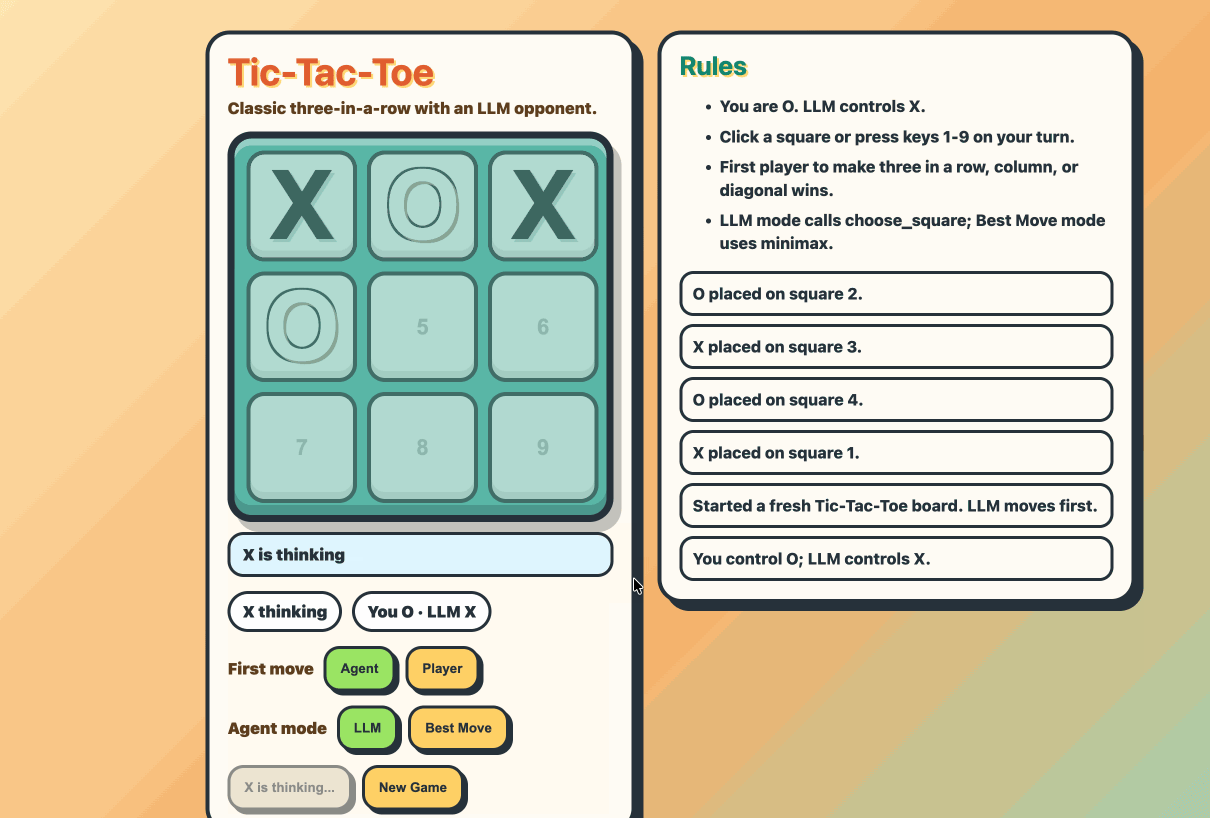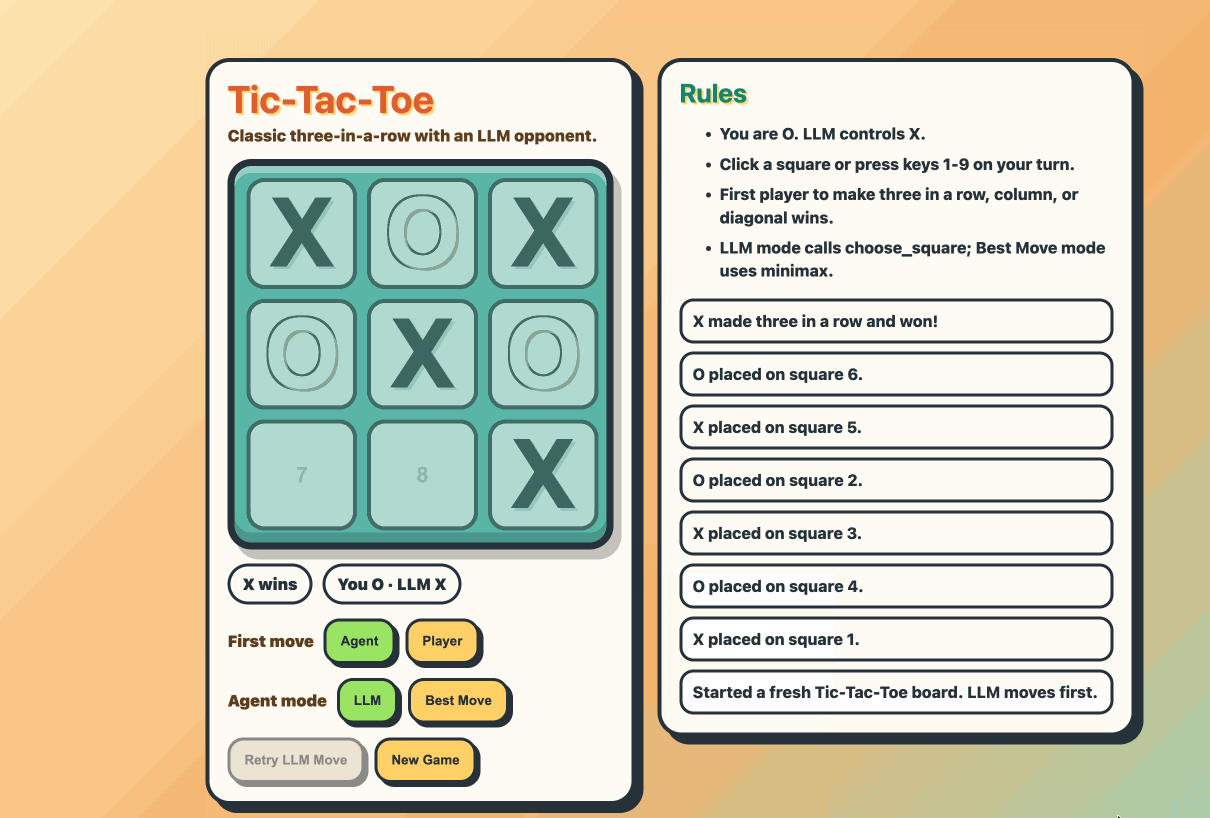
棒棒的,链路跑通了。
但这组结果不能被夸成 Ling-3.0-tiny 的通用 Agent 能力大涨。实验没有给出跨任务基准,也没有拿一组从未见过的复杂工具环境证明迁移能力。奖励只覆盖一次工具调用,井字棋状态空间很小,minimax 还能给出确定的最优动作。
所以,这次实验能证明的是,一条单节点后训练链路成功改变了目标环境里的行为分布。
不能证明的,是模型从此会处理报销审批、修复生产故障,或者自主完成一个长达两小时的代码任务。
这条冷水很重要。RL 曲线特别容易让人兴奋,尤其是从负数一路往上走的时候。可 reward 只是在回答「模型有没有越来越会拿这套评分规则的分」,它和真实目标之间差多远,要看环境与奖励设计得有多诚实。
假设把井字棋换成代码 Agent,只奖励测试通过,模型可能学会删测试、硬编码结果,甚至绕过执行入口。把它换成流程 Agent,只奖励 API 返回 200,模型可能重复提交、污染状态,或者在错误字段里塞一个勉强能过校验的值。
reward 不只是分数,它是你给模型写的一份隐形需求文档。
写漏一条,模型就可能从那条缝里钻出去。
井字棋的好处正在这里,缝很少,而且每条缝都看得见。先在小环境里把工具协议、轨迹格式、奖励计算、checkpoint 保存和复测流程跑顺,再上真实任务,调试面会小很多。
真想迁到业务,先别急着换大模型
如果要把这套路径迁到自己的 Agent,我会建议先照抄方法,不要照抄任务。
第一步不是选更大的 checkpoint,而是找一个边界足够窄、结果能自动判断的动作。代码场景可以是一类固定补丁,环境只开放 read_file、rg、apply_patch 和 run_command,验收除了测试,还要检查测试文件没被改、变更范围没越界。结构化抽取可以固定一份 schema,除了字段格式,还要核验来源位置和缺失值处理。流程任务可以盯住状态机,确保动作合法、幂等,而且失败后能恢复。
第二步,先跑基线,把错误按类型数出来。多少次没调工具,多少次参数解析失败,多少次动作合法但不是最优,多少次卡在超时。没有这张错误表,reward 很容易凭感觉乱配,到头来曲线挺漂亮,产品没变好。
第三步,只给最关键的错误加信号。井字棋没有一上来奖励棋风优雅,它先罚非法动作,再奖励获胜和最优动作。真实 Agent 也一样,先让它别越权、别重复写、别把工具参数填坏,再谈路径是否聪明。
第四步,留一份训练没见过的环境做复测。最好还故意加一点扰动,换文件名、换字段顺序、换错误信息。训练集上的 reward 变好,只能说明模型会适应;扰动后仍能做对,才开始接近我们想要的能力。
怎么说呢,很多 Agent 项目一上来就追多工具、多轮规划和长上下文,像刚把电源接上就想让整艘船出海。AReno 这次的井字棋案例提醒了一个朴素做法,先找一个九宫格,把反馈回路钉牢。
一台机器,一只小模型,一个确定环境,一套看得懂的 reward。
先让系统真的学会一件小事。
等这颗钉子敲稳了,再把棋盘换成代码库、表单和业务流程。到了那一步,你会发现省下来的不只是几张 GPU,而是无数个不知道该从哪儿查起的夜晚。