posts/ai-book-flood-attention-economics.md
AI 书卖得更差,人类作者收入还是一起掉了
38.3 倍。
这是 2023 年一季度到 2026 年一季度,研究样本里累计上架书目的增长幅度。
同一段时间,每季度真正卖出去的书只增长 19.2 倍,销量增长 7.3 倍,收入增长 8.9 倍。
好家伙,货架扩张的速度,比钱流进来的速度快了四倍多。
这组数字来自一篇刚被重新挖出来的市场研究。四位研究者分析了亚马逊上 14,419 本自出版类型小说,做全文 AI 检测,再匹配到 2026 年 6 月的每日销量、收入和排名。
结论挺扎人的。
含大量 AI 文本的书,单本卖得确实更差。可它们没有安静地躺在长尾里吃灰,而是靠数量拿走越来越多销量和头部排名。更麻烦的是,无 AI 文本的书,单书收入也在多数类型里往下掉。
先把边界说清楚。这是一项观察性研究,不是随机实验。它不能证明每一块收入下跌都由 AI 书造成,也看不到亚马逊推荐和广告系统内部怎么分配曝光。
研究选中这块市场也不是偶然。Kindle Direct Publishing 把出版、定价和上架交给作者,传统出版社那道闸门不在了。自出版类型小说本来就依赖高频上新和固定套路,是长篇生成成本下降后最早出现规模效应的地方。它像一张提前三年的压力测试报告,先让我们看到货架无限扩容、注意力不扩容会发生什么。
但它捕捉到了一条很有用的曲线,当生产成本接近零,市场不一定变得更繁荣,也可能先变得更拥挤。
做 AI 内容的人要看,做 Agent、插件、模板和开发者工具的人也该看。因为这条曲线,正在从书架爬向软件货架。
单本不行,照样能把市场挤薄
论文用 Pangram 3.3 扫描书籍全文,把样本分成无 AI 文本、轻度 AI 文本,以及 AI 文本占比超过 25% 的三组。检测器在留出集上的加权误报率是 0.04%,漏报率是 0.14%,团队还换了多组阈值复算,方向没有翻转。
结果里有个很容易被读反的地方。
大量 AI 文本书占全部书目的 20%,只拿到 12.1% 的销量和 11.3% 的收入。无 AI 文本书占 62.9%,却拿到 71.7% 的销量和 72.5% 的收入。到了销量前 5%,大量 AI 文本书的占比只剩 10%。
如果看到这里就说「AI 书不行,市场会自己淘汰」,那就漏掉了分母。
11.3% 不是零。
当生产者可以用很低的成本连续上架,单本弱一点完全能被数量补回来。一本书只分走一小口注意力,几千本加在一起,照样能挤进销量榜、推荐位和订阅池。
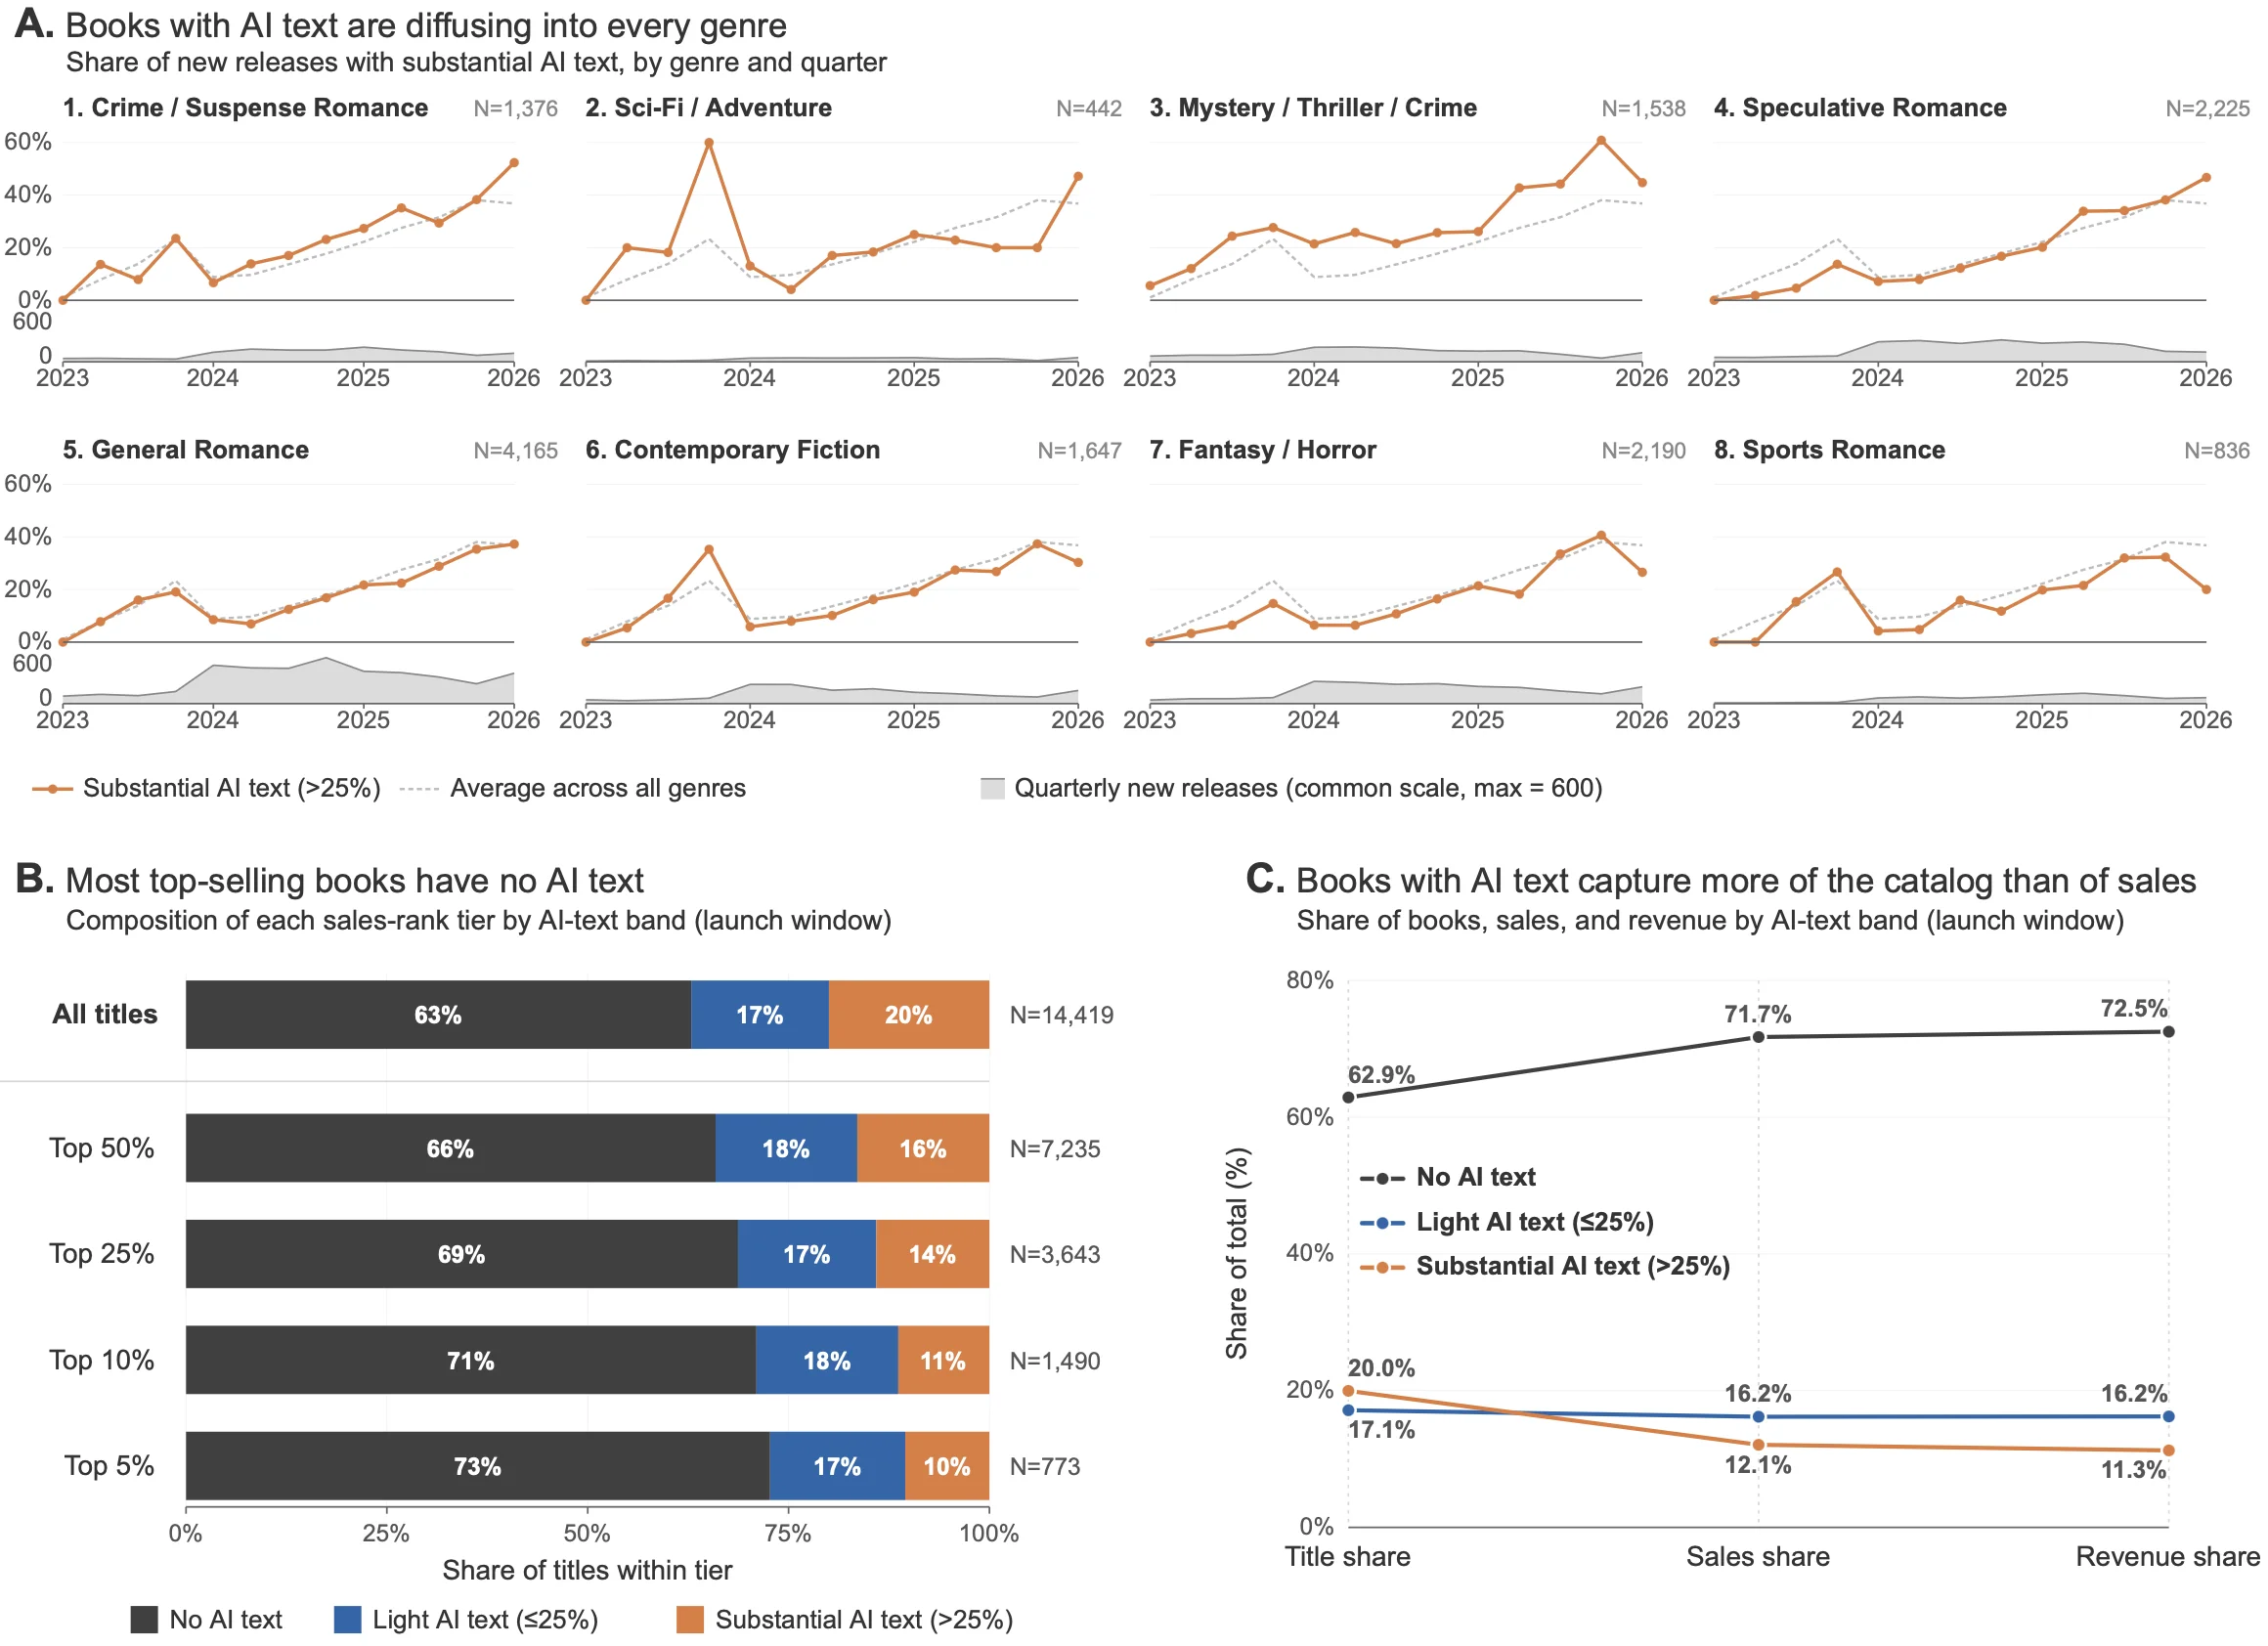
论文图 1,橙色代表 AI 文本占比超过 25% 的书。它们单本表现偏弱,却已经拿到真实的销量与收入份额。
程序员对这事不陌生。
一条质量一般的自动 PR 进不了主干,没什么大不了。一天来两千条,review queue、CI 分钟数和维护者注意力就都得重新算。代码仓库不会因为每条 PR 都不够好,自动免疫掉审查成本。
内容平台也一样。它真正稀缺的从来不是字数,而是读者的一次点击、一个推荐位、一段完整阅读时间。
AI 把供给端的阀门拧开了,需求端却没跟着扩容。
这才是论文里最有点子牛逼的判断。低质量供给不需要在质量上打赢,它只要在规模上占住货架。
最狠的曲线不是销量,是供给
再看那四条增长线。
累计书目增长 38.3 倍,有销量的书增长 19.2 倍,销量增长 7.3 倍,收入增长 8.9 倍。
市场不是没长。买书的人更多了,钱也更多了。只是新书冒出来得更快,快到每本书平均能分到的那块蛋糕反而变小。
研究团队为了避免新书观察时间短,统一比较上架前预售加上架后 90 天的收入。2023 年到 2025 年,所有书的单书收入在八个类型里有六个下降。把 AI 书剔掉,只看无 AI 文本书,八个类型里仍有七个下降。
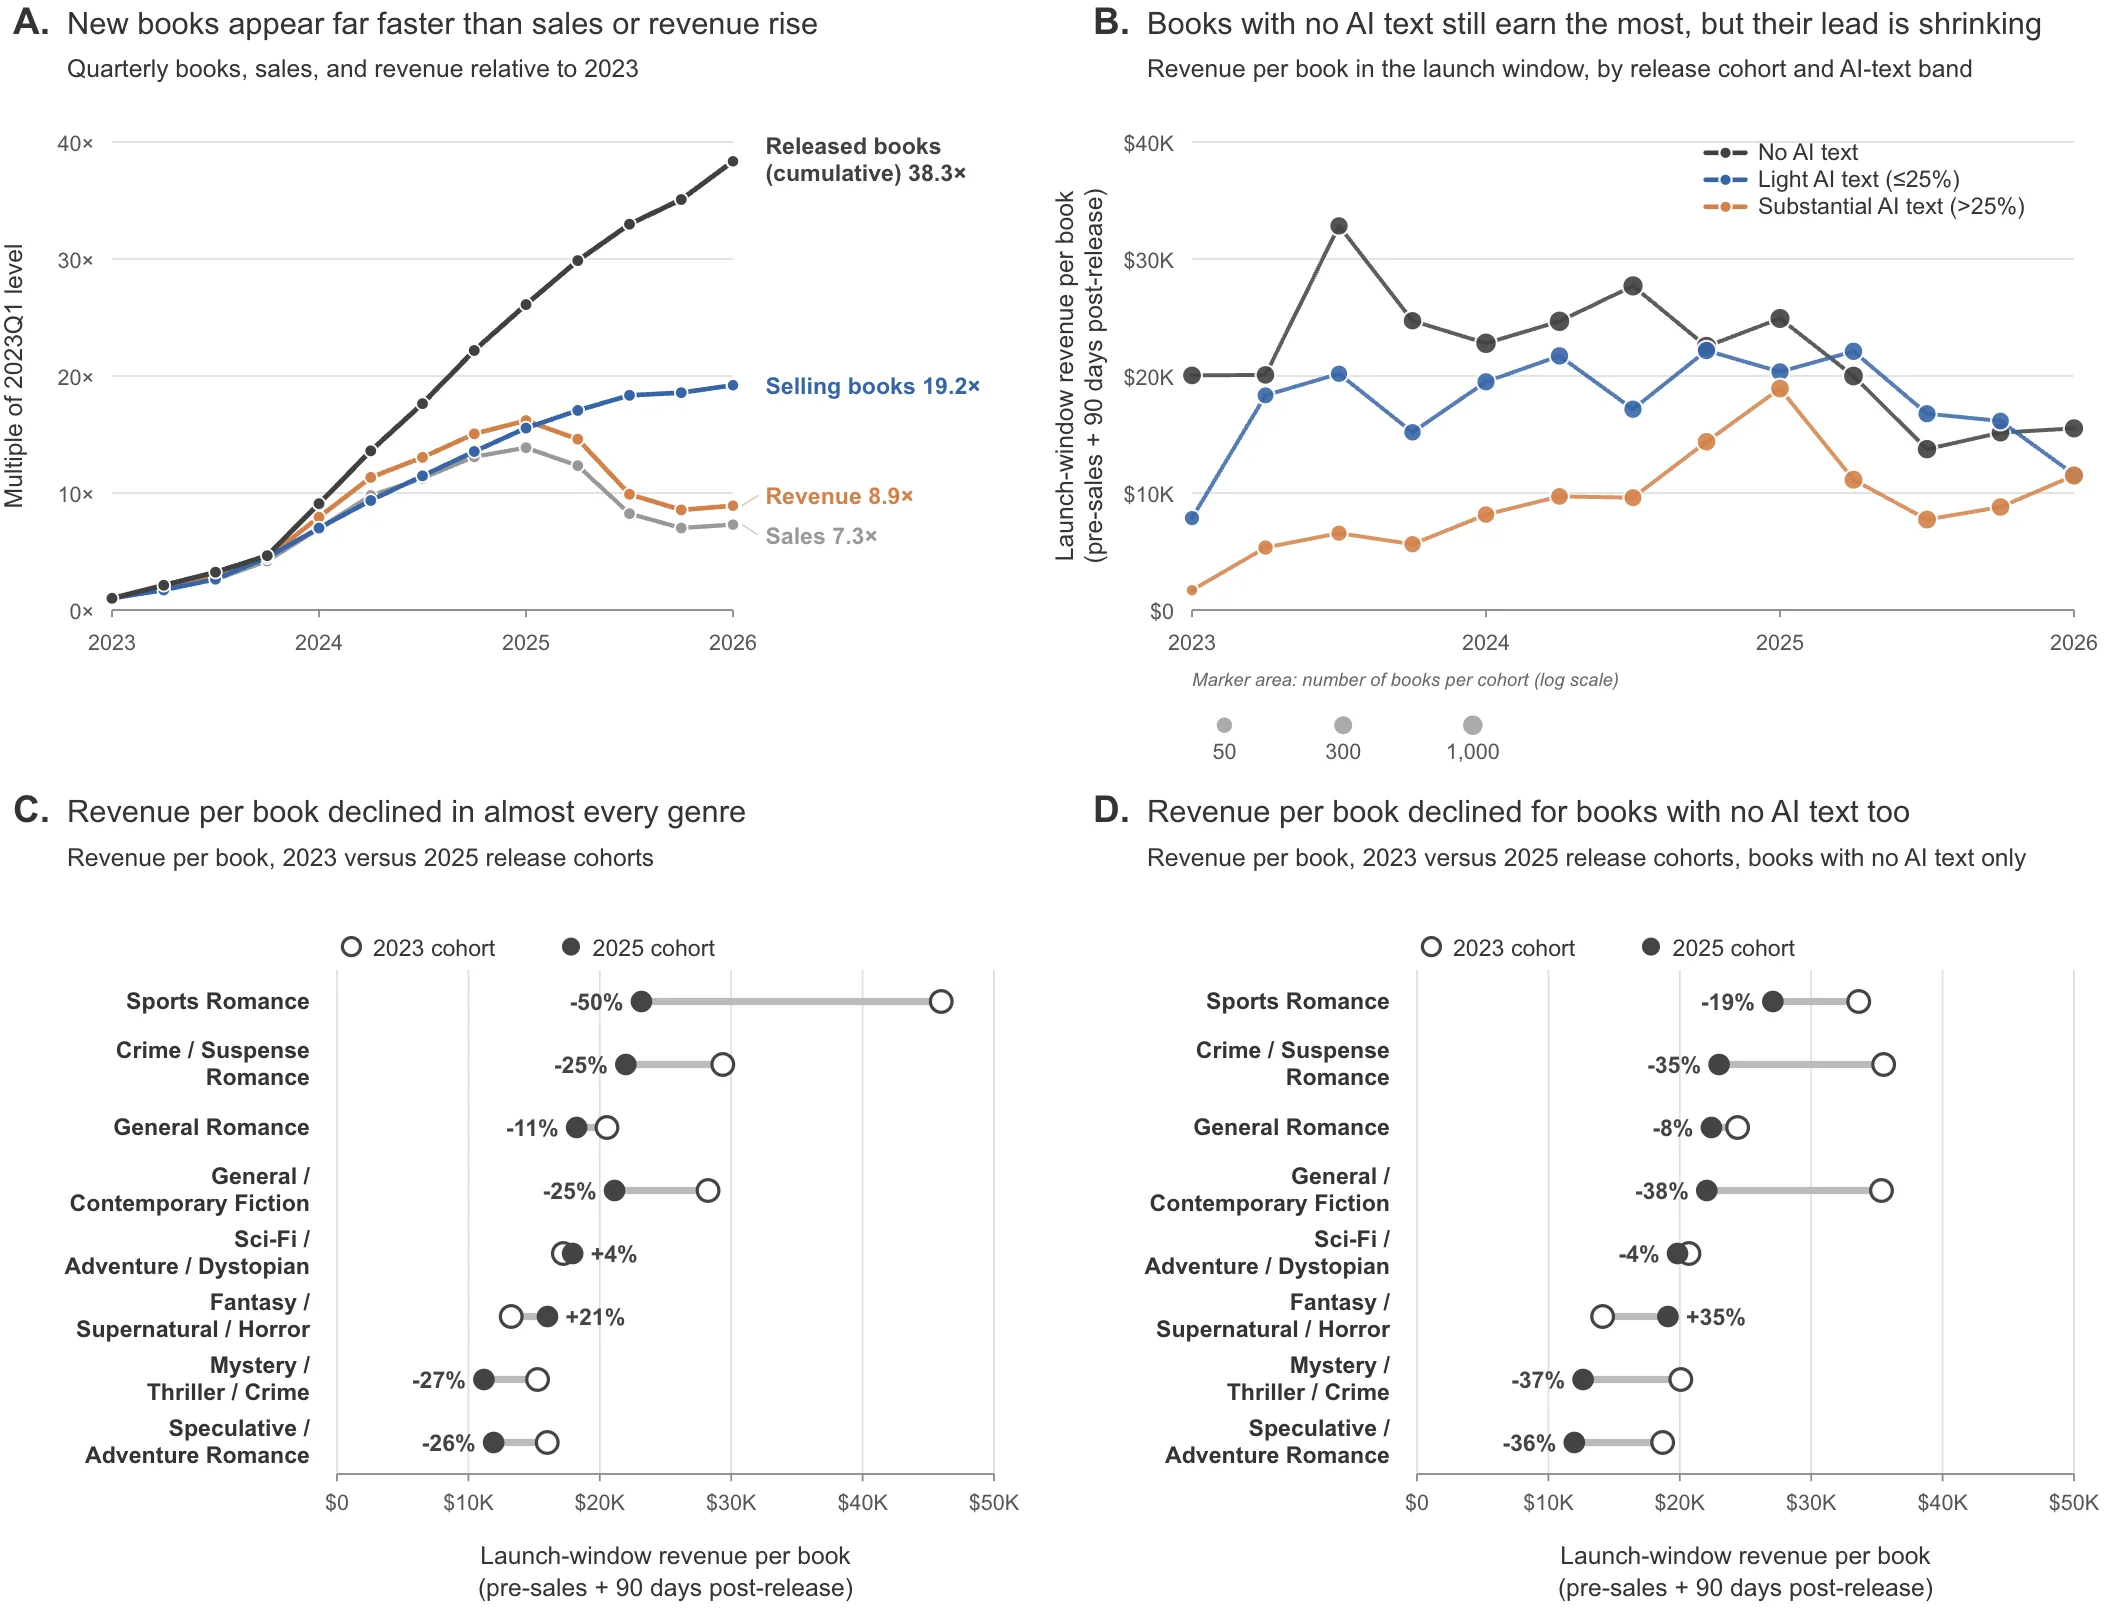
论文图 3,供给曲线冲到 38.3 倍,销量和收入停在 7.3 倍与 8.9 倍。右下角显示,无 AI 文本书的单书收入也普遍下滑。
坦率讲,我觉得这比「AI 会不会取代作者」重要得多。
取代是一个很戏剧化的问题,稀释却是每天都在发生的分母变化。没有谁突然失去工作,没有哪本书单独把谁打败,大家只是发现同样的时间和努力,能换回来的点击、收入和排名少了一截。
把书换成 AI 产品,这个画面更眼熟。
一个 Agent 外壳、一套提示词、一个浏览器插件,现在都能很快做出能跑的 demo。README、落地页、演示视频和上架文案,也可以一起生成。棒棒的,生产链路从几周压到几小时。
然后呢?
用户每天愿意试的新工具数量没有涨 38.3 倍。企业愿意给的采购预算没有涨 38.3 倍。GitHub Trending、应用商店推荐位和微信群里的耐心,更没有涨 38.3 倍。
当大家都能快速生产,速度很快会从优势变成入场券。真正贵的部分会挪到后面,评测集是不是可信,失败能不能重试,数据敢不敢交进去,升级后会不会把旧流程弄坏,出了事故有没有 trace,能不能回滚,三个月后还有没有人维护。
这些活不适合截图,也不太像发布会金句。
偏偏这些才是产品。
订阅池会把问题放大
论文还有一段很像云服务限额的观察。
Kindle Unlimited 是亚马逊的电子书订阅服务。读者付一份订阅费,从共享书库里阅读,作者们再争同一个借阅和分成池。研究发现,在 KU 覆盖高的类型里,无 AI 文本书相对大量 AI 文本书的销量领先少了 8.5 个百分点,收入领先少了 8.4 个百分点。
新书不是凭空创造一份新预算,它更像往同一个 token budget 里再塞一个长任务。
单看每个任务都合理,放在共享配额里就开始抢资源。
这也解释了为什么量产是一种理性选择。论文追踪了作者第一次发布大量 AI 文本书前后的产量。在后来继续使用 AI 的 385 个作者身份里,287 个提高了月产量。收入最高的一个作者身份,用 8 本书产生了 170 万美元消费者总支出。收入最高的一本,大约卖出 80,431 本,带来 64.3 万美元。
说真的,面对这种反馈,继续加产量一点也不荒唐。对单个生产者来说,多上架、多测试、多押几个题材,完全符合激励。
问题出在系统层。
当平台允许近零成本供给无限涌入,却仍用有限的推荐位、搜索页和订阅池分配价值,个体最理性的动作叠在一起,可能得到一个谁都不太喜欢的市场。货架越来越满,筛选越来越贵,普通作品越来越难被看见。
这不是道德故事,也不是劝大家别用 AI。
反正我不会。AI 把重复劳动压掉,当然该用。真正要改的是指标,别再把「今天产了多少」当成胜利,把读者是否留下、结果能否复核、产品能否持续维护放到前面。
卖得好的,还留下另一道影子
论文最敏感的一组结果,来自「稀有表达重合」。
研究者找出至少五个词、只在 Google Books 最多五本书中出现、并且在 4.7 万亿 token 的互联网快照里完全找不到的表达。它们不是「夜色很美」这种通用句,而是更接近某几本既有作品留下的语言指纹。
在收入前 50 的样本里,大量 AI 文本书平均有 45.0% 的 token 落入这类稀有表达,无 AI 文本书是 37.7%,差 7.2 个百分点。更怪的是,在头部 AI 书中,收入每增加 10 倍,稀有表达覆盖率跟着上升约 7.6 个百分点;无 AI 文本畅销书没有相同关系。
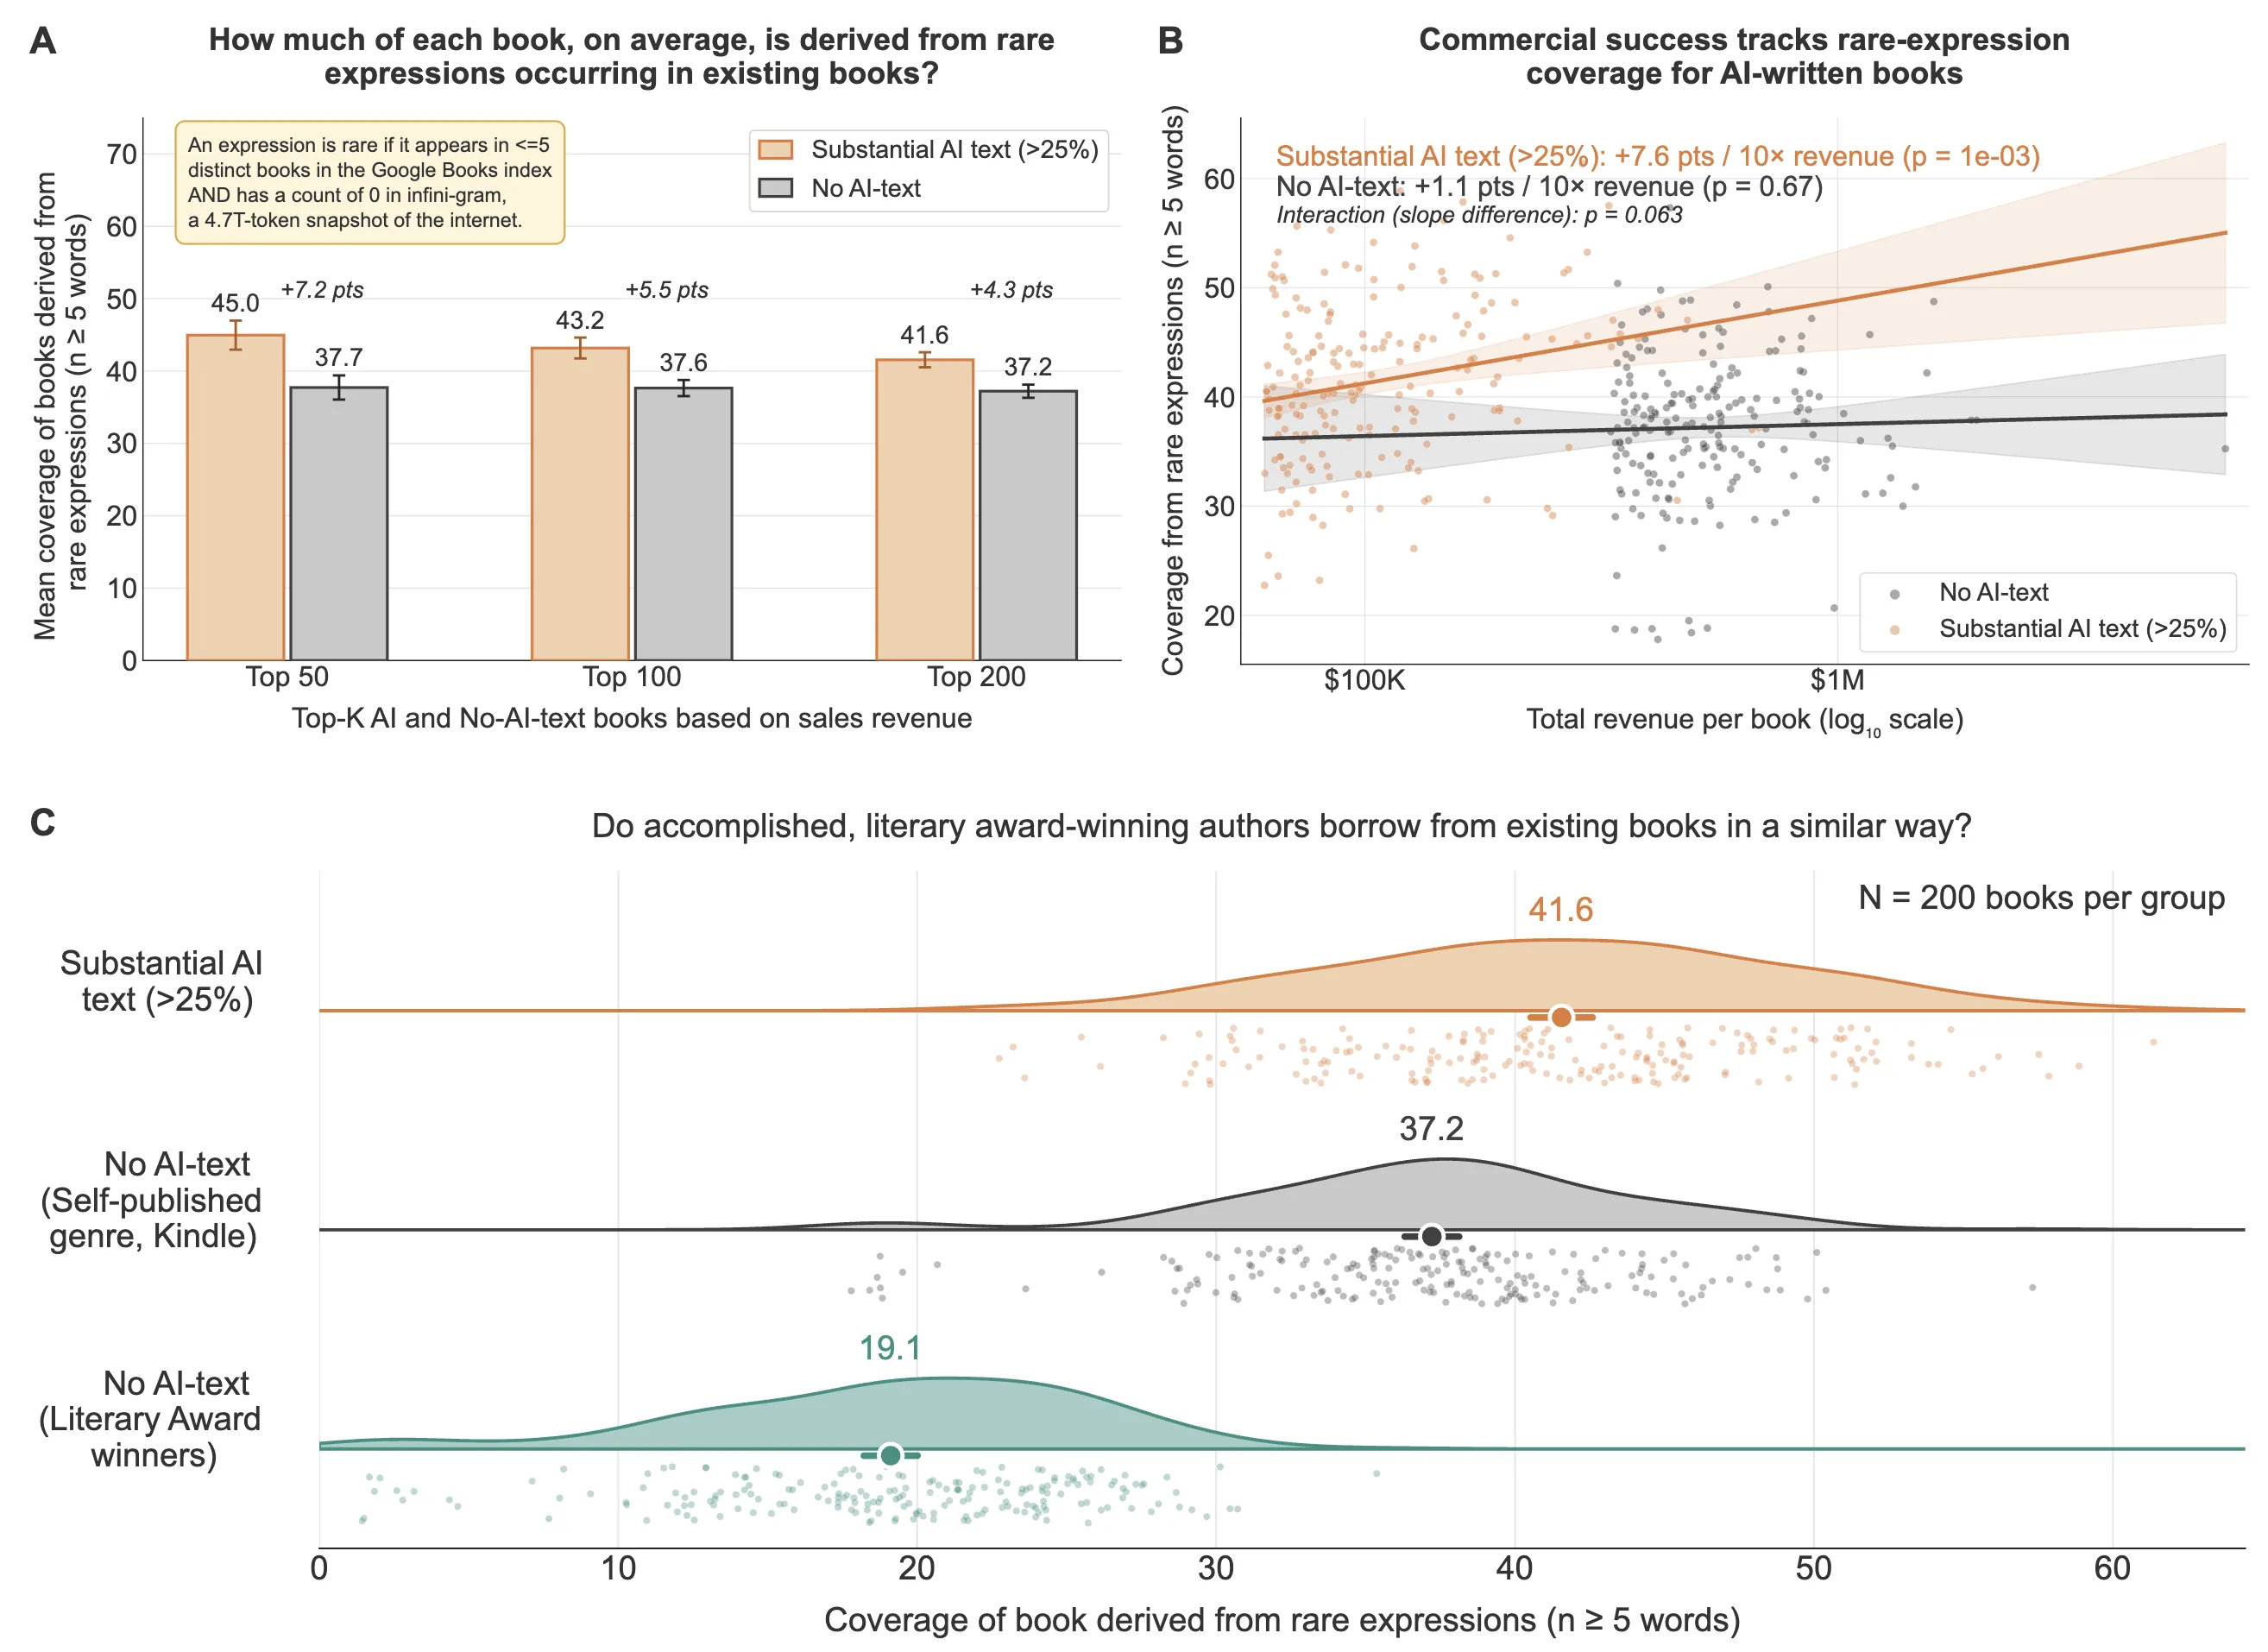
论文图 5,橙色为大量 AI 文本书。研究测到的是文本重合,不等于认定任何一本书构成侵权。
这里一定要克制。文本重合不是法律判决,也不能证明某本书逐句复制了另一部作品。研究作者自己也把结论限定为市场层面的关联,完整方法与限制写得很清楚,处理代码也放在 BookSlop 仓库里。
但对创作者和开发者,它还是给了一记提醒。
当模型把平均水平抬得很高,最容易规模化的往往也是最容易同质化的部分。你可以更快地产出一个看起来完整的东西,却很难靠「完整」获得长期优势。
那该守什么?
我会先守第一手证据。真实跑过的命令、公开可查的数据、失败截图、复现步骤,比一段顺滑结论值钱。再守可验证性,让读者知道数字从哪来,让用户知道 Agent 做了什么,别把所有过程藏进一个漂亮回答里。
分发也得当成产品能力,而不是写完之后顺手发一下。货架无限,读者有限,可信渠道和稳定关系会比生成速度更贵。还有维护,今天能生成十个插件不稀奇,半年后还在修 bug、跟依赖升级、补安全边界的那个,才可能留下。
模型可以把船造得飞快。
可当海面上一夜之间多出 38.3 倍的船,稀缺的就不再是船,而是航道、罗盘,以及有人愿意相信你能把它开到岸上。
收入只涨了 8.9 倍。