posts/ai-compute-usable-capacity.md
算力翻到 2.8 倍,成本未必跟着降
2185 EFLOPS。
这不是哪家新模型的跑分,而是截至 2026 年 6 月底,全国智能算力的总规模。EFLOPS 是每秒百亿亿次浮点运算,这里的统计口径是 FP16,也就是大模型训练和推理常见的半精度计算。
国家发展改革委在 7 月底的新闻发布会上给了另一种更直观的说法,全国智能算力规模已经达到去年同期的 2.8 倍。同一批公开数据里,还有首个全国产 10 万卡 AI 超集群投用、国产大模型全球下载量突破 100 亿次、高质量数据集超过 12 万个、相关行业保持 30% 以上增长。
好家伙,单看这张成绩单,算力像是开闸放水了。
可屏幕前做 AI 应用的朋友,大概马上会冒出一个不太合群的问题。
卡多了接近两倍,为什么推理账单没有自动砍掉一半,繁忙时段的队列没有凭空消失,本地适配一张新卡还是可能卡在驱动、算子和框架版本上?
因为新闻里的 2.8 倍,说的是全国算力供给的盘子。开发者真正拿到手的,是某个时间、某个地域、某套软件栈里,能按预期完成一次任务的有效算力。
两者中间,隔着一条很长的管道。
我觉得,这次最值得聊的不是中国又有多少卡,而是算力行业已经进入下一道题。硬件规模继续涨当然重要,但决定体验的瓶颈,正在从有没有卡,移到卡能不能被调度、数据能不能及时送到、模型能不能稳定跑完、结果值不值得付钱。
算力总量是国民生产总值,有效算力更像你这个月真正能花的钱。
2.8 倍说的是盘子,不是每个请求
国家发展改革委新闻发布会的公开信息写的是达到去年同期 2.8 倍。人民日报披露的工信部数据更具体,截至 6 月底,全国智能算力规模达到 2185 EFLOPS,同比增幅为 177%。一个是四舍五入后的倍数,一个是同比增速,两组数字基本对得上。
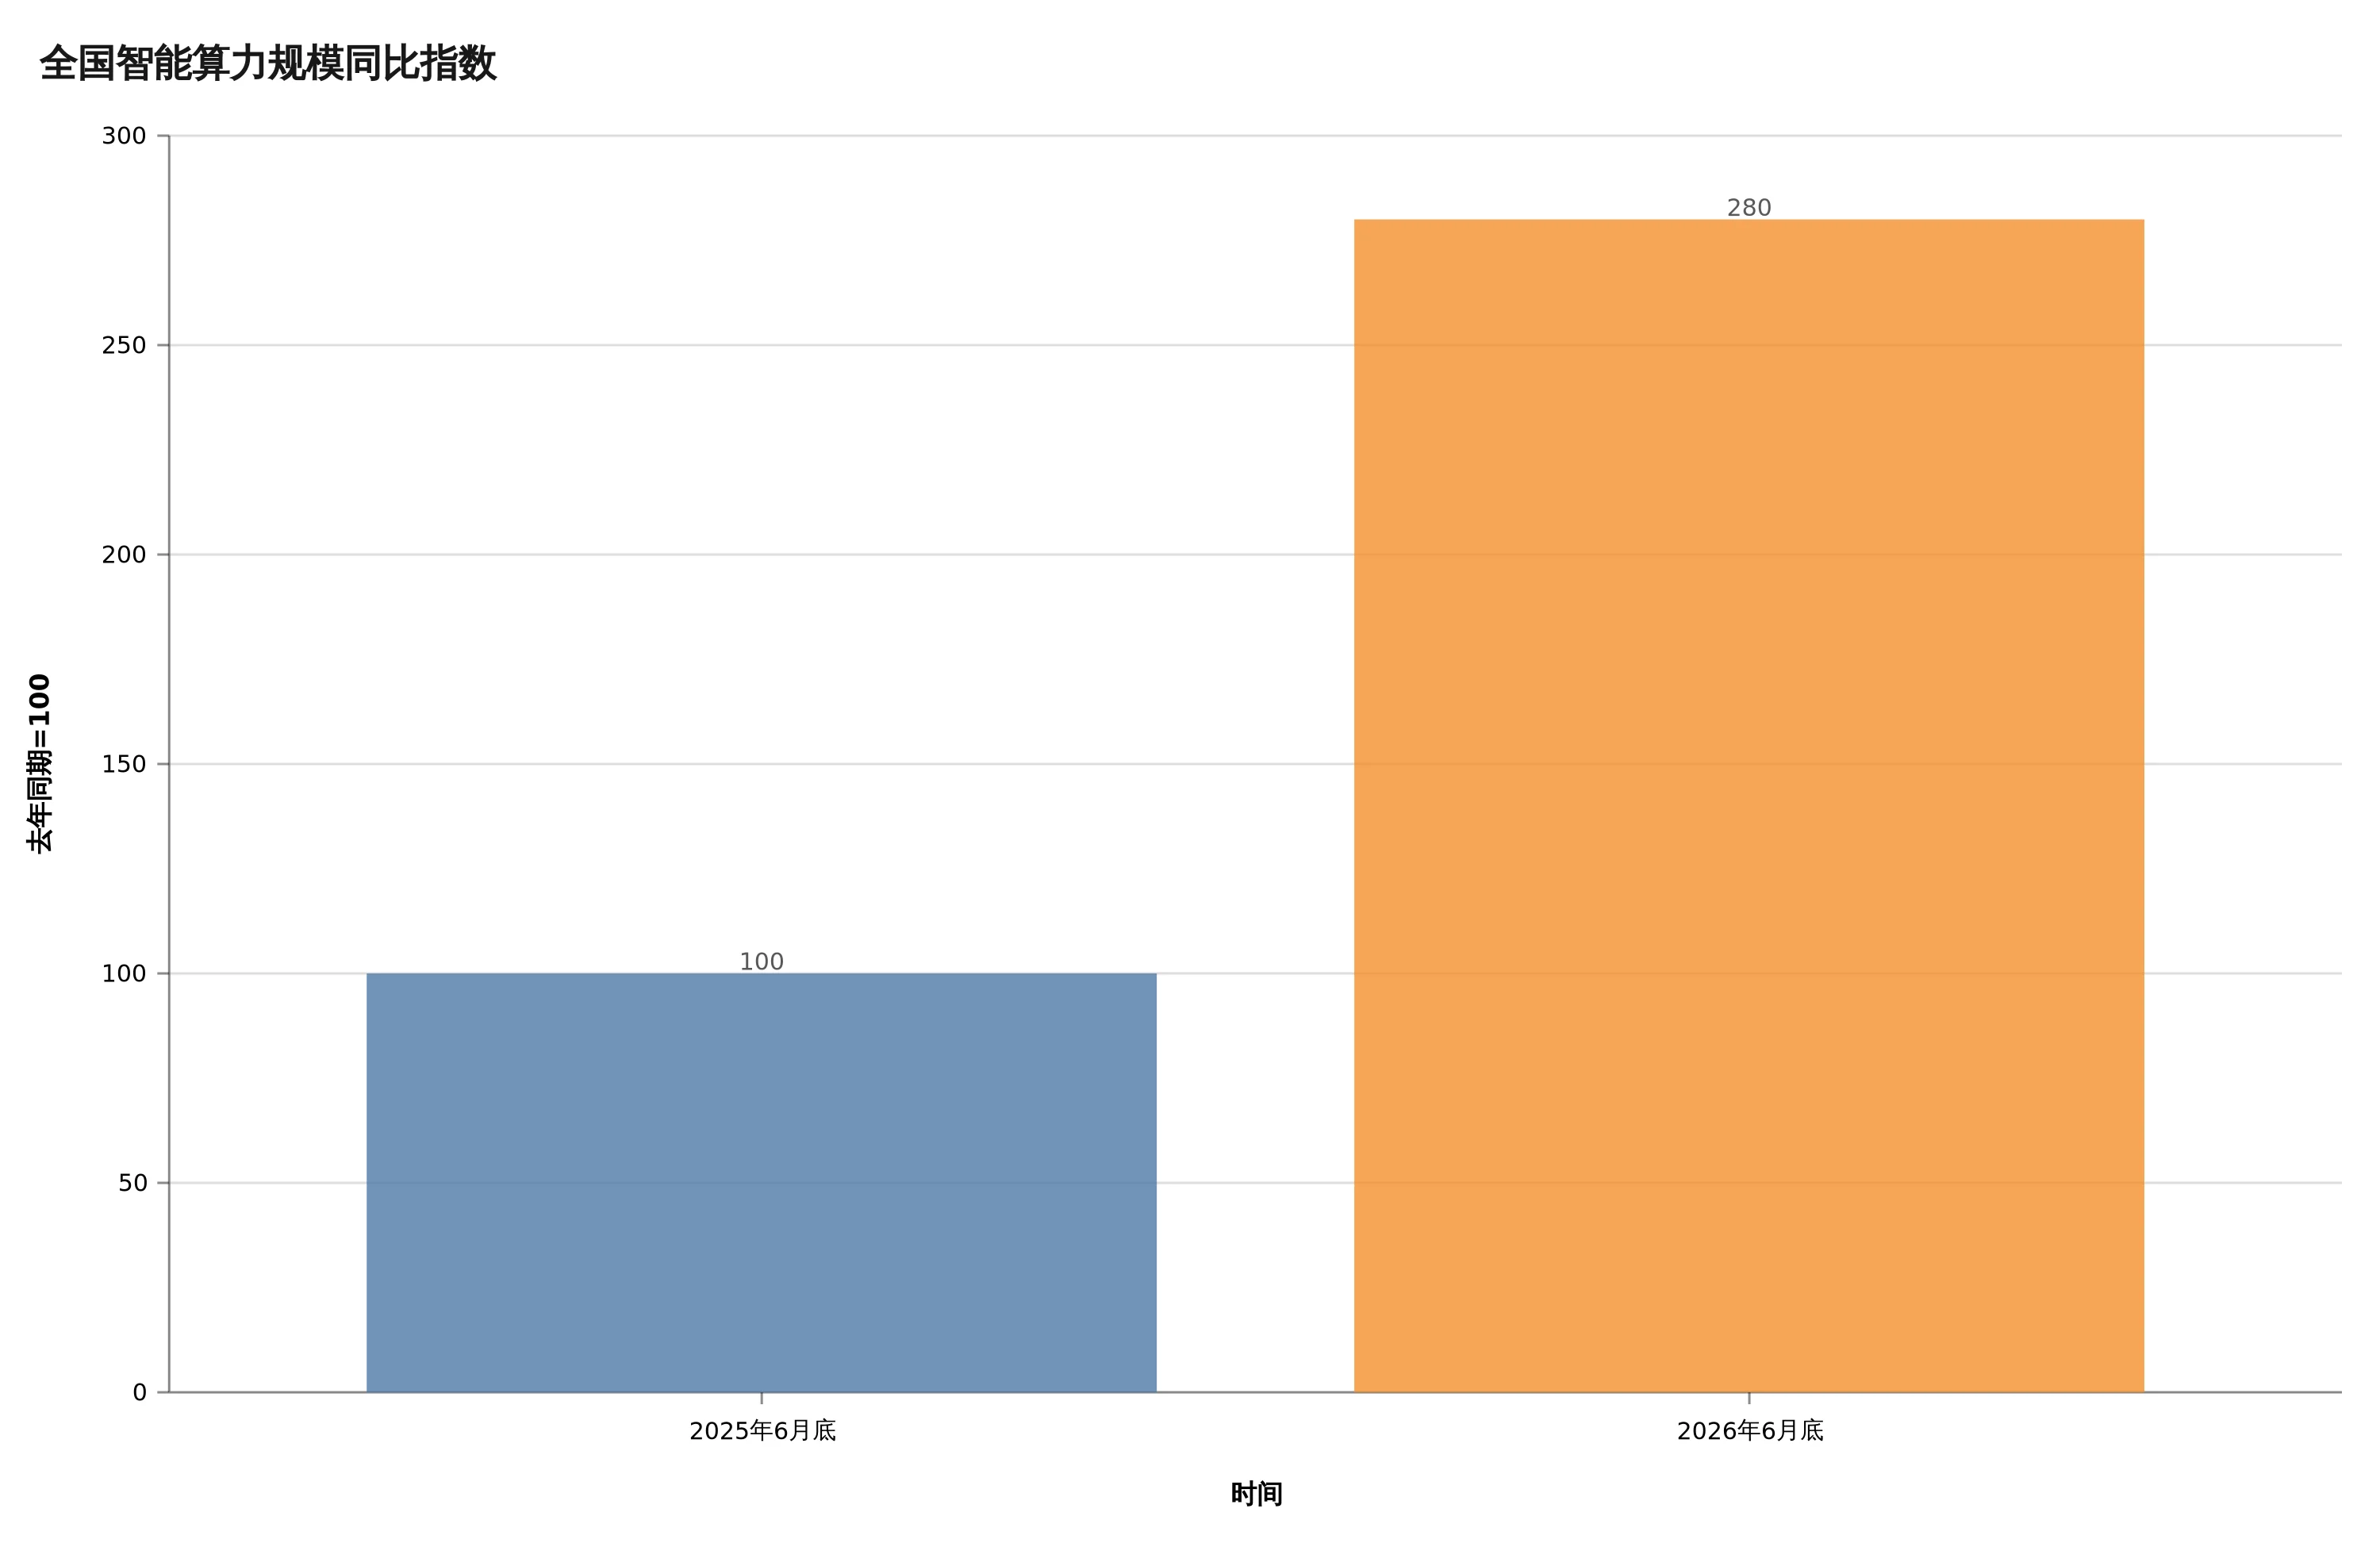
以去年同期为 100,截至 2026 年 6 月底,全国智能算力规模指数约为 280。
这轮增长不是纸面规划。全国产 10 万卡集群已经投用,国家枢纽节点继续集中算力,高速算力通道也在扩张。供给侧确实在猛踩油门。
但总规模有一个天然盲区,它把不同地方、不同芯片、不同网络条件和不同可用时段的算力,全加成了一个数字。
对一个正在跑推理服务的团队来说,东北机房里空闲的一批卡,不会自动解决华东用户晚高峰的首 token 延迟。一套适合 FP16 训练的集群,也不会瞬间变成低延迟推理池。某块芯片的理论吞吐很漂亮,如果服务框架缺算子、量化链路没适配、监控拿不到关键指标,它在业务眼里可能还是一片灰色资源。
这不是挑统计口径的刺。总量本来就该回答基础设施有多大,只是产品团队不能拿它回答另一个问题。
我的请求,今晚到底能不能跑稳?
同一份工信部数据还给了一个很容易被误读的数字,全国算力设施整体上架率达到 71.4%。上架率更接近机架和设备有没有装进去,不等于 GPU 每分钟都在做有效计算,更不等于业务端已经拿到 71.4% 的可用容量。
一张卡可能已经上架,却在等数据、等任务、等配额,也可能被一个长任务占住显存却没有持续满载。更麻烦的是,GPU 利用率本身也会骗人。监控面板显示 90%,不代表 90% 的时间都在生成有价值的 token,它可能在做重复计算、失败重试,或者被低效 batch 塞满。
厉害了,仪表盘一片绿色,用户还在转圈。
所以看算力,至少要把三个层次分开。机器有没有部署,资源有没有被占用,任务有没有成功完成。前两层适合运维看,第三层才跟产品收入和用户体验真正连上。
卡不怕忙,怕的是在等
国家数据局今年 4 月披露,截至 3 月底,全国智能算力总规模达到 188 万 PFLOPS,其中八大国家枢纽节点占比超过 80%。同一篇公开材料还提到,2025 年推理数据量达到 101.34 EB,首次超过训练数据量。
这个变化很关键。
训练更像把一大批数据和计算集中到一起,跑一段很长的工程。推理则碎得多,用户随时进来,输入长短不同,工具调用数量不同,有人要 300 毫秒内返回,有人愿意等十分钟换一个更好的答案。资源调度从安排一趟货运列车,变成同时应付晚高峰的网约车、地铁和外卖骑手。
模型能不能跑,只是起点。数据在哪里、请求从哪里进来、缓存有没有命中、跨地域传输要多久,会一起决定那张卡是在算,还是在等。
很多团队做容量规划时,会盯着 GPU 数量和显存。真正上线后才发现,最先爆的可能是对象存储带宽,可能是向量库连接数,也可能是跨可用区网络。大模型服务还有一个更隐蔽的吃资源大户,KV cache,也就是模型为了续写上下文保存的中间状态。长上下文一多,算力芯片不一定先满,显存会先被一堆没说完的话占住。
这时再加卡,未必治病。
如果路由器仍然把短问答和长推理塞进同一个队列,新卡只会把旧堵点摊大一点。更有效的做法往往是把不同请求拆池,把短任务送到低延迟模型,把长任务放进异步队列,让相似前缀共享缓存,再给超时和失败重试设硬预算。
听起来没有 10 万卡那么壮观,却决定了普通用户能不能感受到 10 万卡。
首个全国产 10 万卡集群的运行报道提供了一个不错的参照。它投用首周满载运行,日均处理作业超过 15 万个,单日峰值超过 50 万个。这里真正有工程味的,不只是卡数,而是作业数。卡是库存,完成的作业才是交付。
这两个单位,气质完全不同。
模型能启动,离业务能跑还远
国产模型与国产算力芯片加速适配,是这次新闻发布会特别提到的一条。很多人扫过去会觉得这只是生态建设的固定句式,其实它正好戳中有效算力最难啃的一层。
同一份模型权重,换一套硬件并不是改个设备名就能跑。算子要有实现,编译器要认识计算图,通信库要扛住多卡并行,量化格式要匹配,推理框架还得处理动态 batch、前缀缓存、并发取消和流式输出。
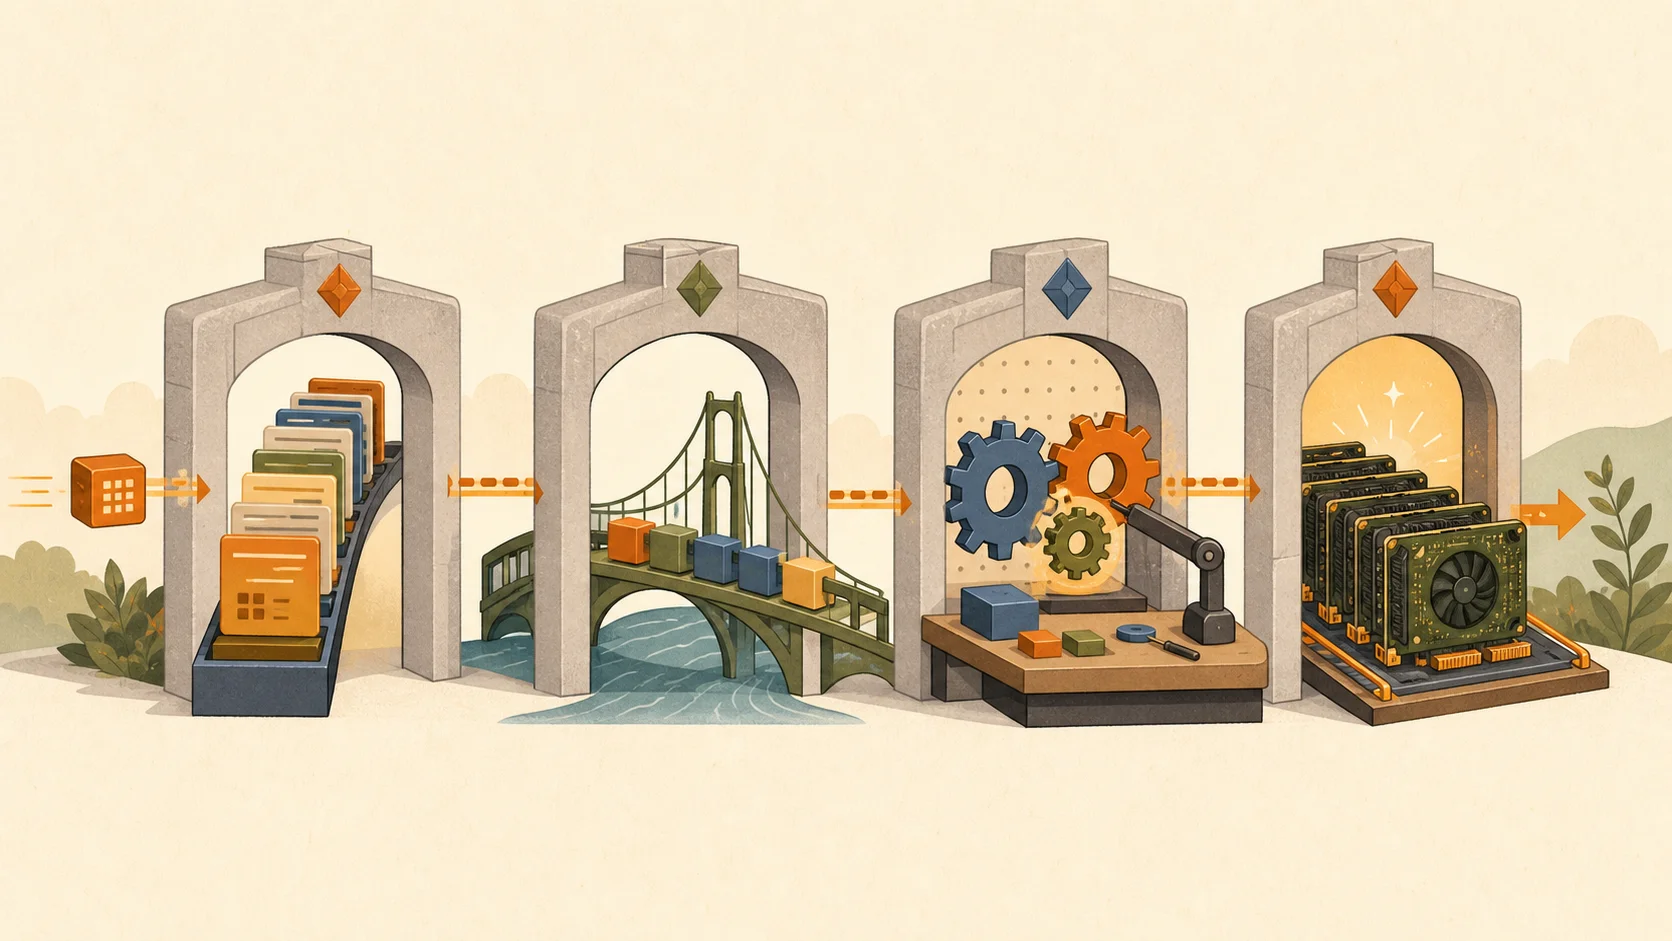
卡只是终点,请求在抵达之前还要穿过调度、数据传输和软件兼容。
任何一环缺口,都可能把理论吞吐吃掉。
很多性能对比喜欢放一个 tokens per second,也就是每秒生成多少 token。这个数字当然有用,但如果没有说明输入长度、输出长度、并发数、首 token 延迟、batch 策略和精度格式,它很像一辆车只报最高时速,不说城市油耗,也不说刹车距离。
更现实的测试,应该贴着业务形态来。
客服问答要看首 token 和 P95 延迟,P95 指 95% 请求都能落在这个时间以内。代码 Agent 要看一个任务里工具调用十几轮后还能不能收敛。批量文档处理要看吞吐,也要看失败文档会不会拖垮整批。带图片和 PDF 的任务,还要把预处理、上传、OCR 和模型推理放进同一条链路算时间。
只测模型内核,最终很容易得到一个棒棒的实验室数字,再得到一个脾气很大的生产系统。
国家数据局等部门发布的人工智能与能源协同行动方案一共部署了 29 项任务,里面不只有能源供给,也提到算力设施绿色转型、算电协同、场景开放、数据价值和模型创新。把这些放在一起看,会发现基础设施的单位正在变化。
以前谈的是一座机房能装多少机器。现在谈的是算力、电力、网络、数据、模型和场景能不能在同一套调度里配合。
硬件是一层,能把硬件变成服务的那层工程,开始变得更贵。
别只算每百万 token 多少钱
如果我是一个 AI 应用团队,看到算力规模翻到 2.8 倍,最想改的不是年度汇报里的市场容量,而是自己的成本表。
大多数表格只记 API 单价、GPU 小时价和机器折旧。可真正从银行卡里扣走的钱,还藏在失败重试、空跑工具、无效长上下文、低命中缓存、夜间闲置和人工返工里。
一个便宜模型,如果每次任务要重试三遍,还需要人工花十分钟核对,未必比贵一点但一次通过的模型省钱。一个吞吐很高的自建集群,如果业务只在白天有流量,夜里大半时间空着,账面单 token 成本也可能很难看。
更值得盯的指标,是 cost per successful task,每个成功任务的成本。
它把模型调用、工具调用、重试、机器占用和人工审核一起装进同一个分母。任务没有通过验收,就不算成功。这样一来,团队不会为了把 GPU 利用率刷漂亮,奖励一堆没人需要的计算,也不会因为某个模型单价低,就忽略它把错误传给了下游。
具体落地并不玄。
先给高频任务建一小套回归题,记录成功率、端到端延迟和完整费用。模型、提示词、路由或硬件换一项,就把同一批题重跑。再把容量按请求类型拆开,短任务、长推理、多模态、批处理各看各的 P95 和失败率。到了采购或扩容时,拿成功任务成本谈,不拿峰值算力谈。
这套小账本不会出现在宏观新闻里,却能帮开发团队判断,那 2.8 倍算力到底有没有流进自己的产品。
国家统计局对上半年工业利润的解读里,服务器与高性能工作站相关行业的利润增长很快,电子行业也被算力需求明显拉动。硬件扩张已经在产业数据里留下痕迹。接下来更值得观察的,是推理价格、任务成功成本和单位能耗会不会同步往下走。
如果只有机房越来越大,应用端仍然被调度、网络和软件栈卡住,规模增长会先变成折旧。
如果这条长管道被接通,才会变成产品。
大数要落到小账上
2185 EFLOPS 是一个很提气的数字。它说明算力供给的底座正在快速变厚,也说明 10 万卡级集群、枢纽网络和国产软硬件适配已经不是 PPT 里的未来时。
但我还是想给这股兴奋踩一脚不那么扫兴的刹车。
别把拥有算力,误当成用好了算力。
对开发者来说,接下来最值钱的能力不是背下全国有多少 EFLOPS,而是能把一个请求从入口追到结果,知道它在哪里排队、为什么重试、哪段在等数据、哪张卡在空转,以及这一切摊到成功任务上究竟花了多少钱。
卡会继续变多,模型也会继续变大。真正稀缺的,反而是把资源变成稳定结果的那层工程判断。
大数负责告诉我们潮水来了。
小账,决定船能不能开出去。