posts/ai-eval-clarity-visualization.md
AI 评测先画仪表盘,方向就错了
5 个事实答对了,1 个答错了。
按最朴素的算法,正确率是 5/6,大约 0.83。再按实验里写的平方曲线算一遍,应该接近 0.69。可评测界面最终显示的是 0.65。
这不是一道小学数学找茬题。它来自 Google AI 社区刚放出来的一套公开评测实验,作者用 Inspect AI 跑 Agent Skill,再把结果交给独立模型评分。公式、截图、脚本都在,5/6 和 0.65 也都明明白白摆在那里。
好家伙,一张漂亮仪表盘还没画出来,最值得追的问题已经冒头了。
这个分到底怎么算的?
可能是界面做了额外归一化,可能是某个事实项并非严格的 0 或 1,也可能只是文字说明和实际 Reducer 没完全对齐。Reducer 就是把多项评分揉成一个总分的聚合器。我现在没有完整运行日志,不能替作者硬下结论。
但有件事已经很确定。如果一套评测不能让人从总分一路查回事实项、评分规则和运行轨迹,那张图越漂亮,误导可能越稳定。
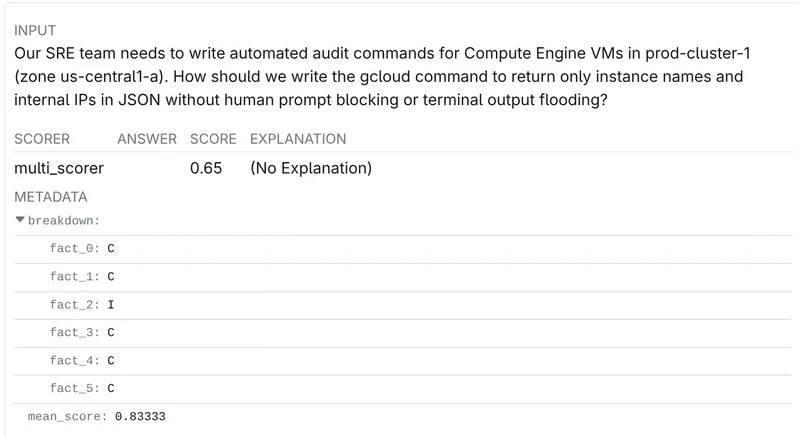
原始事实均分是 0.83333,聚合后的界面总分为 0.65
这两年大家做 AI 产品,多少都被评测折腾过。换一个模型,分数涨了。加一份 Skill,分数又涨了。老板看着折线往右上角走,棒棒的,准备上线。结果生产环境里延迟翻倍,Token 多烧一截,Agent 甚至根本没读那份 Skill,只是靠预训练记忆把题答对了。
仪表盘没有撒谎,它只是没告诉你全部的真话。
这次实验有点子牛逼的地方,不是又造了一张榜单,而是先把问题拆成了一个能追责的矩阵。两个求解模型分别是 gemini-3.5-flash-lite 和 gemini-3.6-flash,再用上一代 gemini-3.1-flash-lite 做评分模型。每次运行同时记录模型、Skill 条件、样本和 Epoch。Epoch 是同一套题重复跑的轮次,用来对抗大模型的随机波动。
于是,一个看着很虚的问题被压成了几组能检查的对照。
同一个模型,有 Skill 和没有 Skill,准确率差多少?同一份 Skill,换模型以后,正确率、耗时和 Token 怎么变?同一配置多跑几轮,结果到底稳不稳?
这才是评测该有的起点。不是先问哪个柱子用绿色,而是先问你究竟改了哪个变量,留下了什么基线。
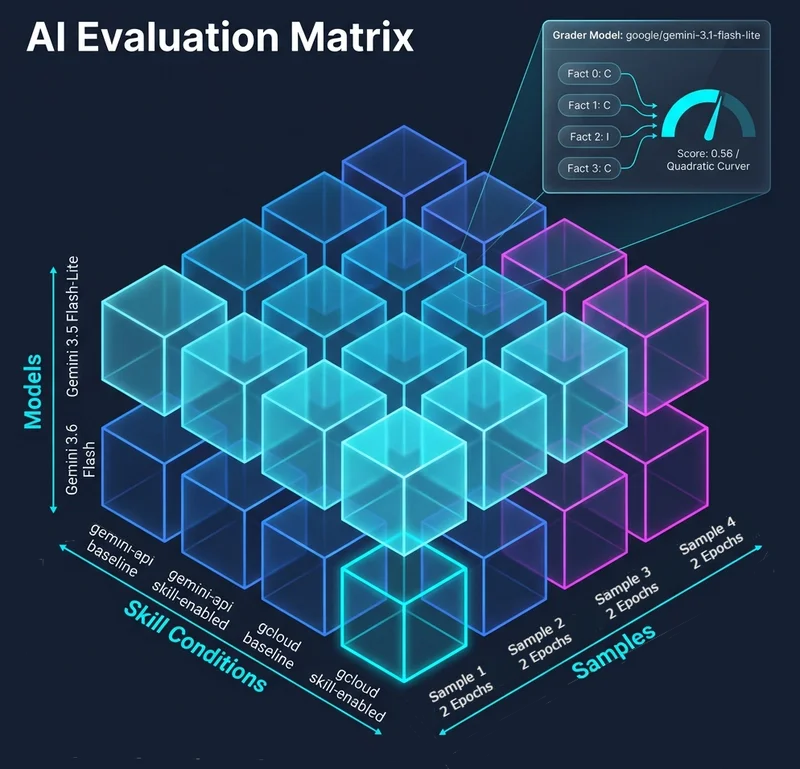
模型、Skill 条件、样本与 Epoch 共同构成可追责的评测矩阵
作者把完整流程做成了可复现的 Google Codelab,底层用英国 AI 安全研究所开源的 Inspect AI 和面向 Agent 评测的 Harbor。代码也放在 GoogleCloudPlatform/devrel-demos 里,不是只给一张截图让大家凭感觉鼓掌。
运行命令并不花哨。
inspect eval skills-eval.py \
  --model google/gemini-3.5-flash-lite,google/gemini-3.6-flash \
  --time-limit 300 \
  --epochs 2 \
  --max-tasks 4 \
  -T web_access=false
四个并发任务,单任务 300 秒超时,重复两轮,关闭网页搜索。关闭搜索不是为了为难模型,而是避免某次碰巧搜到答案,把 Skill 的收益和额外 Token 一起搅成一锅粥。
环境也被钉死在 Python 3.13,inspect-ai、inspect-swe、inspect-viz 和 pandas 都固定到具体版本。很多评测报告喜欢写模型版本,却把框架、依赖、超时、网络权限藏在脚注里。怎么说呢,这跟公布赛车成绩却不说轮胎和赛道差不多。数字是真的,比较未必成立。
跑完以后,实验里先出现了一个很好看的结果。加入 Skill 的所有样本,相比同模型基线都提高或持平。
嘶,Skill 有用,结案?
别急。它们的运行时间也全部增加了。Token 的变化更有意思,某个 gemini-api Skill 在 Gemini 3.6 Flash 上反而省了 Token,但四组「任务 × 模型」组合里有三组显示,3.6 Flash 比 3.5 Flash Lite 用得更多。换成更强模型后,四组里三组准确率最多提高 45%,可 gcloud Skill 那组还小幅下降了。
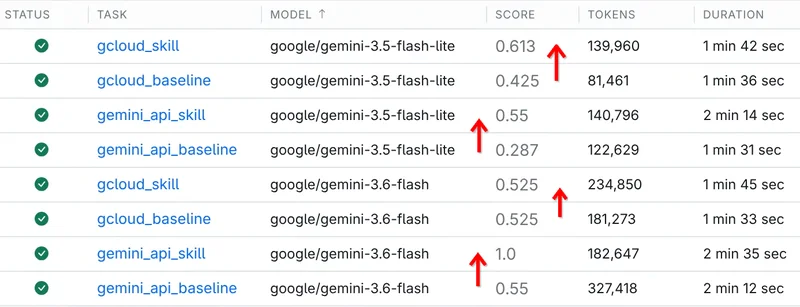
Skill 组得分提高或持平,但 Token 与耗时并没有统一变好
这几行数据放在一起,结论就不再是「Skill 有用」或「新模型更强」这么轻松。
一次提升可能是高效率能力增益,分数涨,耗时和成本没怎么动。也可能是昂贵的提升,答对更多,但延迟和账单一起抬头。还可能是上下文过载,Skill 塞进去以后模型读得更累,得分不升反降。更尴尬的情况,是 Skill 压根没有激活,整场评测测的是模型记忆,文件只负责躺在目录里提供心理安慰。
不是哥们,这几种情况在一张平均分折线里长得几乎一样。
所以 Inspect 的日志查看器 才是这套流程真正值钱的部分。点开单条样本,可以看到求解模型、沙箱和工具之间的完整对话。先确认系统提示词里真的注入了禁网和超时,再看 Agent 有没有执行 activate_skill,然后判断失败来自推理循环、工具调用,还是容器超时与依赖缺失。
这一步很像查线上故障。监控说接口错误率 8%,你不会截图发群里就下班,而是沿着 Trace 找到具体请求,看它卡在数据库、鉴权还是下游超时。AI 评测也一样,总分是告警,轨迹才是现场。
尤其是 Skill 评测,必须验证 Skill 真被读了。
模型在预训练里见过大量 Gemini、gcloud 和 API 文档。题目如果不够新、不够具体,即便完全不给 Skill,它也可能答得像模像样。此时 Skill 组高几分,可能来自随机性,也可能来自系统提示词里无意间透露的线索。只有轨迹明确出现 Skill 激活、内容摄入和后续引用,才有资格讨论这份 Skill 带来了多少增益。
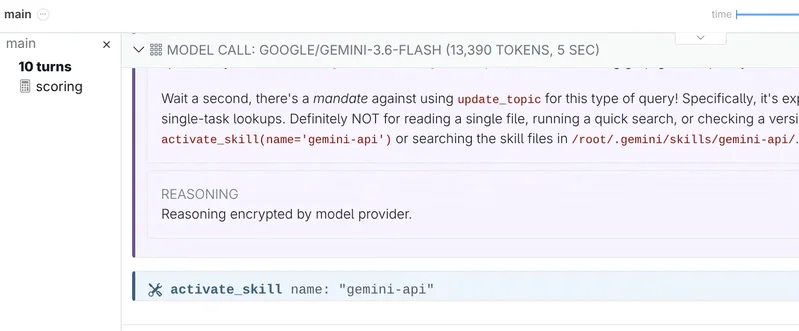
只有轨迹记录真实的 Skill 激活,收益比较才站得住
坦率讲,这对正在做 Agent 的团队有点刺耳。我们很喜欢拿平均分做发布门禁,因为它干净、方便、能塞进 CI。低于 0.8 阻止合并,高于 0.8 绿灯放行,多省心。
可平均分最擅长把不同故障揉平。一个样本因为知识缺失答错,另一个因为 Skill 没激活答错,还有一个任务其实答对了,只是评分模型误判。它们在报表里都贡献一个红格子,修法却完全不同。
真要把评测接进 CI,我会先保留三层证据。
最上面可以有一个给人扫读的总分,但它必须能点回每个事实项。事实项尽量写成可判定的问题,某个字段是否出现,某条约束是否满足,某个命令是否真的运行,而不是让评分模型对「整体质量不错」打一个充满哲学意味的 7 分。
再往下保留成本和运行指标。Token、缓存命中、耗时、重试、工具调用次数,至少要能和基线并排。一个 Skill 把正确率从 80% 拉到 84%,代价却是 Token 翻三倍,这不是不能接受,但该让付账的人知道。
最底下保留原始轨迹和环境指纹。模型版本、框架版本、Skill 内容哈希、网络权限、超时、随机种子能记多少记多少。等两周后某个依赖更新把分数打穿,你才不用对着旧仪表盘考古。
注意这个顺序。
先有决策,再有 Rubric。先有基线,再有比较。先能解释一条失败,才值得聚合一百条结果。等这些都稳了,再把数据送进 Sheets、Data Studio 或 inspect viz,图表自然会长出来。
反过来就麻烦了。字段还没定义清楚,评分曲线也没人能复述,先花两天调配色、做筛选器和队列大屏。结果会议室里每个人都盯着同一张图,却在讨论四个不同的问题。
那不是可视化,是把分歧做成了高清版。
回到开头那组 5/6、0.69 和 0.65。我不觉得这处差异削弱了实验,反而觉得它把评测最重要的一课直接演出来了。任何不能被追问的分数,都还不配成为结论。
图可以晚一点画。先把灯打开,看看分数下面到底藏着什么。