posts/ai-infrastructure-bullwhip.md
GPU 越快,AI 基础设施可能越贵
企业级 SSD 的合约价,一个季度涨了 80%。
不是消费电子突然回暖,也不是全世界同时开始囤硬盘。TrendForce 给出的解释更直接,AI Agent 服务和云厂商采购,把企业级 SSD 的库存压到了历史低位。2026 年第一季度,前五大品牌的相关营收环比涨了 86.1%,冲到 184.6 亿美元。
好家伙,GPU 的紧张刚让不少人喘口气,存储又过来收账了。
这几天 Tomasz Tunguz 写了一篇很有意思的文章,叫 The AI Bullwhip。他把过去三年的 AI 基础设施价格串成一条线,2023 年缺 GPU,2024 到 2025 年压力迁到 HBM 和闪存,2025 年末开始挤 CPU,2026 年轮到大容量硬盘,一路撞上变压器、燃气轮机和混凝土。
看起来像一张缺货日历。
但我觉得更值得警惕的是另一件事。AI 的每一次提速,都可能把瓶颈推到一个更慢、更贵、扩产周期更长的地方。
模型跑得更快,不等于系统更便宜。有时恰好相反。
GPU 缺完,后面每一块都来收账
2023 年初,钱几乎只追着 GPU 跑。Tunguz 汇总的数据里,NVIDIA H100 的按需租赁价一度超过每小时 9 美元。为了抢卡,买家推迟普通服务器换代,全年服务器出货量下降 22%,甚至低于 2018 年。
这一下很微妙。
普通服务器需求下去,内存厂商原本就没消化完的库存继续堆着。Samsung、SK hynix、Micron 和 Western Digital 在那一轮一共吞下超过 200 亿美元的损失,产能也跟着收缩。等 AI 需求转向内存,厂商又把洁净室和设备往 HBM 倾斜。
HBM 是高带宽内存,可以把它理解成紧贴 GPU 的高速粮仓。它能让算力少等数据,可代价不小。Tunguz 引用的行业估算里,每生产 1GB HBM,占用的晶圆产能大约是标准 DDR5 的三倍。高利润产品优先上产线,传统 DRAM 和 NAND 自然被挤到后面。
价格于是掉头。
Micron 的 2026 财年第三季度 10-Q 写得很直白,DRAM 平均售价环比上涨约 60% 出头,NAND 平均售价涨了 80% 中段。另一边,TrendForce 对企业级 SSD 市场的调查 显示,合约价单季上涨约 80%,供应商的产出速度远远赶不上订单。
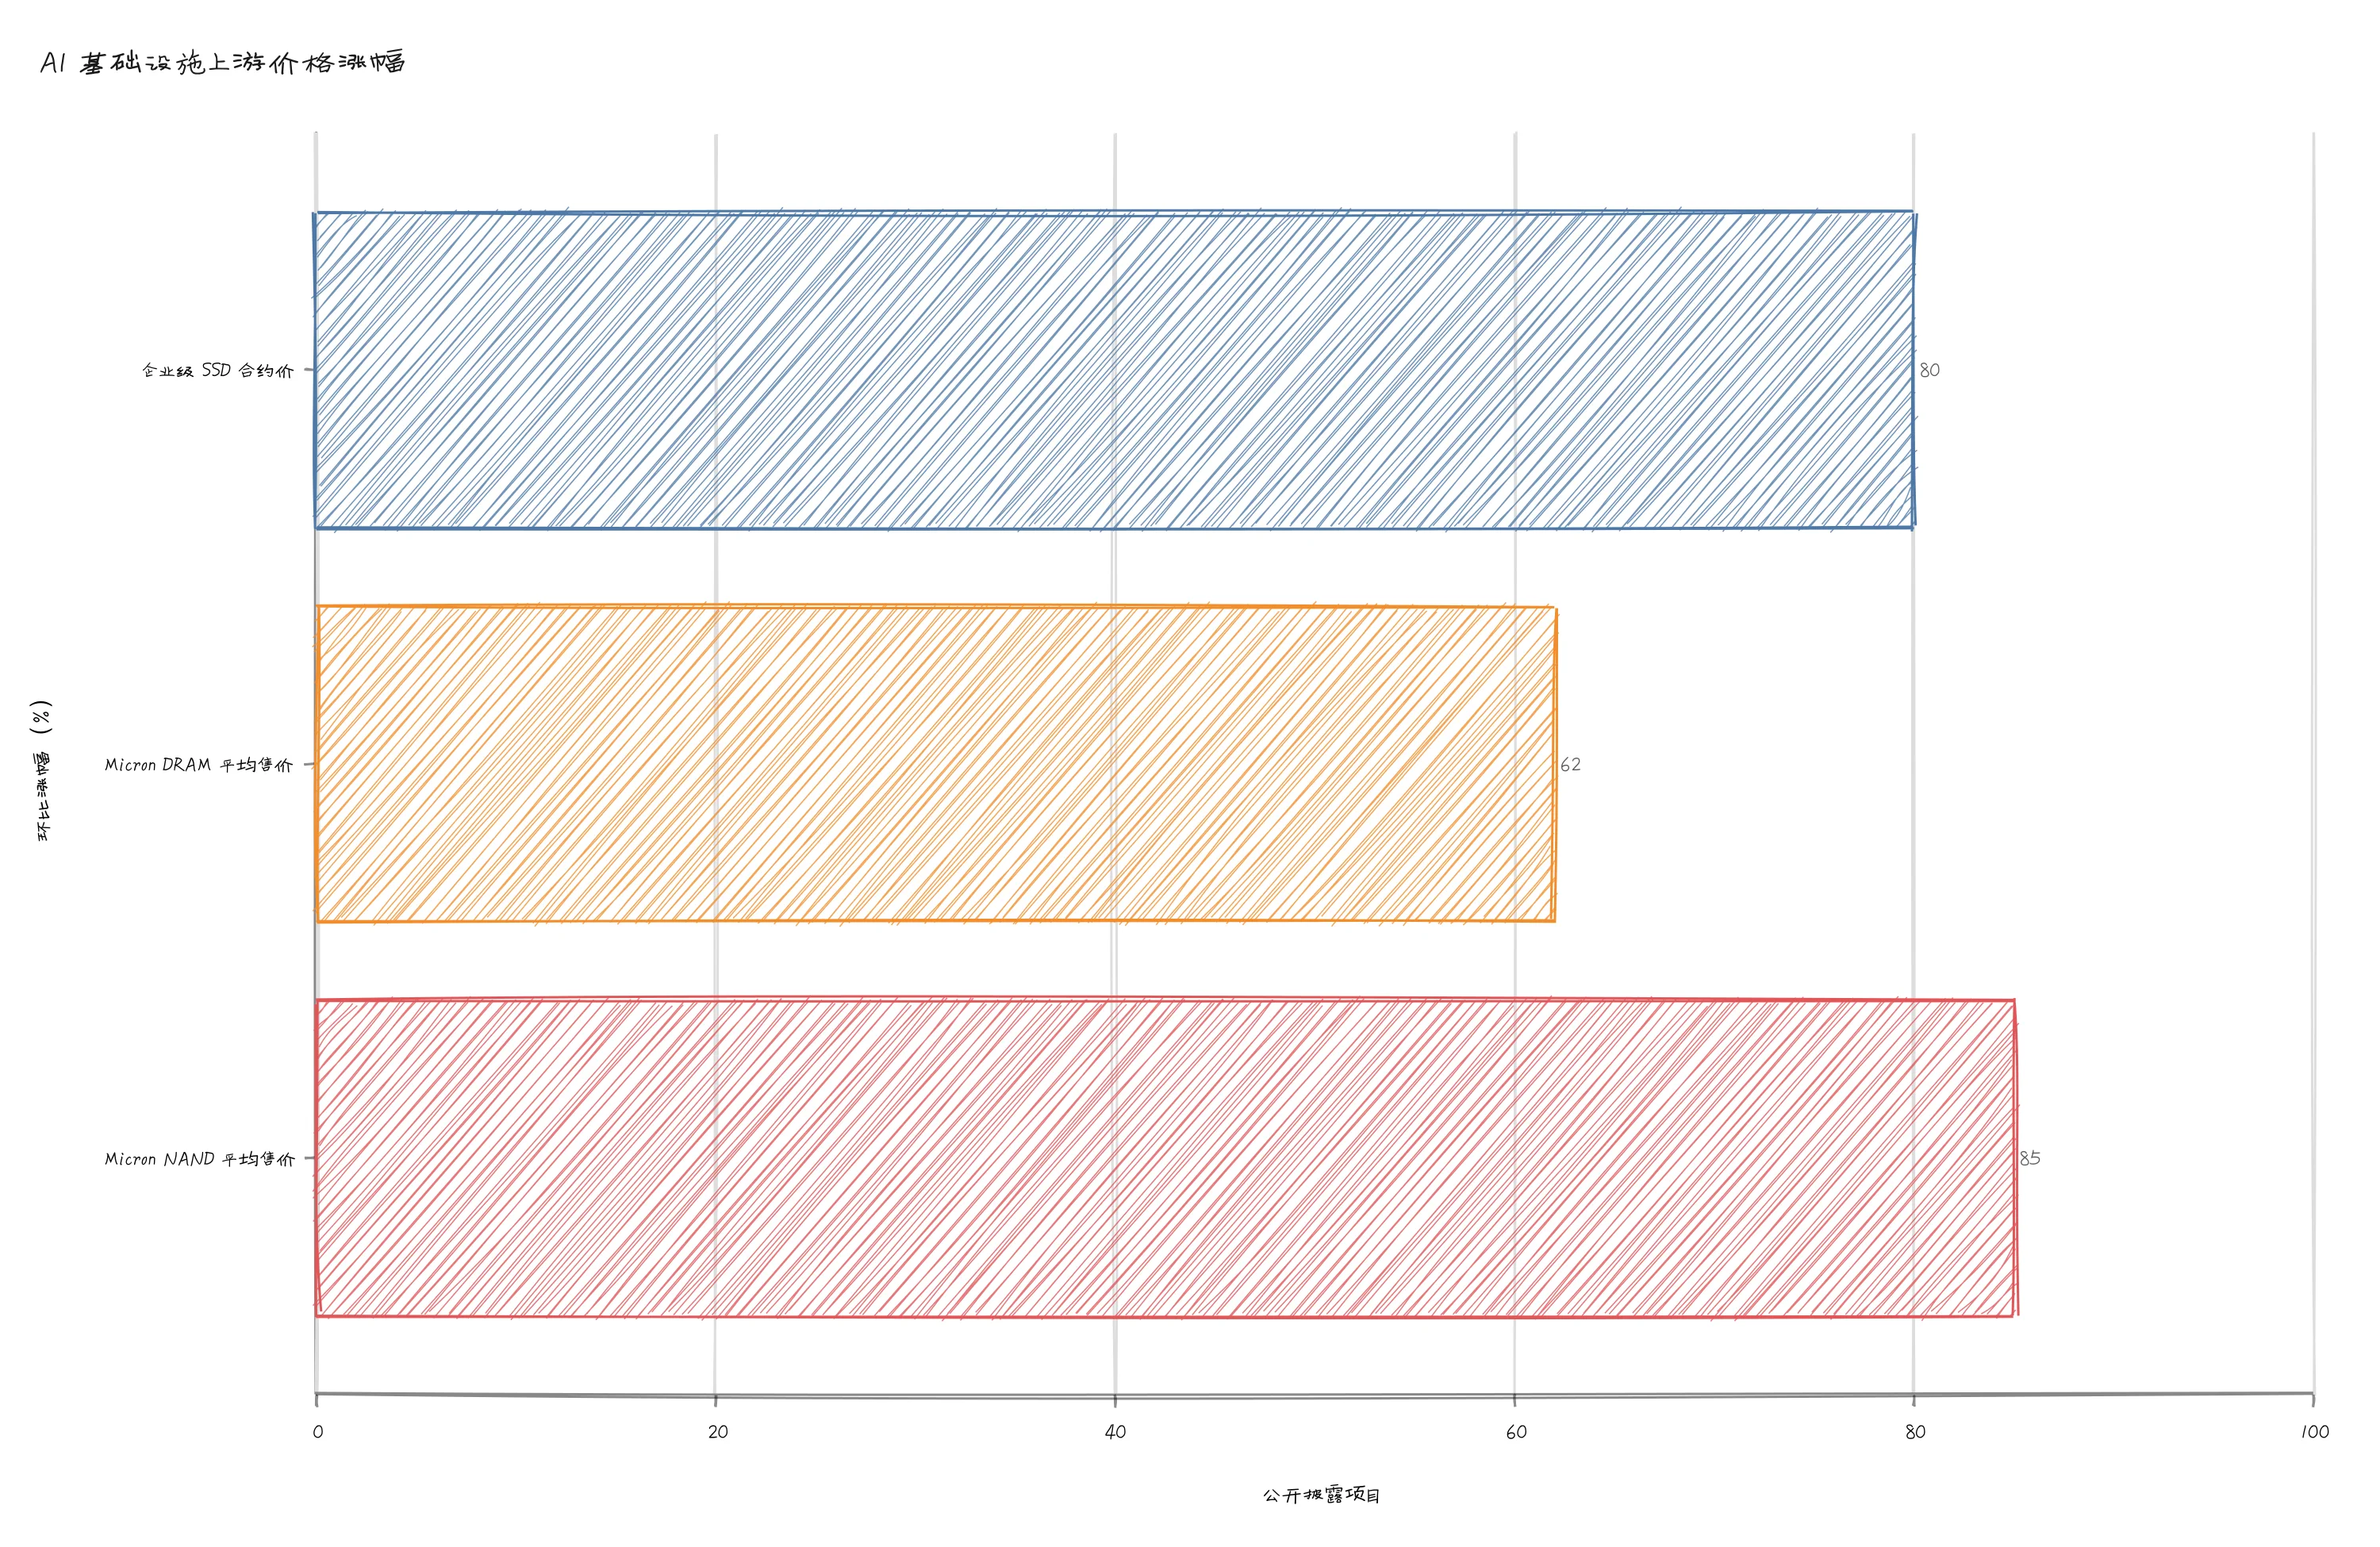
不是需求凭空多了一点,是整条供应链在重新排座次。
更有意思的是,企业级 SSD 已经不只是放数据的仓库。Agent 要反复读上下文、写中间状态、保存工具结果、加载索引和缓存。DRAM 太贵、容量又有限,更多数据被推向高性能 SSD。SSD 开始承担内存层级的一部分工作,压力跟着下沉。
厉害了,软件架构里一个看似普通的状态持久化,竟然能在硬件市场里掀起 80% 的价格波动。
Agent 把一比八往一比一推
很多人讨论 AI 集群,脑子里还是训练那张图。GPU 在中间轰鸣,CPU 像个不太起眼的管理员,负责喂数据和调度。
训练集群常见一颗 CPU 带多张 GPU。Tunguz 引用 Intel 和 AMD 管理层的说法,典型比例大约是一比八。Agent 工作流却不一样,它会编译代码、调用 API、执行 shell、解析 JSON、查数据库、调浏览器、写文件,还要在多轮动作之间维护状态。
这些活,很多并不在 GPU 上跑。
一次生产任务也不是模型吐完答案就结束。模型决定下一步之后,CPU 要接住工具调用,网络要送请求,存储要取资料,沙箱要起进程,结果回来还要校验。某一步失败,重试会把整条链再走一次。
于是一个很反常的场景出现了。模型推理从十秒降到两秒,GPU 看起来更高效,系统却可能更拥堵。因为 Agent 发起下一次工具调用的速度变成原来的五倍,后面的 CPU 队列、数据库连接池、对象存储和日志管道还在原地。
车开快了。
收费站没变。
Intel 的 2026 年第一季度文件 显示,数据中心与 AI 业务收入同比增长 22%,其中一个推动因素就是服务器平均售价提高,以及需求驱动的价格调整。这里不能粗暴地说全部都是 Agent 造成的,产品结构、输入成本和高端型号占比同样在起作用。但 CPU 不再只是 GPU 旁边的配角,这个方向已经很清楚。
Meta 最近发布 MTIA 300,把网络接口直接集成进训练芯片;同一天又开放 MetaRoCE,试着把拥塞控制和故障处理往端点推。两件事表面上一个讲芯片,一个讲协议,背后其实是同一道题。
计算单元变快以后,数据搬不动就是浪费。
NVIDIA 在 Vera Rubin NVL72 的效率数据 里,把指标写成每瓦特能完成多少 Agent 工作量,而不是只展示单卡峰值。这种口径更接近生产现实。可它依旧只覆盖了一部分账单,真正跑起来时,CPU、内存、网络、存储、供电和重试都在旁边伸手。
快一点,为什么反而更贵
供应链里的这个现象叫牛鞭效应。终端需求轻轻一抖,上游看到的波动会被层层放大,像甩鞭子时手腕只动一点,鞭梢却抽出一声爆响。
AI 基础设施尤其容易中招,因为上游太慢。
软件可以一周发三个版本,晶圆厂、变压器和燃气轮机不行。Tunguz 汇总的数据里,数据中心升压变压器的平均交付周期接近三年。GE Vernova 和 Siemens Energy 的产能已经排到 2029 年,部分订单一路看到 2031 年。GE Vernova 2026 年的一场投资者会议 里,管理层还在讨论 2029 和 2030 年的交付档期。
需求在今天爆,供给三年后才到。
中间的人只能猜。
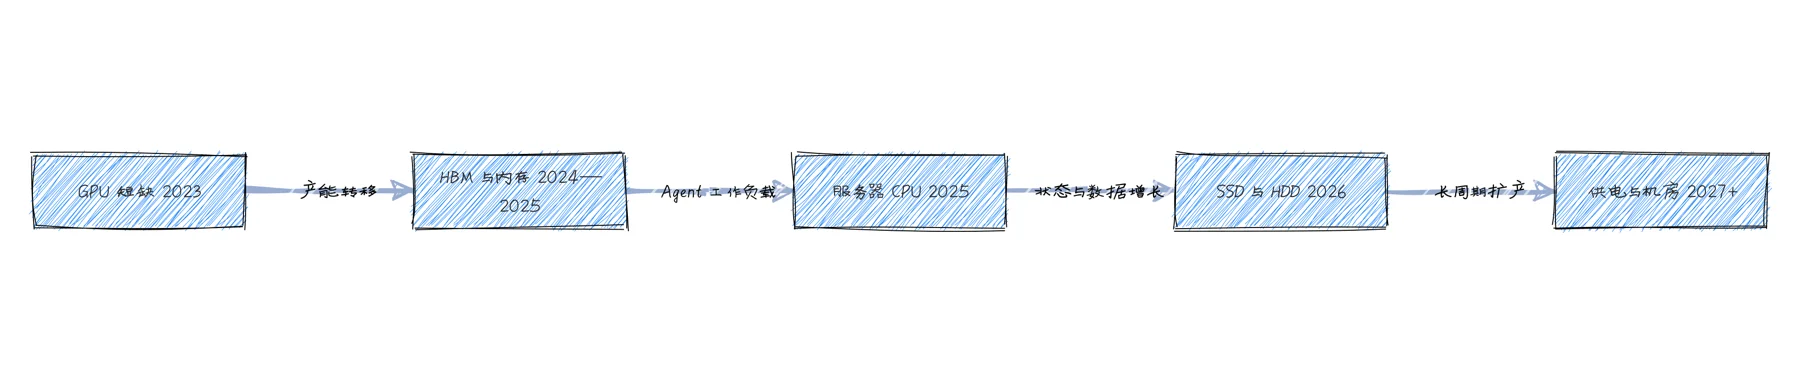
猜少了,客户排队,市场份额丢掉。猜多了,等产线建好,浪头可能已经转向另一个部件。Siemens Energy 的扩产计划甚至把变压器产能目标看到了 2031 年。这个时间尺度放在 AI 圈里,够模型家族换好几代名字了。
这也是为什么单看 GPU 利用率会误导人。
假设 GPU 利用率从 55% 提到 80%,面板一片绿色,大家都很开心。可任务的端到端延迟里,如果 40% 花在排队,20% 花在工具重试,15% 花在读写状态,GPU 的那段再漂亮,也只是在局部省钱。
甚至会更贵。因为更快的生成速度带来更多并发动作,更多动作制造更多状态,更多状态又需要更大的缓存和存储。吞吐提高以后,失败也会以更高的速度被复制。
有点子牛逼,也有点子吓人。
这里最该换的不是硬件,而是指标。生产 Agent 至少要把下面四个数和 token 吞吐放在同一张图里。
success_cost = 总基础设施成本 / 成功完成的任务数
queue_share = 排队时间 / 端到端任务时延
retry_amplification = 总尝试次数 / 成功任务数
data_churn = 读写数据量 / 成功任务数
success_cost 看的是一件事真的做完花了多少钱。queue_share 能告诉你模型是不是正在等外面的世界。retry_amplification 会把隐藏的失败成本揪出来。data_churn 则能提前暴露存储和网络压力。
如果模型升级后 token 单价降了 30%,success_cost 却涨了,问题通常不在模型。可能是工具调用变多,可能是重试策略太激进,也可能是每个子 Agent 都复制了一份相同上下文,顺手把缓存、SSD 和对象存储一起喂胖了。
这种时候继续换更快的模型,像在堵车的路上换一辆跑车。
油门有了。
路没有。
容量规划别再只画一张 GPU 表
我自己的判断是,接下来做 AI 系统,容量规划要从「买多少卡」改成「每完成一件事,整条任务流会经过多少资源」。
先画数据路径。
一条任务从进入队列开始,会读多少上下文,触发多少次模型调用,落多少中间状态,访问几个外部系统,失败后从哪一步重跑。把这些动作画出来,往往比再看一张 GPU 型号对比表更有用。
然后给每一段加背压。背压不是让系统故意变慢,而是下游快撑不住时,上游别继续无脑塞任务。工具调用要有限流,子 Agent 要有并发上限,日志和状态写入要能批量,重试要有指数退避和总预算。没有这些护栏,模型越强,系统越容易用更快的速度把自己打挂。
再往后,缓存也别只看命中率。Prompt cache 命中了多少 token 很好看,可如果缓存对象大得离谱,更新又频繁,存储和网络账单照样会涨。更实用的问题是,一次命中省下的模型成本,能不能覆盖它带来的写入、保留和失效成本。
还有一件事,把降级路径提前写好。高性能 SSD 紧张时,哪些数据必须留在热层,哪些可以进普通对象存储,哪些只是调试痕迹,任务结束就能删。CPU 饱和时,哪些工具调用可以排队,哪些必须拒绝。模型服务抖动时,是换便宜模型,还是减少子 Agent,还是直接把任务退回人工。
这些听起来不如新 GPU 热血。
却决定了系统能不能活过下一轮缺货。
Micron 的 245TB 数据中心 SSD 已经开始出货,一块盘能装进过去需要多块设备才能承载的数据。硬件厂商当然会继续把容量往上堆,棒棒的,工程问题总能被推迟一点。
但它不会消失。
今天的瓶颈在 GPU,明天可能在 HBM,后天可能在 CPU、SSD、交换机和电力。真正稳定的架构,不是猜中下一块会缺什么,而是让任何一块开始排队时,系统都能看见、限流、降级,不把局部压力放大成整条供应链的鞭响。
GPU 会继续变快。
别让鞭梢也跟着更快。