posts/ai-longform-writing-state-machine.md
AI 会写代码了,却还写不好一本书
AI 能在两三百页的书稿里找出很深的错字,却仍然写不好一章技术书。
好家伙,这个落差比任何写作跑分都更扎眼。
刚完成 RLHF 教科书 的 Nathan Lambert,在一篇公开复盘里写得很直白,GPT-5.5 Pro 能从整本 PDF 里挖出细小错误,Claude 更像一个有品味的编辑,可一旦让模型从头组织完整章节,内容就会开始发散,顺序混乱,概念漂移,还喜欢在不该耍聪明的地方拗句子。原文可以看 这篇 Interconnects 文章。
同一代模型,写函数、改 bug、解数学题越来越猛,写长篇非虚构内容却像卡在另一个版本里。
为什么?
我的判断是,很多人把长文当成了更长的文本生成任务。喂一份资料,给一个题目,把输出 token 拉高,等模型一路吐到结尾。看起来像写作,其实更像让一个程序只靠标准输出维持全部运行状态。
能跑才怪。
长文不是一句话的放大版,它更像一次持续几十分钟甚至几天的有状态构建。标题挂着一条承诺,开头放进一个问题,中段不断引入术语、证据和限定条件,结尾还得把前面的枪打响。每加一段,都可能让前面某个判断失效。
模型最容易翻车的,恰好是这组跨段、跨节、跨版本的依赖。
句子级检查全绿,整本书仍然构建失败
Lambert 给出的成功案例都很具体。
GPT-5.5 Pro 检查两三百页近终稿,擅长找拼写和小问题。Claude Code 根据 LaTeX 文件里的 \editor{} 标记,逐个定位编辑意见,打印前后文,再区分简单修正和需要作者判断的问题。模型还帮他同步 Markdown 与 LaTeX 两份书稿,一份接网页读者反馈,一份供 Manning 的编辑团队审阅。没有智能体,这类同步工作可能要多花五倍时间。
厉害了,而且每一项都是真干活。
但你仔细看,这些任务都有明确边界。错字有没有改对,可以核对。两份文件有没有同步,可以跑 diff。某条编辑意见有没有处理,可以查标记。公式能不能编译,代码能不能执行,链接能不能打开,都有外部信号。
模型负责的是一个个能验收的单元,不是替作者决定整本书先讲什么、为什么这样讲、哪里应该删掉一段看起来正确却破坏主线的话。
这很像软件工程里的单元测试和集成测试。
模型现在已经很会通过句子级单元测试。语法通顺,术语像样,单段也有观点。可把五十个各自合格的段落拼在一起,不等于得到一章合格的书。上一节把某个概念当作前提,下一节又从零科普一遍。前面说方案只适合离线批处理,后面却悄悄拿它支撑实时场景。标题承诺讲代价,写到结尾只剩优势。
每一句都能过 lint,整个 build 还是红的。
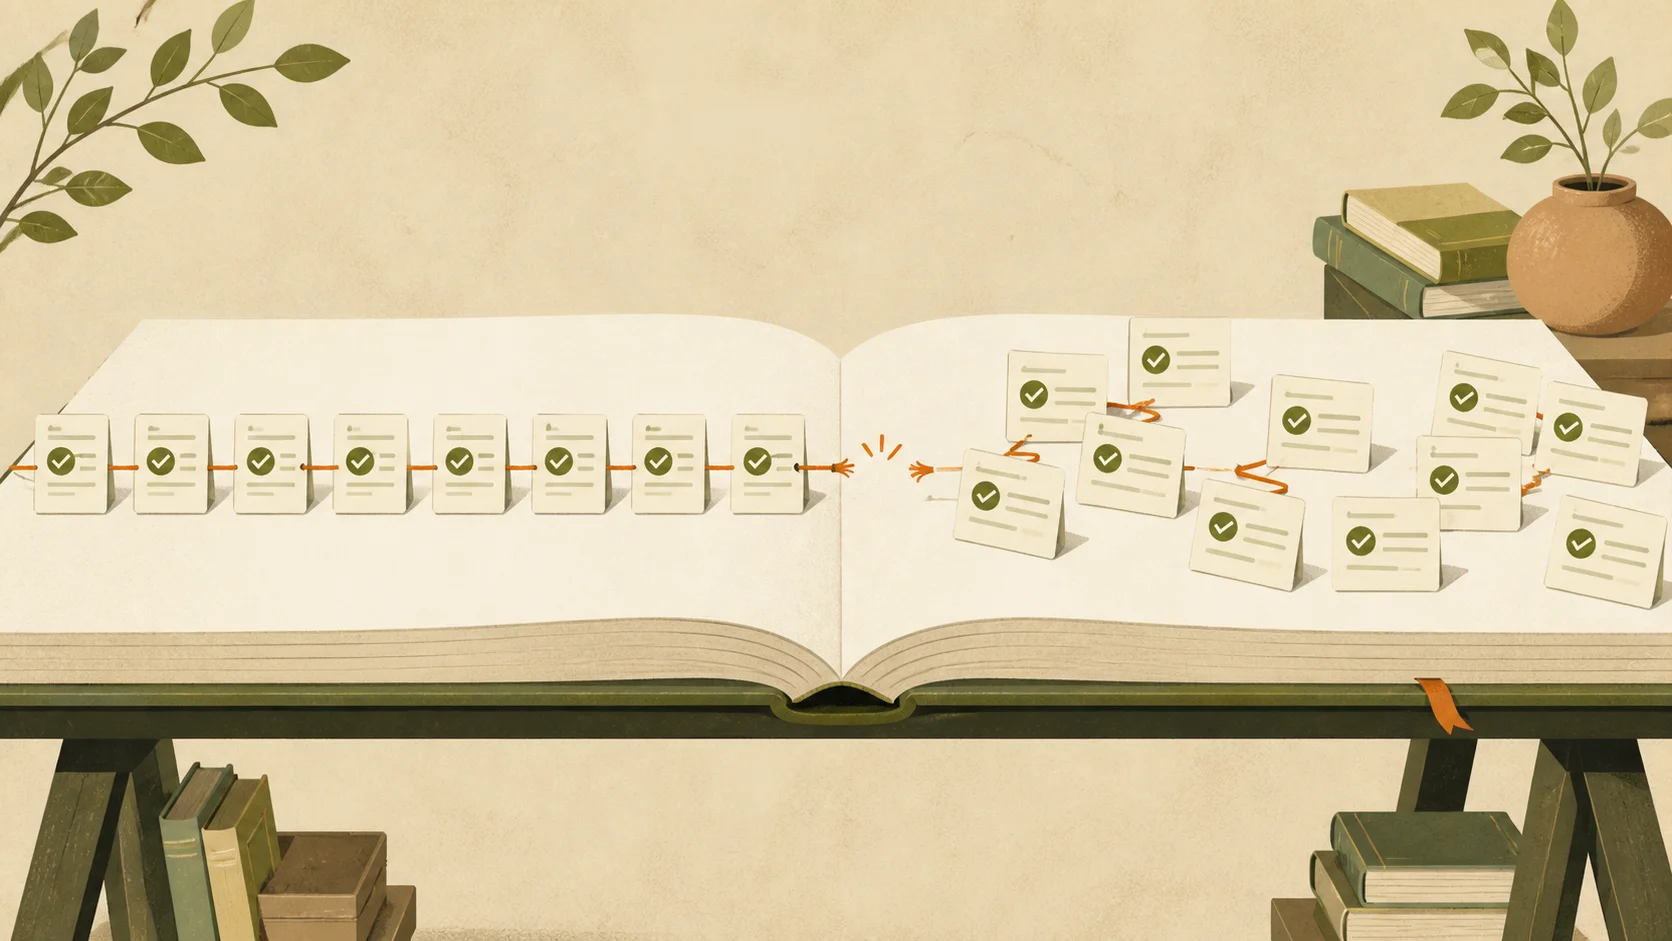
句子级测试全绿,不代表整章还能保持同一条主线
Lambert 关于信息与洞察的另一篇文章 把组织知识称为一种压缩。这个说法很准。写作不是把知道的东西尽量铺开,而是决定哪些事实共享一个结构,哪些例子只留一个,哪些限定条件必须跟着结论一起移动。
模型默认更擅长加内容。看到一段不够完整,就补背景,看到一个概念,就补解释,看到结尾,就补一层升华。信息越堆越多,结构却未必更清楚。最后的感觉像一个装满依赖却没人维护 lockfile 的仓库,什么都有,谁也不敢升级。
长文最缺的不是上下文,是可恢复的状态
很多朋友可能会问,现在上下文窗口都这么大了,把全文重新塞进去不就行了?
窗口能装下状态,不等于模型会正确维护状态。
一个上下文窗口里可以同时放标题、资料、旧稿和修改意见,但模型仍要判断什么是事实源,什么是作者观点,什么已经废弃,什么只是待验证假设。只要这些角色没有被显式标出来,更多上下文反而会让旧版本和新版本一起争夺注意力。
程序员对这种事应该很熟。内存够大,不代表状态机就对。
长文至少有四类状态需要单独维护。
一类是承诺状态。标题和开头到底答应读者什么,正文每一节负责兑现哪一部分。
一类是证据状态。每个数字来自哪里,哪个判断只是一手作者的看法,哪个结论有官方文档或实验支撑,哪些材料不能越过限定条件使用。
一类是概念状态。术语第一次在哪里解释,后面用的是不是同一个定义,缩写、版本和产品名有没有漂移。
还有一类是叙事状态。前面埋了什么钩子,哪里需要回扣,哪些段落虽然不错,却把文章带去了另一条支线。
坦率讲,直接把这些状态埋在几千字自然语言里,再指望模型每次编辑都完整恢复,有点像把数据库事务日志写进群聊记录。不是绝对不能恢复,只是代价高,失败时还很难知道从哪一步开始坏的。
更靠谱的做法,是把它们拆成模型能检查的外部工件。不是再写一份漂亮大纲,而是一张能被逐项验收的写作合同。
promise:
  question: 为什么模型写不好长篇技术内容
  payoff: 一套可执行的长文构建流程

claims:
  - id: C1
    statement: 模型擅长局部编辑
    evidence: Interconnects 原文
    limit: 不等于能组织完整章节

terms:
  long_form_state: 承诺、证据、概念与叙事状态

callbacks:
  - 300 页错字检查
  - 句子级测试与整章构建

forbidden:
  - 无来源数字
  - 把作者观点写成行业共识
  - 整篇覆盖式重写
这份东西不追求好看,它的价值是让每轮编辑都有恢复点。某一段改坏了,可以回到对应 claim。某个数字找不到出处,可以只阻断那条证据。标题换了,先更新 promise,再检查哪些章节已经失去任务。
怎么说呢,这才像工程。
数学和代码有判题器,写作还没有
模型在代码和数学上的快速进步,容易让人误以为同一套能力会自然外溢到写作。
可这几个任务的反馈结构差得很远。
代码能编译,测试能返回红绿,数学证明可以被形式系统检查。可验证奖励强化学习,也就是 RLVR,正是靠这些相对清楚的信号减少长链路里的错误累积。模型走错一步,环境能告诉它错了,训练过程也能逐渐奖励更稳定的路径。
长文里没有现成的 pytest。
一段话读着顺,却可能偷换概念。一章结构完整,却可能把最关键的反例藏到了脚注。事实都准确,依然可能没有观点。最麻烦的是,很多错误只有真正懂这个领域、也知道目标读者是谁的人才能看出来。
这也是为什么 Anthropic 的黎曼 zeta 研究 很亮眼,却不能直接推出模型已经会处理所有开放科学问题。数学探索里可以组织大规模搜索,再由专家与形式化工具验证关键结果。技术写作也需要搜索和推理,但它还要选择解释顺序、构建读者心智模型、压缩材料、管理语气,并判断什么不该写。
后一组工作,很难用一个标量奖励概括。
好消息是,我们不必等到写作判题器从天上掉下来。可以先自己搭一套弱一些、但够用的验收层。
事实层跑链接检查,给每个数字保留来源。
概念层维护术语表,检查同一名词是否出现多个定义。
结构层让评审模型只回答一件事,每一节是否真的在兑现标题承诺,不让它顺手润色。
反例层单独找文章里最强的反对意见,检查正文有没有诚实回应。
版本层把每次修改限制在一个 diff 里,先看删除了什么、改动波及哪些段落,再决定是否合并。
这里最关键的一刀,是让评审和改写分开。一个模型既判卷又直接改稿,很容易一边修问题,一边把原本的人味洗掉。先产出带位置和证据的缺陷单,再按缺陷局部修改,效果通常更稳。
有点子牛逼的地方也在这儿。我们不需要模型突然拥有完整的文学品味,只要先让那些可以外置的判断变得可追踪,长文质量就能往前走一大截。
别让模型写一篇文章,让它跑一次构建
如果现在要用 Claude Code、Codex 或别的智能体协助写长文,我会把流程切成几次很窄的任务。
先只做证据账本。每条事实配原始链接、时间和限定条件,二手摘要只能做线索,不能直接成为引用。
再只做骨架。每一节写一句任务声明,说明它给主论点增加了什么。如果两节的任务声明几乎一样,先合并,别急着扩写。
然后按节生成,但每次都把 promise、相关 claims、上一节结尾和下一节任务一起交给模型。不是把整份上下文一股脑塞进去,而是给当前步骤最小但完整的状态切片。
写完先跑局部检查。禁词、链接、数字、术语、段落重复,这些能机械查的先机械查。机器能做的别留给品味,品味很贵。
最后才做集成检查。把文章当成读者第一次看到,从标题一路走到结尾,找承诺断线、定义漂移、证据越界和支线残留。问题单出来后,只改命中的句段,不让模型整篇重写。
你如果已经在用 git 管文章,这套流程更顺手。一次任务一个 diff,一次评审一张缺陷单。Vale 可以查风格规则,markdownlint 可以管基础格式,链接检查器负责死链,剩下那些只能靠领域判断的问题,再交给人和评审模型。
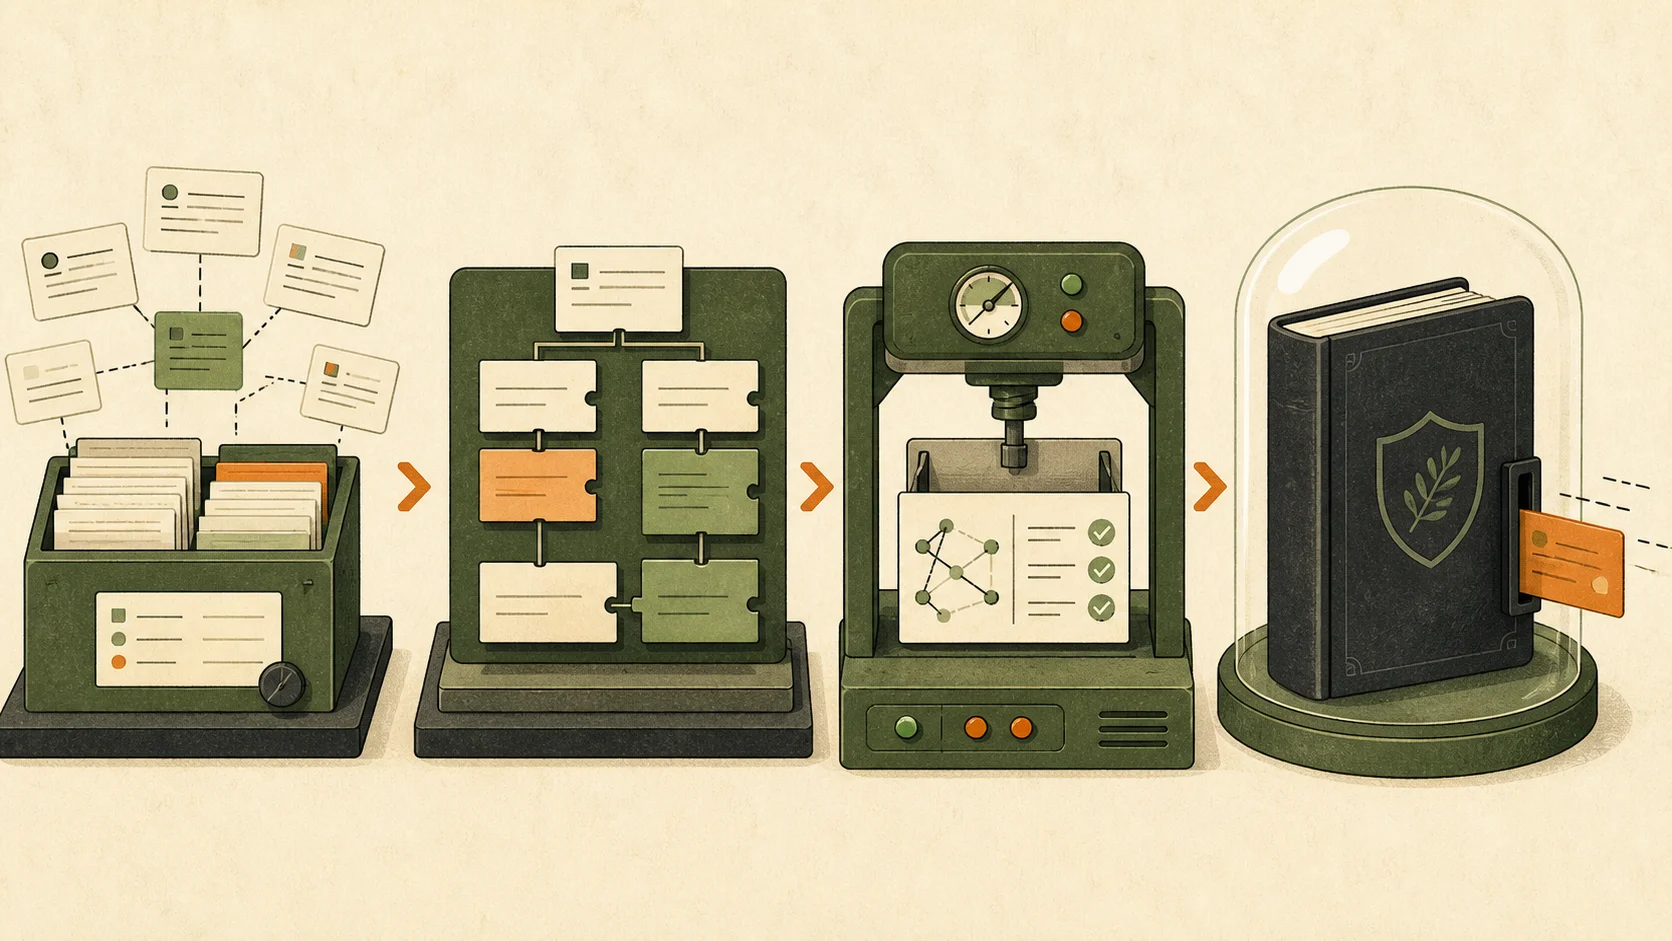
模型不是一次写完全文,而是在证据、结构和验收闸门之间交付小补丁
反正我觉得,模型最适合扮演的不是替你坐在书桌前的作者,而是一支不会累的构建队伍。有人查依赖,有人跑测试,有人定位失败,有人准备补丁。至于这本书为什么存在、读者应该带走什么、哪句看似漂亮的话必须删掉,仍需要一个人守着主分支。
Jasmine Sun 写过模型为什么更适合编辑而不是作者。Lambert 的实践也给出了很具体的证据。他甚至公开了书里的 图表源码,模型能帮忙写 TikZ、Python,能做格式转换,也能维护重复劳动。它确实让知识更容易变成不同媒介。
但媒介转换和知识创造,不是同一个任务。
在非虚构写作的最早阶段,作者要决定骨架,决定先讲什么,决定哪些事实放在一起才会产生理解。那段看起来最慢、最不像产出的工作,往往才是洞察生成的地方。把它全部交出去,省下的是时间,也可能顺手省掉自己的判断力。
所以未来两到五年,最好的教材大概率仍然会有很重的人手痕迹。我不知道更远以后会怎样,但今天的边界已经很清楚。
AI 能检查三百页,也能替你补一段。
真正难的,是让第三百页还记得第一页答应过什么。