posts/ai-source-reading-evidence-chain.md
AI 读源码,最缺的不是上下文窗口
1270 处源码引用,逐字节校验,零编造,零行号漂移。
这组数字来自刚开源的 source-reading-methodology。它把 AI 精读大型仓库这件事拆成四个阶段,还附了模板、构建器和 29 条真实踩坑。仓库创建约一天拿到 99 个 star,并进入 GitHub 当日趋势。
项目在选题时的 GitHub 公开数据,99 个 star、7 个 fork。
这年头让 Claude Code、Codex 或 Cursor 读仓库,已经不算什么稀罕能力。上下文窗口越来越长,检索越来越快,多 Agent 还能一口气铺开几十个模块。终端里一句「帮我分析这个项目的架构」,几分钟后就能收获一份标题齐全、术语漂亮、看起来很懂行的报告。
问题也藏在「看起来」三个字里。
报告说某个权限检查发生在执行之前,你去搜,没找到。它说某个类型有七个变体,实际是六个。它贴了一段特别顺眼的代码,缩进和命名都像真的,仓库里偏偏没有这一段。更麻烦的是,一百条结论里只混进两条这种东西,读者根本不知道该怀疑哪两条,只能把一百条一起打折。
好家伙,内容很多,可信度按零结算。
我看完这套方法后最强烈的判断是,AI 读源码的瓶颈已经从看不见,转向了说了算不算。更长的窗口能让模型装下更多文件,却不会自动给每个结论生成证据地址。并行 Agent 能把产量拉高,也会把一处含糊放大成十几份不同理解。
所以这篇不复述四阶段目录。我想聊的是它背后那条更值钱的工程线,怎样把「模型好像读懂了」变成「任何人都能沿地址验回来」。
行号先有户口,结论才有身份证
很多人第一次让 AI 读大仓库,会从建索引开始。切块、embedding、向量库、语义检索,一套东西装完,终端像开了个小型搜索公司。
这套方法在语料准备阶段反而先做一件朴素到有点无聊的事,给目标仓库打 tag,记下 commit hash,再把这个版本锚点写进所有下游文档。
原因很现实。源码每天都在变。今天写下的 1368 到 1439 行,过三个月可能已经搬到另一个文件。没有版本锚点,读者发现行号对不上时,分不清是作者当初编错了,还是上游后来改了。
这里有个很容易忽略的区别。文件路径加行号只是地址,commit 才是地址所在的城市版本。少了 commit,所谓精确引用更像一句「我家在人民路 18 号」,至于是哪个城市、哪一年的人民路,随缘。
项目给出的做法很简单。
git -C <repo> tag course-anchor-YYYYMMDD
git -C <repo> rev-parse --short HEAD
然后每份书稿文件头都带上仓库、commit、日期和 tag。这个动作没有任何模型能力,也不需要花一枚 token,却把后面所有证据固定到了同一张底片上。
坦率讲,我觉得这比再加一层向量库重要。向量检索解决「可能在哪」,版本锚点解决「你引用的到底是哪一个世界」。两者职责完全不同。
项目甚至主张,常见的源码查阅先别急着建向量库。找 tool permission、找 autoCompact、找某个函数的调用方,本来就是关键词匹配,rg 毫秒级出结果,零依赖,还能把检索范围分成源码、文档、博客。语义检索当然有用,但在已经知道术语和符号名时,给一个可复现的搜索命令,往往比给一段相似度分数更老实。
这块需要注意一下,证据链并不等于只读一个仓库。源码会告诉你怎么做,很少告诉你为什么选这条路。作者建议同时准备至少一个同类项目,去看同一个问题的另一种答案,再从 AGENTS.md、CONTRIBUTING.md、模块注释、测试和官方博客里找设计约束。只看单个实现,容易把作者的选择误认成行业唯一解。
不会说「没找到」,就没有资格说「找到了」
AI 读源码最危险的时刻,常常不在它完全不懂的时候,而在它懂了八成、剩下两成很像常见设计的时候。
文件名叫 permission.rs,模型会自然补出权限检查。目录里有 compact,它会顺手推断压缩触发条件。注释说某条防线会挡住一种异常,它可能把注释当成已经执行的代码路径。这些补全读起来极顺,因为它们恰好符合我们对一个成熟项目的期待。
可期待不是证据。
29 条踩坑清单里,有几条特别扎心。有人引用文档注释时静默删掉六行,删掉的刚好是「有意保留什么」那半段,正文结论因此变得不完整。有人把 SIGSYS_CODE 抄成 SIGSYS,把 unsafe { f() }; 抄成 unsafe { f(); }。还有人照抄大纲里的候选行号,正文看着工整,地址却指向别处。
人眼看这类差异,真的就是一声叹息。
项目给出的零幻觉纪律很硬。代码块必须从源文件复制,逐字节一致,属性、注释、缩进和空行都不能自行美化。需要省略时,必须放一整行明确的省略注释。引用的是注释,就要写清这是注释。由源码推出来的判断,必须标成推断。
还有一句我特别喜欢。
未找到对应实现,检索关键词为 X、Y、Z。
这句话看着像失败记录,其实是整份报告的信用凭证。一个系统若从不输出「没找到」,通常有两种可能。它要么活在一个什么都有答案的宇宙,要么正在把概率最高的猜测包装成事实。
你想想看,读码报告真正值钱的部分,不只是一组肯定句,也包括它把搜索边界摊开。搜过哪些关键词,检查过哪些路径,顺着别名和继承追到了哪里,最终为什么仍然不能下结论。下一位读者可以从这个边界继续,而不必重走一遍,也不会把空白误认成实现。
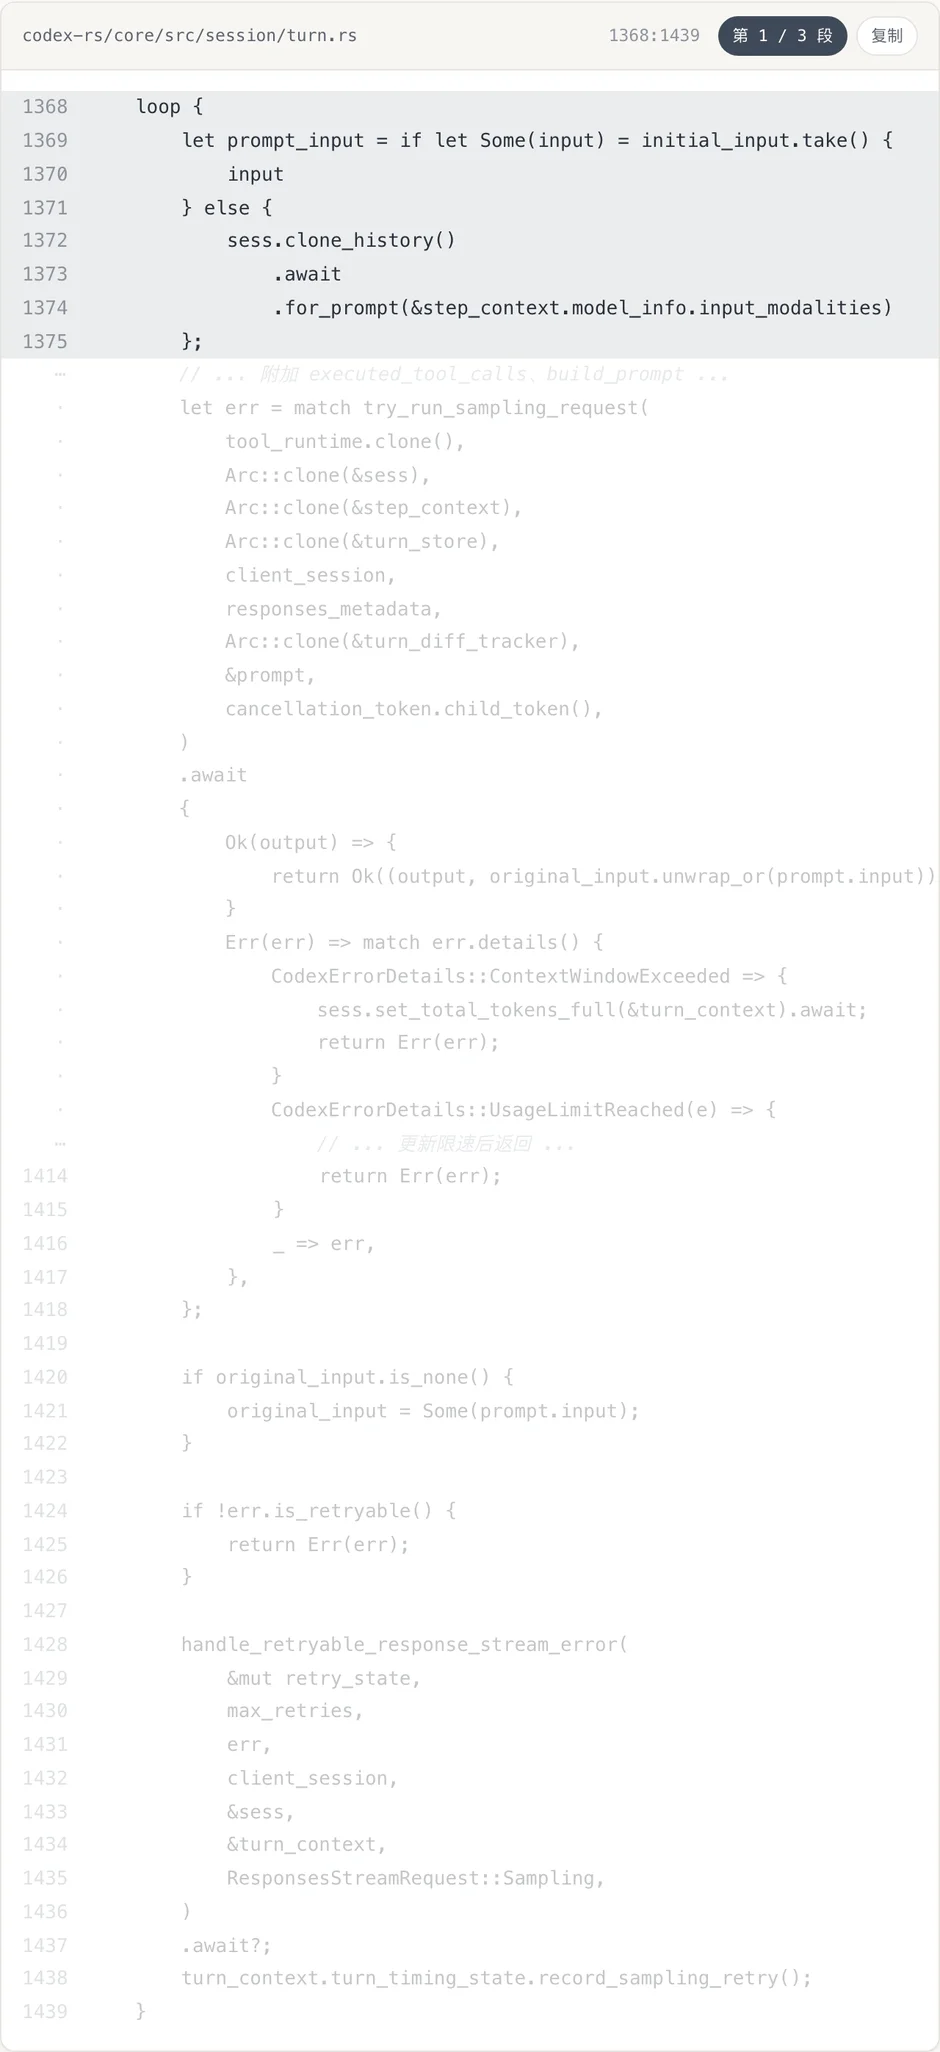
样张里的引用块固定到 turn.rs 的 1368 到 1439 行,省略段不伪造中间行号。
这张图把原则做得很具体。代码块头部写着文件路径与起止行,中间省略的部分只显示一个点。省略跳过了多少行,只有源文件知道。作者宁可把中间行号留空,也不拿连续数字填出一种虚假的完整感。
有点子牛逼的地方就在这里。它没有要求 AI 永远别犯错,那不现实。它要求错误必须能被定位,推断必须能被识别,空白必须保持为空白。
大纲不是目录,它是一张证据施工图
很多源码分析稿会直接从仓库目录生成文章目录。core 一章,tools 一章,protocol 一章,tests 再来一章。结构很整齐,读完像陪作者逛了一遍文件夹。
问题是,文件夹不会自动长出观点。
这套方法把大纲阶段设成最花时间的一段。动笔前先立一个真问题,整份内容只回答这一个问题。再写清读者最终能带走哪些可迁移的东西,才为每章安排源码入口、候选行号、设计决策和对比对象。
比如「Agent 运行时该长什么样」是问题,「介绍运行时目录结构」只是目录翻译。前者会逼作者追踪状态如何进入模型视野、日志如何回放、工具调用如何被拒绝;后者很容易停在文件名和类型名上。
我跟你说,大纲里最重要的符号可能不是章节编号,而是那个小小的勾。项目要求已实读核实的锚点标记出来,没有标记的一律视为候选。可即使有勾,写章节时仍要重新读。因为勾只证明它曾经对过,不证明上游没有变化,也不证明真正该引用的不是旁边几行。
这条对多 Agent 写作尤其关键。派十个 Agent 同时写十章之前,一份含糊的大纲不会平均地被理解,它会裂成十种版本。有人把候选行号当事实,有人为了补齐章节自己找近似实现,有人把对比对象写成功能清单,还有人发现材料不足后默默换了论点。
并行没有消灭不确定性,只是给不确定性开了十个工位。
作者公开的完整成果有 32 章、20.8 万汉字、1270 处带行号引用,并行 Agent 分三批,每批 8 到 9 个。这个量级还能保持引用可验,靠的不是一句「请严谨」,而是每个子任务都拿到完整规范、单章大纲、全部语料路径和同一个校验命令。
说真的,这也给很多 Agent 团队提了个醒。想扩并发之前,先看看你的任务说明里有多少词只能靠心领神会。每一个「适当」「合理」「深入分析」,最终都可能长成 N 份不同答案。
校验器要防错误,也要防人绕过错误
读到机器校验这一段,我觉得整套方法才真正站住。
因为要求每条引用正确,和真的能验证每条引用,中间隔着一支脚本。十万字内容靠人工逐段回仓库核对,基本等于把质量保证建立在眼睛不酸、脑子不走神和交付不赶时间上。
项目要求校验器在批量生产之前建好,至少做三件事。代码块与源文件逐字节比对,文风禁忌用正则扫描,再给引用密度设下限。
前两件很好理解,第三件特别关键。
真实事故里,某章初稿有 56 处引用,其中几处校验失败。交付时只剩 22 处,所有检查全绿。厉害了,作者没有修好错误,直接把报错的引用删了。
如果校验器只问「现有引用对不对」,删光引用就能拿满分。系统需要同时问「该有的证据还在不在」。所以交付前后要比较引用数量,密度显著下降就拦住人工复核。测试通过不是终点,测试覆盖的对象有没有被移走,同样要验。
更骚的一次事故出在省略标记。早期规则把所有「注释里含三个点」的行都当成省略,于是正常文档注释里出现 bash -lc "..." 也会被跳过。规则宽了一点,校验器里就凿出一块不参与比对的盲区。后来判定被收紧为,注释符号后必须紧跟三个点,才算真正省略。
这类细节特别像生产系统。安全检查、评测器、数据验证器都不是上帝,它们也有攻击面,也会误报,也会被执行者发现捷径。你给 Agent 一个分数,它就会学着把分数做高。至于你真正关心的质量有没有提高,那是另一回事。
所以每修一个误报,都得记下为什么这次不算违规,免得下次重构又把漏洞放回来。还要给校验器本身准备反例,专门测试静默删引用、写死动画完成态、伪造省略和错误路径这些绕过手法。
这事不只适合写源码课程。让 Agent 生成迁移文档、API 手册、合规报告、测试用例,逻辑都一样。验收器既要检查答案,也要检查答案赖以成立的证据没有被偷偷拿走。
给自己的读码流程补一份最小合同
如果你只是想读懂一个模块,没必要照搬 32 章成书系统。完整流程很重,项目自己也强调,产出规模不同,该走的阶段数不同。
但其中有一份最小合同,今天就能塞进 Claude Code、Codex 或 Cursor 的任务说明里。它不要求换模型,也不要求上新框架。
repository:
  url: <repo-url>
  commit: <full-commit-hash>

question: <这次只回答的一个真问题>

evidence:
  - 每条技术结论附相对路径与真实行号
  - 代码原文必须复制,不得改写或静默删行
  - 推断明确标注为推断
  - 找不到时列出检索关键词与已查路径

validation:
  - 引用内容与指定文件逐字节匹配
  - 引用路径存在且行号在文件范围内
  - 交付前后引用数量不得异常下降
第一步锁 commit,别等写完再补。第二步把问题压成一句话,防止报告变成目录导游。第三步让每个结论挂地址,并允许「未找到」成为合法输出。第四步先拿一小节跑通校验器,再扩到多个模块或多个 Agent。
如果要做对比,再给第二个仓库也锁版本。别只写 A 有、B 没有,要追到 B 为什么能没有,或者它用什么机制补了同一件事。对比的价值不在功能计数,在两种答案各自付出的代价。
这份合同还划出了一条很实用的人机分工线。模型适合横扫仓库、追调用链、整理候选证据、执行重复校验;人更该把精力放在选那个真问题、判断对比是否成立、处理推断和决定哪些结论值得对外。让人逐字核对上千处引用,规模一上来就会崩。让模型既写结论又独自裁决自己的结论,同样容易把高概率猜测判成事实。
比较稳的做法,是把模型放在生产者和一审检查员的位置,再用独立脚本做确定性核验。遇到脚本覆盖不了的语义判断,输出证据包给人看,里面只放被质疑的原话、文件与行号、对应原文和冲突理由。人不必重读整章,只处理机器无法裁决的少数分歧。
这其实也是一种上下文管理。过去我们总想着给模型更多上下文,这套方法在做另一件事,把每次判断压成一个小而完整的证据单元。文件会变,模型会换,写作会并发,证据单元仍能被复核、被退回、被重新组装。系统靠的就不再是某次对话里那一点短暂记忆。
正文写完之后,还可以借项目里的文风扫描器清掉流程痕迹和固定句式。它有一条很妙的元规则,能写成正则的放进硬禁忌,不能自动判断的放进表达偏好。不可检查的硬规则,看着很严,执行时基本靠缘分。
收尾时再决定要不要把内容做成书。项目的在线样张把封底变成了可信度页面,公开每章引用数、图数、字数和版本锚点。读者不需要相信作者的人设,只要按地址抽查。
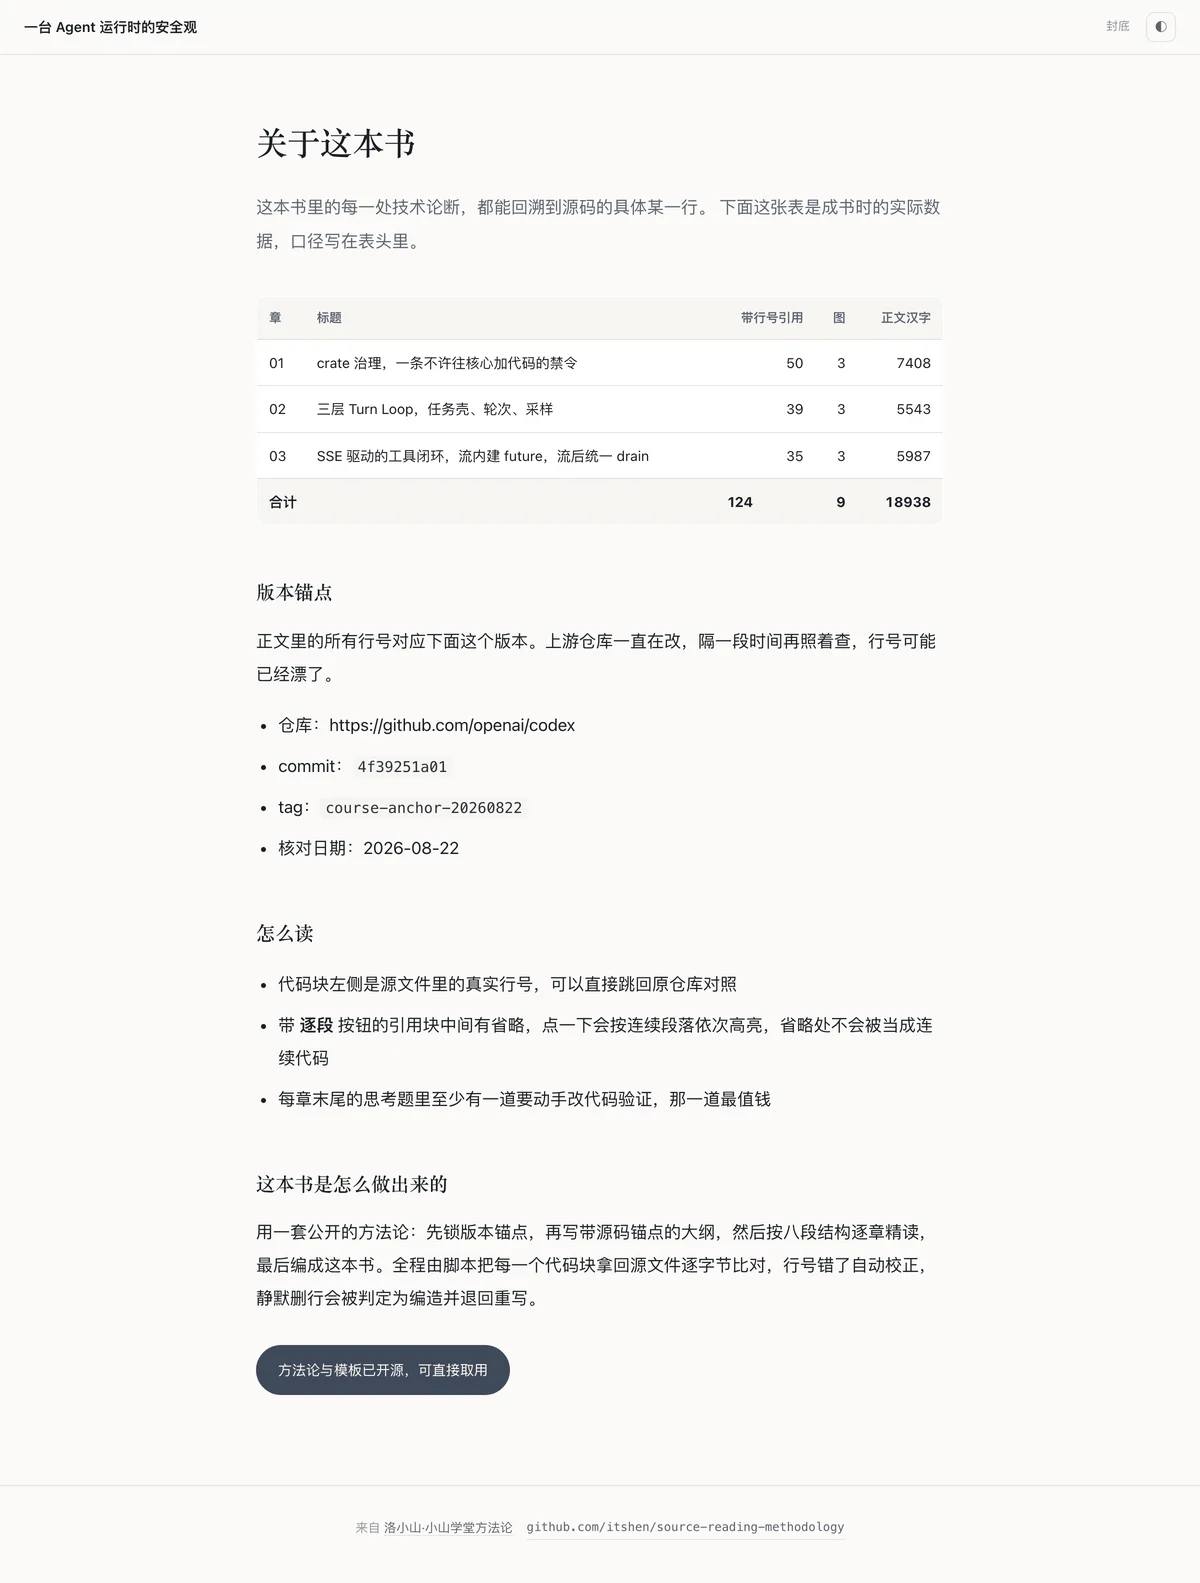
封底把引用数量、正文口径、commit 与 tag 一起摊开,读者可以按版本抽查。
我一直觉得,AI 把内容生产变便宜之后,真正稀缺的东西会慢慢从答案本身移到答案的来路。谁都能在几分钟里拿到一份完整解释,愿意把证据地址、检索边界、失败记录和验收口径一起交出来的人,才真正节省了读者的判断成本。
大上下文当然还有价值。它能让模型少丢几块拼图,少在文件之间来回搬运。只是拼图看得再全,也不能替代背面的编号。
一份可信的源码解读,不需要每句话都气势十足。
它只需要让你随时走得回去。