posts/ai-training-data-ledger-music-copyright.md
数万首歌进了诉状,AI 训练台账该补课了
一首歌掉进训练集时,工程表里可能只剩下一段文本、一个 URL、一个抓取时间和一串内容哈希。
等它走进法庭,却突然裂成了好几样东西。歌词是一份权利,曲谱可能是另一份,录音又归另一拨人。文本旁边被清掉的作者、出版社和版权声明,也可能单独成为争议。
同一段数据,工程师看见的是 content,权利人看见的是一叠合同。
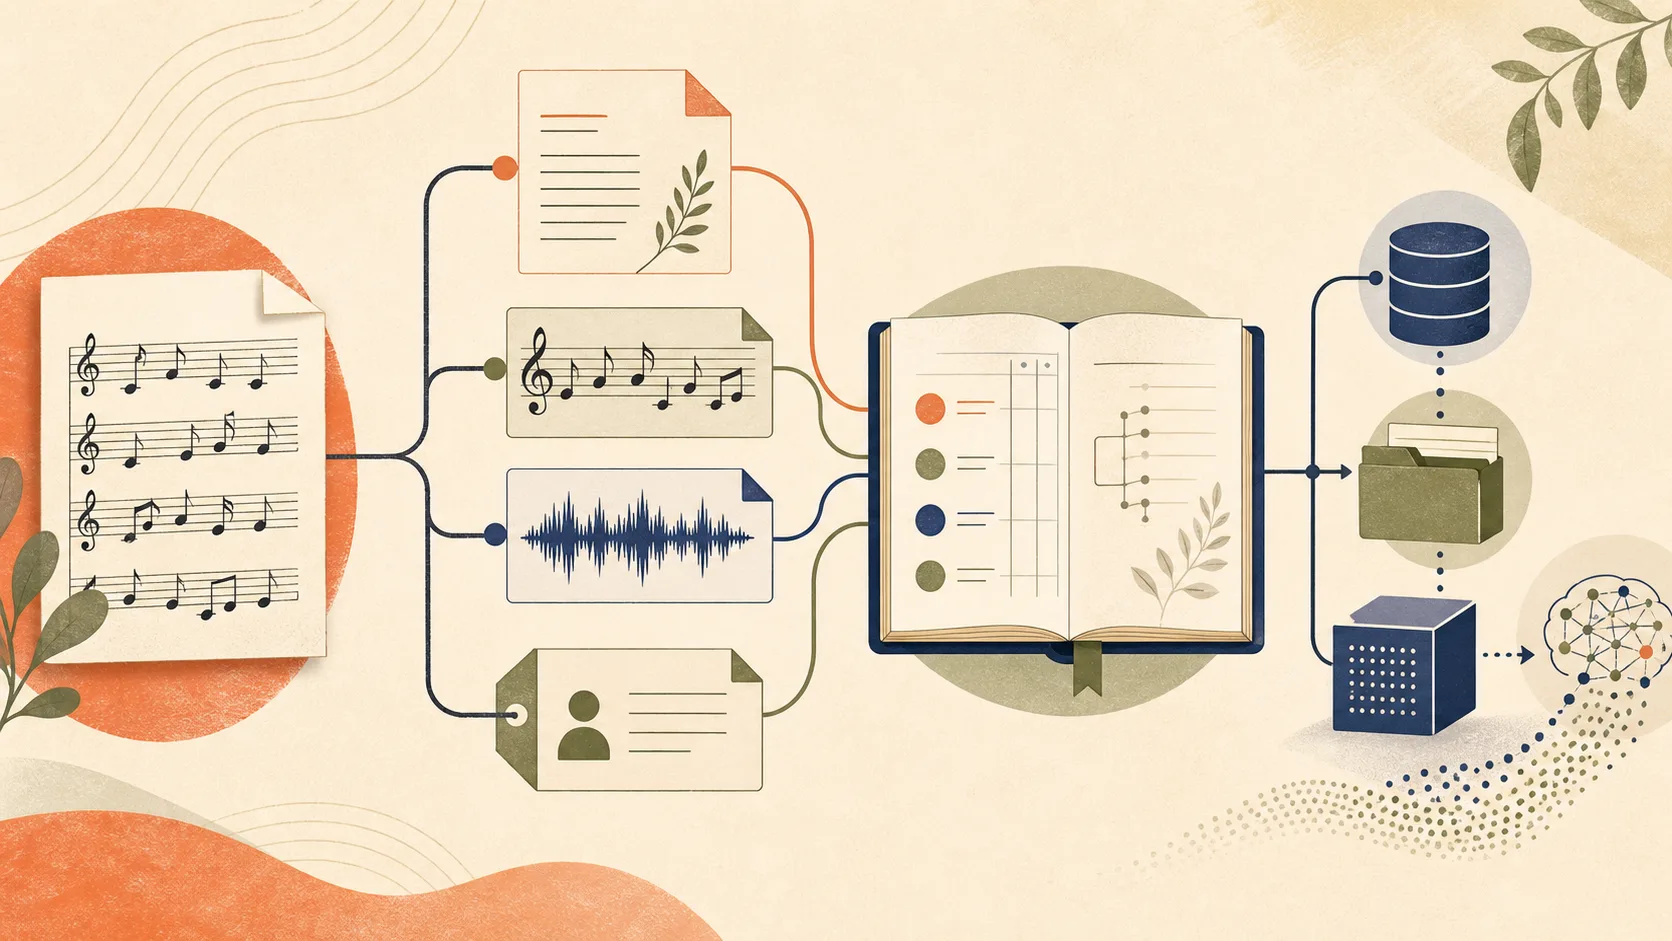
一首歌不是一条扁平文本,进入训练管线前就带着多层权利关系。
8 月 28 日,索尼音乐出版和华纳查普尔音乐在美国加州北区联邦地区法院提交了一份 48 页的诉状。原告称,Anthropic 获取并使用了数万部受版权保护的音乐作品,争议覆盖数据获取、模型训练、Claude 输出以及版权管理信息。行业媒体 Music Business Worldwide 把案件的四类主张和音乐出版行业此前的几宗诉讼放在了一起。
先把刹车踩住。
这些都是原告在诉状里的指控,不是法院已经认定的事实。Anthropic 也向 Axios 表示,不同意出版商的主张,并会积极抗辩。标题里那些吓人的数十亿美元,只是把作品数量乘上法定赔偿上限后的理论暴露,不是判决书上的数字。
我不打算替法官抢活,也不想把这篇写成谁更坏的口水稿。
真正让我停下来的,是原告提出的一个要求,他们希望 Anthropic 交代 Claude 的训练数据,并销毁被指侵权的副本。
好家伙,这两个动作落到工程系统里,问题一下就具体了。
你能不能回答某段数据从哪来,靠什么授权进入系统,被谁处理过,进过哪一轮训练,影响了哪些模型版本。收到删除请求之后,你能不能让它停止出现在下一次训练、微调、检索库和评测集里。已经训练完的权重怎么办,输出侧的记忆测试怎么办,衍生数据还能不能继续用。
这不是法务在发布前填一张表就能解决的事。
这是数据管线的能力。
一首歌不是一条文本
很多团队的数据资产长这样,原始网页进对象存储,清洗任务去掉导航、广告和重复段落,切成 chunk,再进预训练、微调或 RAG。RAG 就是检索增强生成,先从资料库捞相关内容,再让模型回答。
流程很顺,血缘却常常在清洗时断掉。
原始 URL 还在不在。抓取当天的页面快照有没有保存。网站允许展示内容,是否也允许批量下载、训练、生成相似输出和商业部署。某份许可证只覆盖研究用途,后来模型转成收费 API 时,有没有重新检查。文本去重后合并了多个来源,删除其中一个来源时,系统知不知道该删哪个副本。
音乐会把这些坑放大,因为它不是一个扁平的 text/plain 文件。Axios 提醒,一首商业歌曲可能同时包含歌词、录音和乐曲等不同版权,权利还可能分散在艺人、出版商、唱片公司等主体手里。
工程上最危险的简化,就是把「公开可访问」当成「拥有所有用途的授权」。
公开网页只说明浏览器能拿到 200,不替你签训练合同。robots.txt 也不是许可证。买到一本书,更不自动带来把整本书拆成训练样本并对外提供模型服务的权利。
美国版权局的生成式 AI 训练报告没有给训练行为盖一个统一的合法或非法印章。它强调合理使用要逐案判断,而且预训练、后训练、微调与 RAG 等不同使用阶段需要分别看。报告还指出,音乐、小说这类高度表达性的作品,和事实资料、功能性代码并不是同一种判断难度。明知使用盗版副本服务商业系统,也会让合理使用抗辩更难。
所以,一条可用的数据记录至少不该只有 url 和 content。我自己的判断是,团队要把它做得更像软件供应链里的物料清单。
source_uri: 原始位置
captured_at: 获取时间
content_hash: 原始内容哈希
rights_holder: 已知权利主体
acquisition_basis: 自有、授权、公开许可或待复核
license_scope: 训练、微调、检索、输出、商用范围
transform_chain: 清洗、切分、去重与派生步骤
dataset_versions: 出现过的数据集版本
model_versions: 训练或评测关联的模型版本
deletion_state: 生效、冻结、删除或争议中
evidence_uri: 合同、许可页面或快照位置
这里最难的字段不是 content_hash,而是 license_scope。
许可证会变,网站条款会变,产品用途也会变。今天做研究原型,三个月后接进收费 API,原来的授权未必跟着升级。坦率讲,靠一份静态 Excel 记不住这种变化,最好把权利状态也做版本化,让每次数据集构建都能重放当时的判断依据。
真正有用的台账,得能反向追模型
只记录来源还不够。被投诉的数据如果已经穿过五次清洗、两轮去重和三个数据集,最终训练了四个模型,你需要从作品反向找到这些衍生物。
这块特别像依赖漏洞爆出来之后查 SBOM。SBOM 是软件物料清单,用来回答某个有问题的库到底进了哪些构建。训练数据也需要同样的反向索引。
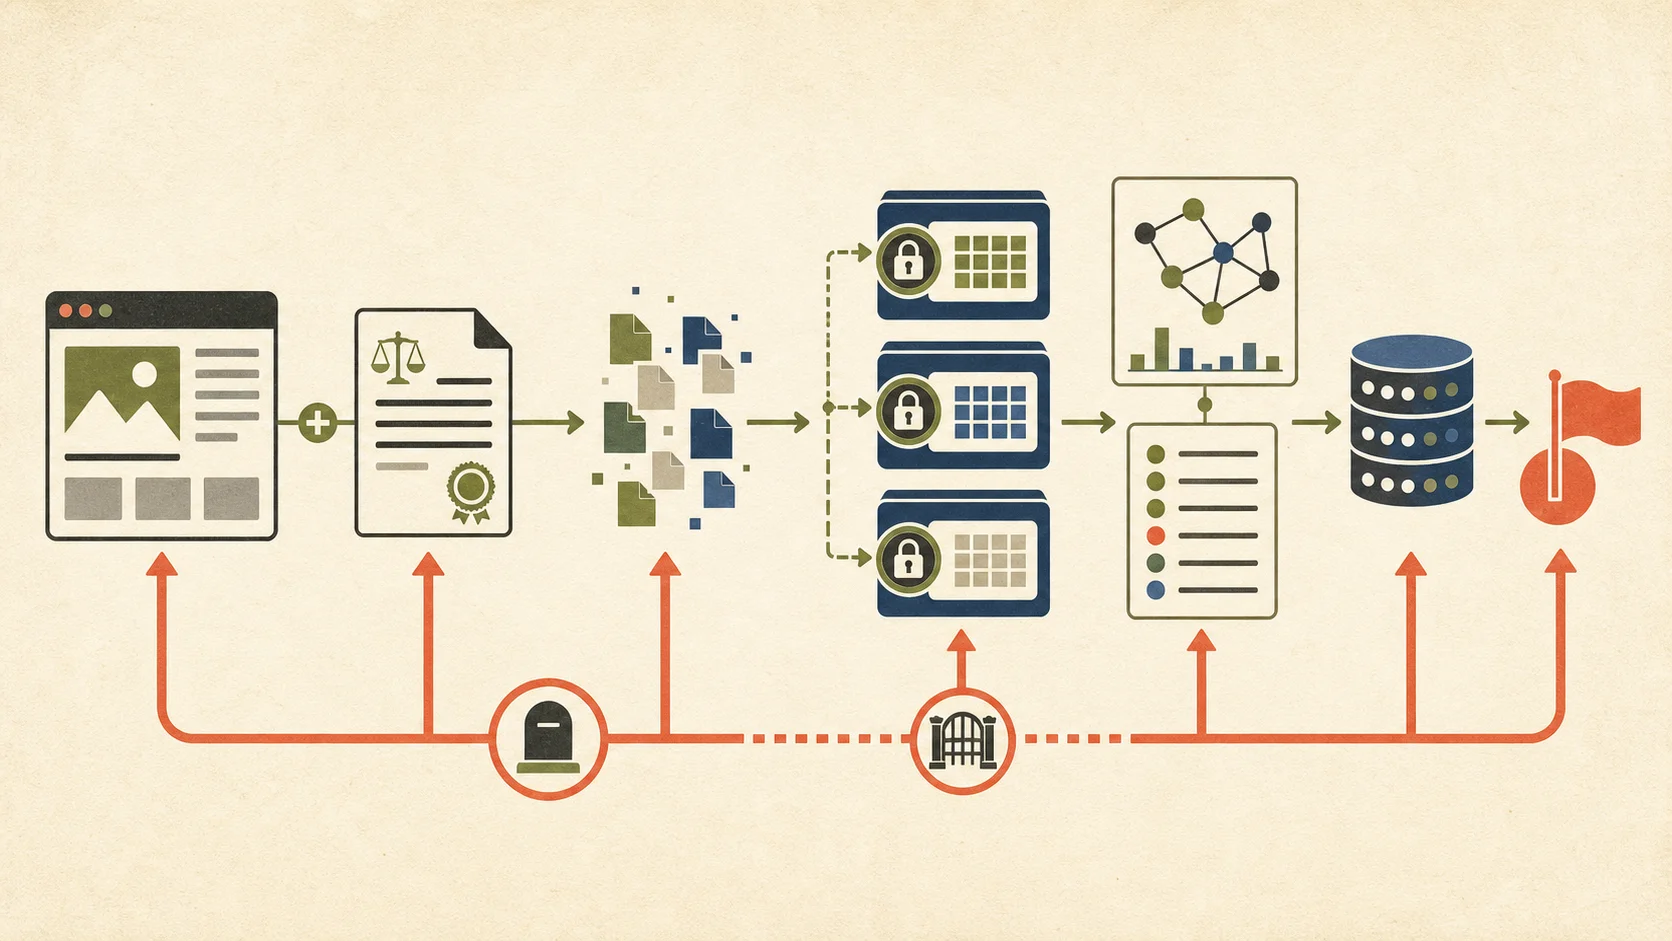
可用的训练台账不只记录来路,还要能从争议结果一路反查到来源。
具体到系统,可以把每次数据集构建当成不可变版本。原始内容用哈希寻址,清洗任务记录输入和输出,去重不要只保留胜出的文本,还要保留被合并来源的映射。模型卡里别只写用了某个大语料库,要能指向精确的数据集版本和处理配置。
收到权利主张时,先给对应内容加争议状态,让它退出下一轮构建,再跑影响分析。哪些训练任务引用过它,哪些向量库仍有 chunk,哪些评测题来自同一作品,哪些模型需要加输出防护或安排重训,都应该能查出来。
厉害了,平时嫌元数据占存储,真到要删一段内容时,大家才发现最贵的不是硬盘,是不知道它去了哪儿。
NIST 的生成式 AI 风险管理框架专门建议追踪训练数据和元数据的来源,同时记录溯源能力本身的局限。这个后半句很重要。不是挂一个 provenance 标签就算完工,团队还要诚实写清楚哪些数据能追,哪些历史批次只剩聚合结果,哪些第三方模型根本拿不到训练明细。
你想想看,一个系统如果无法回答边界,就不该假装自己有完整台账。
更现实的做法,是给可追溯范围分级。A 级能追到合同、原始快照、所有派生版本和模型。B 级能追来源与数据集,但不能确认权利链。C 级只有模糊来源,必须隔离,不能默认进入商业模型。未知不是一个空字段,它应该触发风控动作。
输出防护不是万能橡皮擦
诉状还有一层主张,Claude 的输出可能复现或近似复现受保护歌词,已有防护可以通过重新提示绕过。这里仍要强调,这是原告说法,后续要看双方提交的测试、上下文与法院判断。
但对模型团队来说,输出记忆测试本来就该做。
可以从训练集中抽取高风险表达性作品,构造直接索取、续写、改写、角色扮演和多轮诱导等提示,测量长片段逐字重合率。别只测一次拒答。攻击者会换语言、换开头、拆成多轮,安全评测也得跟着换。
测试结果还要和模型版本绑定。一次 guardrail 更新通过了,不代表下次微调、蒸馏或上下文策略调整后仍然通过。对高风险类别,可以把记忆回归测试塞进发布门禁,像跑单元测试一样跑。
不过,输出过滤只能处理系统吐出来什么,不能替训练输入补授权。把歌词挡住,不会自动改变数据当初怎么获得。反过来也一样,输入有许可证,不代表产品可以不管输出复现。
输入治理、模型评测、输出防护,是三层不同的活。
这也是这宗诉讼给工程团队最值钱的提醒。版权争议不会只停在一条抽象的「能不能训练」上。它会顺着数据管线往下问,副本怎么来的,元数据有没有被清掉,哪个阶段用了它,模型能不能吐回来,要求删除时系统能不能真的动手。
说真的,没人喜欢给数据管线补台账。它不提高 benchmark,不会让 demo 多一个炫酷按钮,做完也很难在发布会上占一页。
可当一段文本从对象存储一路航行到模型权重,台账就是那张海图。平时看着只是几条线,起雾之后,才知道哪里是航道,哪里是暗礁。
别等诉状帮你画。