posts/alloydb-scann-four-level-tree.md
100 亿向量塞进 AlloyDB,专用向量库的边界松了
100 亿向量,p95 延迟不高于 51 毫秒,召回率 95%。
这三个数字被 Google 放在了同一句话里。
好家伙,以前一提到百亿向量,脑子里马上就是分片、独立向量库、多套运维体系。现在 Google Cloud 的公告说,一个兼容 PostgreSQL 的全托管数据库,里面的 ScaNN 索引也能碰这个数量级了。
我看到 51 毫秒时确实有点兴奋,但紧接着就得补两行小字。这是官方内部测试,四层树仍然是 Preview。测试的数据分布、向量维度、机型、查询并发和更新压力,公告没有给全。
所以这不是一篇「AlloyDB 已经打死向量库」的爽文。那种结论下得太早,跟用一次 benchmark 决定线上架构差不多,都有点心大。
真正值得琢磨的,是四层树把一条旧边界往外推了。
多一层树,不是多一个目录
向量搜索干的事,是从海量 embedding 里找到与查询最接近的那一小撮。Embedding 就是把文本、图片或商品映射成一串数字,距离越近,语义通常越相似。
最笨的办法是每次都与全库比一遍。在几万条数据上还能忍,到上亿条就成了一场电费表演。因此 ScaNN 用树形聚类先把空间切成许多片,查询时先判断大概在哪片,再去做精查。
原来的两层树,搜索空间大致按 O(N^1/2) 增长。三层树降到 O(N^1/3),现在四层树继续降到 O(N^1/4)。
别被公式吓跑。拿 100 亿这个 N 粗略感受一下,它的平方根是 10 万,四次方根只有大约 316。这不等于真实查询只扫 316 个向量,但它能帮我们看懂层次分区为什么在极大规模下突然变得值钱。平面上一次切不动的搜索空间,改成一层层收窄,每次只把小部分分支带到下一轮。
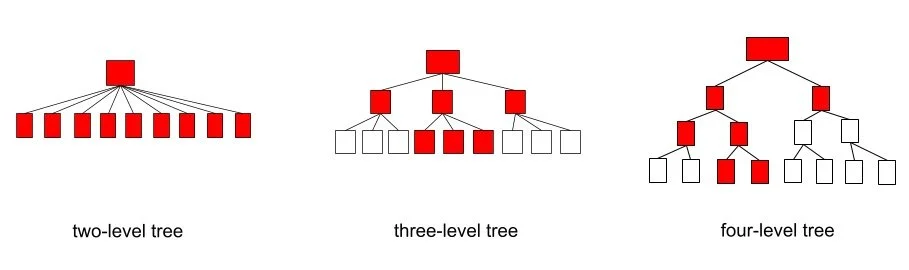
官方示意图,红色节点是一次查询实际访问的分支,树越深,搜索空间越收敛。
可这里马上冒出一个麻烦,切得越细,越容易把正确答案分到没有搜索的那根树枝上。速度与召回率就在这里拉扯。
这也是为什么 Google 没有只加一层节点就收工。新架构还配了 Top-K branch、SOAR、质心调整和平衡树形。简单理解,就是别让一个向量只吊在一根树枝上,给它多留几条可能的回家路,减少「分区分快了,答案也分丢了」。
这一手有点子牛逼。树的层数只是表面,真功夫在怎么把枝叶分得均匀,又不把近邻丢在另一边。
51 毫秒很亮,但别忘了它姓 p95
p95 的意思,是 95% 的查询在这个时间以内完成,还有 5% 更慢。线上 RAG 与 Agent 往往不是只查一次。一个请求可能要做查询改写、多路召回、重排和权限过滤,其中任何一次撞上慢尾巴,用户等到的就是整条链路的总和。
坦率讲,我更想看的是 p99、同机型下的并发曲线、索引构建时间和持续写入下的延迟抖动。官方博客这次没给,所以 51 毫秒能证明架构路线有戏,还不足以替你签生产迁移单。
另一个容易被忽略的数字是 95% 召回率。召回率指真正应该找到的近邻里,系统实际找回来了多少。做商品相似推荐,95% 可能很好;做法务证据检索、安全告警或医疗记录定位,丢掉的 5% 可能恰好最贵。
搜索系统的账,从来不是「延迟越低越好」这么简单。它是一个四角形,延迟、召回、成本、更新鲜度,你往任何一边拽,另一边都可能响。
AlloyDB 的参数文档把这笔交易写得挺直白。num_leaves 决定索引分多少区,scann.num_leaves_to_search 决定查询时打开多少区,pre_reordering_num_neighbors 决定进入精排前留多大的候选集。搜得越广,通常越准,也越慢。
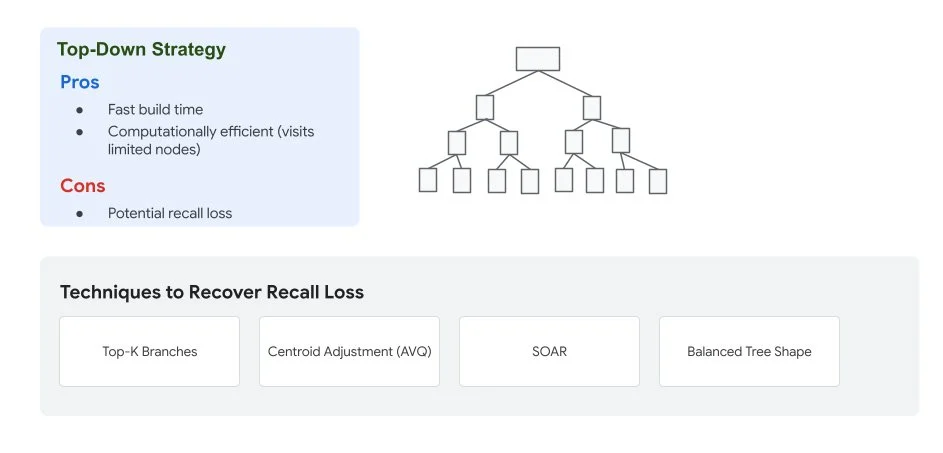
官方架构图,自顶向下建树能节省构建与遍历成本,Top-K branch、SOAR 和质心调整用来补召回损失。
量化器也一样。默认的 SQ8 量化以更小体积换速度,文档说典型召回损失低于 1% 到 2%。如果你要 99% 以上召回,可以选 FLAT,性能就得另算。还有处于 Preview 的 AH,相比 SQ8 最高可压缩到四分之一,但「最高」这两个字,做基础设施的都懂,不测自己的数据就没用。
不是每个 RAG 都需要四层树
厉害了的地方在这里,Google 连不同数量级该用几层树都写进了调优指南。
1000 万以下,两层树就够。1000 万到 1 亿之间,优先召回率可继续用两层,优先索引构建时间才考虑三层。1 亿到 10 亿,优先召回用三层,优先构建时间可考虑 Preview 的四层。真到 10 亿至 100 亿,四层树才成为推荐路线。
看见没有,数据没过亿,先别为了「架构先进」开 Preview 开关。多一层树不是免费升级,它要更复杂的聚类、采样与调参,还会改变索引构建和召回的取舍。
这个分层边界对很多团队反而是好消息。大部分 RAG 项目根本没有 10 亿向量,连 1000 万都未必有。它们真正的问题常常是 chunk 切错了、embedding 与语料不匹配、权限过滤放在了错的位置,或者只看 top-k 命中率,不看最终答案。
索引层数不会替你修这些 bug。
如果你的向量已经真到亿级,可以先用一份小合同约束试验,别一上来就搬全量数据。
dataset:
  vectors: 100000000
  dimensions: 768
  update_ratio_per_day: 0.03
quality:
  recall_at_20: ">= 0.97"
latency:
  p95_ms: "<= 80"
  p99_ms: "<= 150"
load:
  qps: 300
  concurrent_writes: true
operations:
  max_build_hours: 6
  rollback_required: true
上面数字只是合同格式示例,不是 AlloyDB 的官方保证。你要把自己的数据分布、向量维度、更新比例、权限过滤和真实查询放进去,然后用同一套重放流量比两层、三层、四层,以及你现在的向量库。
怎么说呢,真正的 benchmark 不是一张延迟截图,而是一份可以拒绝上线的验收合同。
PostgreSQL 这张牌,会越来越重
专用向量库最大的价值,从来不只是跑得快。它们在大规模分片、多租户、快速扩缩、多模检索和监控工具上已经积累了很多年。四层 ScaNN 出现之后,这些能力不会突然归零。
但 AlloyDB 手里有另一张很硬的牌,业务数据与向量在同一个 PostgreSQL 兼容系统里。
做企业 RAG 时,最麻烦的往往不是相似度计算,而是「这个人现在还能不能看这份文档」、「这个商品刚下架,向量索引多久能同步」、「搜索结果能不能和订单状态做事务一致的过滤」。一旦业务条件需要跨两套数据系统,延迟、一致性、回滚和运维告警都会跟着变复杂。
如果 AlloyDB 的向量搜索已经过了你的性能线,那么少维护一套数据管道,可能比索引本身快 20 毫秒更值钱。这笔账不会出现在向量 benchmark 里,却会出现在每一次值班里。
我自己的感受是,四层 ScaNN 暂时还不是一个「快搬家」的信号,而是一个「重新算账」的信号。
如果你已经用 AlloyDB 存业务数据,向量规模在亿级往上长,且正在被两套数据管道折腾,这个 Preview 值得拿隔离流量试。如果你只有几百万向量,现有方案又稳定,那就把精力花在语料、评测和权限模型上。
当然,真要开四层树,还得先显式打开 Preview 功能。创建文档给的入口是设置 scann.enable_preview_features 数据库标志,或在会话中设置允许的最大层数。
SET scann.max_allowed_num_levels = 3;

CREATE INDEX my_scann_index ON my_table
USING scann (embedding cosine)
WITH (
  num_leaves = 1000000,
  max_num_levels = 3
);
这里 max_num_levels = 3 代表三层质心树,加上底部数据层,对外叫四层索引。num_leaves 不要照抄示例,要按真实行数与性能目标调。说实话,文档里这种「开关很短,调参很长」的功能,一般都不适合周五下午上线。
棒棒的,按钮只有一个。
然后你会用一整周学会为什么当时不该按。
回到最开始那三个数字。100 亿说的是规模,51 毫秒说的是大多数查询,95% 说的是系统愿意为速度留下多少遗憾。
三个数字放在一起,才是一个能讨论的工程方案。
只截其中一个,就只剩广告了。