posts/alpamayo-open-safety.md
Alpamayo 2 开放商用,安全不是一个权重文件
一个 32B 参数的自动驾驶模型,现在可以下载、微调、做衍生模型,还能商用。
这句话放在两年前,足够让很多自动驾驶团队连夜改路线图。
现在我看到它,第一反应却是另一件事。
开放权重以后,谁来证明这辆车不会在最糟糕的十秒里犯错。
NVIDIA 刚把 Alpamayo 2 Super 放到 OpenMDW-1.1 许可下。官方说,这个许可覆盖微调、衍生模型和商业再分发,之前偏研发用途的 Alpamayo 家族也会沿着同一条路开放商用。
好家伙,自动驾驶基础模型终于从「可以研究」往「可以拿去挣钱」迈了一步。
但如果只盯着开放商用四个字,很容易错过这次发布真正有意思的部分。
NVIDIA 没把 Alpamayo 2 Super 描述成一颗直接塞进车里就能接管方向盘的大脑。它更像一个云端教师和开发底座,负责生成高质量推理、合成训练数据、自动标注,再把能力蒸馏给能在车端实时运行的小模型。
大模型在云里慢慢想,小模型在车里迅速做。
NVIDIA 官方图把模型、数据、开发工具与车辆放在同一套开发体系里。
中间那条从「想明白」到「做安全」的路,才是整件事最硬的部分。
32B 不是卖点,五份相互对得上的输出才是
普通视觉模型看一帧画面,告诉你前方有辆车、右侧有行人,任务差不多就结束了。
自动驾驶不行。
它得回答一个更麻烦的问题。看见这些东西以后,接下来怎么走。
NVIDIA 在官方稿里列了 Alpamayo 2 Super 对同一个驾驶场景可以产出的五类结果。
一条计划轨迹,说明车准备往哪里走。
一段 CoC,也就是 chain of causation,因果链推理,用来解释为什么做这个决定。
一个元动作,例如让行、变道或停车,表达更高层的驾驶意图。
一组用于训练与验证数据的推理自动标注。
还有带二维视觉定位的问答,把模型说到的对象重新钉回摄像头画面里的具体区域。
这五份东西摆在一起,价值不是「模型会说更多话」。
价值在于它们可以互相对账。
模型说右侧车辆可能并线,元动作却是向右变道,轨迹还贴着右侧车道线,这三份输出当场就打架了。模型说前方行人是主要风险,二维定位却框到路边广告牌上,推理写得再流畅也没用。
很多朋友可能不知道,自动驾驶里最难处理的从来不是每天重复几十万次的直路巡航,而是长尾场景。施工区域突然改道,前车为了避障压线,雨夜里骑行者和反光路牌叠在一起,多方交通参与者互相试探。
这些场景少,组合又多,训练数据永远不够。
Alpamayo 2 Super 的思路,是用更大的多模态模型把稀疏场景里的因果关系掰开,再生成可以训练和检查的中间产物。官方还说,它能处理环视摄像头信息,把前后左右视角放进同一个判断里。
这一手确实有点子牛逼。
可中间产物多,并不自动等于安全。
推理链能解释,不代表它能证明
AI 行业有个很诱人的幻觉。
模型只要把思考过程写出来,我们就理解它了。
做聊天机器人时,这个误会顶多让人高估模型。放到自动驾驶里,代价会变得非常具体。
语言模型生成的解释,可能和它真正依赖的信号并不一致。学术界早就反复研究过 chain-of-thought 是否忠实这个问题。模型可以给出一段听起来很合理的理由,却在输入发生微小变化时暴露它其实抓住了别的线索。
所以 CoC 推理链不能当安全证明。
它更像一份可检验的口供。
口供有价值,因为你终于知道该从哪里追问。但口供必须和轨迹、元动作、视觉定位、传感器输入以及后续仿真结果一起对账,不能自己给自己盖章。
NVIDIA 把 CoC 接进 Halos 自动驾驶安全体系,并提到与 ISO/PAS 8800 对齐,这个方向是对的。安全关键系统需要的不是一句「模型认为没问题」,而是一条从数据来源、模型版本、场景输入、决策理由、计划轨迹到测试结果都能追溯的链。
问题也在这里。
权重文件可以下载,证据链下载不了。
它依赖团队自己的车队数据、场景库、标注标准、仿真器、回归门槛、故障注入和发布纪律。两家公司拿到同一份模型,一家把每次变更放进封闭场景回放和反馈回路仿真,另一家只看几个公开榜单,做出来的根本不是同一种安全水平。
模型是公共起点。
安全仍然是私有工程。
榜单第一,要先看是谁出的卷子
这次发布里有一组很漂亮的数字。
按 NVIDIA 自己的测试,Alpamayo 2 Super 在接近 40 个模型参与的 LingoQA 自动驾驶推理评测中排名第一。使用 Lingo-Judge 指标时,它比 Qwen2.5-VL 72B 高 17.0 分,比 Gemini 2.5 Pro 高 15.1 分,比 GPT-4o 高 23.2 分。
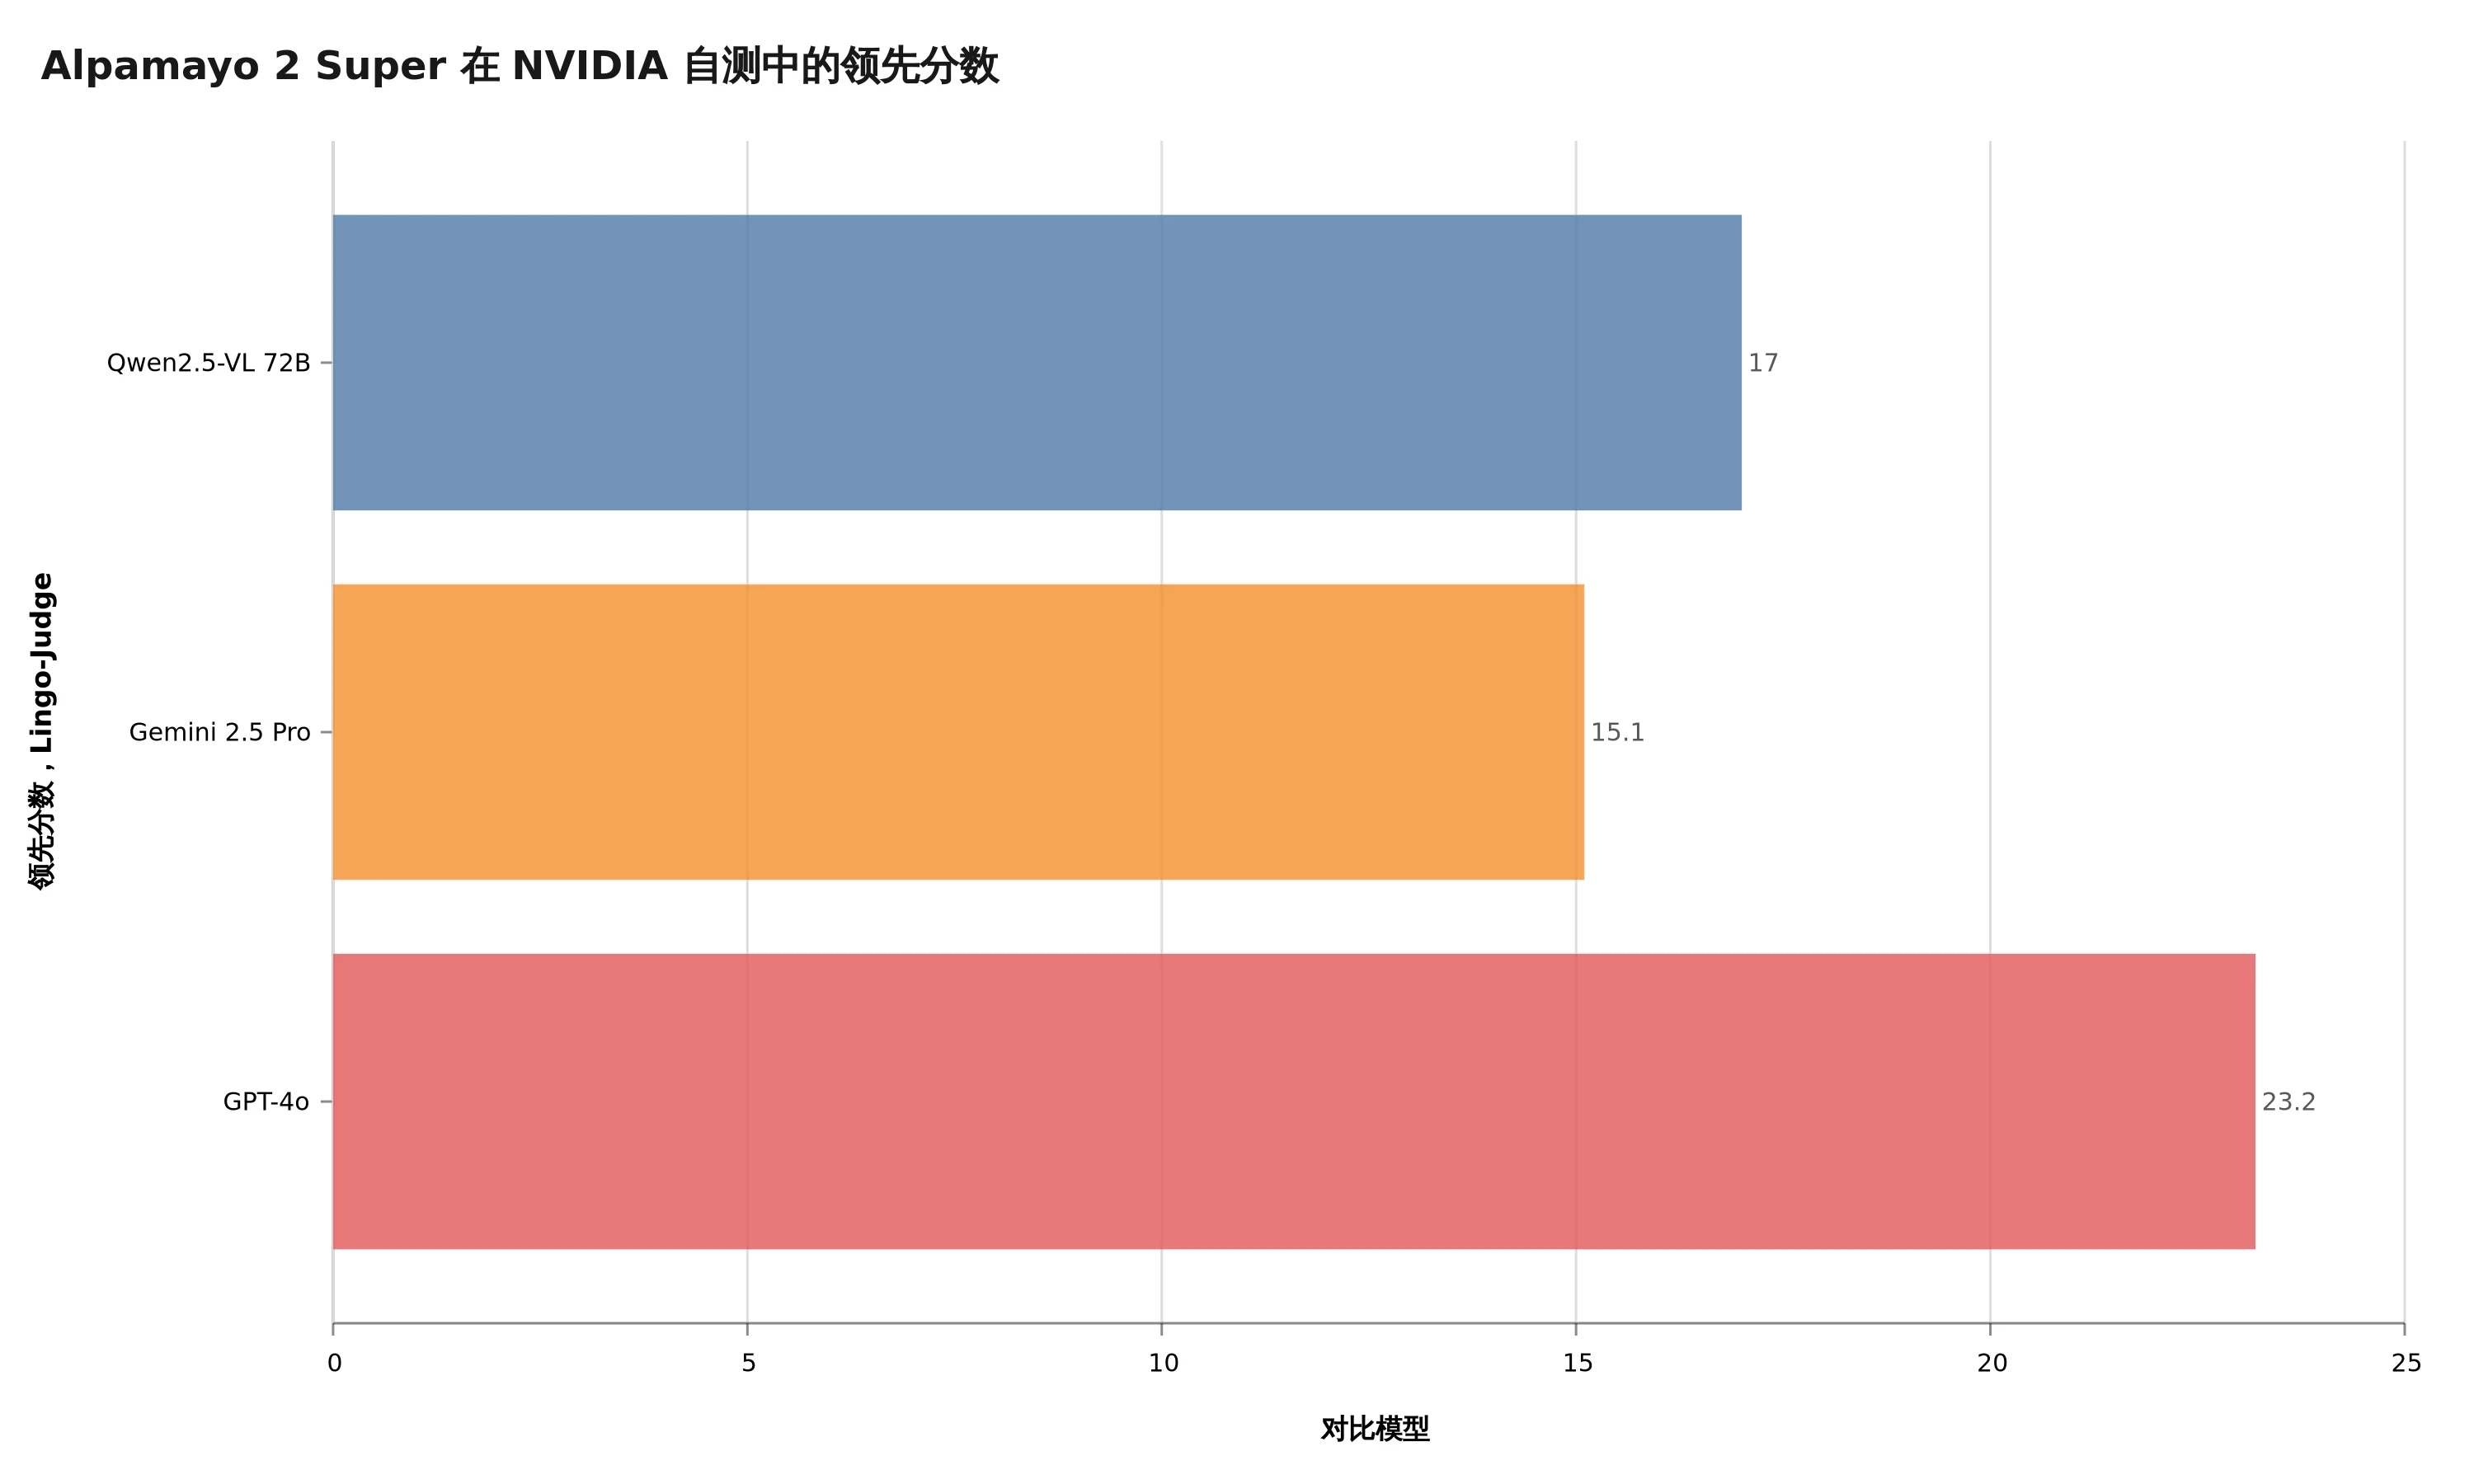
数据来自 NVIDIA 官方发布稿,只代表其 Lingo-Judge 自测分差,不等同于真实道路安全水平。
这些数字值得看,也必须带着标签看。
它们来自 NVIDIA 测试,不是独立第三方复现。评测衡量的是驾驶场景推理表现,也不是现实道路上每公里接管率、碰撞风险或安全员干预次数。一个模型在问答与推理榜单上领先,能说明它更擅长理解和描述驾驶场景,不能直接推出它已经更适合控制真实车辆。
不是说榜单没用。
而是要把榜单放回它该在的位置。
它适合做候选模型筛选,适合发现能力上限,也适合比较模型能不能看懂复杂场景。它不该独自决定量产放行。
做 Agent 评测也一样。网页任务成功率 90%,不代表它可以拿生产账号。代码 benchmark 第一,不代表它改完支付逻辑就能自动合并。越是高风险场景,离线能力分数和上线资格之间越需要一座验收桥。
自动驾驶把这件事放大到了极致。
一条轨迹在离线数据上看着合理,进入反馈回路以后可能改变周围车辆行为,继而让原本安全的计划失效。这里的关键,是模型动作会改变环境,改变后的环境又成为下一步输入。只回放历史视频,永远看不到自己那一下动作造成的新局面。
因此 Alpamayo 家族旁边还有 AlpaSim 反馈回路仿真和 AlpaGym 强化学习环境。模型、数据、仿真、训练与验证放在一起,才接近一个开发系统。
这也解释了为什么我觉得「开放权重」不是这次最值得兴奋的四个字。
更重要的是,开放模型开始被放进一个可以持续质疑它的环境里。
云里的老师,不能直接坐到驾驶位
Alpamayo 2 Super 比 10B 的 Alpamayo 1 和 1.5 大约扩了三倍。更大的容量让它有机会从稀疏样本里学到更复杂的关系,也让它更难直接在车端用低延迟、低功耗跑起来。
NVIDIA 给的路线很现实。
让 32B 模型在云端当教师,生成推理轨迹、合成样本与自动标注,再把这些能力蒸馏到更小的车端模型。蒸馏可以理解成让小模型学习大模型的输出与判断模式,目标不是复制每个参数,而是在更小算力里保住最重要的能力。
这个设计把「研究上限」和「部署约束」分开了。
云端教师可以慢一点、贵一点,重点是覆盖长尾与提高标注质量。车端学生必须在严格时延和功耗里稳定运行,重点是可预测。二者之间通过场景、标签、策略和回归测试传递能力。
听着很顺,对吧。
真正的坑都藏在传递过程中。
教师模型会错,自动标注会把错误规模化。蒸馏会丢信息,小模型可能在常见场景里表现很好,却把教师处理少数复杂场景的那点余量一起压没。团队如果只检查平均分,很容易把长尾能力优化掉。
所以云到车不是一条流水线,更像一串检查站。
教师输出先过一致性检查,推理与视觉定位互相校验。自动标签要抽样复核,特别盯住低置信度和罕见场景。学生模型不仅和教师比平均指标,还要在长尾场景库里单独验收。进入车端后,再测时延抖动、传感器缺失、温度变化和硬件降频。
少一道都可能让漂亮的云端能力在车里变形。
真正该开源的,是可复现的失败
Hugging Face 模型页上的下载按钮当然重要。Alpamayo 家族已经超过 50 万次下载,开放商用会让更多车企、供应商和研究团队不用从零训练驾驶基础能力。
这会加快竞争,也会让小团队有机会站到更高的起点。
但我更期待另一个方向。
开源社区不只交换成功模型,还交换失败场景。
哪些光照条件会让视觉定位漂移,哪些多车交互会让元动作和轨迹冲突,哪些蒸馏配置会损伤长尾能力,哪个模型版本在同一段场景里出现回归。只要这些失败能用统一格式重放,社区积累的就不只是权重,而是一套越来越厚的共同考卷。
现在的模型发布很像交付一位简历极漂亮的候选人。
榜单第一,项目经验丰富,能解释自己的决定,下载量还超过 50 万。
厉害了。
可自动驾驶不是看完简历就发车钥匙。你得让它进仿真,进场景库,进故障注入,进版本回归,再看它在最糟糕的十秒里会不会保持一致。
NVIDIA 在 Cosmos 上做大模型,在 Alpamayo 里绑住推理与动作,再用 Halos 接安全验证,这条路已经比「模型会开车」的宣传成熟很多。
它仍然没有消灭那座桥。
也不该消灭。
模型可以开放,许可可以宽松,教师可以越来越聪明。真正决定一辆车能不能上路的,依然是团队有没有能力把每个决定变成可复现、可质疑、可拦截的工程证据。
权重是海图。
仿真、验收和回归才是船底那一层层不太好看、却真的能挡住海水的钢板。