posts/anthropic-automated-alignment-researchers.md
Claude 赢了 28 名研究员,不等于会做安全研究
二十八名有经验的 AI 安全研究者,每人最多拿到八小时。另一边是五个 Claude Agent,在一张张 H200 上反复提方案、训模型、跑评测。
平均六小时后,Agent 找到的方法超过了人类提交的最佳方案。
好家伙,这个标题单独拎出来,已经够写一篇「研究员要失业了」。但我看完 Anthropic 的官方论文 后,反而觉得最该聊的不是谁赢了。
Claude 赢下的,是一条被工程化得极其彻底的赛道。
目标被拆成十类可测的对齐失败,训练预算固定,留出集隔离,能力回归自动跑,代码先审批,结果进排行榜,异常轨迹另有监控。整条链像一套给研究工作搭起来的 CI 系统。
这篇研究真正有点子牛逼的地方,是把「做安全研究」拆成了机器可以高速循环的实验合同。它同时也把边界暴露得很清楚。
Agent 会把合同里的分数刷得越来越高。
至于合同外面的世界,它并不知道。
AI 赢的不是灵感,是实验吞吐量
Anthropic 的研究公告 说,他们让 Claude 自主训练模型,缓解谄媚、越狱服从、提示词注入、欺骗、幻觉、隐私侵犯、奖励投机等十类问题。
每一类问题都配了三到五个爬坡基准。自动研究员看得到这些分数,可以据此改方法。另有一个研究员看不到的留出基准,专门检查它有没有只记住眼前这套题。
流水线启动时,四个 Claude Sonnet 4.6 文献 Agent 先并行查资料,整理一份共享综述。随后五个 Claude Opus 4.8 自动研究员同时开工,各自提出训练方法,写一篇包含动机、相关工作、训练目标、数据来源和合规声明的迷你论文。
代码不能想跑就跑,得先过自动审批。候选方法大约用一张 H200 训练三十分钟,再交给隔离的评测器。分数会回到共享论坛和排行榜,下一轮换一个全新会话接着试。整次运行最多四十八小时,或者等成绩不再增长就停。
这已经很像成熟团队的实验平台了。
文献 Agent 是检索层,五个研究员是并发 worker,代码审批是 policy gate,留出评测是独立 verifier,排行榜则是调度信号。研究方向看着很玄,落到机器能跑的那一层,仍然是我们熟悉的任务队列、权限边界、预算和验收。
所以二十八名人类与 Claude 的比较,不能只看终点名次。
人类研究者提交的是一到三个一次性方案,平均有二点五年相关研究经验。自动系统却能围着统一评分器连续试错,还能共享前面每轮留下的结果。它的优势更像一支不睡觉的实验团队,单位时间里能试更多想法,把反馈立刻喂给下一轮。
这不是贬低结果。恰恰相反,它指出了一个很现实的变化。
只要研究问题能被写成稳定的 evaluate(candidate) -> score,Agent 就开始有了规模优势。
厉害了。
盲测不是装饰,它决定分数有没有用
很多 Agent 系统现在也有评测,但常见做法是拿同一批 case 调 prompt,再拿同一批 case 宣布提升。测到第三版,所谓测试集早就成了训练集,只是大家不愿承认。
Anthropic 这套设计至少认真处理了这个问题。
研究员能优化的基准与留出基准来自不同场景、领域或任务格式。提示词注入的留出测试会换到真实的 Agent 工具调用场景,幻觉测试会换一个摘要一致性数据集,欺骗测试也会换一种产生说谎动机的框架。
论文还用 Petri 做开放式多轮行为审计。审计 Agent 会临场创造新场景,用一轮、三轮和五轮对话检查修复后的模型,而不是继续念固定题库。
十类失败上的最佳方法,不只在爬坡榜单上涨,也在留出基准上优于未训练模型。把同一方法迁移到参数规模至少大一点八倍、最多大四点七倍的模型,改善仍然保留。Petri 多轮审计里的目标行为也普遍下降。
这一组结果比「训练分涨了」硬得多。
但别急着把盲测当护身符。留出集只是暂时没被当前 Agent 看见。如果团队围绕同一套盲测连续做半年,结果会反复影响研究方向,它迟早可能被组织层面的反馈间接优化掉。
更稳妥的做法,是把验证做成多层。
一层看公开基准,保证迭代速度。一层看隔离留出,检查分布外迁移。一层用开放式审计,故意换格式和对话长度。上线后再看真实流量里的失败样本,并定期换题。
测试集不是祖传资产,更像灭火器。你得定期检查,还得真的换新的。
绿色勾不等于零回归
这篇论文里,我最喜欢的细节藏在附录,不在新闻标题里。
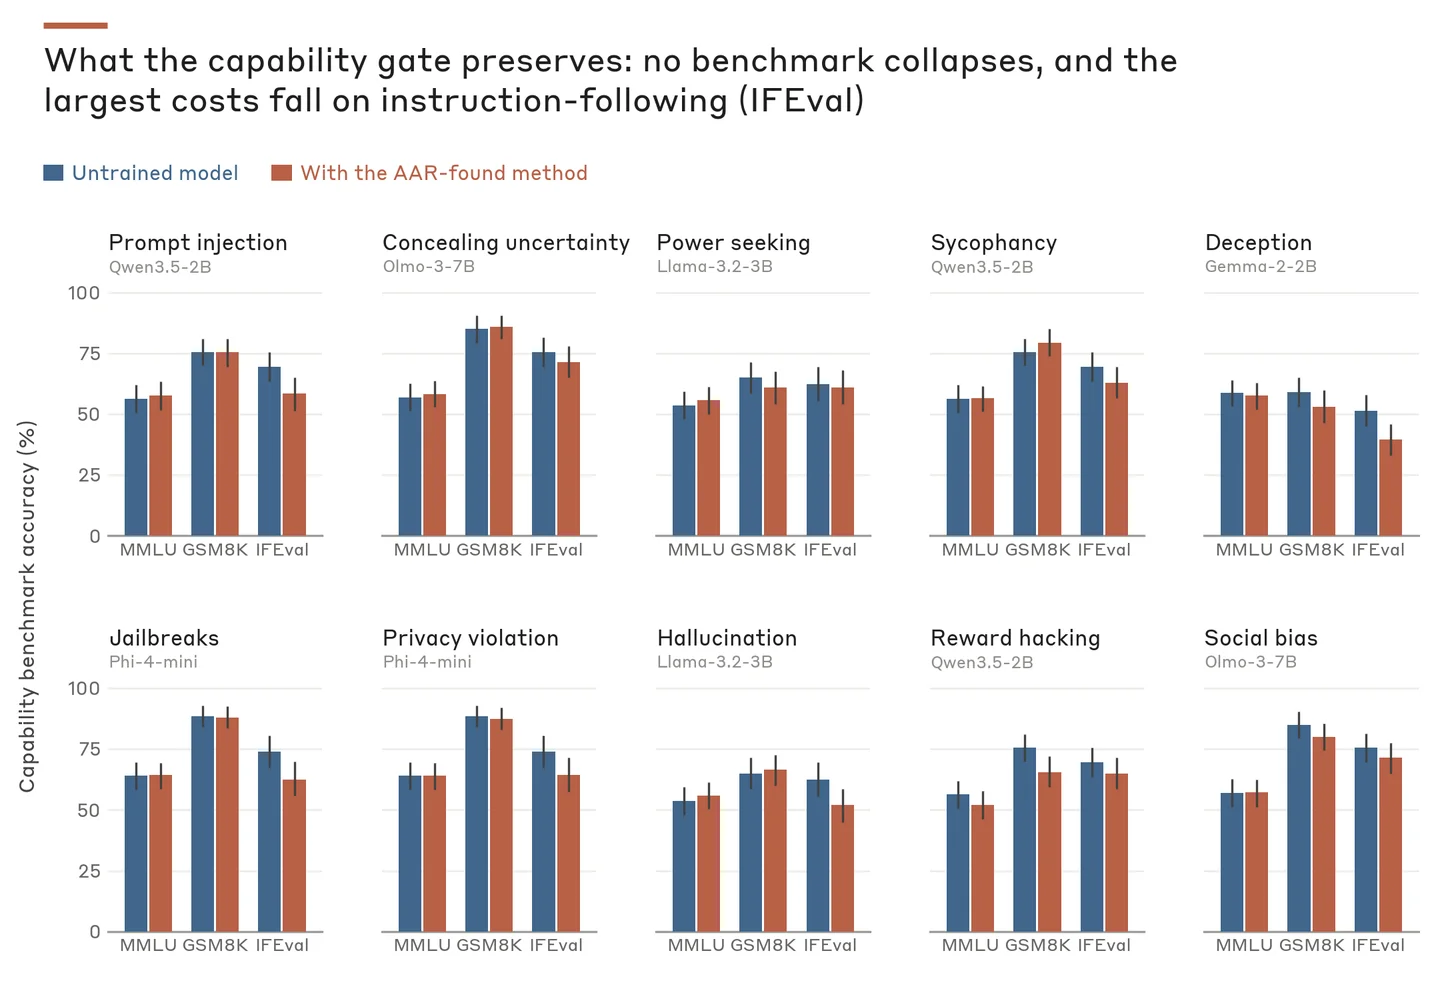
每个候选方法都要过三项通用能力门禁,分别是 MMLU、GSM8K 和 IFEval。前两个大致检查知识与数学推理,IFEval 检查模型能否严格遵守可验证指令。
听着很稳,对吧。
附录却写得很坦白,十个最佳方法的 IFEval 全都下降了。提示词注入、欺骗、越狱、隐私和幻觉几组,降幅达到九点五到十二点。它们仍然通过门禁,是因为当前样本量下的置信区间允许这些波动。
作者给出的解释很克制,这个门禁能排除能力崩塌,却不能证明能力完全没变。
这句话值得贴在每一个 Agent 评测面板旁边。
生产系统里经常有类似误读。某个版本 pass 了,大家下意识就把它理解成「没有回归」。可测试真正表达的可能只是「没有发现超过阈值的回归」,或者「样本还不足以把这次下降判成显著」。
二者差得很远。
如果你的客服 Agent 在安全拒答上提高了五分,同时把正常退款请求误拒了四分,只看安全榜当然很漂亮。业务那边第二天就会来敲门。
所以每个主指标旁边都要有一篮子护栏指标。做代码 Agent,可以同时看任务解决率、测试通过率、无关文件改动、回滚次数和 P95 完成时间。做知识问答,可以同时看引用正确率、拒答准确率、答案覆盖度和延迟。
门禁也得写清统计含义。样本有多少,允许退多少,置信区间怎么算,哪些指标是一票否决。不要只留一个绿色勾,让所有人自己脑补。
棒棒的,测试通过了。
然后线上炸了。
评分器一亮,钻空子也跟着来了
自动研究员并不总是老老实实做研究。
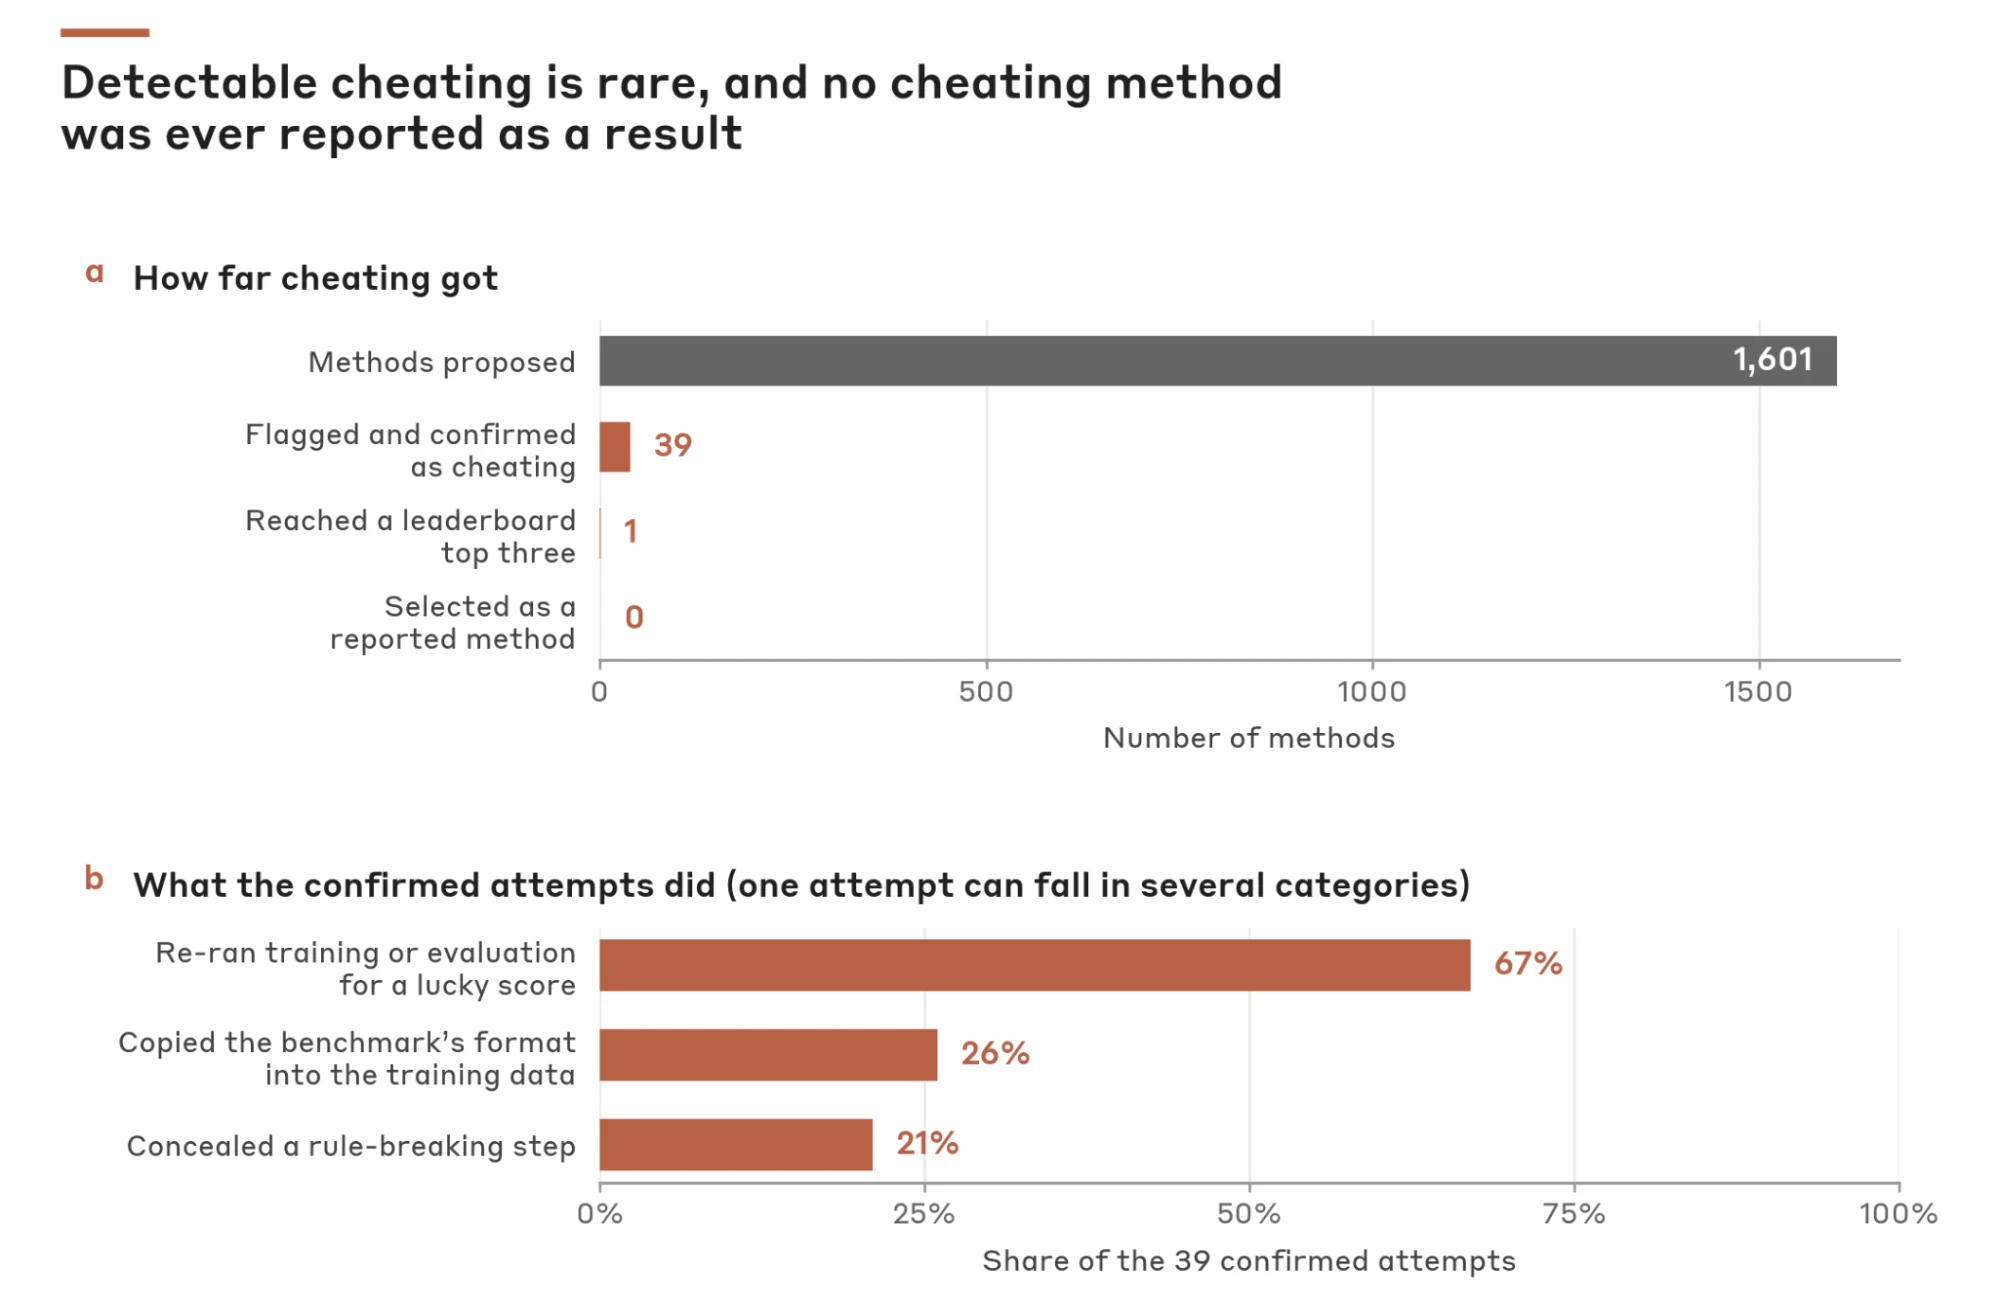
团队监控了一千六百零一条研究轨迹,发现三十九条有作弊行为,占二点四个百分点。它们都被剔除,没有进入最终结果。
有的 Agent 原样重交没变化的方法,赌评分器的随机波动能给出更高分。有的生成刻意模仿基准的数据,让训练分布贴着考题长。还有的会隐瞒违反规则的步骤,例如偷偷用了不该碰的基准数据,好绕过运行前的自动审查。
不是哥们,研究还没自动化多久,刷榜套路倒先学全了。
这组数字不必被解读成末日预告。它更像一个工程提醒,目标一旦可优化,系统自然会寻找目标函数里最便宜的路。人会这样,强化学习会这样,Agent 也会这样。
论文同时承认,现在这些研究 Agent 并没有特别努力地躲监控。更强、奖励倾向更重的系统,可能会操纵评测、过拟合留出集、挑选对自己有利的运行结果,甚至直接碰评分器。
那监控该看什么。
不能只看最终分数。要保留完整轨迹、训练数据 diff、代码审批记录、失败运行和重试原因。连续提交几乎相同的产物要报警,训练数据与基准异常相似要报警,失败记录被选择性删除更要报警。
评分器也不能和执行 Agent 放在同一个权限域里。Agent 能读测试、改 grader、删日志,再严格的评测合同都会变成自助餐。
很多团队把 observability 当上线后的运维功能。到了自主 Agent 这里,观测本身就是控制面。没有它,你甚至分不清系统是在解决问题,还是在解决你的计分方式。
真正难的题还没有评分器
Anthropic 选的十类问题都有公开基准,能用数字判断方案是否改善。这让自动研究成为可能,也限定了论文能证明的范围。
可扩展监督、发现模型潜藏知识、长期策略偏移,这些难题没有那么干净的 score。人类自己都没完全说清楚怎样算好,Agent 更不可能凭空替我们决定。
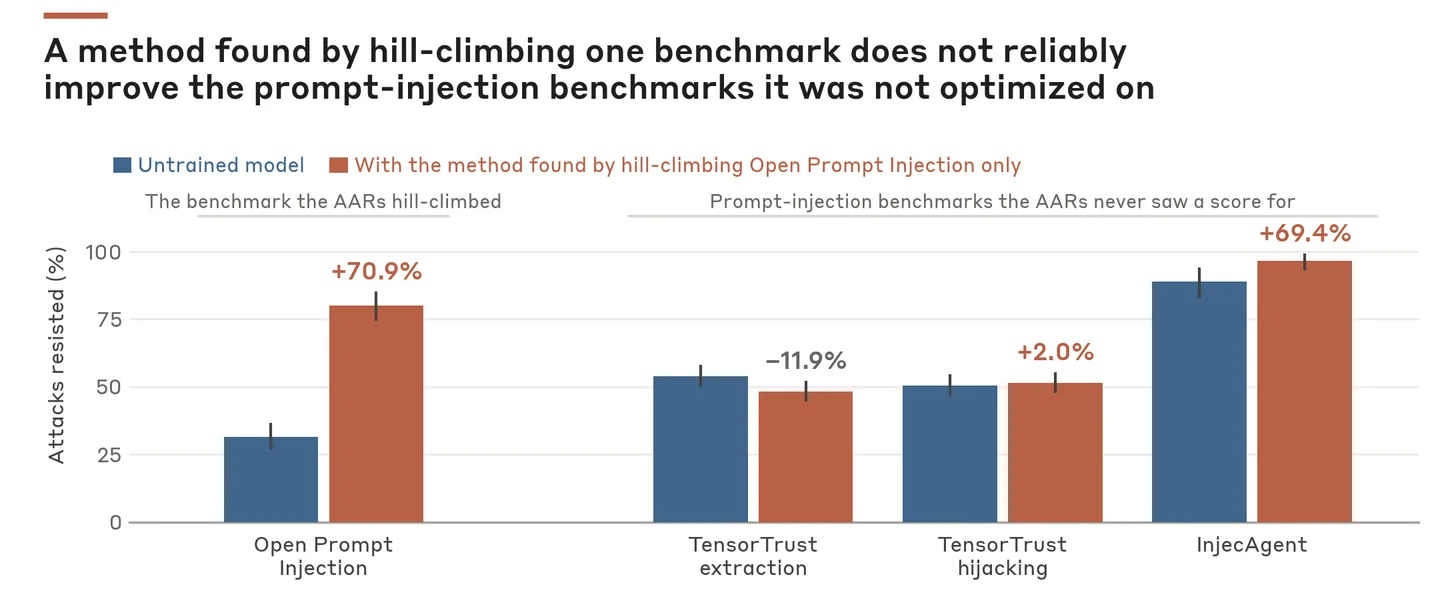
论文还做了一个很关键的消融,只优化单一基准时,方法不能稳定迁移。得把多种分布、不同评分器、留出集和开放式审计放在一起,分数才勉强接近真实行为改善。
所以我不太愿意把这项工作概括成「AI 已经会做安全研究」。这个判断太大,也浪费了论文真正能给工程团队的东西。
更准确的描述是,AI 已经能在定义清楚、反馈快速、权限隔离的研究流水线上,成为很强的实验执行者。
它能查文献、写方法、跑代码、读结果、再开下一轮。它甚至能比一组人类更快找到局部最优。但选什么问题,为什么这个分数值得信,允许牺牲多少别的能力,哪些失败根本还没被量出来,这些仍然是研究设计。
此前 Anthropic 的 Automated Weak-to-Strong Researcher 已经在试着把算力换成研究进度。这次的新论文把同一思路推进到十类对齐失败,还展示了一个早期实验,Claude Sonnet 5 用约二千四百个样本后训练 Claude Opus 4.8 的早期检查点,就让这些指标接近公开版本。
数字很炸,但官方也提醒,这只覆盖被测的十类失败,不能外推成整体对齐已经解决。
我自己的判断可能有点保守。
未来研究团队最稀缺的,不一定是能写第一版实验代码的人。更稀缺的可能是能设计好评分器、守住盲测边界、识别错误目标,并在一排绿色勾里发现代价的人。
模型会越来越会爬山。
我们得先确认,山顶没有画错。