posts/anthropic-independent-data-research.md
25 万段 Claude 对话开放了,研究者一条都看不到
25 万段真实 Claude 对话,开放给外部研究者。
研究者看不到其中任何一条。
好家伙,这两句话放在一起,像是某种数据开放行为艺术。但它们确实同时写在 Anthropic 8 月 26 日发布的试点复盘里。
斯坦福 SALT Lab、牛津 Human Information Processing Lab 和 METR,分析了约 25 万段 2026 年 4 月至 5 月的 Claude.ai 或 Claude Code 对话。他们可以自己提问题、自己分析、自己发结果,哪怕结论让 Anthropic 不舒服也照发。
可他们碰不到原始对话。
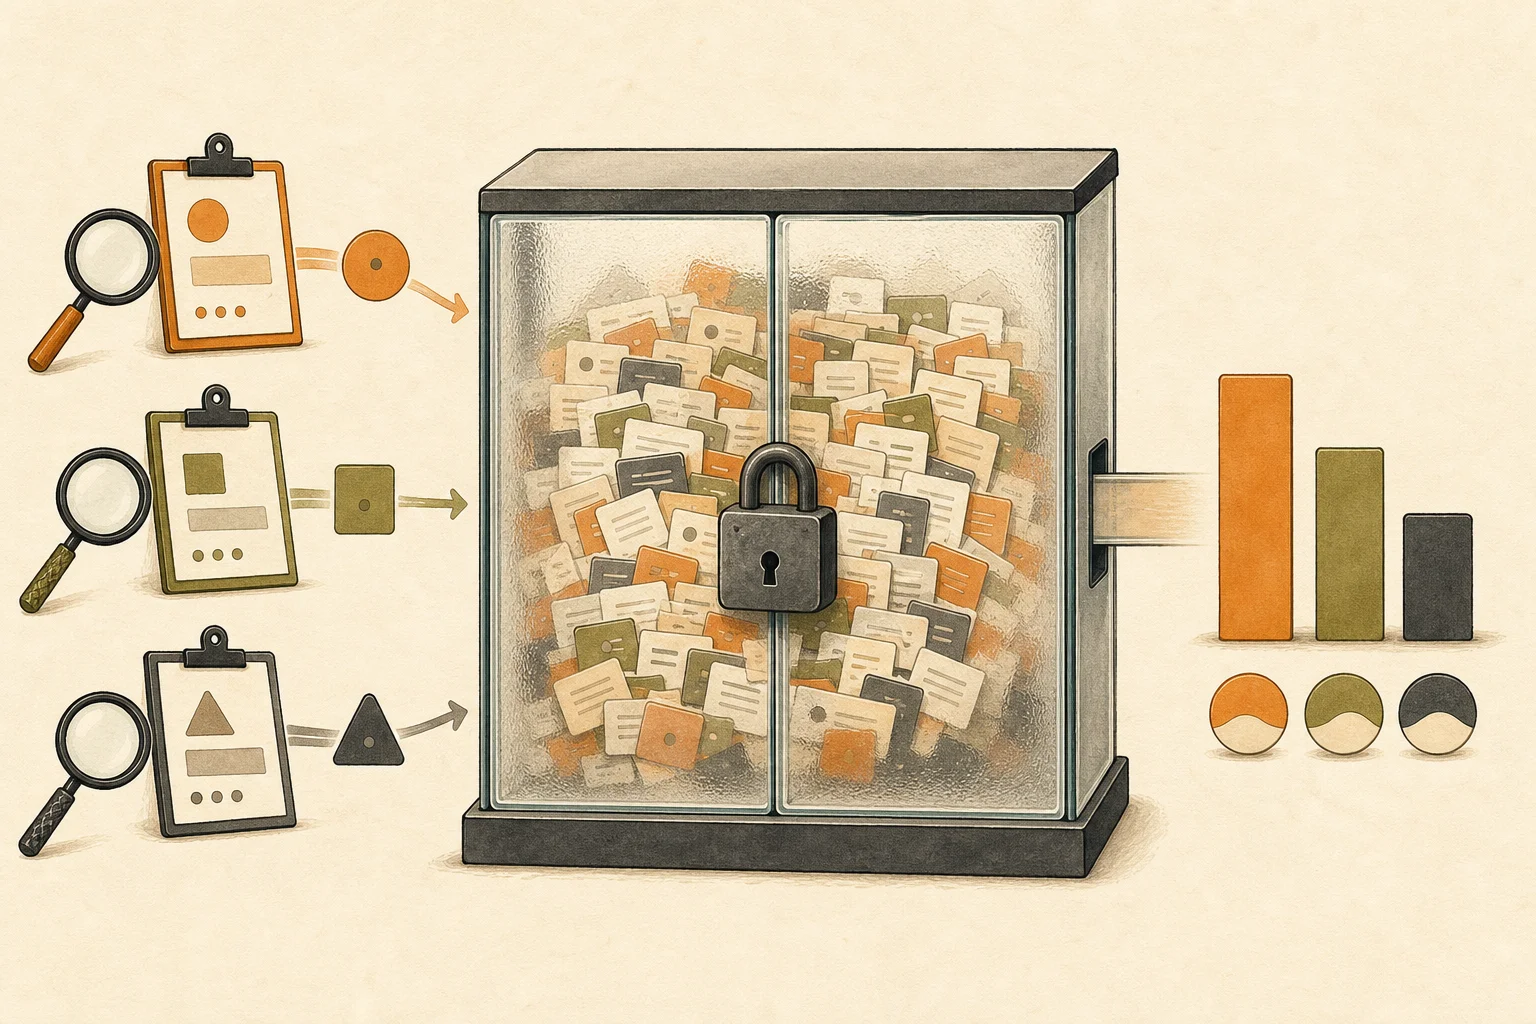
中间隔着一套叫 Anthropic Insights 的系统。研究者把问题交进去,Claude 对每段对话做判断,系统只吐出聚合后的类别和占比。用户说过什么,代码里有什么,公司资料长什么样,外部团队统统看不到。
我看到这里,第一反应不是「透明度又进步了」。
我更在意另一个词,合同。
这不是把数据库拷给别人,而是给第三方搭了一条受控的观测接口。谁能问,能问什么,问题怎样验证,哪些结果能公开,平台能删掉什么,误差由谁解释,全都得提前写清楚。
对做 Agent 的团队来说,这事有点子牛逼。因为它碰到的不是一家大模型公司的公关难题,而是每个生产系统迟早都会遇到的麻烦。
你想让别人检查你的系统,又不能把用户日志扔出去。你想保留隐私,又不能只让自己证明自己没问题。你想让研究者自由发问,又得承认测量工具仍然握在平台手里。
这几件事没有一个能靠「脱敏后发个 CSV」解决。
研究者拥有问题,却不拥有显微镜
Anthropic 为什么要绕这么大一圈?
因为现实里的 AI 使用数据,几乎都锁在少数实验室内部。外部研究者通常只有两条路。
一条路是研究实验室发布的分析。数据来自真实用户,问题却是实验室自己选的。公司想研究生产力,外界就只能看到生产力。公司不想碰的盲区,数据再大也照不到。
另一条路是研究公开对话数据集。问题可以随便设计,数据分布却常常偏向随意聊天、角色扮演和创意写作。拿它去推断企业里的人怎样用 Claude Code 改仓库,多少有点拿周末夜市的人流研究早高峰地铁。
Anthropic 这次试着拆开两个权力。
外部团队拿走提问权和发表权,平台保留原始数据与执行权。
按照官方披露,Anthropic 的合同审查权被限制在四块,用户隐私、可能帮助他人违反使用政策的信息、公司机密、研究准确性。除此之外,公司不能决定论文写什么。研究者发现难看的东西,也可以公开。
这个安排很重要。独立研究最稀缺的不是多一个作者名字,而是研究问题不由被研究对象提前指定。
但显微镜仍然属于 Anthropic。
研究者会写一个问题,例如「这个人正在寻求哪类指导」。Claude 为研究范围里的每段对话作判断,再把结果聚合成类别与比例。外部团队看到的是「法律指导占多少」「用户主导协作占多少」,看不到支撑分类的原始对话。
厉害了,隐私保护住了,新的测量风险也跟着来了。
同一句研究问题,改几个词,分类可能就变。一个写得不够好的问题,会把真实对话塞进误导性的类别。偏偏研究者又不能回到原文检查,错误一旦进了聚合层,就很像一张已经烤好的披萨,你知道味道不对,却看不见后厨到底放错了什么。
Anthropic 内部处理这类问题,会花数周反复调整提问。外部团队做不到同样的迭代频率,因为每次重跑都可能重新经过隐私审查,成本很快失控。
他们想了个挺工程师的办法,先在公开的 WildChat 数据集上测试问题。那里能看到原始对话,可以核对分类是否靠谱。
然后分布偏移来了。
WildChat 更偏随意和创意使用,真实 Claude 流量里有更多专业工作。有些问题在公开数据上跑得棒棒的,换到真实流量就产生误导类别。测试集通过,不代表生产环境没歪。熟悉评测的人看到这里,大概已经开始叹气了。
25 万段对话,先打破了几个舒服的想象
这次试点的结果还不算终局。牛津和 METR 的完整研究仍在进行,文中很多结论只能叫初步发现。即便如此,它已经打破了几个很舒服的想象。
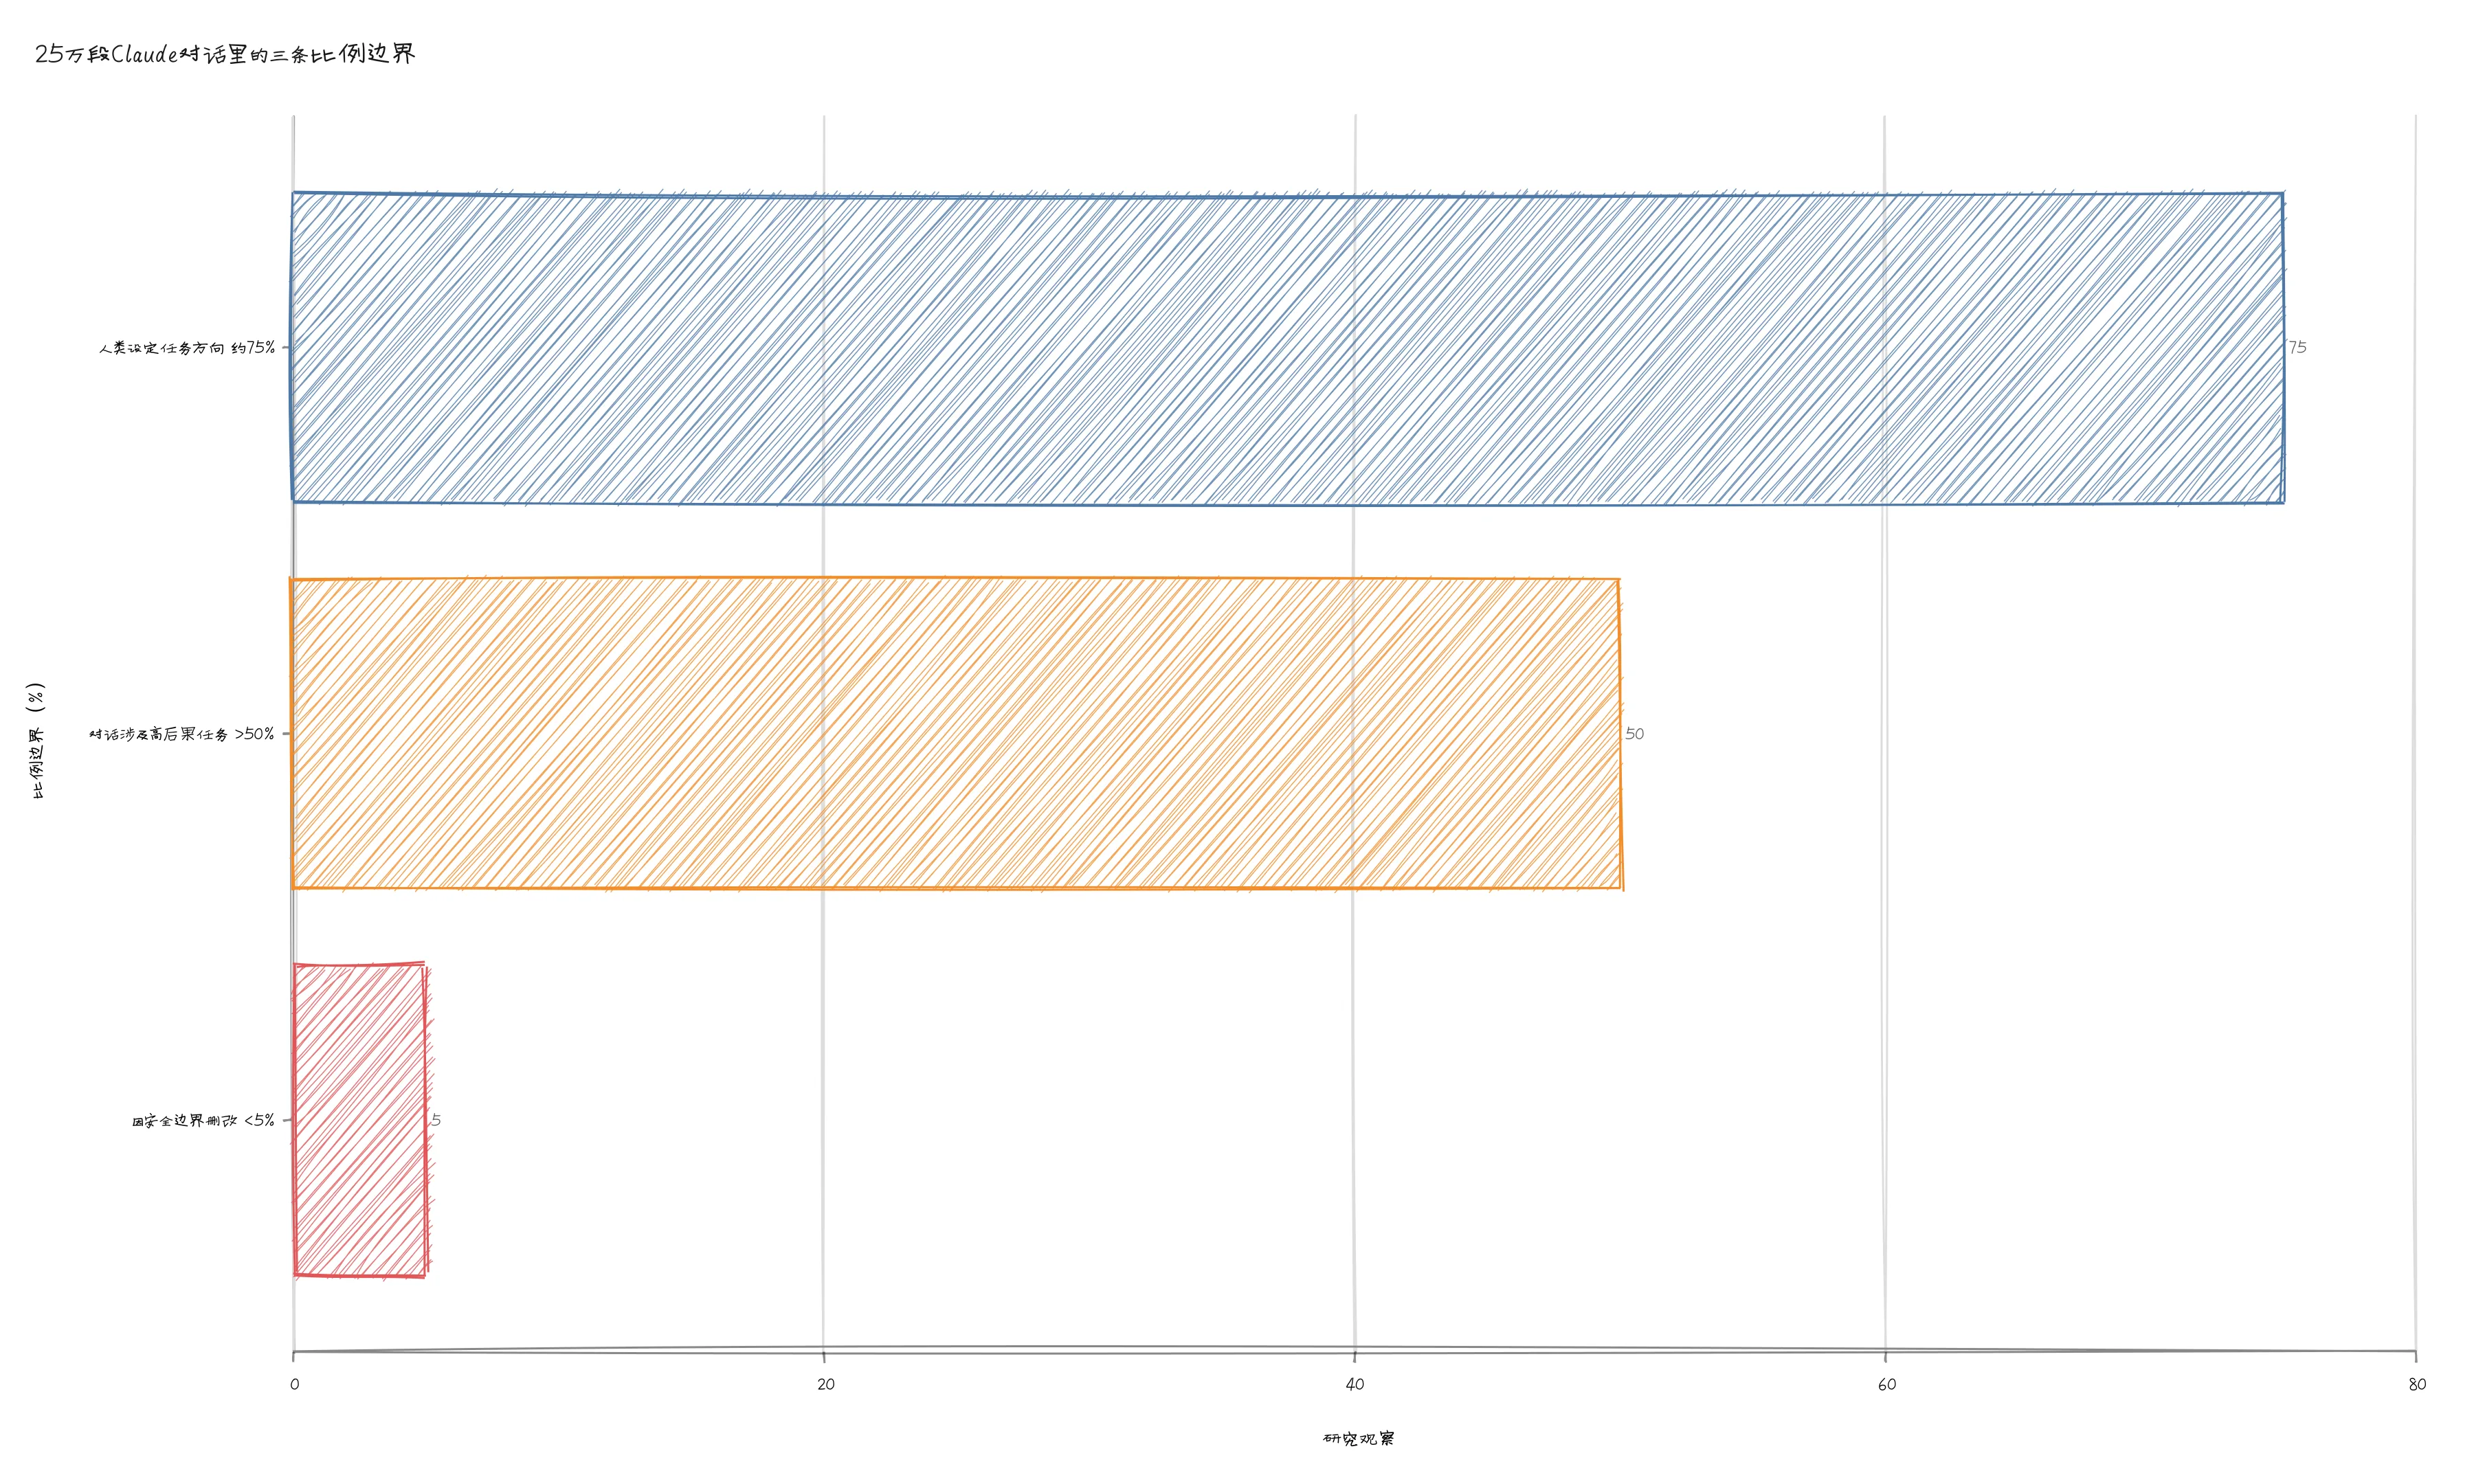
斯坦福 SALT Lab 研究人类怎样与 AI 协作。他们发现,超过一半的 Claude 对话涉及后果较重、影响他人或难以撤销的任务。法律和金融专业建议尤其常见。
这跟「人只把低风险杂活交给 AI」的预期不一样。很多人嘴上说模型会胡编,手上已经把会影响真实决策的工作递过去了。
与此同时,接近四分之三的对话仍由人类设定方向,Claude 提供协助。用户通常会修改模型输出,而不是复制粘贴直接交差。摩擦也不全是坏事。用户发现 Claude 误解了意图,再补条件、改方向、收紧输出,这段来回本身会推动任务变清楚。
这组发现对 Agent 产品有一个很现实的提醒。
别把「用户少点几次确认」自动当成进步。协作里的某些摩擦是在承载责任。删掉一个确认框很容易,确认框后面原本由谁发现歧义、谁对不可撤销动作踩刹车,才是难题。
SALT Lab 已经公开了完整研究说明,值得做协作式 Agent 的朋友细看。
牛津团队研究的是人在使用 Claude 时的感受。早期结果里,Claude 表现温暖时,用户更积极。Claude 拒绝或反对时,用户更容易继续争辩。Claude 表现得古怪,用户的智力投入反而更高。只是顺利帮忙时,用户更容易显得满意。
怎么说呢,模型的语气不只是皮肤。它会改变人怎样参与任务。
METR 则在研究编程智能体到底节省了多少现实时间。初步结果显示,新模型可能比旧模型节省更多时间。方法里有个容易被忽略的环节,研究依赖 Claude 判断一个任务如果没有 AI 需要多久。METR 把这种估计与既有开发者研究里的已知完成时长对照,发现二者有相关性。
但相关性不是计时器。完整分析还没发,现在就把它写成「Claude Code 让程序员提速多少」的确定结论,多少有点着急。
我有时候觉得,AI 行业特别喜欢把进行中的研究先做成海报。这里最好忍一忍。
开放数据,不等于开放了测量权
Anthropic 已经把每个项目的聚合数据放到 Hugging Face,还在附录里公开了合作流程、合同、隐私威胁模型和第三方隐私审计。
这些都是真进展。
尤其是允许研究团队自己定义问题,并把不方便公司的结果照常发表。这比公司内部研究换个外部顾问署名,诚意大得多。
可它还不能被简单写成「25 万段对话向学界开放」。公开的是聚合结果,不是对话本身。研究者拥有问题设计权,却不能自由换一套分类模型重跑,不能逐条复核,也不能让另一家实验室在同一批原始材料上完全复现。
还有一道删改边界。
研究中有些聚合类别暴露了违反使用政策的行为。Anthropic 公布了大多数违规类别,但会隐藏那些可能说明用户如何绕过护栏的内容。每项研究里,被修改或删除的类别与对话都少于 5%,平台也会告诉研究者哪些聚类被处理以及原因。
不到 5% 看起来很小。但在研究稀有风险时,尾部那一点可能正是最有价值的部分。
坦率讲,我不认为这让试点失去意义。用户隐私和防止复制绕过方法,确实是合理边界。只是我们得把边界写在结论旁边,别把「独立提出问题」悄悄讲成「独立掌握数据」。
外部审计从来不是一个开关。
它是一串权限。
谁定问题,谁选样本,谁执行测量,谁能看原文,谁解释异常,谁决定删改,谁拥有发表权。Anthropic 这次交出了其中几项,保留了另外几项。价值就在这个拆分里,限制也在这个拆分里。
普通 Agent 团队真正能抄的东西
多数团队当然没有 25 万段对话,也请不起三所研究机构。但这套思路并不只属于大厂。
先别急着建一个漂亮仪表盘。先把外部的人能否提出自己的问题写进评测合同。
如果安全团队只能看产品团队预先选好的成功率,它不是外部检查,只是换了一个人读周报。真正有用的接口,应该允许对方定义切片,例如只看高权限工具调用、只看长任务中途改目标、只看失败后自动重试超过三次的轨迹。
然后给每个问题配一小块可人工核对的验证集。验证集不必来自真实用户,可以来自合成样本、公开数据和经过授权的内部案例。但要明确它与生产流量哪里不同。别再拿一个分布完全不同的公共基准跑到 95 分,就宣布生产分类可靠。
再往后,把评测问题本身当代码管理。问题改了什么,分类边界为什么变,哪些版本跑过哪些数据,都应该能追踪。否则同一个「危险工具调用率」这个月是 2%,下个月变成 5%,团队根本不知道风险上升了,还是提问措辞换了。
还要给观察者真正的发表权。内部场景不一定要发论文,但至少要允许安全、合规或独立评测团队留下不同意见,而且这份意见不能被产品负责人用一句「不符合业务语境」抹掉。
这套流程不酷。它会拖慢一点发布,会多几轮隐私审查,会暴露团队原本不想看的问题。
可你想想看,所谓可信,不就是允许别人拿自己的问题来难为你吗?
25 万段对话一条都看不到,这听上去像悖论。读完整个试点,我反而觉得它把问题照得更清楚了。
隐私不是拒绝外部检查的借口,开放也不是把原始日志扔出去的冲动。中间那条路很窄,需要受控接口、问题版本、验证数据、删改记录和独立发表权一点点铺出来。
Anthropic 这次没有交出整座数据库。
它交出了一部分被提问的权力。
还不完美,但比自己给自己打分,强多了。