posts/anthropic-pptx-skill-ab-test.md
这个 PPT Skill 21.1 万次安装、17.3 万 Star,同题少吃 20% 输入 Token
同一份 8 页产品汇报,我让同一个 GPT-5.6 Sol 跑了两遍。
A 组关掉所有 Skills,只给产品数据和公司模板。B 组多加载一份 Anthropic 官方 pptx Skill。模型、推理档位、输入文件都没变,连 brief 的 SHA-256 都一样。
这玩意现在有多热。现场查 skills.sh,安装量约 21.1 万次。再查 GitHub 官方仓库,172,518 Star、20,495 Fork。做 PPT 这件熟悉得不能再熟悉,社会证明也够猛。
安装倒不复杂。
npx skills add https://github.com/anthropics/skills --skill pptx先把结论放这儿。Skill 没把裸模型按在地上摩擦,甚至有一页图表,裸模型排得更紧凑。它真正省下的是过程的不确定性,还少吃了 20.4% 的输入 Token。
好家伙,这个结果比「装上就变 PPT 大师」有意思多了。
我给两组的任务是一份虚构但数据完整的 Northstar Assist 季度产品汇报。8 页,面向高管产品委员会,目标是拿到 H2 发布计划、6 名工程师、2 名产品营销和 120 万美元基础设施预算的批准。
里面故意塞了几种 PPT 最容易翻车的东西。32,000 到 8,700 的使用漏斗,四项功能采用率,三条留存曲线,四个月路线图,三项发布风险,还有一份 4 页公司模板。图表必须是 PowerPoint 原生对象,不能拿 PNG 糊弄;时间线、数字和文本都得能改。
原本我打算直接在 Claude CLI 里做双跑,实际请求返回了 OAuth access token has been revoked。为了不把登录状态混进实验,我换成同一个 Codex 宿主,两组唯一变量仍然是是否加载 Anthropic 公布的 SKILL.md。所以这次测的是公开工作流本身的增益,不是 Claude 和 Codex 谁更强,也不能冒充 Anthropic API 内置版本的官方跑分。
裸模型并没有摆烂。它自己检查模板的字号、颜色、页脚和双圆点图形,重建了 3 套母版,生成 2 个原生图表,渲染 8 页后发现路线图标题太长,又回头改了一轮。
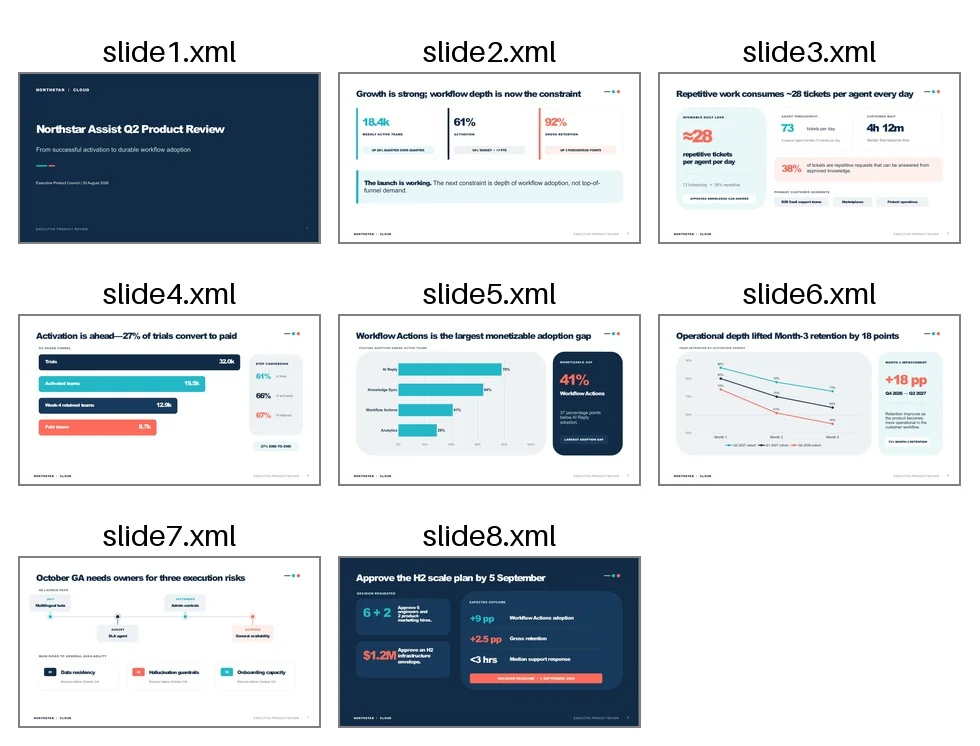
从结果看,版式相当能打。标题大多压在一行,图表区和结论区分得清楚,第 7 页的路线图也很完整。它还把公司模板里的 Office theme XML 原样拷进最终文件。坦率讲,如果只看缩略图,很难一眼说这是「没装 Skill」的作品。
Skill 组的开场不一样。它先用缩略图脚本盘完整套模板,再用 MarkItDown 抽取每页文字,接着把 4 页模板复制成 8 页结构骨架,才开始往里填内容。第一轮渲染发现模板页脚重复、原生图表字体被 LibreOffice 回退成衬线体,修完后重新生成、重新验。
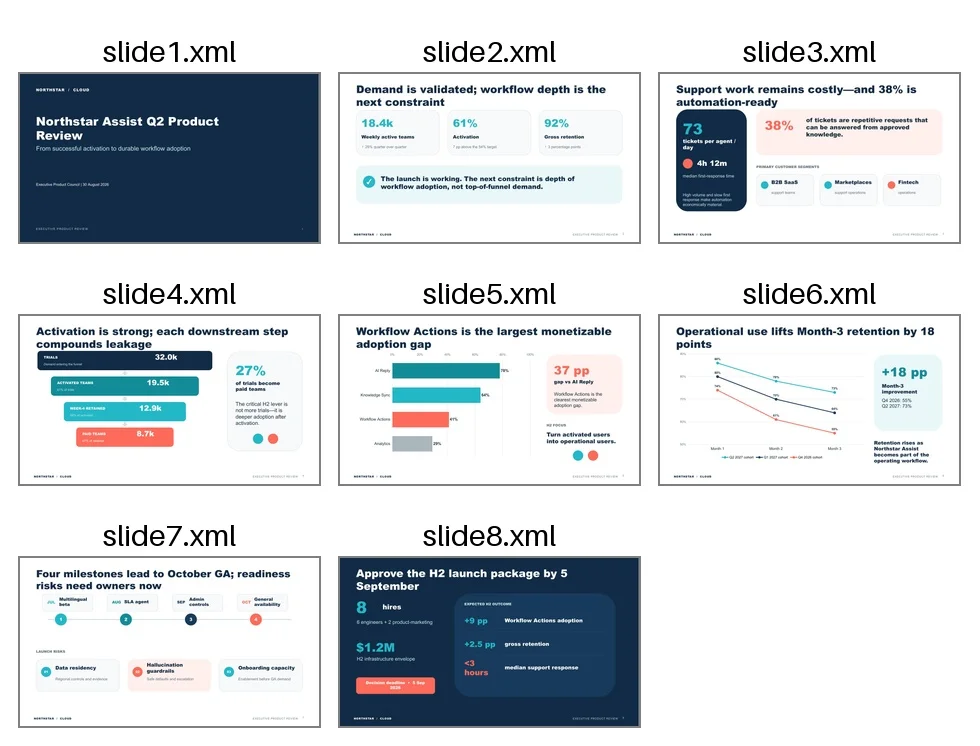
这套顺序不是模型临场灵感,而是 Skill 写死的工程纪律。官方文件把新建、读文件、套模板分成三条路,还附了 thumbnail.py、validate.py 和 LibreOffice 转图脚本。连图表必须保持原生、首轮渲染默认有问题、占位符要全文扫描,都写得明明白白。
先看可编辑性。两组打平。
我拆开两份 .pptx 检查,都是 8 个 slide XML、2 个 chart XML、2 个内嵌 Excel 工作簿,媒体目录里都是 0 张图片。漏斗和时间线也全由文本框与形状组成。两份文件都通过 Anthropic 自带的结构校验,压缩包测试没有坏文件,模板占位符扫描为 0。
裸模型用了 198 个可编辑形状,Skill 组用了 149 个。别急,形状多不等于更高级。前者更爱把细节拆成独立元素,后者更克制。真正有用的结论是,两组都没有把图表截图塞进去交差。
再看图表。裸模型的功能采用率页面更像已经排好的高管汇报,浅灰图表底板加深蓝结论卡,信息密度高但不乱。Skill 组把 Workflow Actions 单独标成珊瑚色,右侧再解释 37 pp(百分点)的差距,判断更直接,但两行大标题吃掉了不少上方空间。
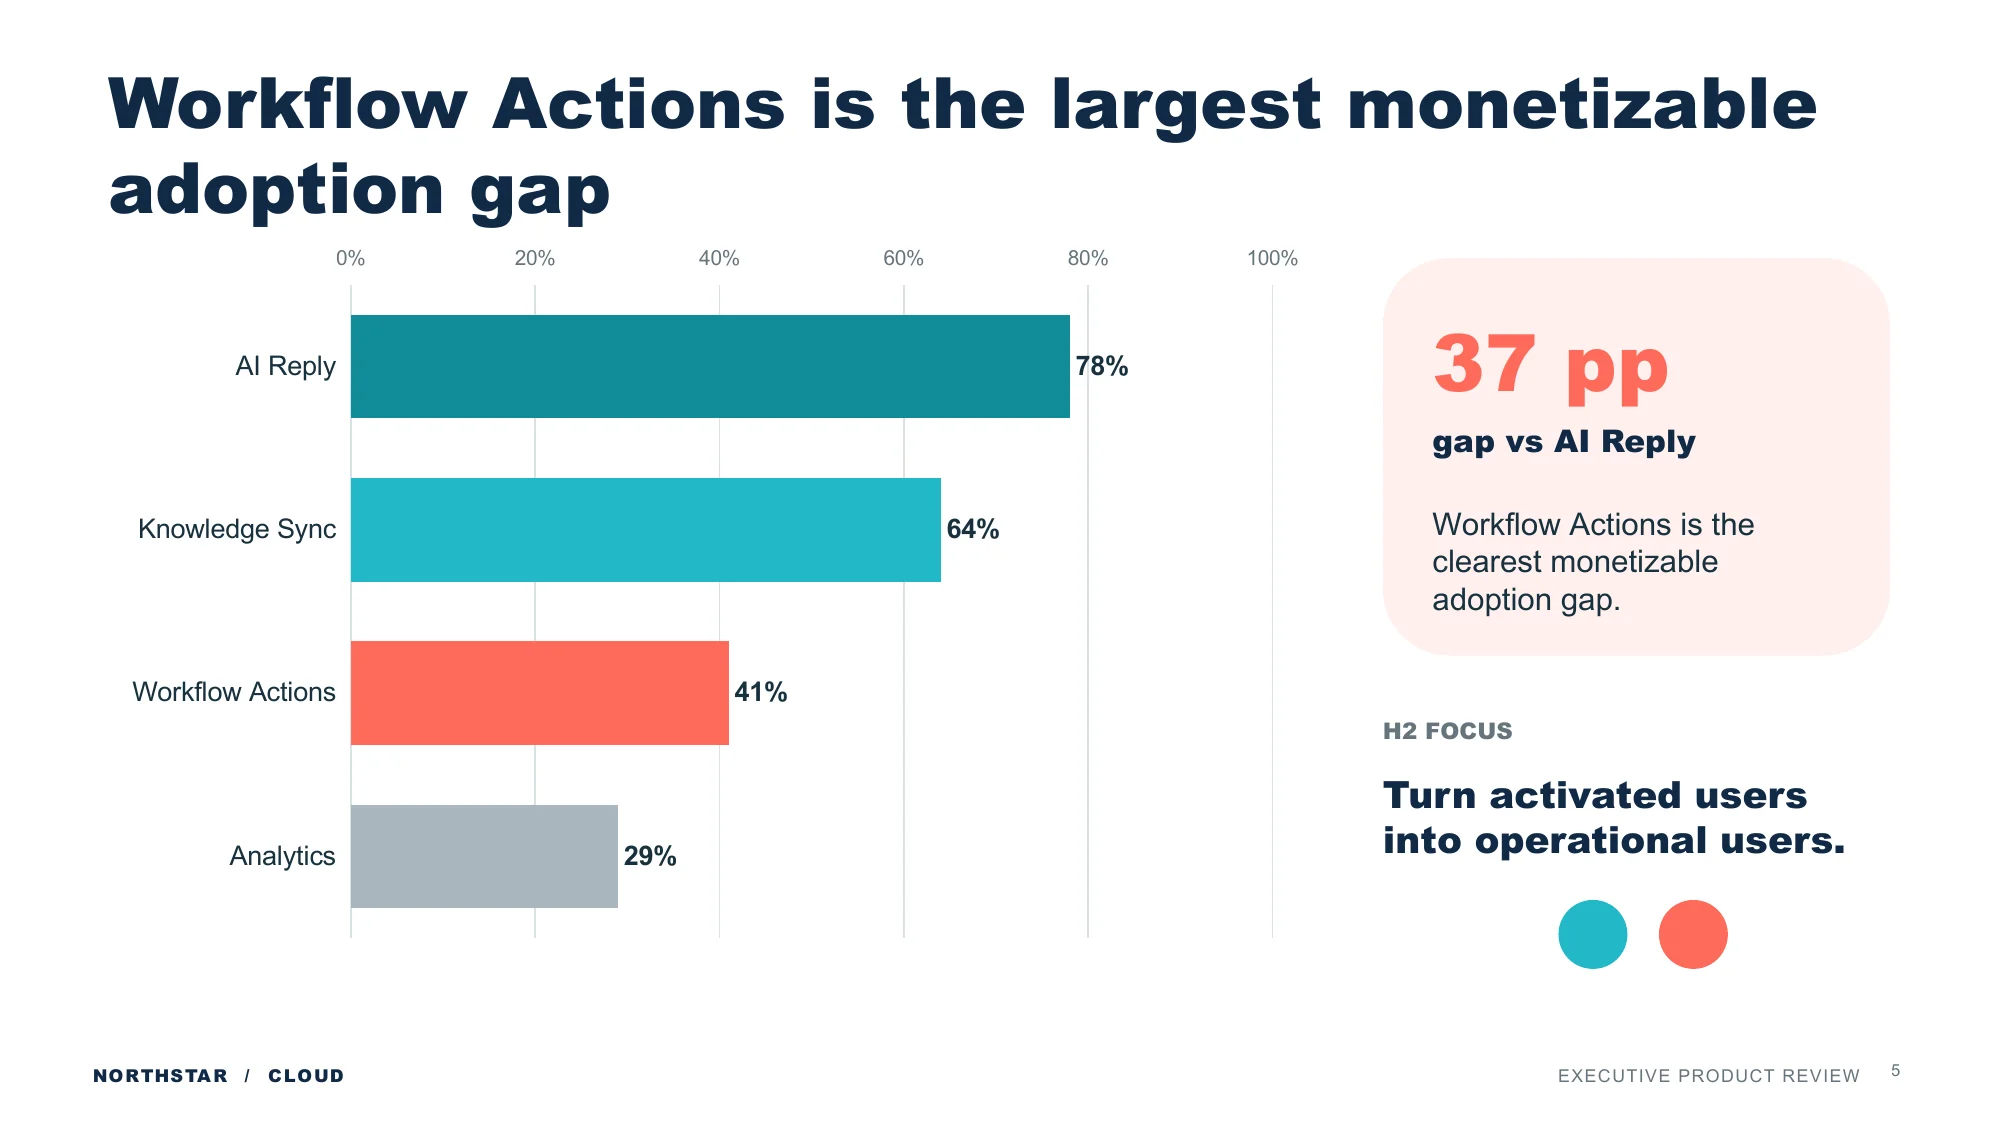
我自己的感受是,Skill 赢在稳定,不一定赢在单页审美上限。 简单模板里,强模型裸跑照样能还原品牌色、页脚和图表。模板一旦变成二三十页,里面混着母版、SVG、图标、备注和一堆祖传占位符,先盘模板再动手的价值就会迅速放大。裸模型这次选择重建母版,Skill 组选择复制原模板骨架,这两个路径在简单样例上看着差不多,复杂模板里可不是一回事。
更有意思的是 Token。
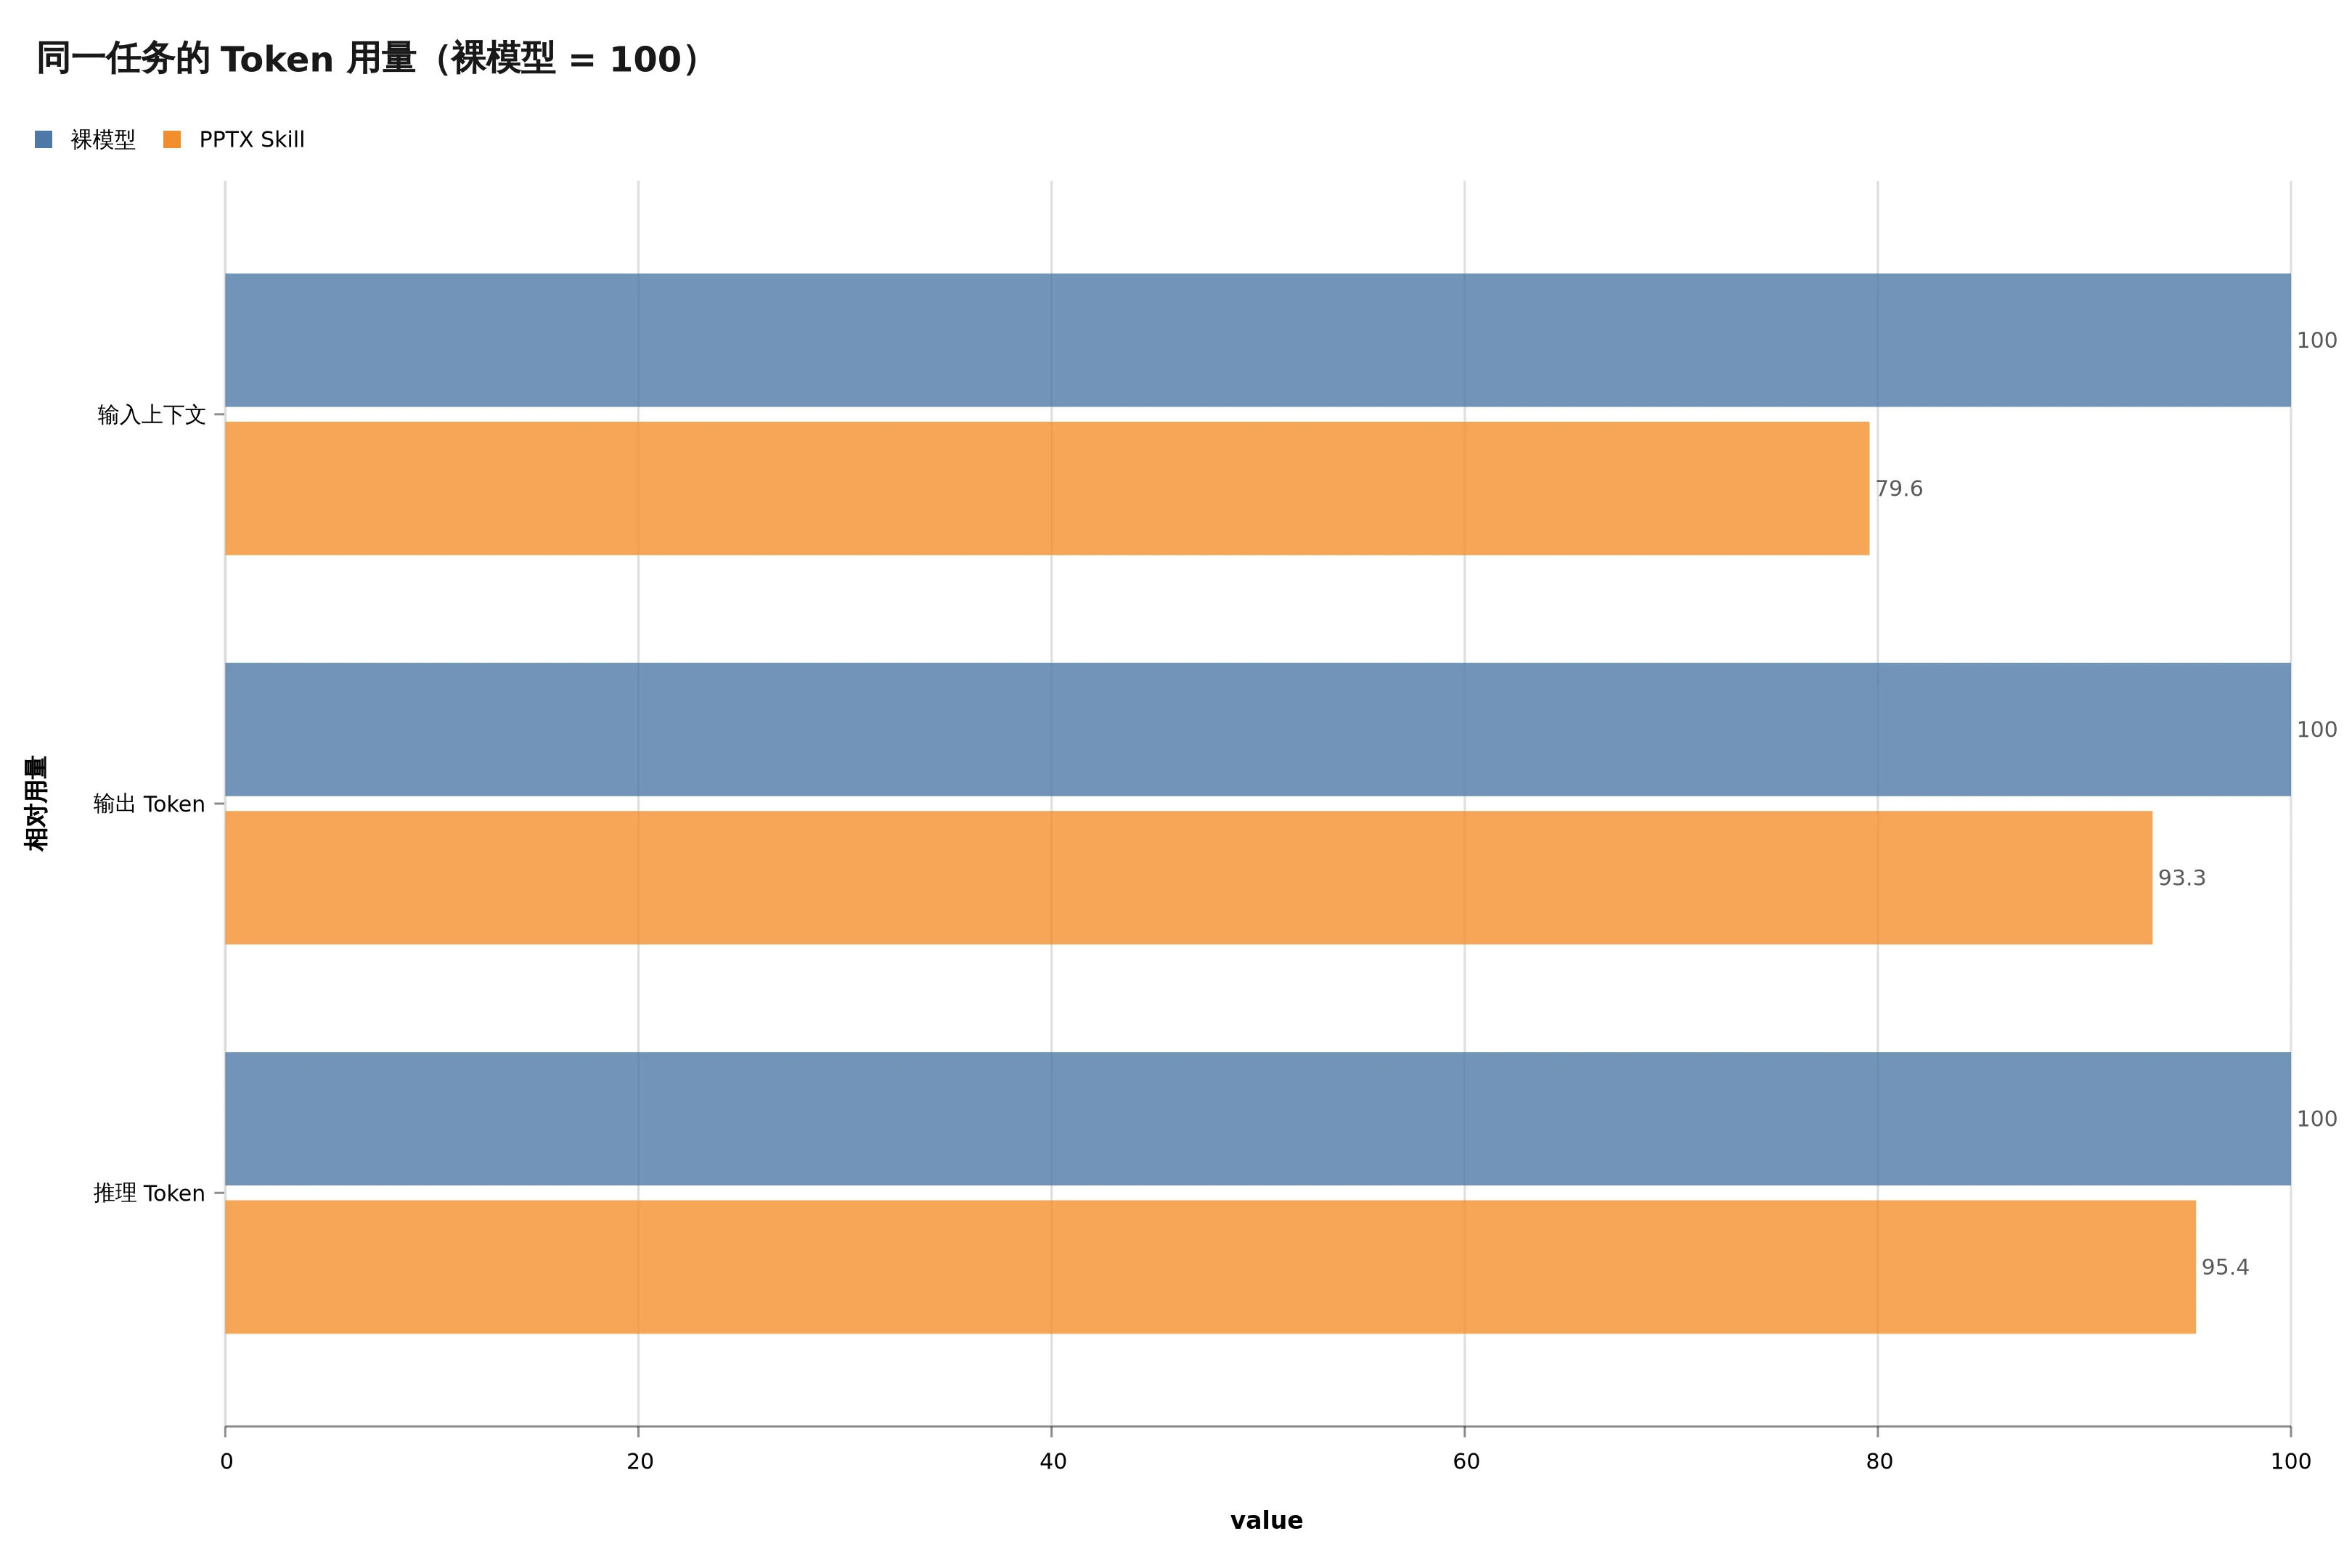
裸模型一共用了 2,116,623 个输入 Token,Skill 组用了 1,684,617 个,少了 20.4%。输出 Token 从 25,391 降到 23,693,少 6.7%。推理 Token 从 9,366 降到 8,939,少 4.6%。这是单次实验,不该外推成固定节省比例,但方向很清楚。模型不必每次重新发明「怎么检查模板、怎么验图表、怎么做第二轮修正」。
这一下挺像给新同事一份靠谱的入职手册。能力还是那个人的能力,手册不会突然给他加十年审美经验,但会告诉他先查什么、别踩什么、交付前跑哪几个检查。Anthropic 的 Agent Skills 文档 也把 Skill 定义成指令、元数据和可选脚本的模块化能力,按任务需要逐层加载,不是给模型换脑子。
所以要不要装。
你如果每周都要做产品汇报、融资材料、客户方案,尤其手上已有公司模板,又要求图表和文字能继续改,我觉得值得。它最值钱的不是配色表,而是把「模板盘点、原生对象、结构校验、逐页渲染、发现问题再修」串成一条固定路径。
如果只是做一份一次性的概念提案,追求 Keynote 式视觉冲击,或者公司模板本身就丑得很稳定,装完也不会自动开悟。它同样不会替你决定哪条数据值得上首页,哪一句结论值得让老板停三秒。别把流程护栏当创意总监。
还有个容易被安装量盖过去的点。Anthropic 仓库说明 写得很清楚,PPTX、DOCX、PDF、XLSX 这几份文档 Skill 是 source-available,并非普通开源项目。拿去生产环境前,许可证、依赖和模板里的敏感信息都得自己过一遍。官方也提醒,仓库里的实现和 Claude 产品内实际行为可能不同。
这轮实测留下的一句话很简单。
PPT Skill 没让模型突然更会设计,它让模型更难忘记验收。
有点子牛逼的地方,不在那 8 页 PPT 里,而在第 9 页不存在之前,它知道该停下来再检查一遍。