
Claude 开放任务成功率到 91%,人类先成了瓶颈
Anthropic 更新了 RSI 内部数据,Claude 的开放任务成功率已升至约 91%。这还不是 AI 自己造下一代 AI,但研发流程的瓶颈正在从执行转向判断、评审和验证。
一条蓝线,三个月里从 76% 爬到了 91%。
这条线不是公开榜单,也不是 Claude 又刷了一次 SWE-bench。它来自 Anthropic 自己的 Claude Code 会话,代表模型面对最开放、最缺规格的内部任务时,被判定成功的比例。
9 月 18 日,Anthropic 在《When AI builds itself》末尾补上了最新曲线。四类任务的成功率,到 9 月已经挤进 88% 到 92% 这个窄区间。
好家伙,最难的那条线追上来了。
但先把一个容易传歪的事实摆正。这不是 Anthropic 9 月首次发布 RSI 报告。原文 6 月 4 日就已经公开,9 月 18 日新增的是内部数据更新。真正的新消息,是开放任务成功率从 5 月的 76% 继续升到约 91%,不再和简单任务隔着几十个百分点。
它也不等于递归自我改进已经发生。
RSI,Recursive Self-Improvement,指 AI 可以自主设计、训练和验证更强的下一代 AI,然后由更强的下一代继续改进自己。Anthropic 在正文里写得很克制,他们还没走到这一步,而且 RSI 并非必然。
那这份更新为什么仍然值得写?
因为在完整闭环出现之前,前半段已经开始改变研发组织。AI 执行越来越便宜,人类判断和评审却没有同步扩容。这个瓶颈,比「AI 会不会突然觉醒」更早落在每个正在用 Agent 写代码的团队头上。
91% 到底测了什么
先看最新那张图。
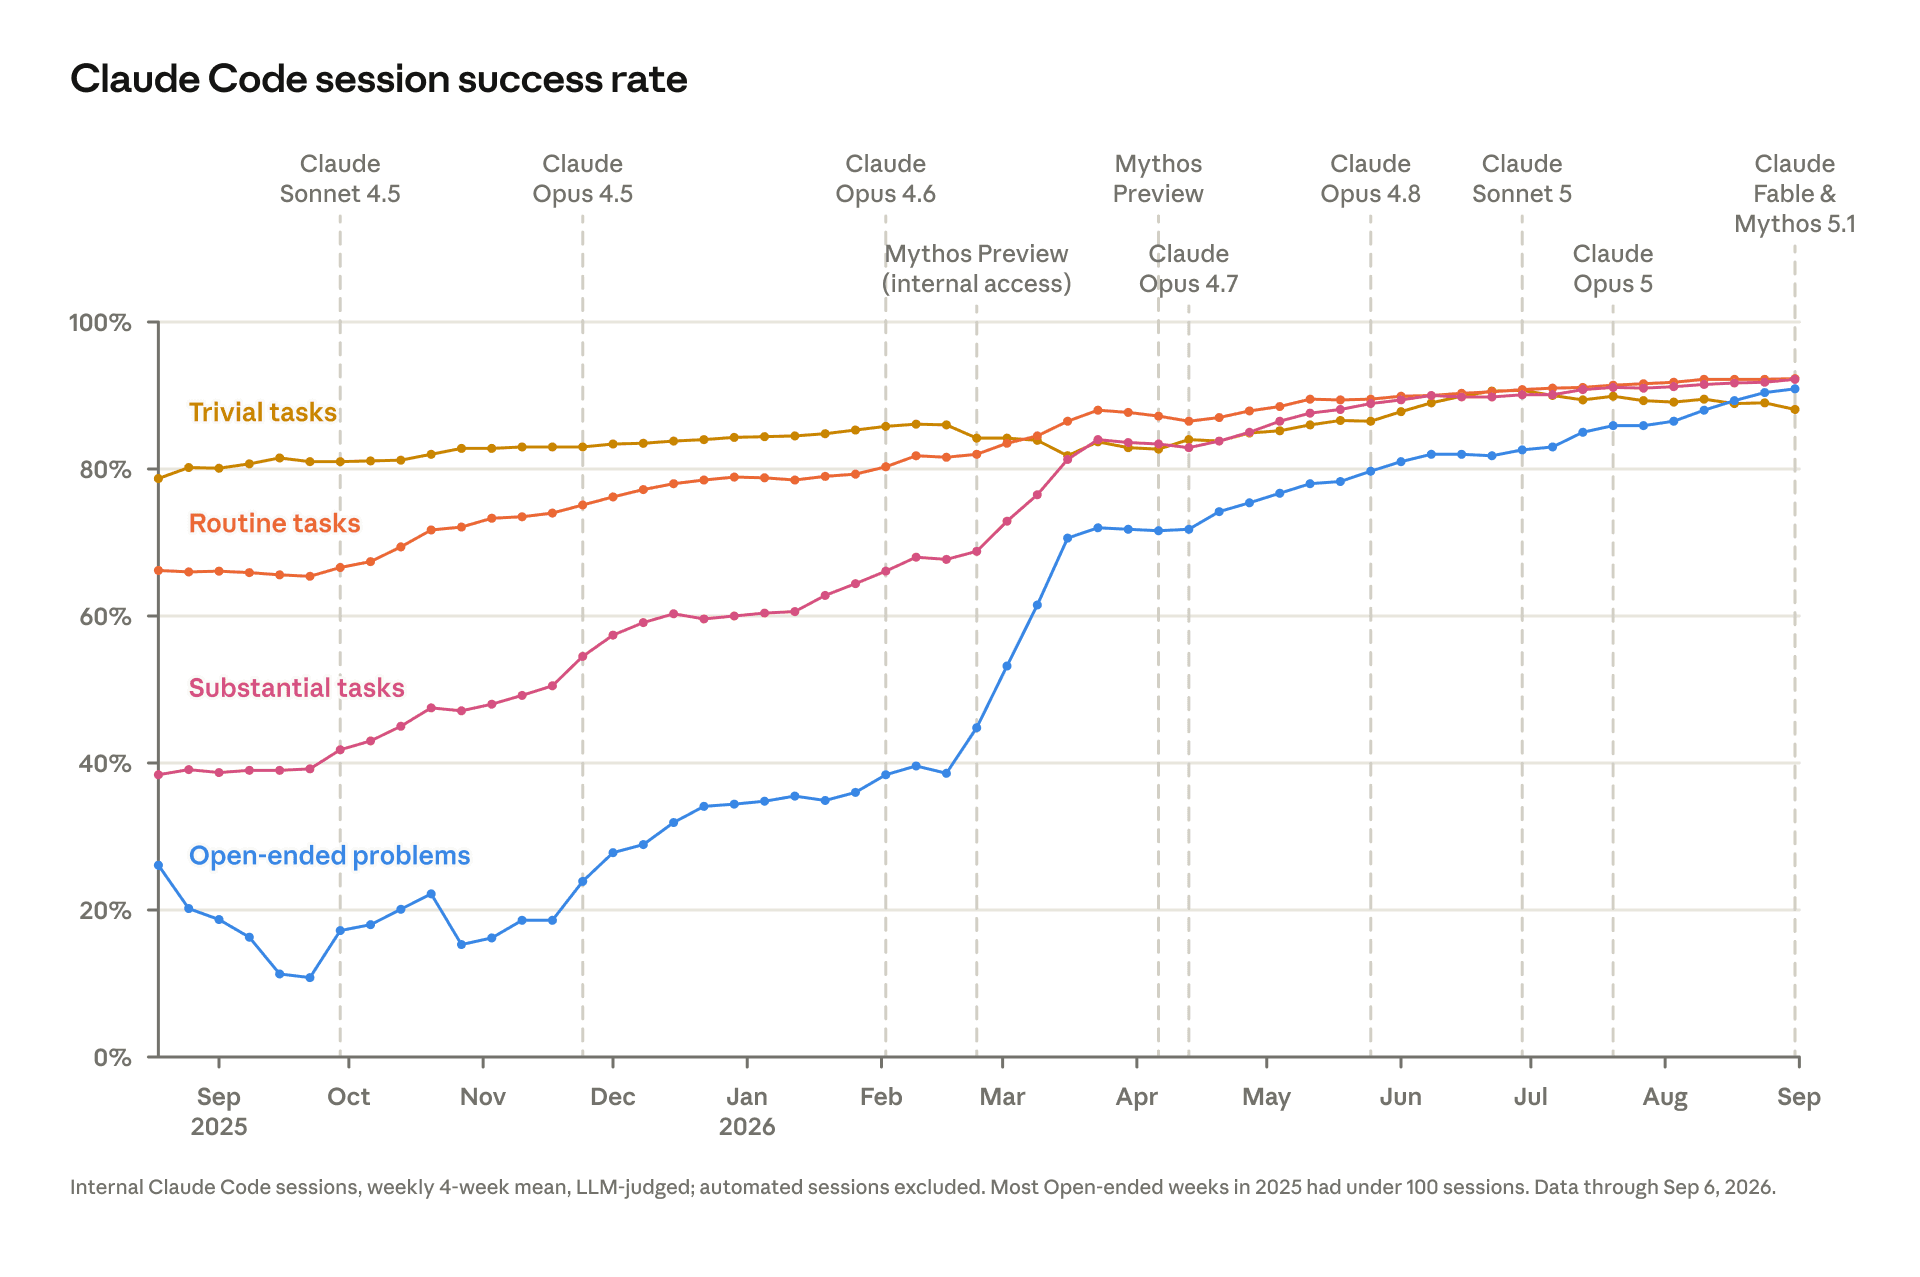
蓝线是 Open-ended problems,也就是目标存在,但规格不完整、解决路径不清楚的开放任务。2025 年秋天,它长期只有十几个百分点。2026 年 2 月后陡升,到 5 月约 76%,9 月约 91%。
Anthropic 的例子很具体。一次常规升级导致数万次训练任务崩溃,工程师只给 Claude 一段上下文和集群访问权限。Claude 逐个测试环境变量,找到一个冷门调试开关,复现问题并确认修复。官方称它用约两小时完成了通常需要两三天的工作。
这已经不是补全一个函数。模型在一个活系统里读状态、做假设、动工具、看结果,再继续缩小范围。
可 91% 也有几层但书。
样本来自 Anthropic 内部,成功与否由另一个 Claude 判断,任务难度同样由模型分类。自动化会话被排除在更新图之外,2025 年一些开放任务周样本少于 100,而且任务分布变化会让曲线短期波动。
所以这张图能证明的是,Anthropic 内部的 Claude Code 会话越来越少需要纠正或接管。它不能独立证明所有公司的开放任务都有 91% 成功率,更不能证明模型已经能自主选择最值得研究的问题。
这里还有一个统计口径特别容易被忽略。所谓成功,不是代码跑完一次就算过关,而是评审模型根据会话摘要判断 Claude 是否清楚完成了用户任务,并且没有要求人类纠正。这个口径比只看测试通过更接近真实工作,但它仍然把判断权交给了模型。评审模型可能偏爱和自己相似的解法,也可能漏掉摘要之外的问题。
开放任务这条线的样本组成也会随月份变化。某周恰好来了更多熟悉仓库里的故障,和某周全是新系统里的模糊问题,难度标签相同,真实挑战并不相同。Anthropic 展示的是四周移动平均,只能削平噪声,不能消掉任务分布变化。
所以我会把 91% 当成一个强烈的内部趋势信号,而不是可以直接写进采购报告的行业基准。它最值得注意的地方,是同一家公司、同一套工作流里,最开放任务与常规任务之间的差距正在快速消失。
从会干活到会选方向,中间还隔着一层
Anthropic 把造模型拆成两类工作。
一类是执行。写代码、搭基础设施、跑训练、做实验。另一类是判断。决定试什么、相信哪个结果、什么时候放弃一条路线。
Claude 在执行侧已经冲得很快。
截至 2026 年 5 月,Anthropic 称超过 80% 的生产合并代码可归因于 Claude。典型工程师在 2026 年第二季度每天合并的代码量,是 2024 年的 8 倍。公司还让每一代模型优化一段小模型训练代码,速度提升从 2025 年 5 月的约 3 倍,涨到 2026 年 4 月内部模型的约 52 倍。
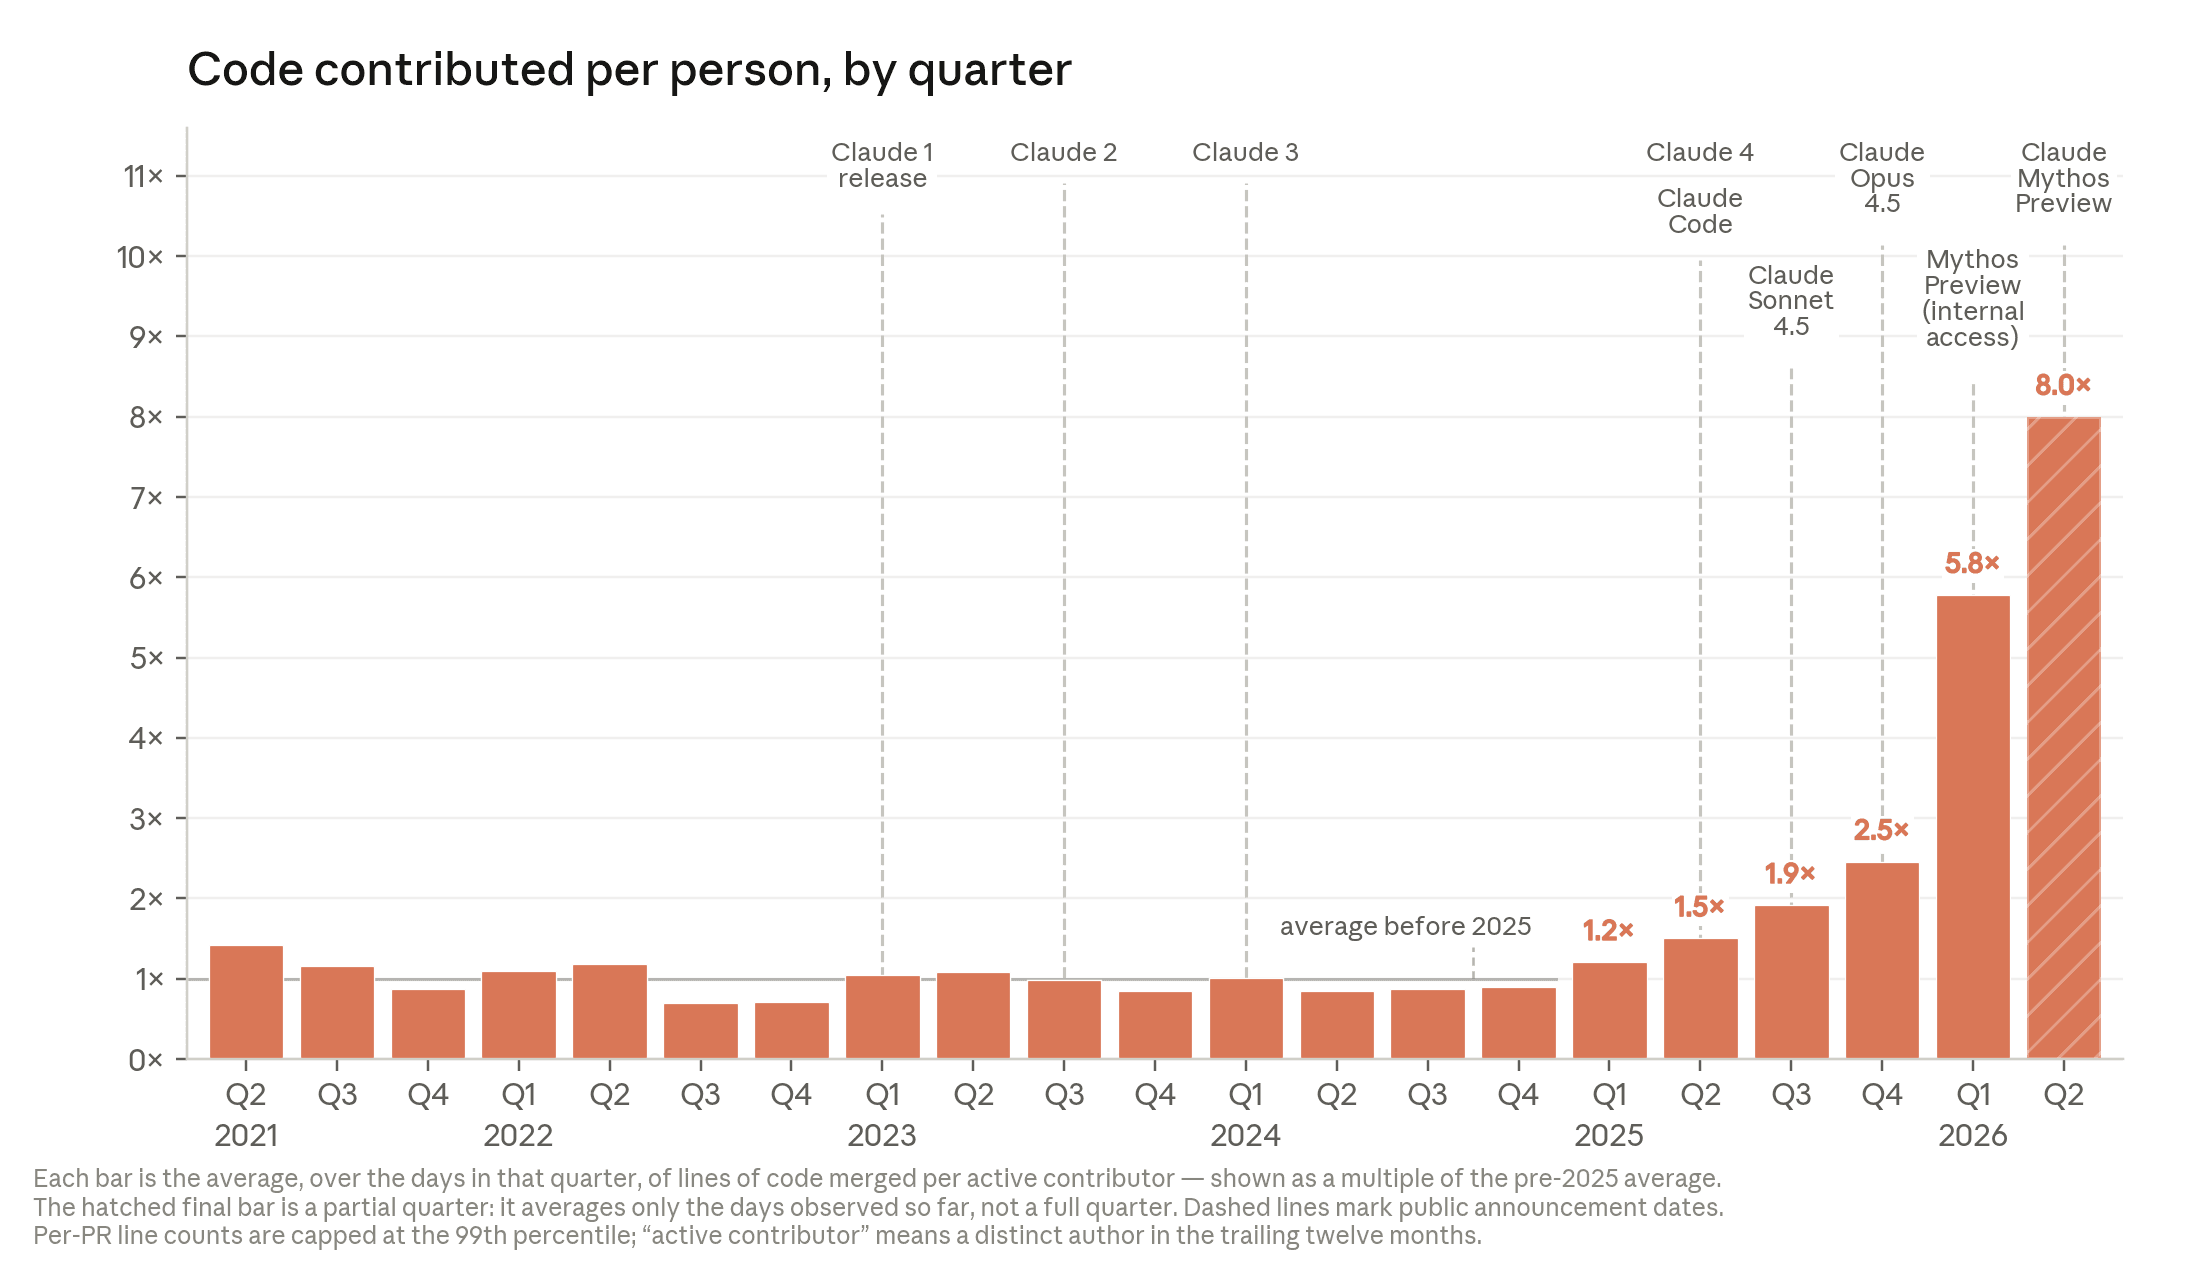
这些数字很猛,但代码行数不是生产力,Anthropic 自己也承认 8 倍会高估真实提升。更关键的是,目标、正确性检查和实验边界仍然由人先定义。
判断侧的数据更微妙。
研究团队从 129 段真实会话中,专门挑出人类研究员走过弯路的时刻,再让不同版本的 Claude 只看走偏之前的记录,建议下一步。一个知道最终结果的 Claude 负责判谁的方向更好。内部 Mythos Preview 在 64% 的样本里胜过人类。
听着有点子牛逼,但这个集合本来就只挑了人类有改进空间的时刻,不是公平的人机总决赛。Anthropic 还做了 127 个对照样本,人类下一步本来就很强,模型只在约 20% 的时候更好。
这两组数放在一起才有意思。模型开始能救回人类的坏判断,却还没有稳定取代好的研究判断。
也就是,会跑实验和会决定该跑什么实验,仍然不是一回事。
报告里还有一项更接近完整研究的实验。Anthropic 曾让一组 Claude Agent 围绕弱模型监督强模型的问题,自主提出假设、跑实验、交换结果并继续迭代。两位人类研究员一周内缩小了大约 23% 的性能差距,Agent 用累计 800 小时和约 1.8 万美元算力缩小了 97%。
这个结果很抓眼,但人仍然选了问题,也设计了评分尺,而且方法没有顺利迁移到生产规模模型。模型在一个人类搭好的实验场里跑得很远,和模型自己发现哪座山值得爬,还是两件事。
这恰好是 RSI 判断里最不能偷换的一步。执行速度可以用小时和吞吐量计算,研究方向却涉及长期价值、机会成本、证据质量和失败后的解释。前者越来越像工程自动化,后者还没有一条公认的自动验收线。
RSI 没闭环,反馈回路已经加速
如果把 RSI 画成一条链,大概是这样。
提出研究方向 → 设计实验 → 写代码与运行 → 解释结果 → 训练下一代模型 → 再提出更好的方向现在最接近自动化的是中间几段。代码、实验执行、局部优化和缺陷发现,越来越能交给 Agent。最难的仍然是两头,为什么做,以及结果到底值不值得信。
所以我不赞成把 91% 写成 RSI 已经来了。这个标题很爽,事实却接不住。
更准确的判断是,AI 研发已经进入递归加速,但还没有递归自治。每一代模型都在帮助人类更快造下一代,产生的工具、数据、评测和代码又会进入下一轮研发。反馈回路是真的,只是人仍握着方向盘和验收章。
这也解释了 Anthropic 为什么在报告里专门提到阿姆达尔定律。一个流程里,某部分加速一百倍,整体速度最终仍会卡在没有加速的部分。
代码生成快了,代码审查就堵。
实验能并发跑几百个,选择哪十个继续就堵。
发现漏洞变快,修补和上线就堵。
这不是未来时,很多团队现在就已经撞上了。
对普通研发团队,先补的不是更多 Agent
如果你的团队已经让 Claude Code、Codex 或内部 Agent 大量写代码,这份 RSI 报告最实用的提醒,不是赶紧再开十个 Agent,而是检查三种容量有没有跟上。
第一种是评审容量。一个人一天能认真看多少个 PR,能否区分功能正确、边界完整和权限安全。生成量翻倍,评审不扩容,未验证代码只是在队列里堆得更快。
第二种是验证容量。测试、评测、回放、灰度和回滚能不能自动化。没有可执行的验收标准,Agent 跑得越久,交回来的一坨东西越难判断。
第三种是方向容量。谁负责决定哪些问题值得做,哪些结果可信,哪条路线该停。Anthropic 把这叫研究品味。放到普通团队,就是产品判断、架构判断和风险判断。
一张简单的检查表可以先用起来。
- Agent 每周新增多少代码、实验或候选方案
- 人类评审的等待时间是否持续上升
- 自动测试能覆盖哪些正确性,哪些仍靠经验判断
- 低置信度或高风险结果有没有明确的人工升级路径
- 团队是否保留了原始轨迹、失败尝试和验收证据
这几项里只要有两项说不清,继续加 Agent 的收益很可能会被评审债吞掉。
真要在团队里验证这件事,可以挑一批已经有答案的历史任务,做一次并排回放。让 Agent 独立完成,再记录四个数,交付成功率、人工接管次数、评审等待时间,以及从发现问题到回滚完成的时间。
别只比较写代码用了多久。Agent 用两小时交出 PR,人类花一天半才敢合并,系统级收益并没有宣传片里那么大。相反,如果测试和证据足够好,评审者能在十分钟内确认结果,即使模型写得慢一点,整条链路也可能更快。
再往前一步,把不同风险的任务拆开统计。文档修订、测试补全、依赖升级可以用较轻的门槛,高权限基础设施、训练数据管线和安全逻辑则需要更严格的复核。一个统一的成功率,会把最危险的尾部藏在平均数里。
这张回放表才是 RSI 话题和日常研发真正接上的地方。不是猜哪年会出现智能爆炸,而是看今天的 Agent 有没有让你的验证系统失去呼吸空间。
RSI 真正让人不安的,不是某一天屏幕上跳出一句「我已经升级了自己」。更现实的路径是,执行环节一段段被自动化,组织越来越依赖自己来不及检查的产物,最后连问题出在哪里都说不清楚。
Anthropic 的新曲线没有证明人类已经退出 AI 研发。
它证明的是另一件事。
人类正在从写代码的人,变成给越来越多机器工作签字的人。真正稀缺的能力,也开始从手速变成判断、验证和承担责任。
RSI 还没来。
评审瓶颈已经到了。
如果你团队明天把 Agent 产出翻一倍,最先堵住的会是代码审查、测试,还是方向判断?