posts/apple-silicon-inference-stack-gap.md
Mac 本地推理不缺新框架,缺的是收敛
同一台 Mac,同一个模型,社区截图里每秒能吐 45 个 token,进了真实代码仓库,多聊几轮,可能只剩 9 个。
跑分没撒谎。
它只是把最难看的那段路裁掉了。
这两天,r/LocalLLaMA 上一篇 Apple Silicon 本地推理实战长帖 把这个问题掀了出来。作者花了两周梳理 MLX-LM、vLLM Metal、oMLX、llama.cpp 和一堆社区分支,结论很刺耳,Mac 不一定缺算力,缺的是一套能把关键优化同时开起来的运行时。
好家伙,这个判断比又一张芯片带宽表有用多了。
很多朋友买 Mac 跑本地模型时,会先看统一内存,再看模型量化后能不能装下,接着搜一张 tok/s 截图。三个动作都没错,但它们回答的只是「能不能启动」和「短跑多快」。如果你的目标是让本地模型接管一个持续一小时的编码任务,真正决定体感的,是上下文越来越长以后,运行时还要不要每轮重读历史,能不能提前猜 token,以及模型转换时有没有把原厂训练好的加速部件悄悄丢掉。
这才是 Mac 本地推理现在最麻烦的地方。
不是没轮子,是轮子太多,车还没装好。
跑分没骗你,只是没告诉你全程
本地推理大致有两段,prefill 和 decode。
prefill 是模型先把你的提示词、代码文件和历史对话吃进去。可以把它理解成开工前把整张桌子铺满资料。decode 才是模型一个 token 接一个 token 往外写答案。
普通聊天里,历史短,prefill 不太扎眼。到了编码 Agent,情况变了。系统提示、工具说明、仓库地图、刚读过的文件、前几轮修改记录不断往上下文里堆。第一轮也许是 1 万 token,下一轮变成 1.1 万,再下一轮 1.3 万。如果运行时没有 prefix cache,也就是前缀缓存,每次请求都要把前面几乎相同的内容重新算一遍。
你看到的生成速度仍可能是 30 tok/s,光标却迟迟不动。因为模型还在重读那一大坨历史。
这一下就解释了为什么短基准很漂亮,长会话却越来越黏。短基准常盯着 decode,真实任务还要付重复 prefill 的账。只报一个 tok/s,有点像餐厅只报炒菜时间,不报排队和备菜。数字是真的,晚饭还是可能九点才端上来。
prefix cache 解决 prefill,speculative decoding 解决 decode。后者叫投机解码,做法是先让模型或一个轻量草稿模块猜接下来的几个 token,再由主模型一次验证。猜对了,就少走几次逐 token 的串行循环。
长时间运行的 Agent 两边都想要。
前缀缓存让它别重复读仓库,投机解码让它写得更快。听着挺顺对吧,问题偏偏出在「同时」两个字上。
Qwen3.8 把两套状态绑在了一起
Qwen3.5、Qwen3.6 和 Qwen3.8 这类新模型,不只维护普通 attention 的 KV cache,还带着 Gated DeltaNet 的循环状态。KV cache 像一排按 token 保存的档案,循环状态更像不断被覆盖的工作台。新 token 进来,工作台就往前滚一步。
投机解码猜错时,普通 attention 可以裁掉猜错后新增的 KV。循环状态没那么省心,它已经被错误 token 推进了,你得把工作台恢复到猜测发生前。prefix cache 也一样,缓存一段公共前缀时,不能只记 KV,还要保存对应的循环状态检查点。
这不是加两个开关。
这是两套状态机要在接受、拒绝、回滚、复用几个路径上保持一致。任何一处差一个 token,后面都可能稳定地生成错误答案。最怕的还不是 crash,最怕它安安静静跑完,然后给你一份看着挺像那么回事的错代码。
MLX-LM 的公开 PR #990 就在啃这块。它加入了 Qwen 原生 MTP,也就是多 token 预测的投机解码,补了 Gated DeltaNet 状态回滚,并让模型转换保留 MTP 权重。提交者在 M4 Pro 上测 Qwen3.6-27B 4-bit,基线是 15.7 tok/s,启用 MTP 后达到 24.6 tok/s,提升约 1.57 倍。
厉害了。
可这个 PR 从 3 月开始仍处于 open。8 月 16 日又出现了 PR #1740,继续补 Qwen3.8、事务式多轮 prompt cache 复用,以及缓存状态不完整时直接拒绝继续运行的保护。
这里有个很容易被忽略的细节。一个模型的 Hugging Face 页面写着支持 MTP,不等于你下载的 MLX 转换版本还保留着 MTP tensors。转换脚本如果没带走这些权重,你装进内存的是同一个模型名字,却不是同一套能力。
模型能加载。
加速头没了。
棒棒的,最难排查的 bug 往往就长这样。
公开 PR 正在拼这张图
相比单点分支,vLLM Metal 更像一套正在收敛的服务栈。它把 MLX 作为计算后端,接上 vLLM 的调度接口,目前公开文档已经列出 paged attention、continuous batching、Qwen3.8 支持,以及混合 GDN 模型的实验性 prefix cache。
这里的进展挺实在,也挺诚实。
混合 prefix cache 的 PR #584 在 M5 Pro 和 Qwen3.5-0.8B 上做了两组很有意思的测试。面对 16 个共享 1088 token 前缀的请求,中位 TTFT,也就是首 token 延迟,从 128.8 毫秒降到 52.8 毫秒,快了约 2.4 倍。完全相同的热前缀,单次探针从 118 毫秒降到 29.5 毫秒。
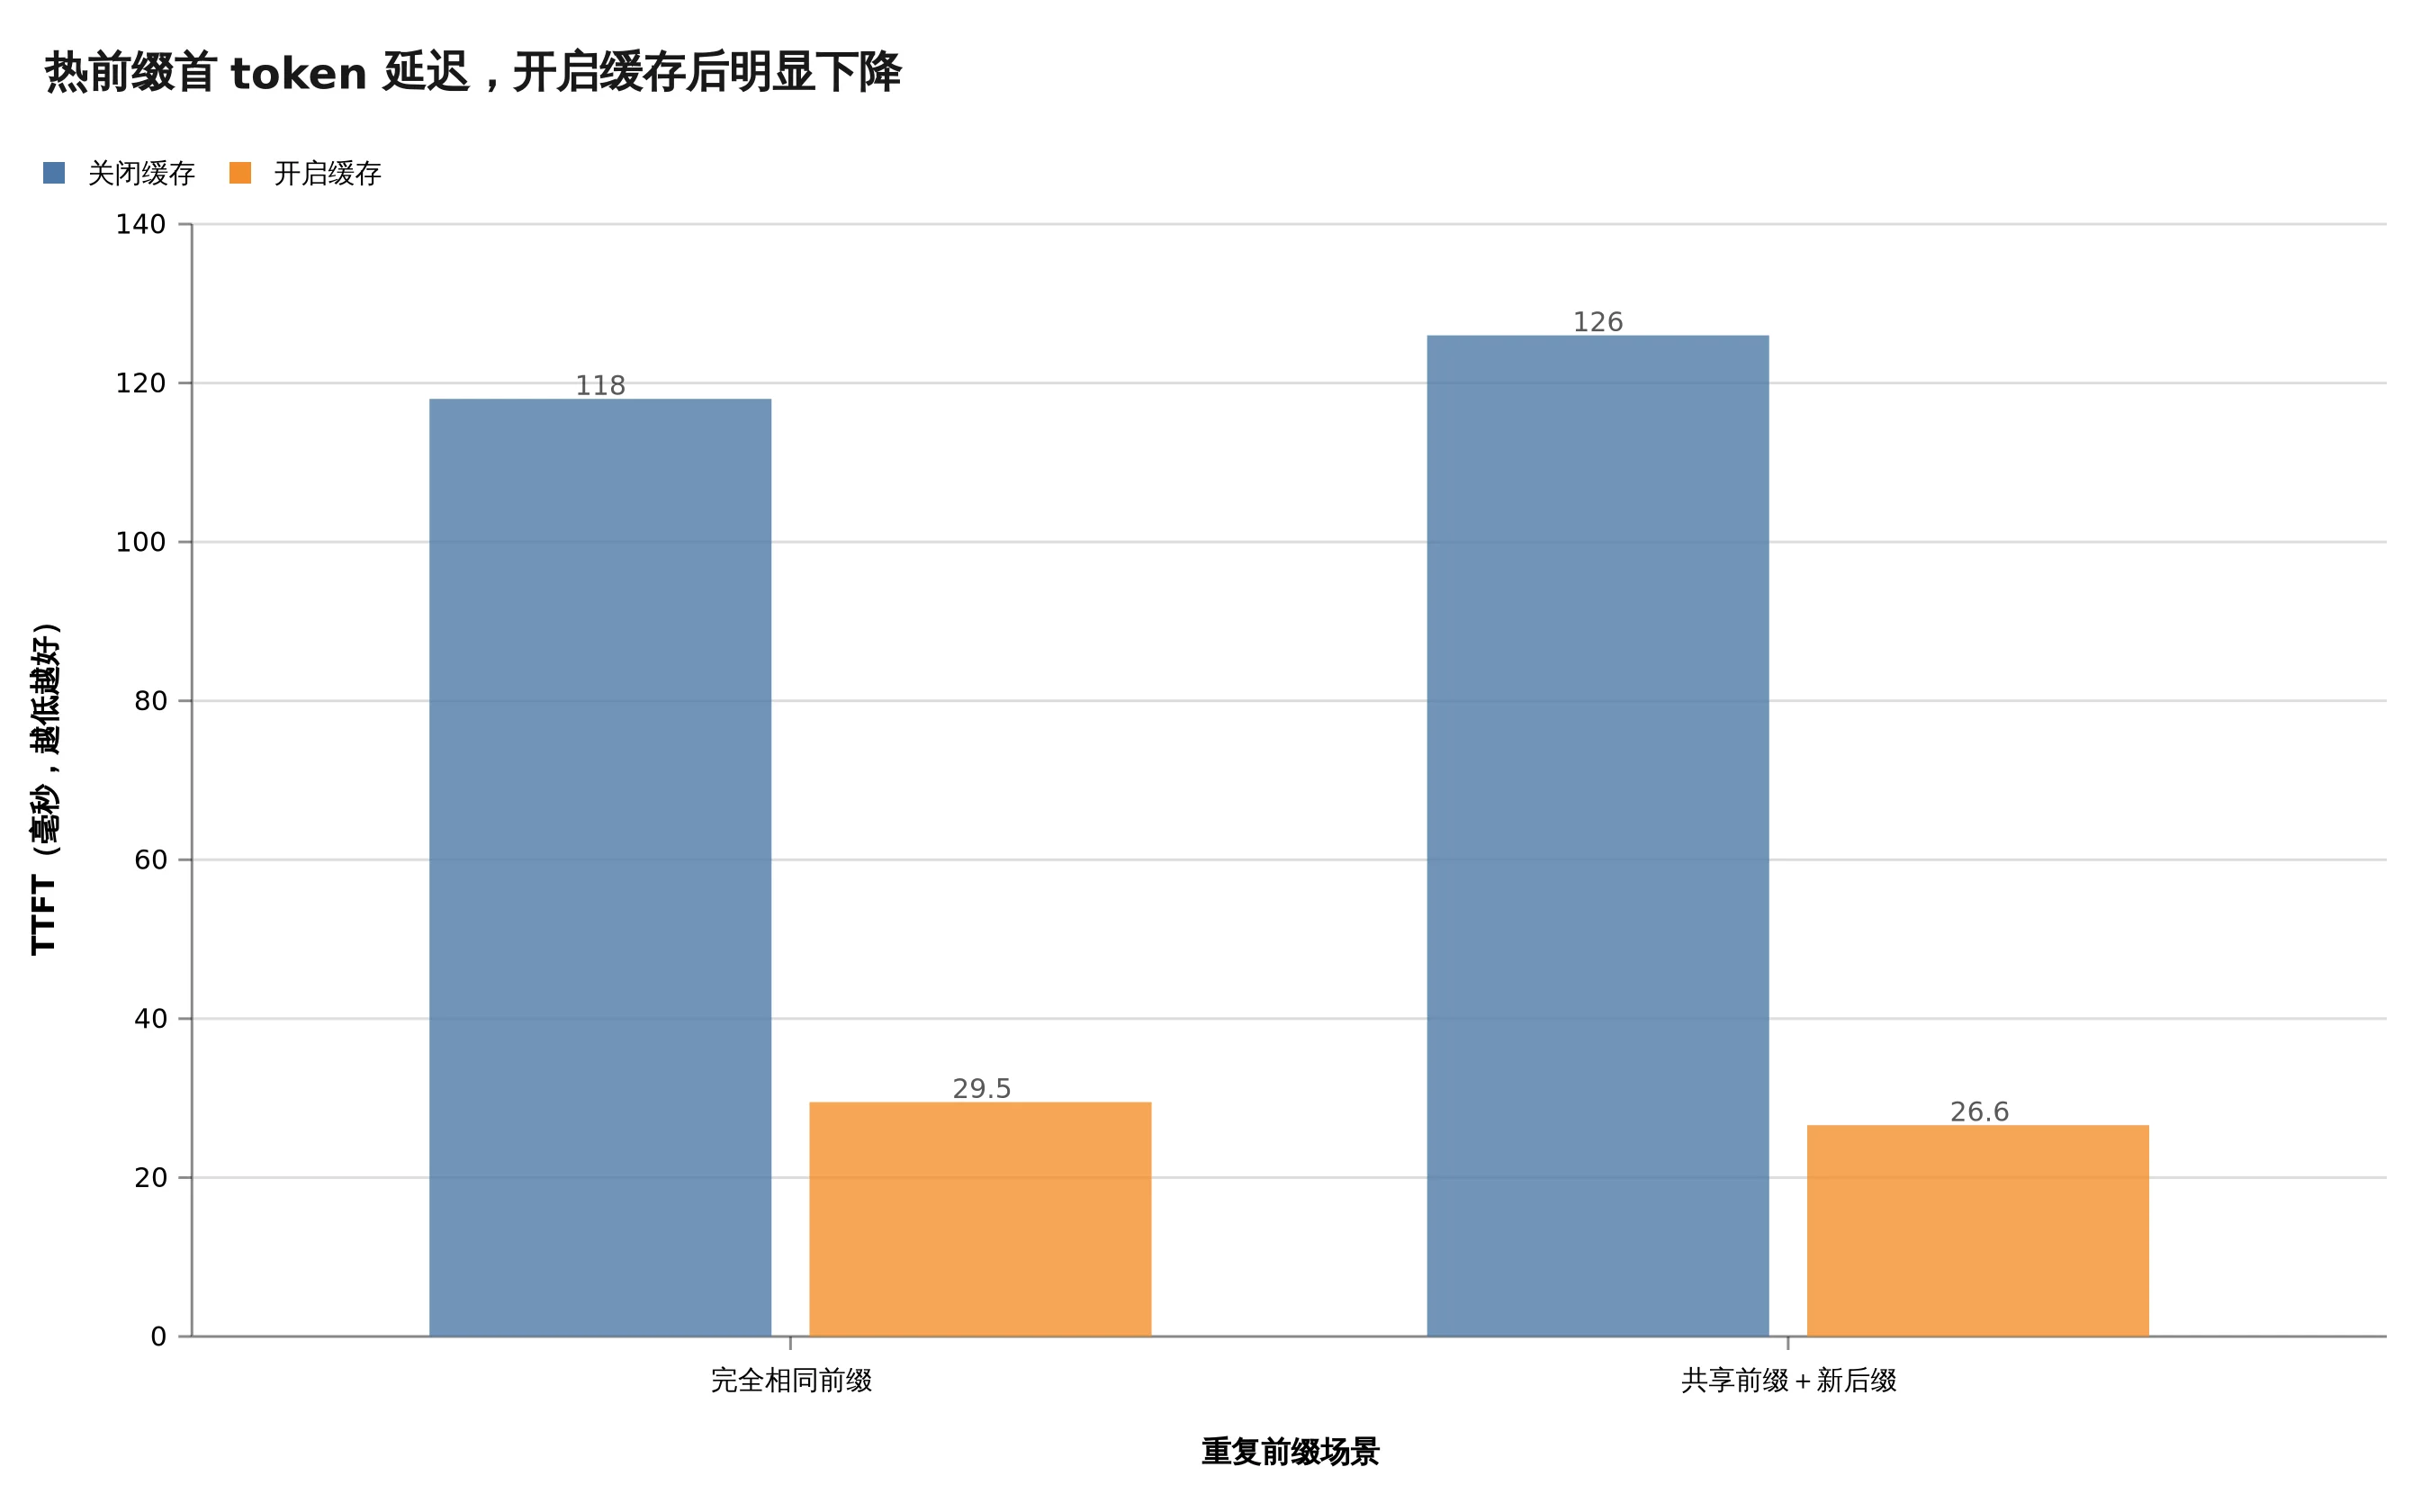
这正是编码 Agent 喜欢的负载。系统提示和仓库说明大段相同,后面只追加一小段新消息,缓存命中能省掉很多重复劳动。
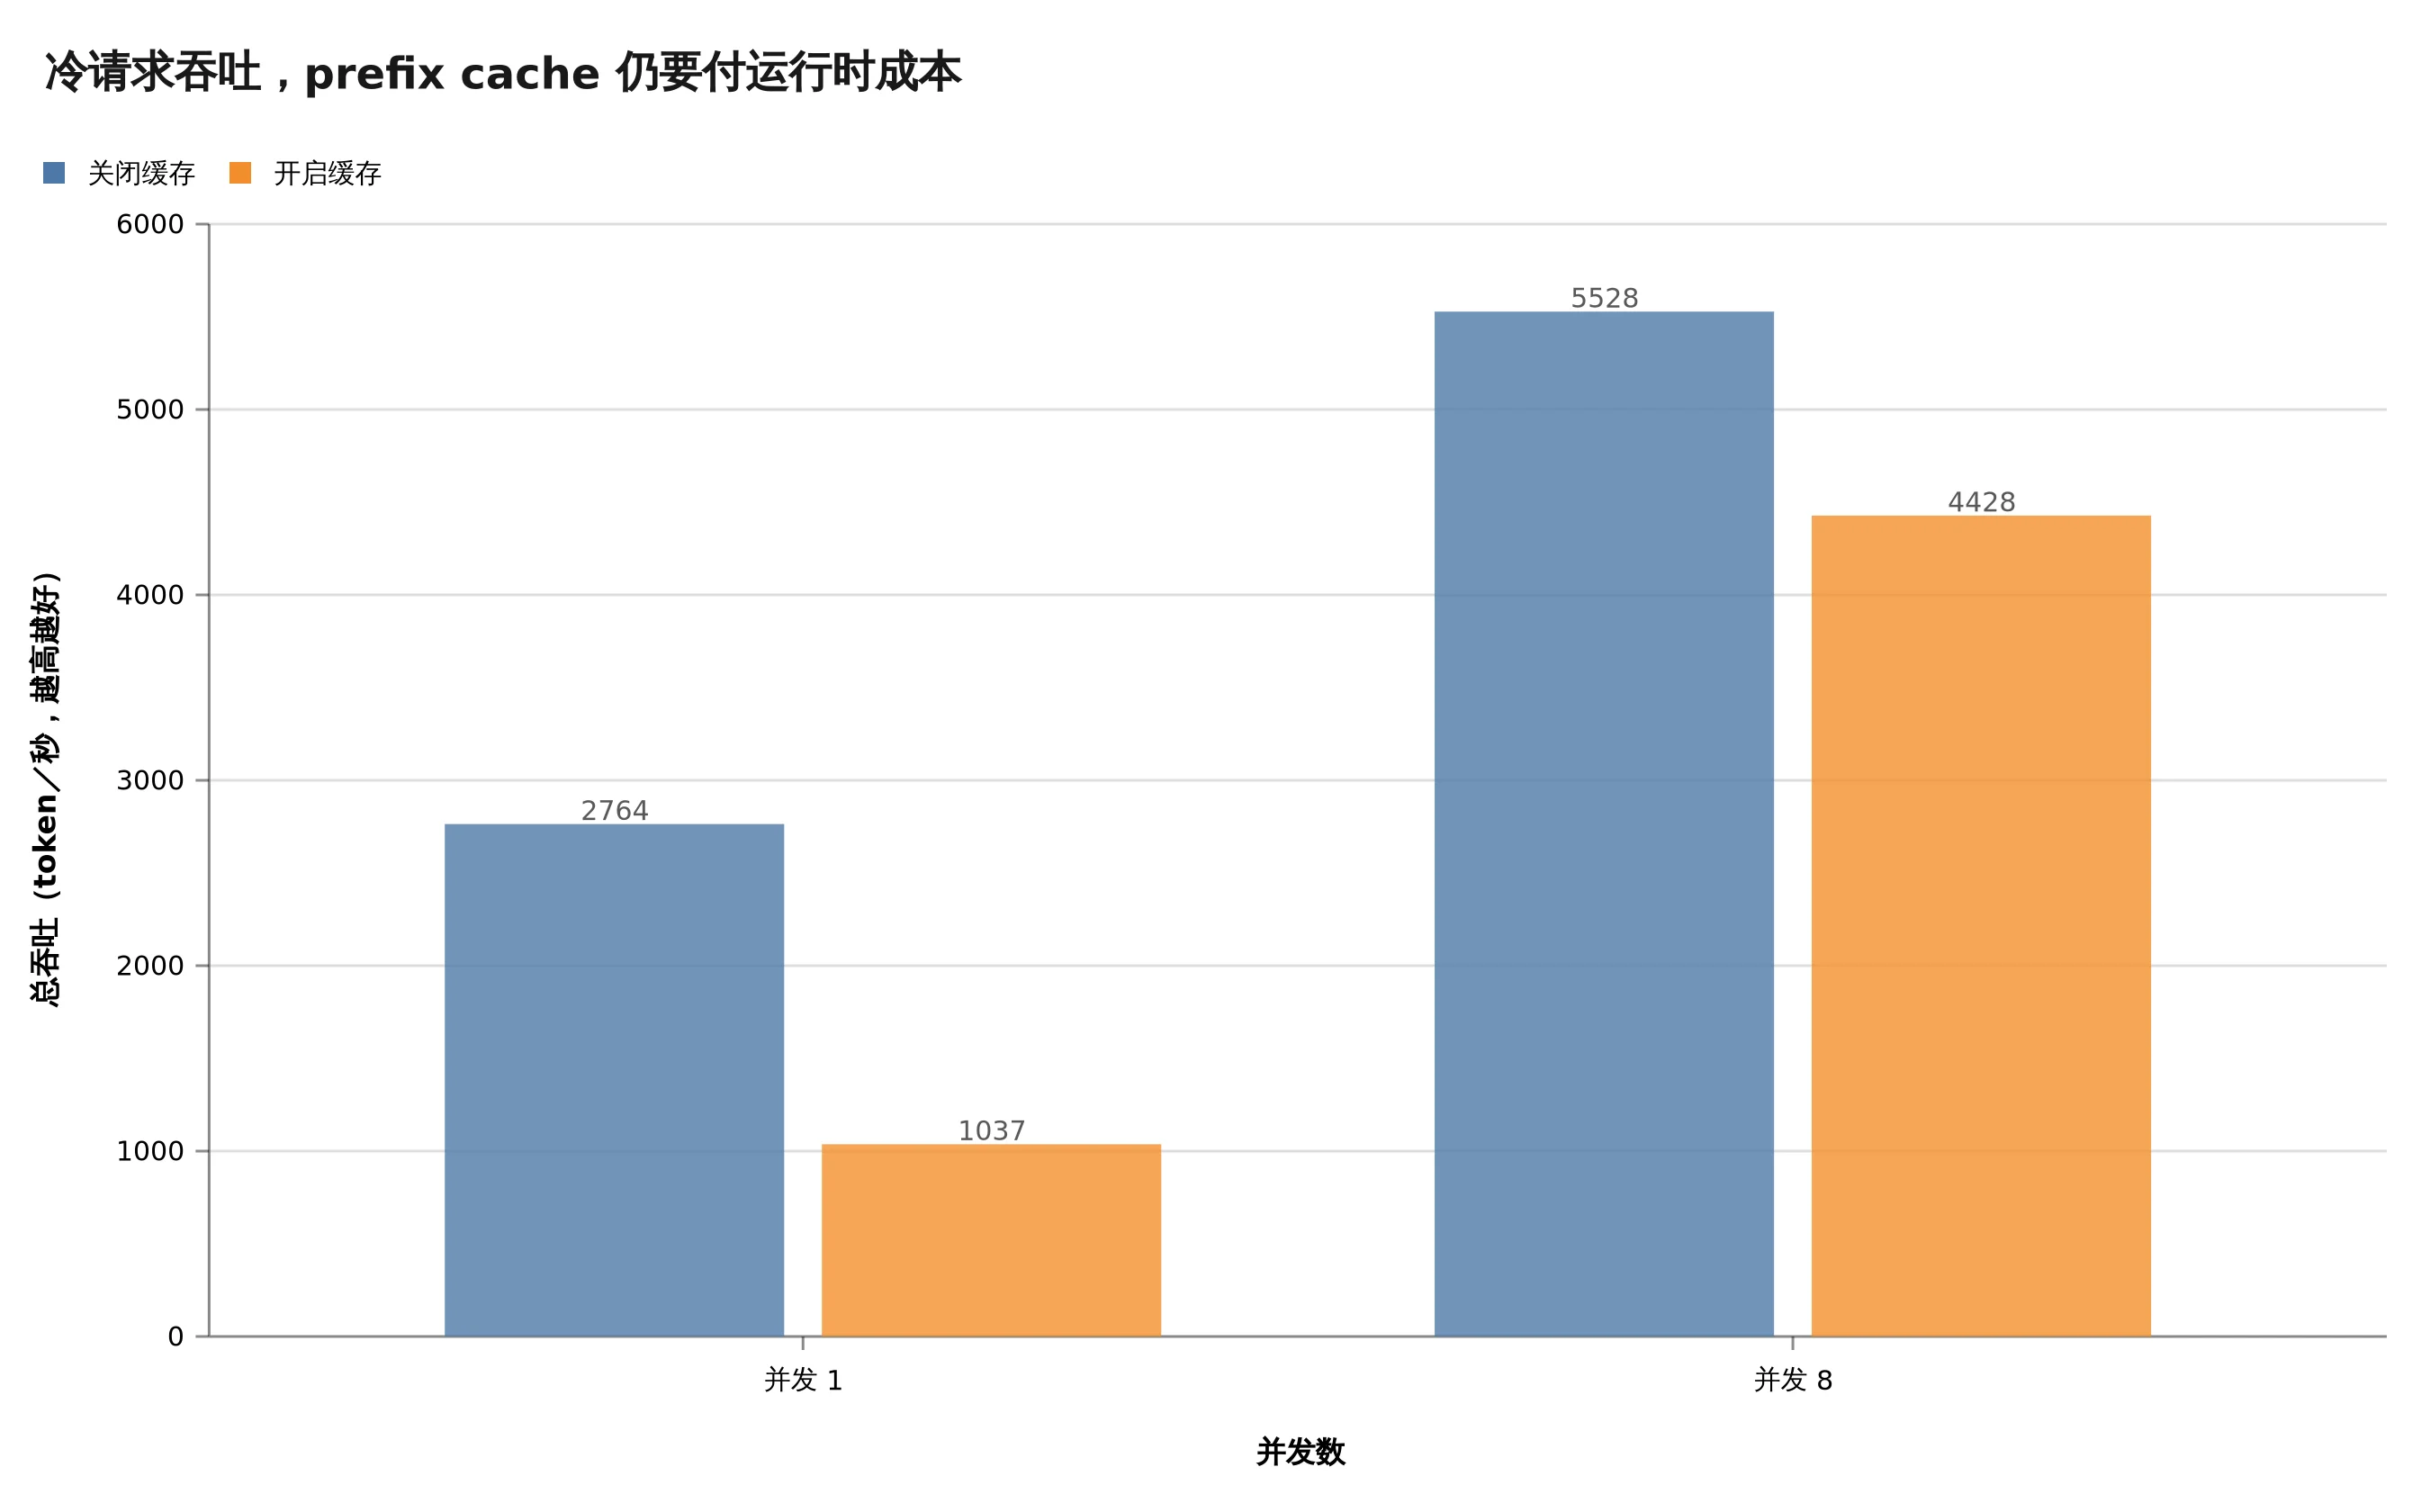
可同一个 PR 也写了冷请求的代价。没有共享前缀、并发为 1 时,开启缓存后的吞吐只有关闭时的 0.38 倍。并发到 8,才回到 0.80 倍。原因指向 MLX worker 的循环状态池增长路径,而不是 prefix cache 这个概念天然就慢。
热流量大赚,冷流量可能倒贴。
这组数据比一句「支持 prefix cache」值钱。功能表上的勾只告诉你代码路径存在,负载测试才告诉你什么时候该开。
更关键的是,PR #584 明确写着,混合 GDN 的 prefix cache 目前不能和 speculative decoding 一起用,因为跨状态块的草稿回滚还没实现。原帖争论最凶的地方也在这里。有人拿另一套运行时的短基准反驳,有人贴 MTP 翻倍的数据,讨论来回几轮,问题仍然回到同一处,32K、64K、128K 上下文里,两项优化能不能同时工作,缓存命中和冷启动各自付多少代价。
这才是有价值的争论。
8 月 15 日,vLLM Metal 的 PR #611 又把一步前瞻 decode pipeline 默认打开。在 M1 Ultra 上,Qwen3.8-27B 从 22.3 提升到 25.3 tok/s。这是好进展,但项目自己的 Qwen3.8 支持说明 也提醒,测试用的 8-bit 转换含文本权重,却没有 vision 和 MTP tensors。
能跑起来,decode 也更快了,模型训练时带的加速头仍没完整落地。
你看,拼图就在这里。
我会怎样选一套能干活的运行时
如果你只是偶尔和本地模型聊几句,选择没必要这么重。装得下、输出质量过关、风扇别起飞,已经够用。
如果要跑 Claude Code、Codex 这一类长会话工作流的本地替代,或者给团队架一个多用户推理服务,我自己的建议是先别下载五个框架。拿一段接近真实工作的固定会话,当成你的验收样本。
开局放进系统提示、工具描述和一批代码文件,让上下文先到 16K 或 32K。连续追问十轮,每轮只追加少量内容。记录首 token 等了多久,再记录整轮完成花了多久。光看生成阶段的 tok/s 不够,TTFT 和 E2E,也就是端到端时间,才接近坐在编辑器前的体感。
接着把同一段前缀跑两遍。第二遍如果几乎没有变快,prefix cache 可能没开,也可能对这个模型架构没有真正命中。别只信启动日志里那行 enabled,去看运行时的 cache hit 指标,或者至少比较冷启动与热启动的首 token 延迟。
然后把上下文从 8K 拉到 32K,再到 64K。短上下文 30 tok/s,长上下文首 token 等半分钟,这套配置就不适合 Agent。原帖里那句抱怨很准确,真实长会话会把框架的缺口放大,而不是把峰值跑分复读一遍。
再往后才是 speculative decoding。检查它用的是模型自带 MTP,还是另一个 draft model。前者要确认转换后的权重仍在,后者要把额外内存也算进去。启用后别只跑一句问候,至少用你的代码仓库测接受率、速度和输出一致性。MTP 在稠密 27B 上能有明显收益,在激活参数很少、基础 decode 已经很快的 MoE 上,额外验证成本可能把收益吃掉。PR #990 的公开测试已经展示了这种差异。
还有一个很笨但很好用的检查,列出你真正需要的能力组合,再去看它们能不能一起开。不是问项目分别支不支持 prefix cache、MTP、continuous batching 和长上下文,而是问这四个东西在你的模型上能不能同时启用,失败时有没有明确报错,还是会悄悄退回慢路径。
坦率讲,这套验收不酷。没有一张峰值截图那么适合发社交媒体。
但它能替你省下两天折腾。
少造一个框架,也许更快
原帖有个带情绪的建议,别再为每个缺口新造一个框架,把力气集中到一两个能收敛的项目上。
我觉得方向是对的。
本地推理现在最稀缺的,不是又一个漂亮 Web UI,也不是把同一套 MLX 调用再包一层 OpenAI 兼容接口。真正难的是模型转换不丢权重,缓存和循环状态能正确回滚,调度器知道冷热请求的代价,测试覆盖长上下文、多轮复用和并发。这些工作没那么容易做成三十秒演示,却决定了系统能不能在第三十轮对话里继续干活。
Apple Silicon 的优势还在。统一内存能让一台笔记本装下很多消费级显卡装不下的模型,MLX 也在持续把硬件能力往上抬。问题不该被简化成 Mac 行不行,而该问我们有没有把一块好硬件变成一套稳定的推理系统。
当前答案大概是,已经有点子牛逼了,但还没收工。
所以屏幕前的你如果正准备为本地 Agent 买一台大内存 Mac,别只问能跑多少 tok/s。问问 prefix cache 命中了吗,长上下文的 TTFT 怎么变,MTP 权重还在吗,需要的优化能一起开吗。
峰值速度是一阵风。
能把同一条长航线稳定跑完,才算一艘船。