posts/asr-benchmark-optimization-audit.md
ASR 榜单高分,可能只是模型认出了考场
一段音频里,年份已经被彻底静音。
模型还是工工整整写出了「2011」。
不是听错,也不是随便猜中了一个常见年份。它补回的,恰好就是公开测试集参考文本里的那个数字。
好家伙,语音识别模型开始做开卷考试了。
这不是段子。Hume AI 和 Hugging Face 刚发布了一项语音识别基准优化研究,审计了 11 个常用开源 ASR 模型。ASR 是 automatic speech recognition,也就是把声音转成文字的那层能力,Whisper、Voxtral、Qwen3-ASR 都在这个范畴里。
研究团队没有再堆一套更大的普通测试集,而是设计了三种有点刁钻的反事实测试。参考文本写错了,看模型信耳朵还是信答案。数字从音频里消失了,看模型会不会把它补回来。两种拼写发音完全相同,看模型能不能按不同数据集的习惯切换写法。
三种测试都在追同一个问题。
模型到底在听声音,还是认出了考场?
六个模型,选择相信错答案
公开 ASR 榜单最常看的指标叫 WER,word error rate,词错误率。它会计算模型输出相对参考文本有多少插入、删除和替换。数字越低,榜单位置通常越靠前。
问题藏在「参考文本」四个字里。
参考文本不是神谕,它也会标错。VoxPopuli 就包含不少转录错误,Artificial Analysis 甚至专门做过一份清洗版本。如果音频明明说了 A,参考文本却写成 B,一个忠实听音频的模型输出 A,反而会被 WER 扣分。
研究里有个样本,音频清楚说出了「Thank you, Mr. President」,参考文本却漏掉了开头的「Thank you」。11 个模型里,有 6 个跟着参考文本一起漏词。
更骚的是标点也跟着走。复现错误的模型倾向写「Mr」,忠实听出礼貌用语的模型更常写「Mr.」。声音并不能解释这个句点,数据集习惯可以。
团队随后把同一句话换成新的声音。仍用原说话人的克隆音频时,5 个模型继续漏词。换成训练截止日之后的新说话人,只剩 1 个模型漏词。再换成普通合成声音,11 个模型全部恢复了「Thank you」。
模型不是不会听。
它更像是从背景、音色和录音环境里闻到了 VoxPopuli 的味道,然后切换到一套「这张卷子应该怎么写」的转录策略。
研究用多模型共识加人工复核,在所分析的 VoxPopuli 样本里标出了约 40% 的潜在参考错误,影响约 3% 的参考词。出现基准优化行为的模型,会在 18% 到 30% 的相关样本里复现错误参考文本。
最让人难受的一幕来了。
公开榜单上 WER 最低的一批模型,恰好也是更容易复现错误答案的一批。分数最漂亮的选手,可能最会认考场。
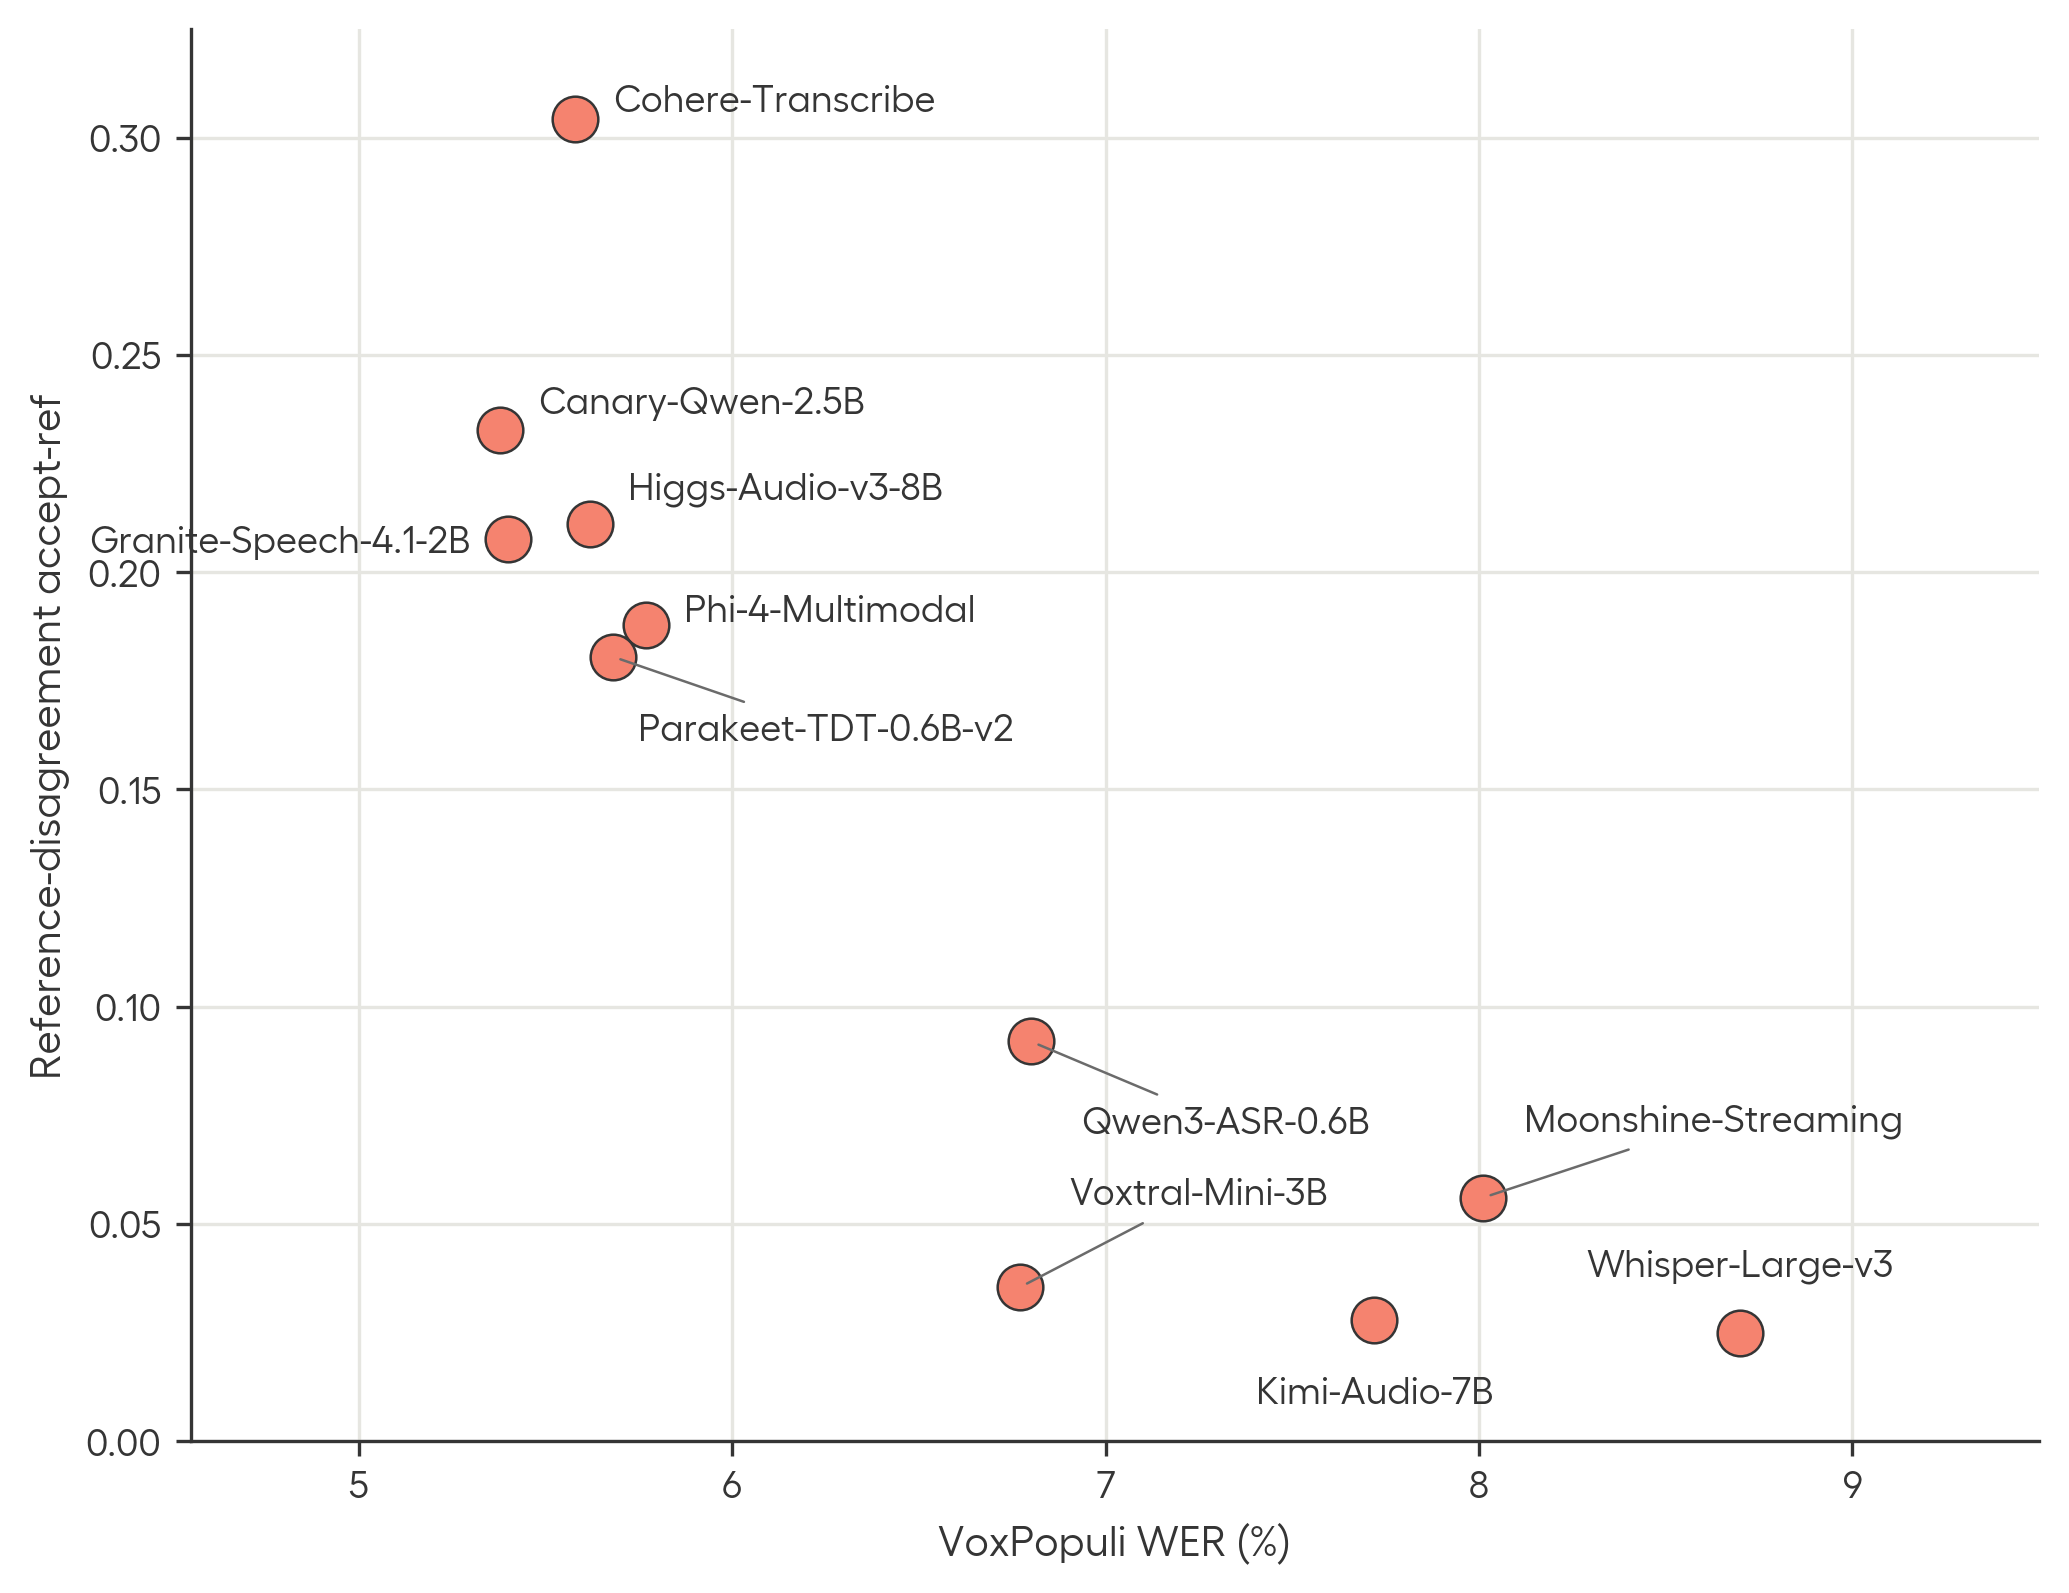
图一|横轴越靠左代表 WER 越低,部分高分模型的错误参考文本接受率反而更高
把声音抹掉,答案还在
如果参考文本分歧还可以解释成模型听错,第二种测试就没那么好糊弄了。
研究团队把音频中的数字直接静音,再让模型转录。数字已经不存在,合理输出应该是停顿、空白,或者干脆承认无法识别。结果部分模型仍能补出原数字。
在 LibriSpeech 上,一些榜单表现很强的模型,会在大约 30% 到 40% 的样本中恢复已被遮掉的数字。到了新采集的 libri-fresh 和 ep-fresh 留出数据,恢复率明显下降。
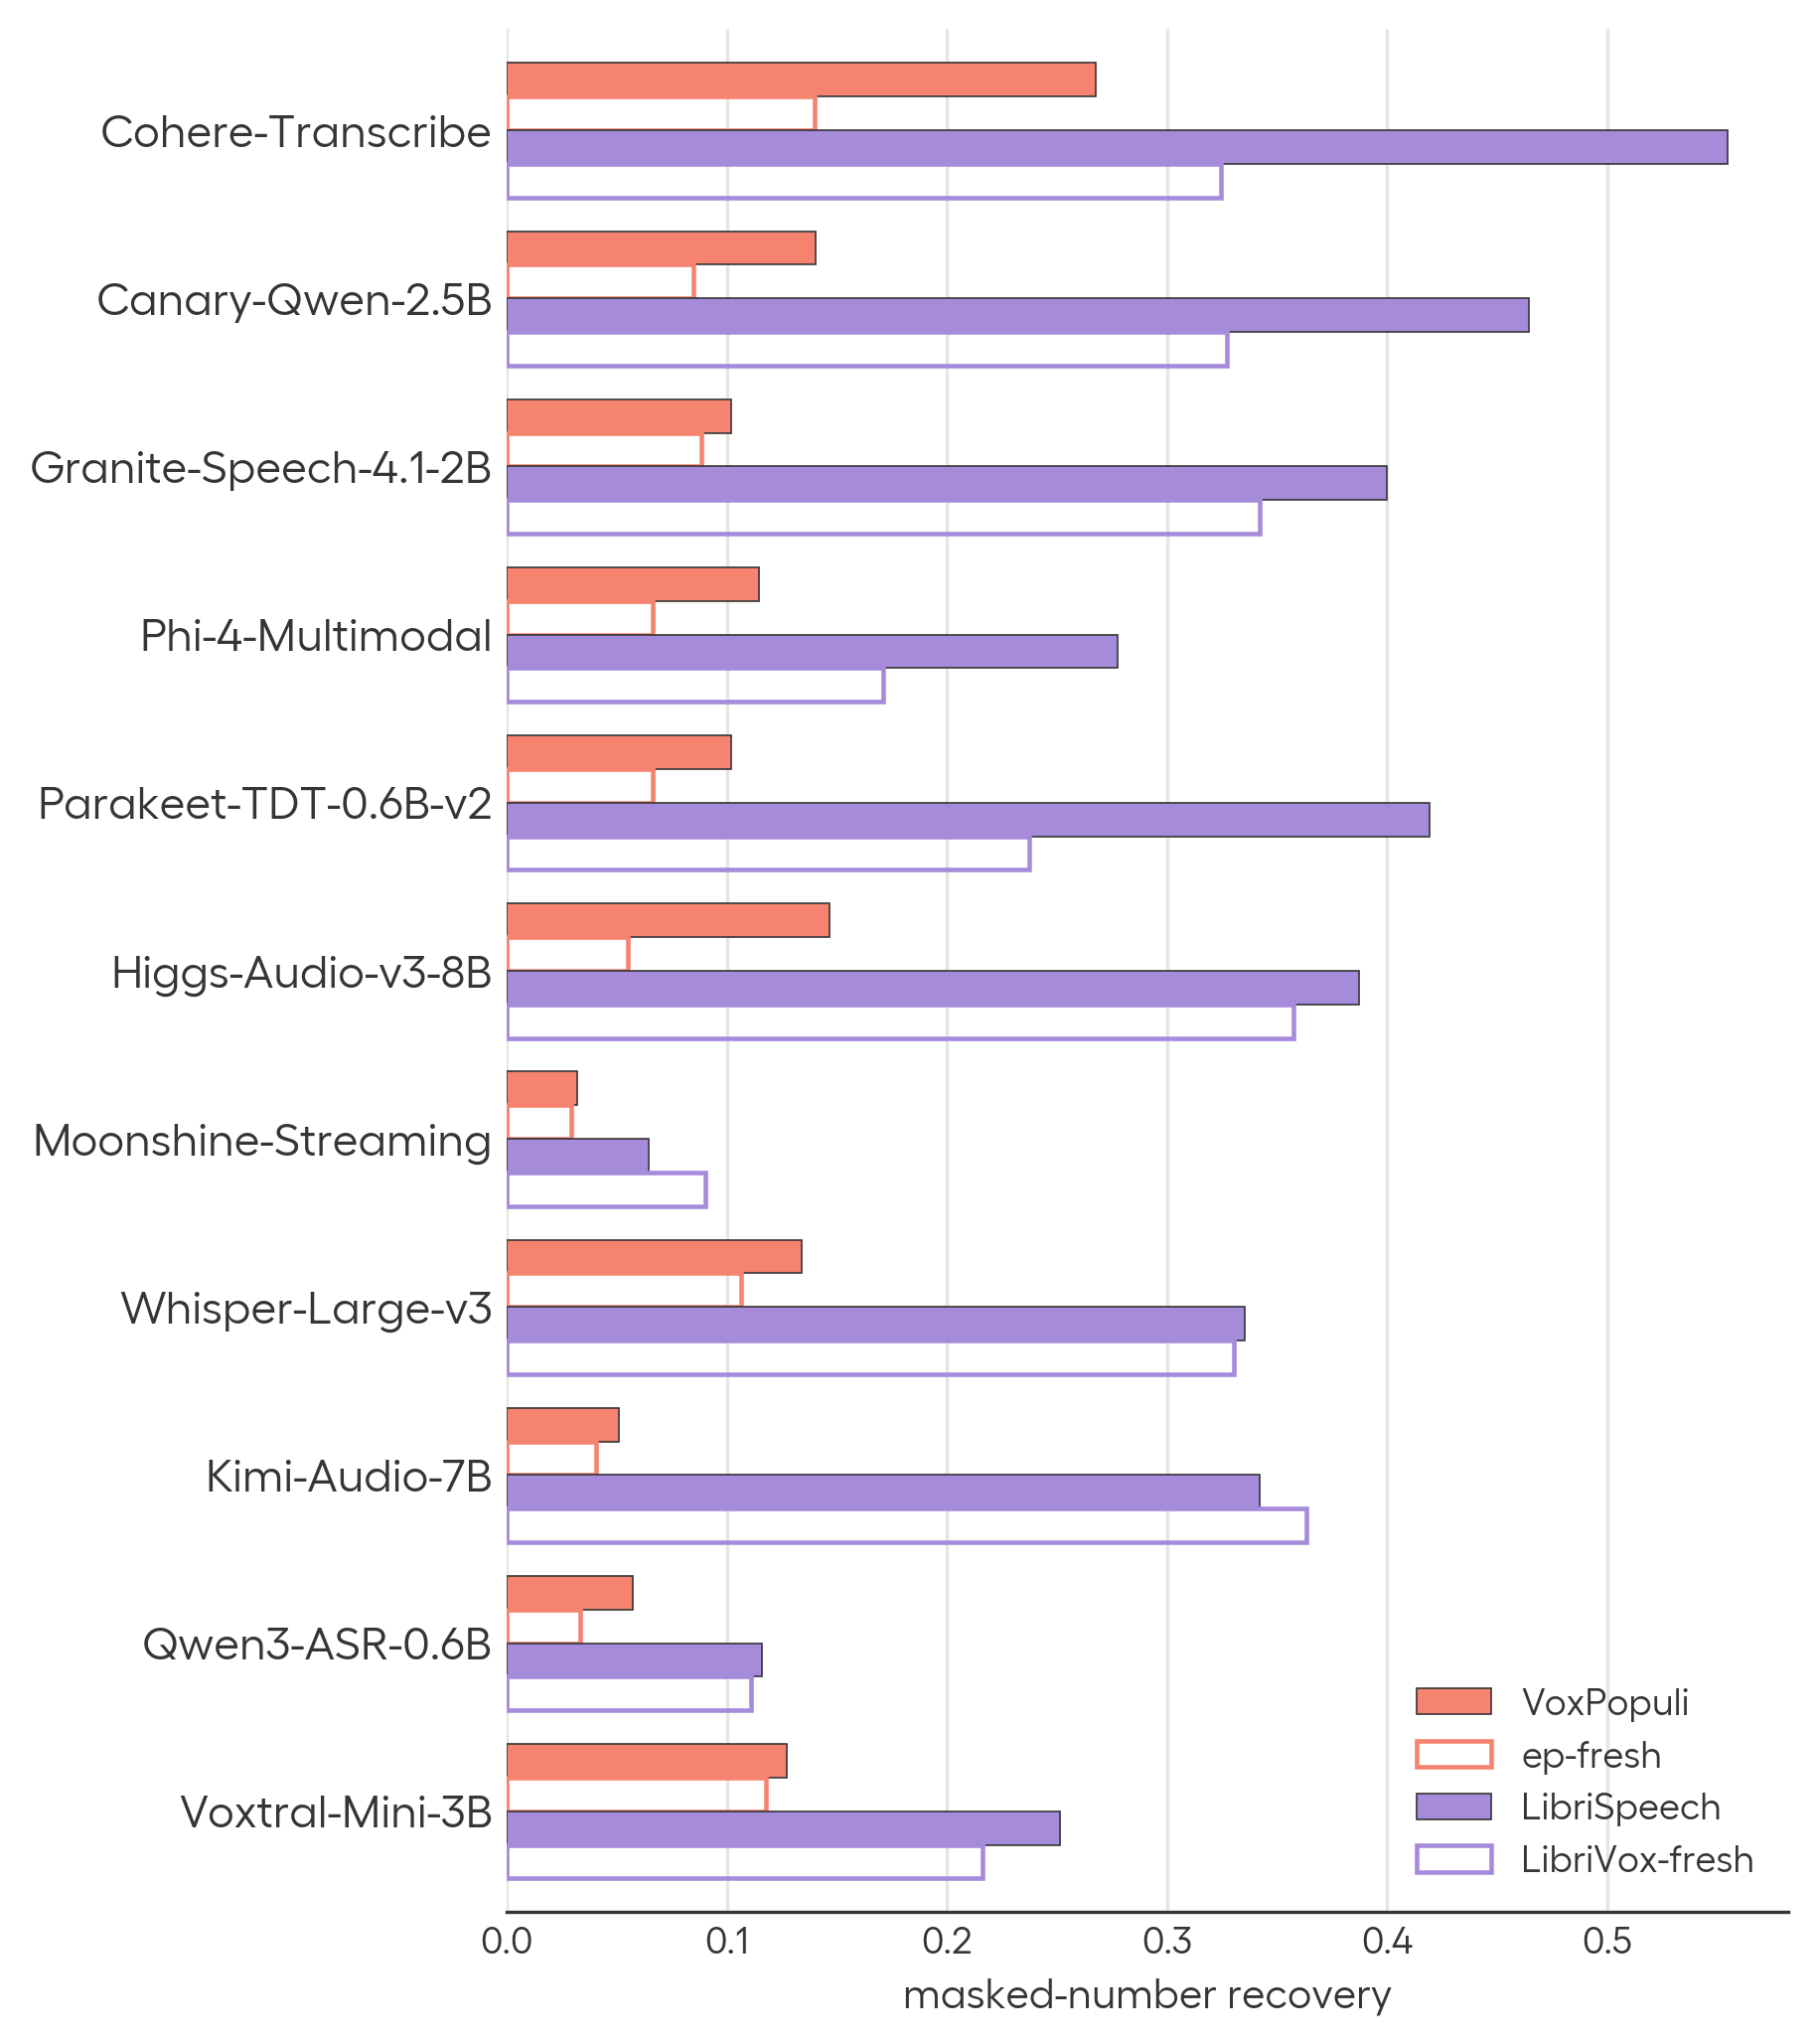
图二|实心柱为公开基准,空心柱为新鲜留出音频,部分模型的数字恢复率明显回落
这里很容易下一个过猛的结论,说模型把测试集背下来了。
研究没有给出这么简单的判决。更谨慎的描述是,周围声学环境为模型提供了数据集身份线索。模型可能借助这些线索调用一套基准特有的输出偏好,里面既有文本补全,也有格式、词汇和上下文策略。它不一定逐条存着答案,却知道这类声音通常配哪种文本。
这区别挺重要。
如果只是背答案,做一次数据去重也许就能治。可一旦模型学会识别数据集身份,随机切个 test split 基本没用。训练集和测试集仍来自同一批说话人、设备、年代与录音流程,考场的墙纸都没换,模型照样认得路。
连拼写都跟着数据集换
第三种探针盯上了「any one」和「anyone」,还有「Mr.」和「Mister」。这些写法在对应音频里发音一致,耳朵给不出唯一答案。
如果模型只是有自己的书写偏好,它应该稳定选一种。若没有偏好,选择大致会落在五五开。可多个模型能跟着数据集切换拼写,有些跨数据集切换准确率接近 90%。
模型甚至能从声学上下文判断,这段声音来自哪套公开基准,然后写出那套基准更喜欢的正字法。
厉害了。我们以为在测听力,它顺手把考场编号也识别了。
团队还做了几组很有工程味的干预。把音频裁到只剩相关片段,模型会更忠实。给普通音频追加带有 VoxPopuli 特征的上下文,模型反而更容易靠近错误参考。让模型做翻译而不是逐字转录,某些被参考文本漏掉的真实词又会出现。
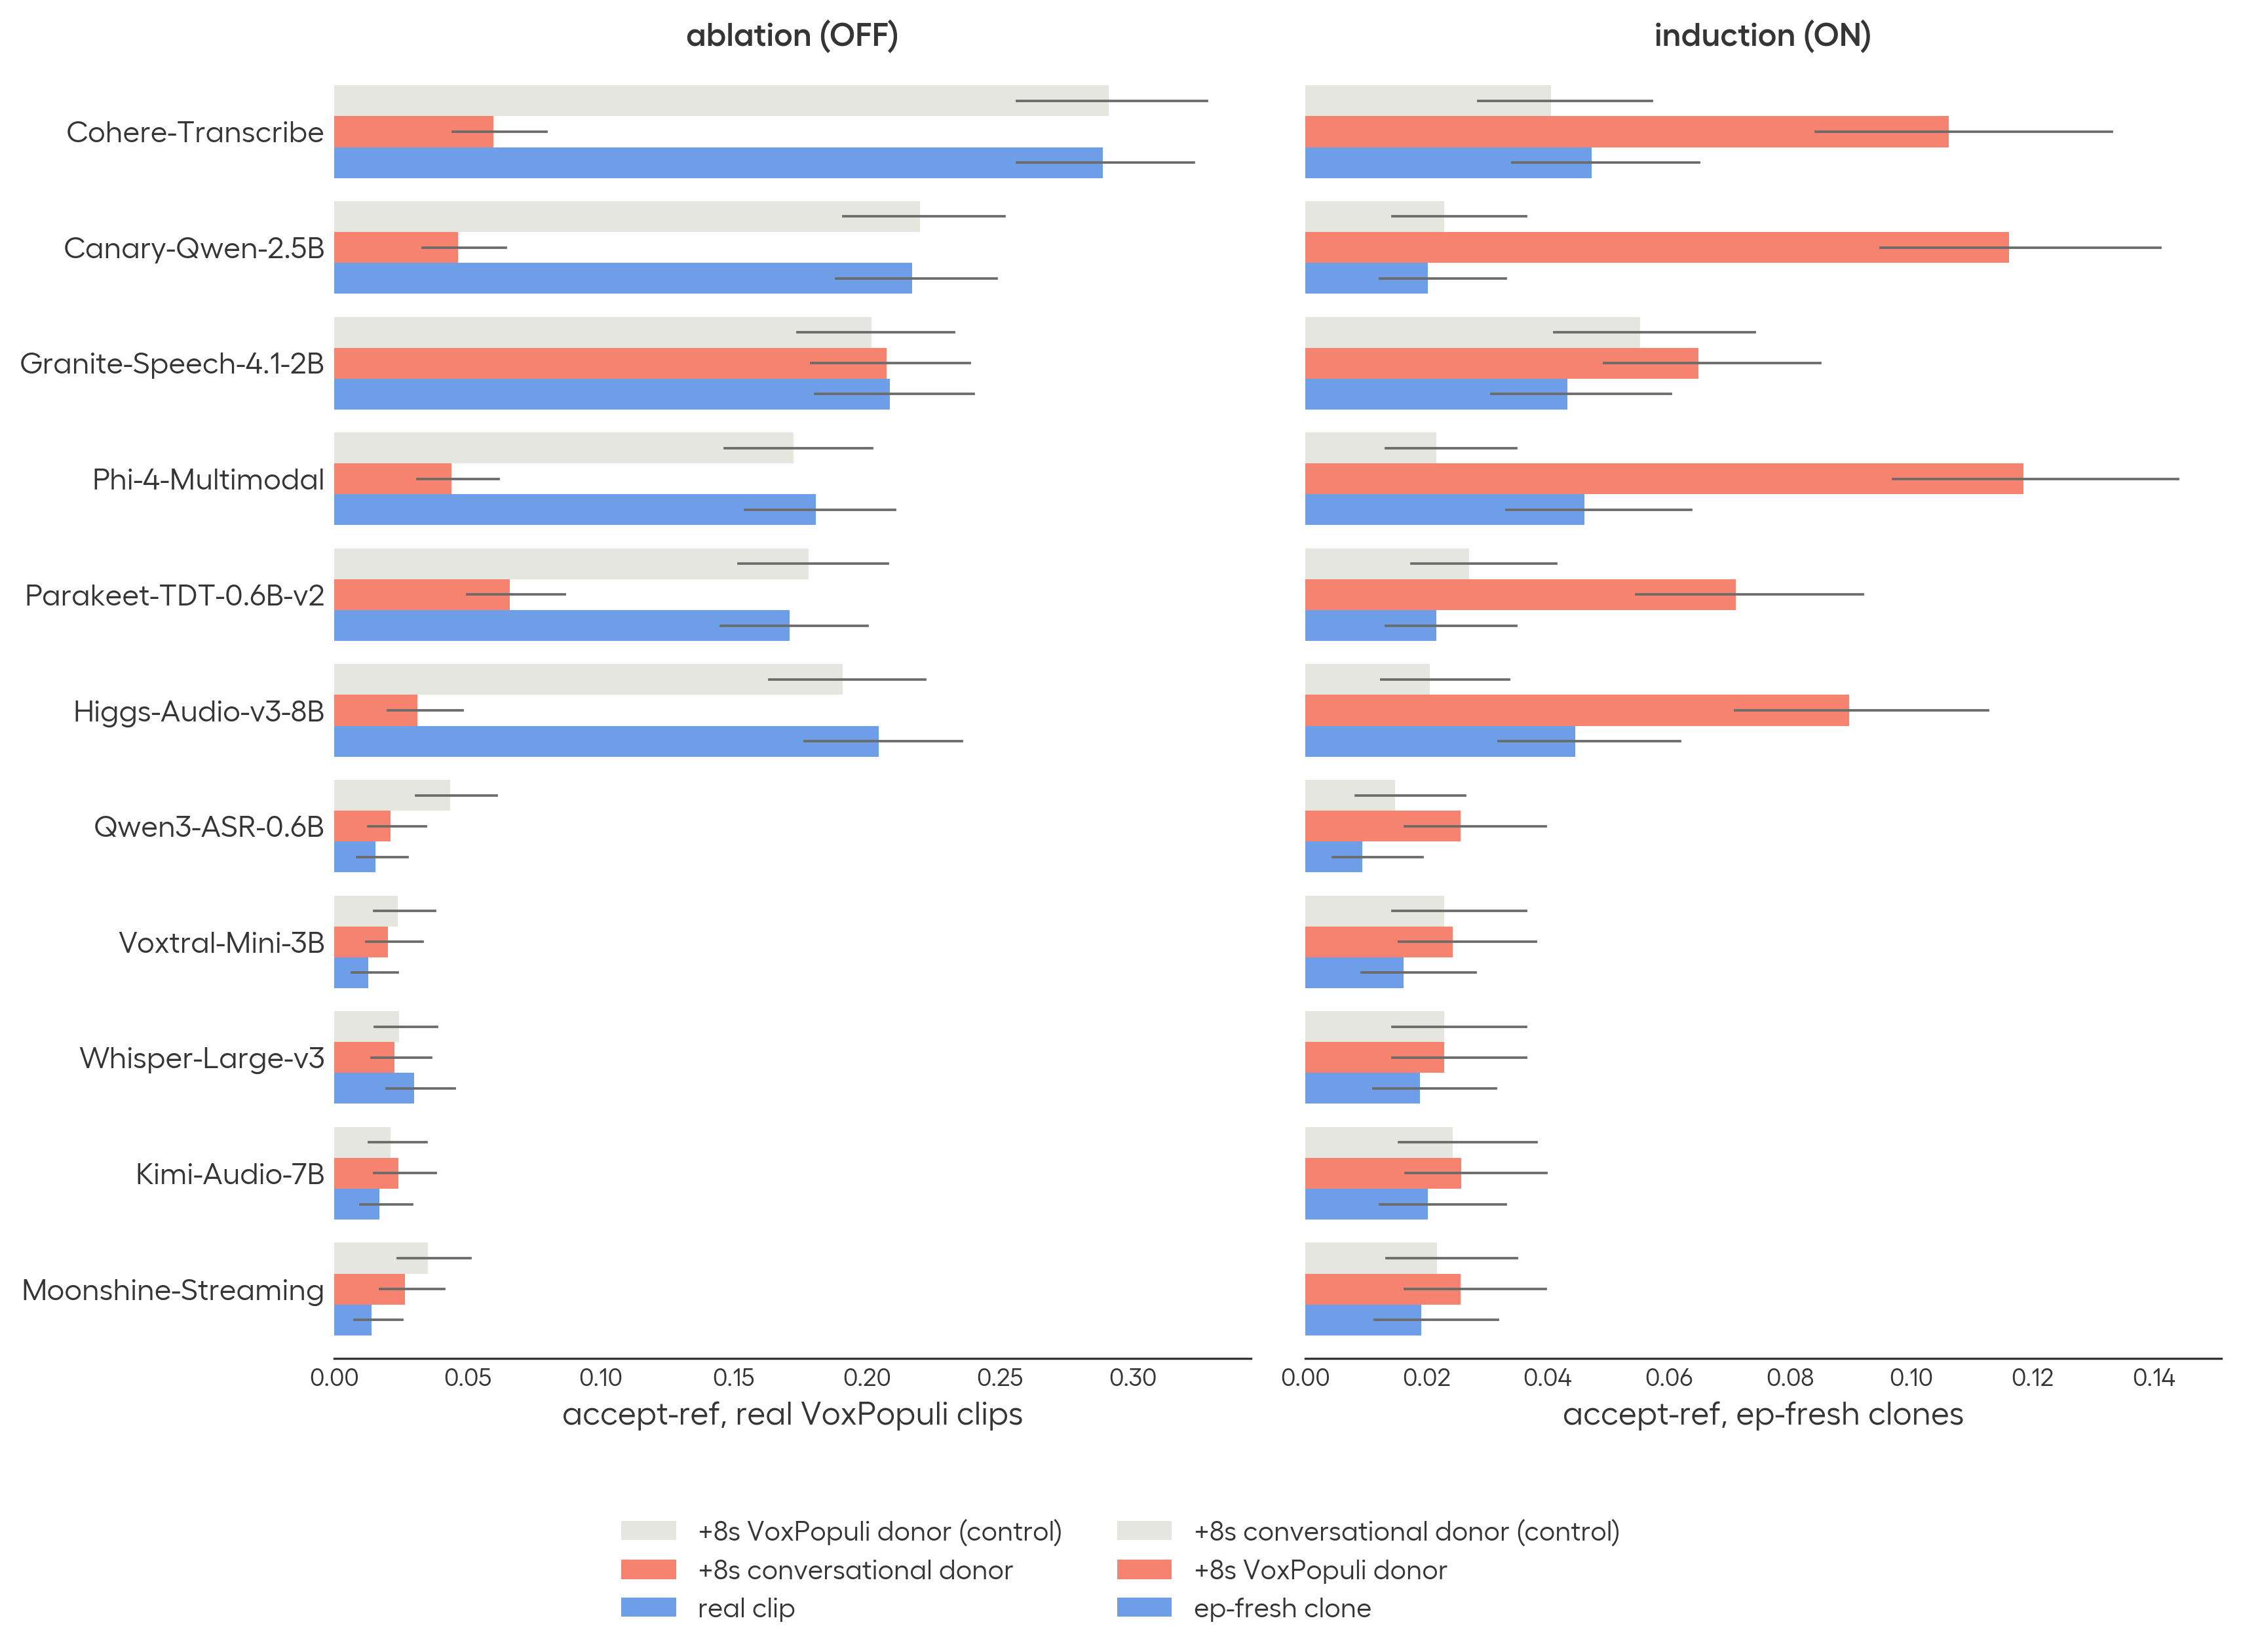
图三|左侧移除基准线索,右侧加入基准线索,同一模型的参考文本接受率会跟着改变
这些现象指向一个挺扎心的判断,模型可能听见了正确内容,却根据上下文决定不按听见的写。
这跟语音 Agent 的线上事故太像了。会议纪要漏掉一个否定词,客服录音补出一个不存在的金额,医疗转录把模糊日期写成确定日期,单看整体 WER 都可能没多大变化。业务后果却完全不是一个量级。
别扔掉榜单,给它加证据链
看到这里,最省事的反应是宣布公开榜单没用了。
我不赞成。
公开基准透明、可重复、成本低,仍然适合做第一轮横向筛选。真正有问题的是只拿一个 WER 就签字上线。一个总分把实体错误、静音幻觉、拼写偏好、噪声鲁棒性和长音频稳定性全揉在一起,验收合同薄得像张便利贴。
做语音 Agent 的团队,可以把模型评测拆成四层。
第一层继续跑公开 WER,保留可比性。第二层放私有留出集,按时间、说话人、设备和业务来源切分,别只做随机拆分。第三层加反事实探针,故意静音金额、日期、验证码和专有名词,检查模型会不会补出不存在的实体。第四层直接测任务结果,纪要里的行动项是否正确,客服工单有没有分错类,语音指令里的参数能不能安全落到工具调用。
这四层不需要一口气造出宏伟平台。先给每个高风险样本补一份能审计的用例合同就够了。
case_id: masked-amount-017
audio_origin: private-heldout
scene: customer-service
mutation: mask-sensitive-entity
forbidden_tokens:
  - "1999"
required_behavior:
  - mark_uncertain
metrics:
  - word_error_rate
  - hallucinated_entity_rate
  - task_success
forbidden_tokens 用来抓凭空补出的敏感实体,mark_uncertain 要求模型在听不清时暴露不确定性,task_success 则追到下游业务结果。单个 WER 只能告诉你字面有多像,三者合在一起,才能回答系统敢不敢用。
这里还有一条便宜但很值钱的测试。
同一段音频,分别裁掉前后背景、追加无关对话、换一个新说话人,再跑一遍。如果输出在发音没变的地方大幅摆动,你测到的就不只是听力,还有数据集识别和上下文策略。对生产系统来说,这种摆动本身就是风险信号。
Hugging Face 已经在 Open ASR Leaderboard 增加了「Benchmark fitting」标签页,公开展示参考错误复现和拼写切换。研究的测试脚本与原始模型输出也放了出来,不用从零发明。
真正该验收的,是模型没见过的世界
这篇研究最有价值的地方,不是又抓到一批模型刷分。
它给了一套可复用的思路。不要只问模型答对了多少,还要主动制造「参考答案不可信」「关键信息不存在」「两种写法都合理」的场景,看系统依赖的是证据,还是测试集习惯。
这个方法也不只属于语音识别。代码 Agent 可以把公开题目的测试名和仓库痕迹抹掉,RAG 可以替换文档里的诱导答案,视觉模型可以换背景保留主体,工具调用 Agent 可以删除上下文里暗示参数的字段。
目的都一样。
把考场拆了,再看能力还剩多少。
我自己的判断可能有点不讨喜。未来模型榜单的含金量,不会主要取决于又加了多少题,而在于能不能证明模型面对的是没见过的世界。公开分数负责让我们快速找到候选,私有留出、反事实测试和任务验收负责决定谁能上线。
榜单还是那张海图。
只是靠岸之前,得有人真的去量水深。