
ChatGPT 与 Gemini 都到 10 亿,模型反而没那么重要了
两个十亿用的是两只钟。ChatGPT 看周活,Gemini 看月活。数字背后更值得盯的是默认入口、工作状态和你能不能带着自己的上下文离开。
昨晚,AI 圈同时亮起了两个十亿计数器。
Google 宣布 Gemini App 月活超过 10 亿,称它是公司历史上增长最快的产品。OpenAI 几天前的采用报告则写下,全球已有超过 10 亿人把 ChatGPT 用进工作和生活。
好家伙,两家同时摸到十亿,标题看起来像终于跑到了同一条终点线。
先别急。
The Verge 的报道补了一句很要命的口径说明。Gemini 的十亿是月活,ChatGPT 不但早已跨过十亿月活,还在今年 7 月跨过了十亿周活。
两块牌子都写着十亿,背后挂着两只不同的钟。
月活统计过去一个月来过的人,周活统计过去一周来过的人。后者通常代表更高的使用频率,但没有 Gemini 的周活数据,也没有两家的统一去重规则,就不能拿这两个十亿直接宣布谁赢了。
这不是抬杠,是看增长数据最基本的工程习惯。先把窗口、对象、平台边界和去重方式对齐,再谈比较。不然就像一个接口报每分钟请求数,另一个接口报每天独立设备数,图画得再漂亮也只是两根各说各话的柱子。
可这件事真正有意思的地方,也不在谁多一亿。
我自己的判断是,十亿用户之后,模型能力依然重要,却不再是决定普通人留在哪个平台的唯一变量。真正拉开距离的,正在变成三样看起来没那么性感的东西。
默认入口、工作状态,以及离开的成本。
第一只钟测频率,第二只钟测分发
先看增长曲线。
OpenAI 在今年 2 月披露,ChatGPT 当时有 9 亿周活。到 7 月变成 10 亿,五个月增加约 1 亿,增幅约 11%。对于一个已经长到这个体量的产品,这仍然很猛,只是速度显然不再是早期那种一脚油门翻倍。
Gemini 走的是另一条线。它在 2 月约有 7.5 亿月活,7 月底到了 9.5 亿,8 月再跨过 10 亿。半年增加约三分之一,追得很快。
厉害了,但这里仍然不能顺手写出 Gemini 很快就会超过 ChatGPT。
ChatGPT 的十亿周活说明它已经进入大量用户每周都会打开的节奏。OpenAI 的官方数据还提到,在工作场景里,人们使用 ChatGPT 完成任务或创造内容的概率,是非工作场景的两倍以上。写代码、改文档、做分析,这些不是偶尔问一句天气,而是会留下连续上下文的工作。
Gemini 的强项则是分发。Android 预装、Google 账户和既有产品面,把入口摩擦压得很低。Gemini 团队披露 iOS 端月活已经超过 1 亿,剩下的大头自然来自 Android。手机开机就在那里,和用户先去官网注册、再下载客户端,是两种完全不同的增长机器。
一个更像高频工作台,一个更像遍布设备的默认入口。
模型跑分当然会影响人们第一次下载谁,可当产品都进入十亿量级,决定下一次打开谁的,往往是图标离拇指有多近、上次的项目还在不在、公司权限有没有配好、同事能不能接着干。
模型负责把人吸引过来,系统负责让人明天还回来。
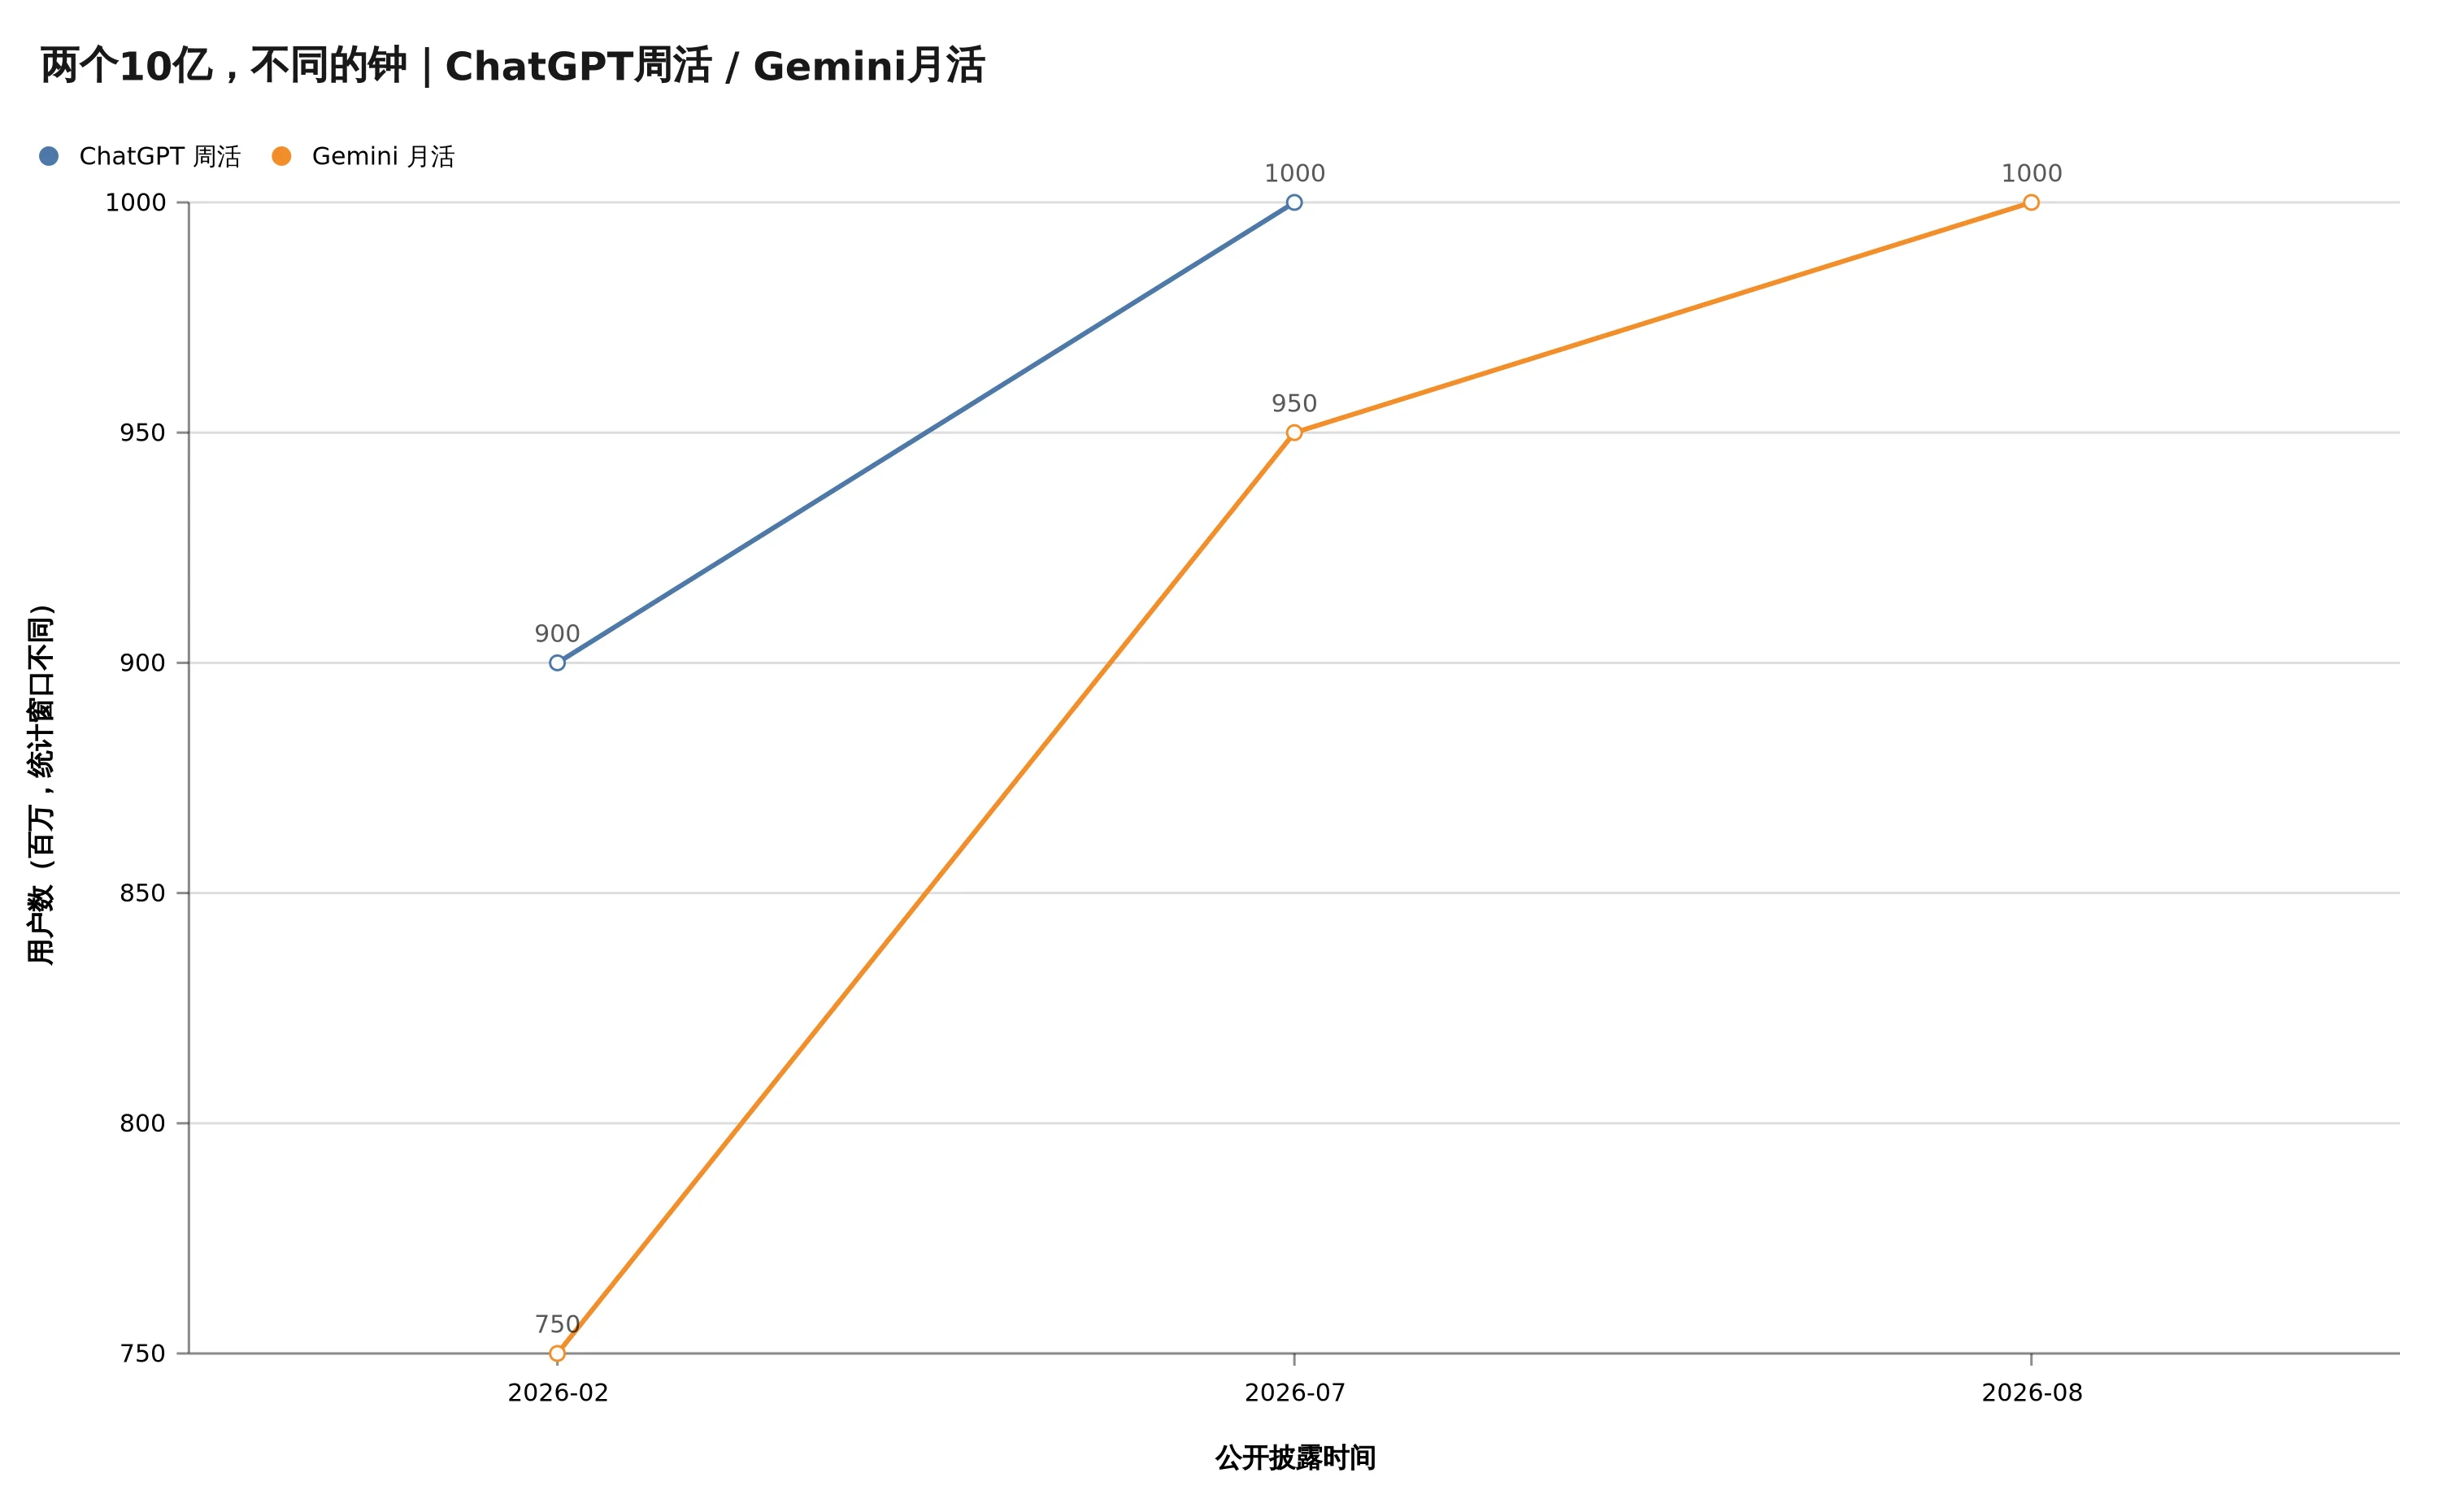
两个十亿使用不同统计窗口,趋势可以看,绝对值不能直接判输赢
同一天出现的导入按钮,比十亿更值得看
就在两家十亿用户刷屏的同一天,OpenAI Developers 宣布了一项桌面端更新。用户可以把其它智能体里的项目、聊天记录、技能和插件导入 ChatGPT Work 与 Codex,还能查看导入历史,选择自动更新。
单看像个迁移工具。和十亿用户放在一起看,味道就变了。
平台开始争夺的,不只是你这一轮问了什么,而是你过去几个月积累下来的整个工作状态。
项目里有哪些文件,聊天里做过哪些决定,skill 里固化了什么流程,插件握着哪些工具权限,agent 跑到第几步失败过。这些东西一旦粘在某个平台里,换模型就不再是下拉框点一下,而像搬一套正在营业的数据库。
说真的,模型切换越来越便宜,状态迁移却越来越贵。
今天 Claude 某个任务更强,明天 Codex 的工具调用更稳,后天 Gemini 的多模态又追上来。API 适配层改几个字段,甚至换一个路由规则,就能把请求送去另一家。但要把半年聊天里的隐含决策、团队权限、历史附件、失败重试和验收习惯一起搬走,没那么轻松。
这也是为什么导入能力值得肯定。
至少平台承认了用户的工作不该从空白聊天框重新开始。棒棒的。
可导入不等于可移植。
如果数据只能单向进来,出去时没有稳定格式,技能名称相同但权限语义不同,插件目录搬过去却缺少凭据、环境变量和版本锁,那只是把迁移成本从入口挪到了出口。
很多朋友可能会觉得,聊天记录能导出来不就行了。问题是聊天记录更像日志,不是完整状态。真正让一个 agent 继续干活的,通常还包括文件版本、工具合同、审批边界、测试集、密钥引用和运行环境。少一个,导入成功的绿色提示也可能只是 UI 层成功。
绿灯亮了,任务没复现。
这种场面,做工程的太熟了。
十亿用户之后,护城河开始长在状态层
AI 产品的第一阶段很容易理解,谁的模型聪明,谁就能吸引注意力。
第二阶段比的是产品。语音、图片、代码执行、深度研究、桌面端和移动端,谁把能力装进更顺手的交互里,谁就拿到更多使用时间。
现在第三阶段已经冒头。平台开始比谁能接住更长的任务、更多的上下文和更复杂的协作关系。
这时护城河不只长在参数里,也长在状态层。
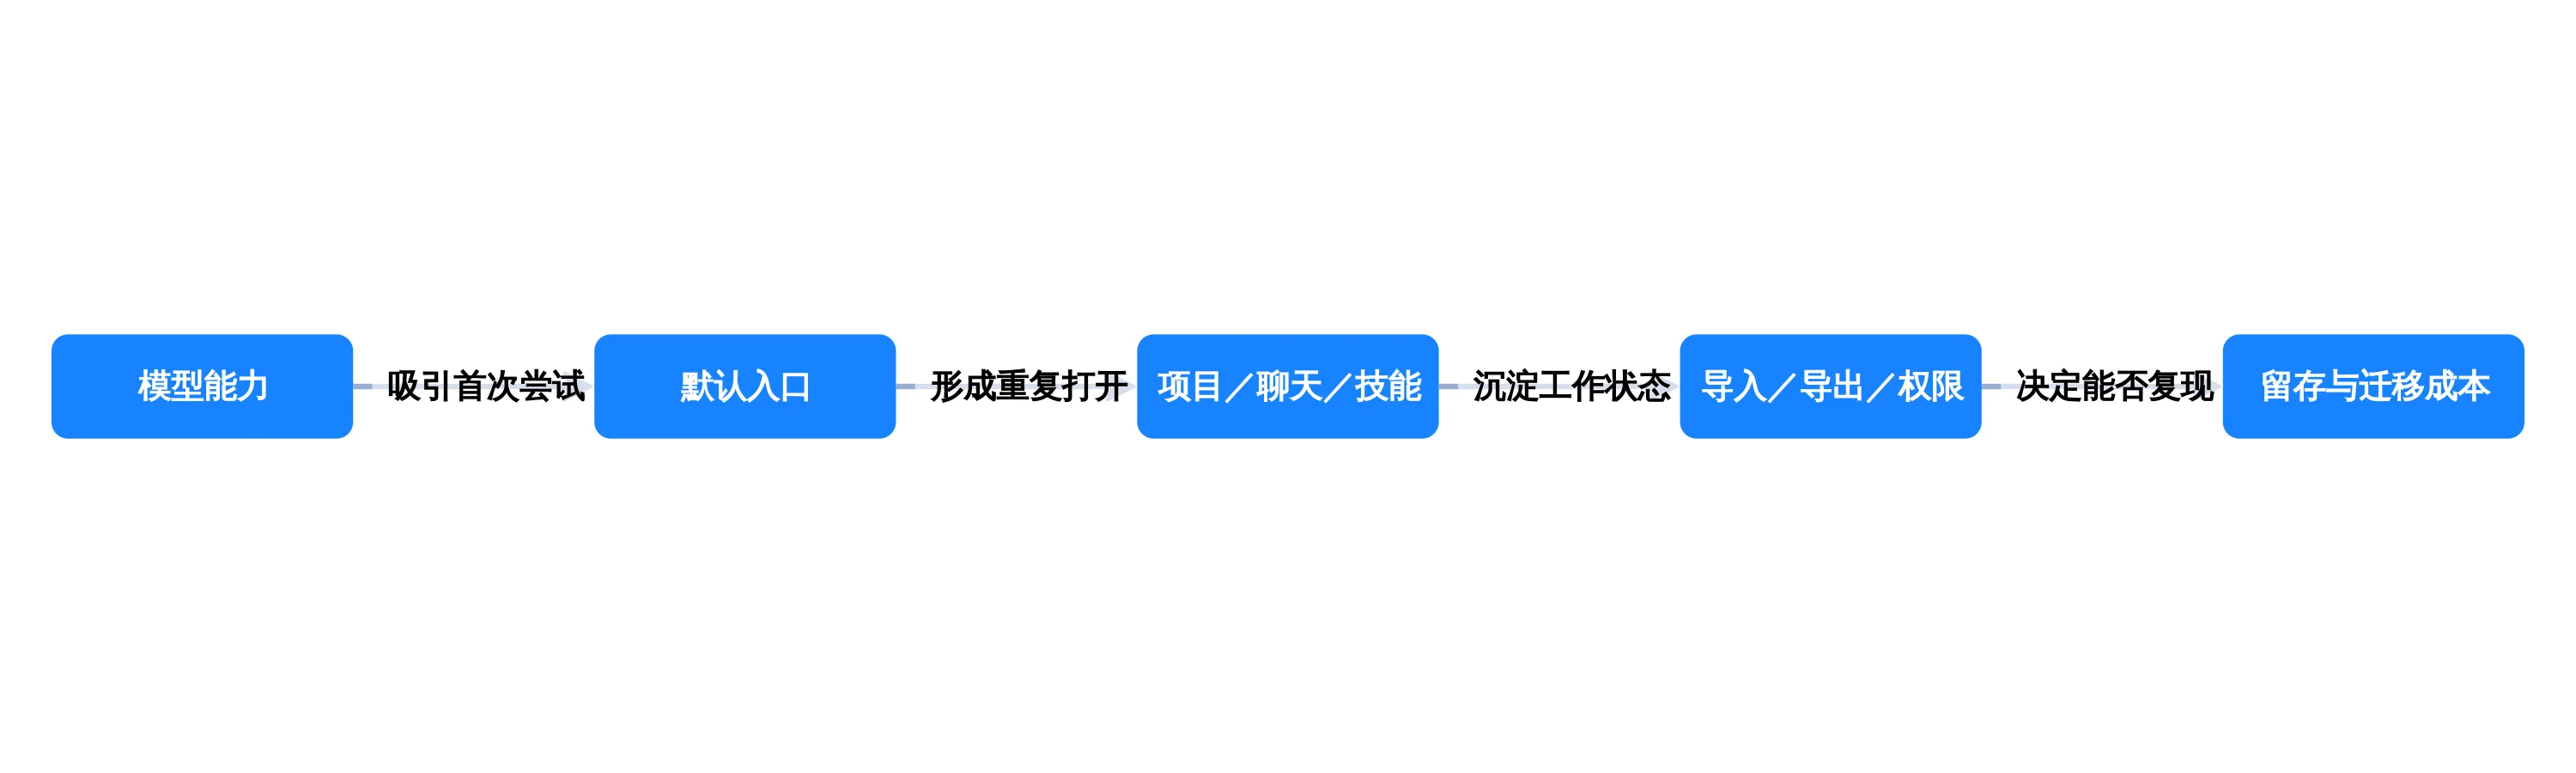
模型吸引第一次尝试,入口和状态决定用户明天是否还会回来
所谓状态层,用人话讲,就是模型下一次醒来时,能不能知道上一次发生了什么。它可能是一段记忆、一份项目索引、一个 Git commit、一组评测结果,也可能是某个工具刚拿到的临时权限。
对于聊天产品,状态让回答更连贯。对于 agent,状态决定任务能不能续跑。
差别挺大。
一段聊天丢了,用户最多重新讲一遍。一个长任务的状态丢了,agent 可能重复下单、覆盖文件、再次发消息,或者在已经失败的路径上多烧一轮 token。到了企业环境,还要叠上审计、最小权限和数据保留期。
所以我看十亿用户,不太想继续争论哪家排行榜高了两分。我更想看四件小事。
项目能不能完整导出,导出的格式有没有公开说明,权限能不能在目标平台重新映射,失败任务能不能从确定的检查点恢复。
这四件事很土,没有发布会灯光,却直接决定用户敢不敢把更长的工作交出去。
怎么说呢,十亿用户是规模,敢把任务状态托付给你才是信任。
别把自己的家底只存在聊天框里
平台当然会继续做导入功能。Google 有分发,OpenAI 有高频工作场景,Anthropic、Microsoft、Cursor 也都在把 agent 推进真实项目。每一家都会努力让搬进来更顺。
作为开发者,最稳妥的做法不是猜最后谁赢,而是让自己的工作资产随时能搬。
我一直觉得,长期事实应该放在模型外面。代码进 Git,需求和决策进 Markdown 或团队知识库,评测保留固定输入与预期结果,技能和工具合同做版本控制。聊天记录可以帮助回忆,但别让它成为唯一的事实来源。
一个最小的可迁移项目,大概可以长这样。
workspace/
  README.md
  decisions.md
  evals/
  skills/
  tool-contracts/
  data/
  versions.lock
README.md 写清目标和启动方式,decisions.md 记录为什么这么选,evals/ 留下固定测试,skills/ 保存可复用流程,tool-contracts/ 约束工具输入输出,versions.lock 锁住关键依赖。
这些文件不需要漂亮。它们只需要让另一个模型、另一台机器,或者三个月后的你,能在不翻完五百轮聊天的情况下接着干。
坦率讲,这套做法会多一点维护成本。每次重要决定都落盘,确实没有在聊天框里一路按回车爽。可它换来的是一种很实在的自由。
今天用 ChatGPT,明天试 Gemini,某个难题交给 Claude,批量代码再丢给 Codex。平台可以换,任务的事实、验收标准和权限边界不跟着漂。
还有一层容易漏掉。迁移时别只验证文件数量,要跑一次真实任务。检查链接是否还在,skill 是否拿到正确工具,插件权限有没有扩大,历史附件能否读取,关键评测是否复现。
导入完成只是接口返回 200。
任务完成才是验收通过。
两只钟之后,看谁能让用户带着行李走
ChatGPT 与 Gemini 同时跨过十亿,是一个挺夸张的时代标记。AI 已经不是少数人折腾的玩具,而是和搜索、浏览器、办公软件一样,开始进入全球用户的日常入口。
但两只钟也提醒我们,漂亮数字永远要先问口径。
周活告诉你频率,月活告诉你覆盖。预装告诉你入口,任务状态告诉你深度。模型分数决定一次惊艳,能不能迁移则决定用户有没有选择。
我可能看走眼,但我觉得下一轮真正残酷的竞争,不是谁再多拿两分跑分,而是谁能接住用户多年积累的上下文,同时还允许他们完整地带走。
能搬进来,是产品能力。
能带着行李离开,才是平台的底气。