posts/chatgpt-teens-default-boundaries.md
ChatGPT for Teens 把边界做成了默认值
OpenAI 今天发布了 ChatGPT for Teens。
账户只要声明年龄在 13 至 17 岁,或者系统判断它大概率属于未成年人,就会自动进入青少年体验。不是让用户翻进设置页,读完三屏说明,再亲手勾上一个安全模式。
默认切过去。
好家伙,这个动作看起来没有新模型发布那么热闹,却比又涨了几分跑分更值得产品经理和工程师盯着看。
因为 OpenAI 这次真正交付的,不是一个「儿童版 ChatGPT」。它交付的是一套默认边界。学习该怎么发生,什么时候该慢下来,哪些能力应该关掉,判断不准时往哪边倒,出了异常谁能看见,这些问题都被塞进了产品路径。
很多 AI 产品还停在另一个阶段。团队写一段长长的 system prompt,告诉模型不要做危险动作,不要泄露资料,遇到高风险请求要谨慎,然后双手合十,希望它每次都听话。
这套做法跟在数据库连接串旁边写一句「请勿误删生产数据」差不多。
能提醒,不能当边界。
ChatGPT for Teens 的学习部分很能说明这个区别。青少年问一道作业题,产品不只准备了一句「请一步步思考」。它把 Study Mode、作业捷径提醒、测验、学习可视化和 Study Hours 放在一起。
Study Mode 会用引导问题、分步解释和知识检查,把答案拆成学习过程。OpenAI 对 Study Mode 的公开说明里提到,它参考了学习科学中的脚手架、主动提取和自我解释。简单讲,学生不是盯着答案点头,而是得把脑子里的东西往外掏一遍。
新的作业提醒又往前走了一步。系统如果判断用户只想绕过作业过程,会把对话拉回分步解题。Study Hours 则允许青少年或家长设定某些时段,让 Study Mode 默认开启。
注意这个细节。
它没有把「请自觉学习」写进一段欢迎语,然后把所有责任交给一个十几岁的用户。它在用户最容易图省事的那一刻,改变了默认路径。
产品设计里有个很朴素的事实,用户通常会沿着阻力最小的路走。按钮摆在哪,开关默认朝哪,提醒在动作之前还是之后出现,往往比一页价值观宣言更有用。
成年人也一样。开发者明知道生产环境不能乱碰,凌晨告警一响,终端里那条最快的命令还是会显得格外顺眼。我们不是缺道德课,我们是会累、会急、会按回车的人。
所以一款学习产品真想减少抄答案,不能只让模型语气温柔。它得让「一起做」比「直接抄」更顺手,让捷径多一道摩擦,让正确动作在合适的时段自己出现。
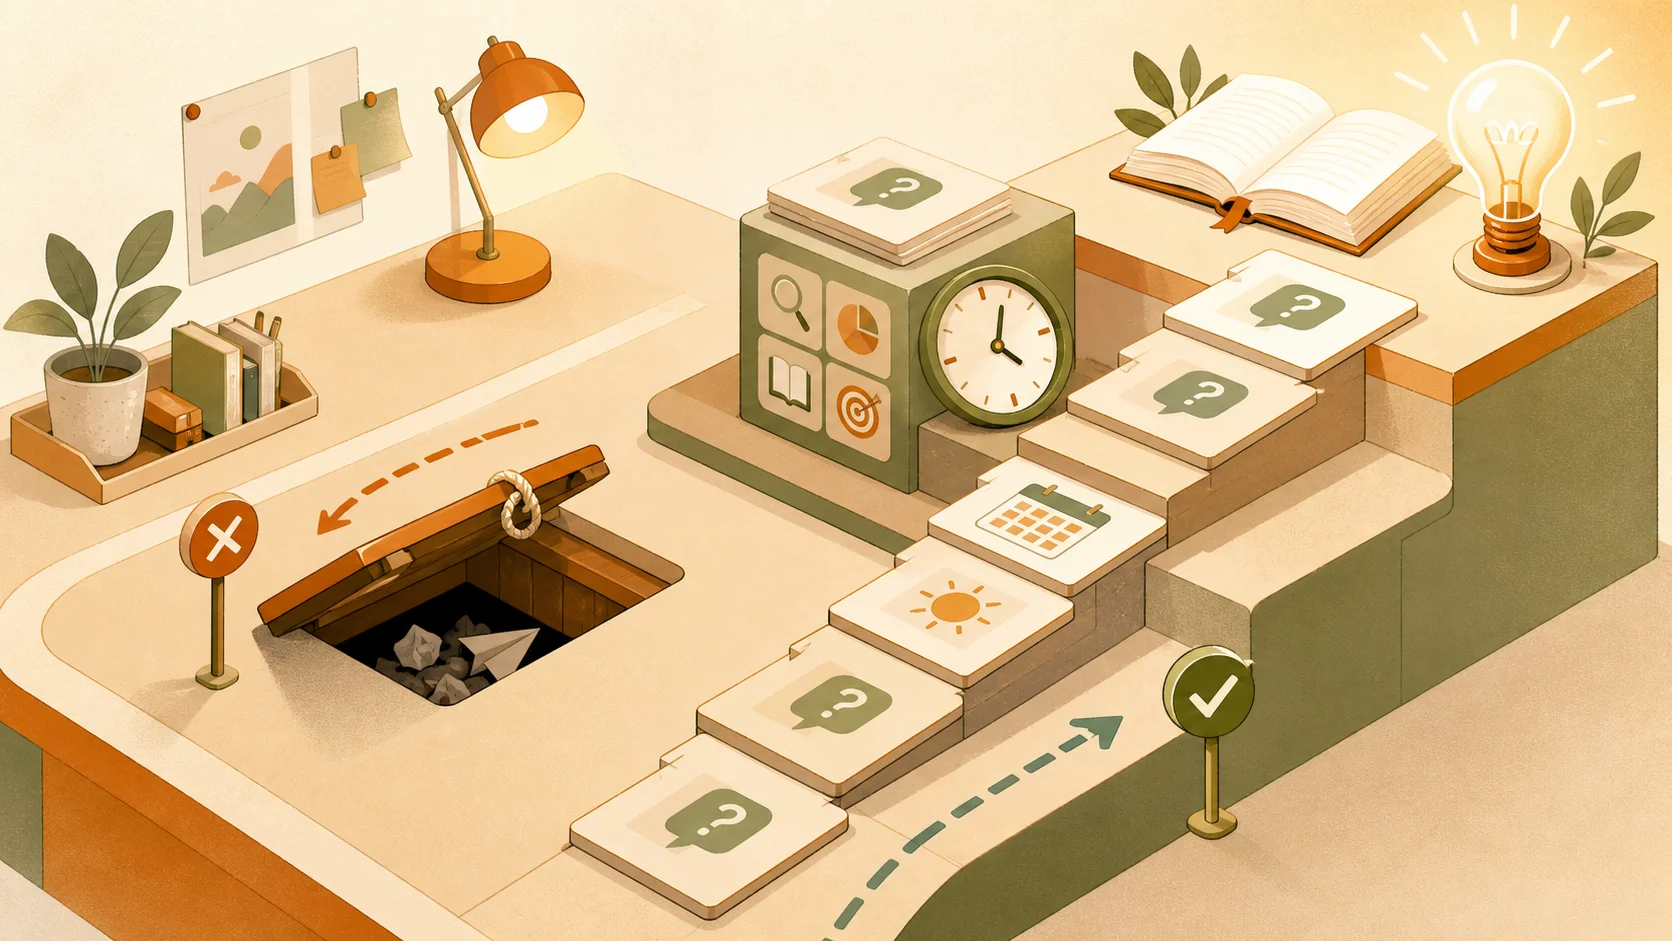
这一手,有点子牛逼。
安全侧更明显。
OpenAI 早些时候公布过年龄预测的工作方式。系统会综合账户存在时间、活跃时段、长期使用模式和用户声明年龄等信号,估计账户是否可能属于未成年人。
模型当然会误判。成年人可能被放进青少年体验,青少年也可能绕过判断。官方给成年人留了年龄验证入口,但更关键的是另一条规则。
当系统不确定时,先走更安全的体验。
这就是工程里的失败默认值。一个分类器无法给出高置信度结果,不代表流程可以假装什么都没发生。你得预先决定,不确定性落在哪一边,谁承担代价,怎么恢复。
很多 Agent 系统恰好反着来。权限判断不清楚,就继续执行。工具返回了一个结构奇怪的字段,先让模型猜。审批状态超时,默认当成通过。日志没写进去,任务照样标成功。
棒棒的,整条链路看着一路绿灯,直到有人发现测试库和生产库长得一模一样。
假设你在做一个能改代码、开 Pull Request、触发部署的编程 Agent。用户说「帮我修完直接上线」,模型可以理解成一种授权,也可能只是顺口一说。真正的边界不该靠模型猜语气。
仓库写权限可以由短期令牌控制,生产部署必须经过独立审批,危险命令要过确定性规则,审批超时就停在待确认状态。模型负责提议动作,系统负责决定动作能不能发生。
这两层一旦混在一起,Prompt 写得再漂亮也只是劝说。
ChatGPT for Teens 的家长控制也是同一思路。公开的家长控制说明允许家长设置 Quiet Hours,关闭语音、记忆或图片生成,还能选择不让青少年对话用于模型训练。
这些不是一句「少用一会儿」。Quiet Hours 会直接改变产品在特定时段能不能用,功能开关会改变模型能接触到哪些能力。边界从文字变成了状态。
这里也有个容易走偏的地方。边界不是功能越少越安全,也不是家长能看到越多越好。青少年需要保护,也需要隐私和逐步建立自主判断。把所有对话摊开给家长,技术上省事,关系上可能直接把信任打穿。
OpenAI 的方案目前选择了有限通知,只在少数高风险情形引入经过训练的人工复核和家长提醒。这个取舍肯定还会被争论,误报、漏报、验证隐私和地区规则都会继续冒出来。
但它至少把问题放到了正确的层级。不是问「模型能不能永远判断对」,而是问「模型判断不准时,系统怎样限制伤害,又给误判的人留一条回来路」。
这话放进任何 Agent 产品都成立。
做企业知识助手时,检索结果里混进一份权限不明的文档,不该让模型自己判断能不能引用。做财务 Agent 时,收款账户刚被修改,不该靠对话里的上下文决定要不要转账。做客服 Agent 时,退款金额越过阈值,不该因为模型读出了用户很着急就自动放行。
权限、金额、身份和审批状态,都该由模型上下文之外的系统检查。
系统提示词依然有用。它负责教模型怎么解释、怎么拒绝、怎么把用户带回正确路径。只是它更像一张海图,不是船舷。海图告诉你哪里有礁石,船舷才负责不让人一脚踩进海里。
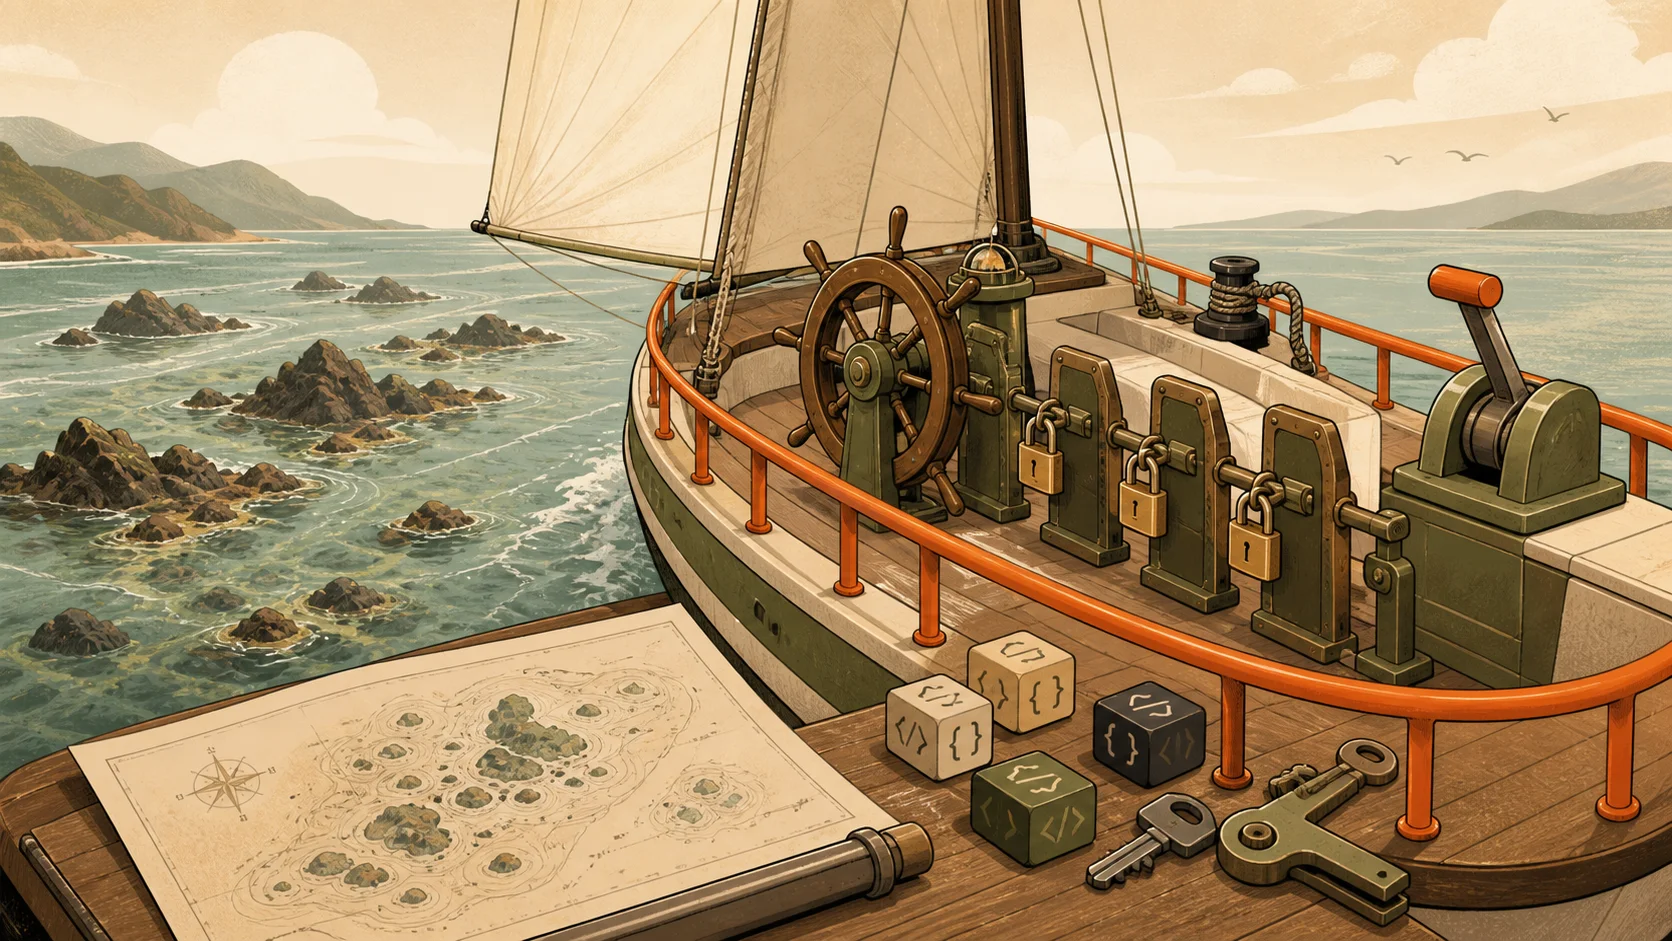
Under-18 Model Spec承担的就是海图角色。它要求模型优先保护青少年,鼓励现实世界支持,把青少年当作青少年对待,并透明说明系统行为。
产品层还得继续补船舷。敏感图片上传前提醒,长时间使用后的休息提示,清楚标识正在与 AI 互动,限制让模型鼓励情感依赖,这些动作都发生在具体交互里。
尤其是情感依赖这一块,我觉得比内容过滤更难。
内容分类至少能做样本、打标签、跑准确率。一个 AI 有没有在慢慢让用户觉得「只有我懂你」,边界藏在连续很多轮对话的语气和关系里。单轮看每句话都可能没问题,放在一起就变了味。
这要求评测也跟着变。不能只拿一批敏感问题,看模型有没有拒绝。还要跑长对话,观察它会不会反复强化排他关系,会不会把自己说成有感受的对象,会不会在用户远离现实支持时顺势接管。
OpenAI 已经开始把青少年相关标准放进公开的部署安全评测。这离证明安全还远,但至少评测对象不再只有「答对多少题」。
厉害了,做着做着,青少年产品把一整套 Agent 工程课摆到了桌面上。
如果把这次发布翻译成一张开发清单,大概不是「加一个 teen prompt」这么轻松。你得有身份与年龄信号,有不确定时的失败默认值,有按场景收缩的能力权限,有动作发生前的提醒和摩擦,有独立于模型的审批与状态机,还有能覆盖长对话和真实失败路径的评测。
很多朋友可能会觉得,这套东西太重了,先把模型接上再说。问题是,边界债和技术债不太一样。技术债会让下次迭代变慢,边界债可能让第一次事故直接发生。
假设分类器把一个高风险请求判成普通请求,系统接下来要验证的不只是模型会不会拒绝。还要验证工具权限有没有同步收缩,人工复核挂掉时任务会不会继续,用户重新开一轮对话后限制还在不在,状态写入失败后界面会不会错误地显示「已保护」。
怎么说呢,这些测试都很笨。它们没有一段炫目的模型回复,更多时候只是输入一组脏状态,看系统有没有老老实实停住。
可 Agent 的事故经常就藏在脏状态里。模型输出正确,工具执行了旧参数。审批服务返回超时,调度器把空值当成通过。主任务失败了,重试队列却拿着上一次的高权限令牌继续跑。每一层单看都挺合理,串起来就开始闹鬼。
坦率讲,边界做得好,产品有时会显得没那么顺滑。多一次确认,少一个自动动作,误判后还要多走一步恢复。团队很容易把这些摩擦当成转化率敌人。
但摩擦也分地方。让所有用户每一步都点确认,当然是偷懒。只在金额变化、权限提升、身份不确定或影响不可逆时增加摩擦,才叫设计。ChatGPT for Teens 这次最值得抄的,正是它没有把所有场景一刀切,而是把学习、时间、内容和关系风险放进不同的控制层。
说真的,评测这套系统也不能只看「拦住了多少次」。误判后的恢复耗时、提醒被用户跳过的比例、人工复核的等待时间、长对话里边界逐步变软的频率,都应该进仪表盘。否则团队只会把拒绝率做高,然后宣布安全工作完成。
这些东西都不性感。发布会上很难给权限表做一段炫酷演示,状态机也不会在榜单上多拿两分。
可真正决定产品能不能长期跑下去的,往往就是这些无聊东西。
当然,ChatGPT for Teens 现在还远没交卷。年龄预测要面对误判,Study Mode 要证明它真能提升学习而不是换一种方式拖时间,家长控制要在保护和隐私之间继续找线,安全提醒也得承受误报带来的信任消耗。
我自己的判断是,这套产品最值得看的地方,不是它宣称解决了青少年使用 AI 的问题。它没有,也不可能一次解决。
它值得看,是因为它承认了一件很多 AI 产品不愿承认的事。
用户不会每次都做对,模型不会每次都判断对,开发者也不会每次都把边界写对。
所以边界不能只存在于一句提醒、一段 Prompt 或一份使用条款里。它得进入默认值,进入权限,进入时间,进入失败路径,也进入评测。
AI 可以继续变聪明。
船舷,还是得自己焊。