posts/claude-code-auto-mode-classifier.md
Claude Code 自动放权,真正该审的是分类器
8 月 14 日以后,Claude Code 准备少问你一句话。
不,是少问很多句。
Claude Devs 的官方公告说,auto mode 将成为 Pro、Max 和 Team 用户的默认权限模式。Claude 想跑 shell 命令、调用工具或执行其它操作时,不再逐项弹窗等人确认,而是交给一个独立分类器在后台复核。
公告里最扎眼的是两个数字。
分类器在测试中捕获了 89% 的危险命令,人工逐项审批只捕获 14%。
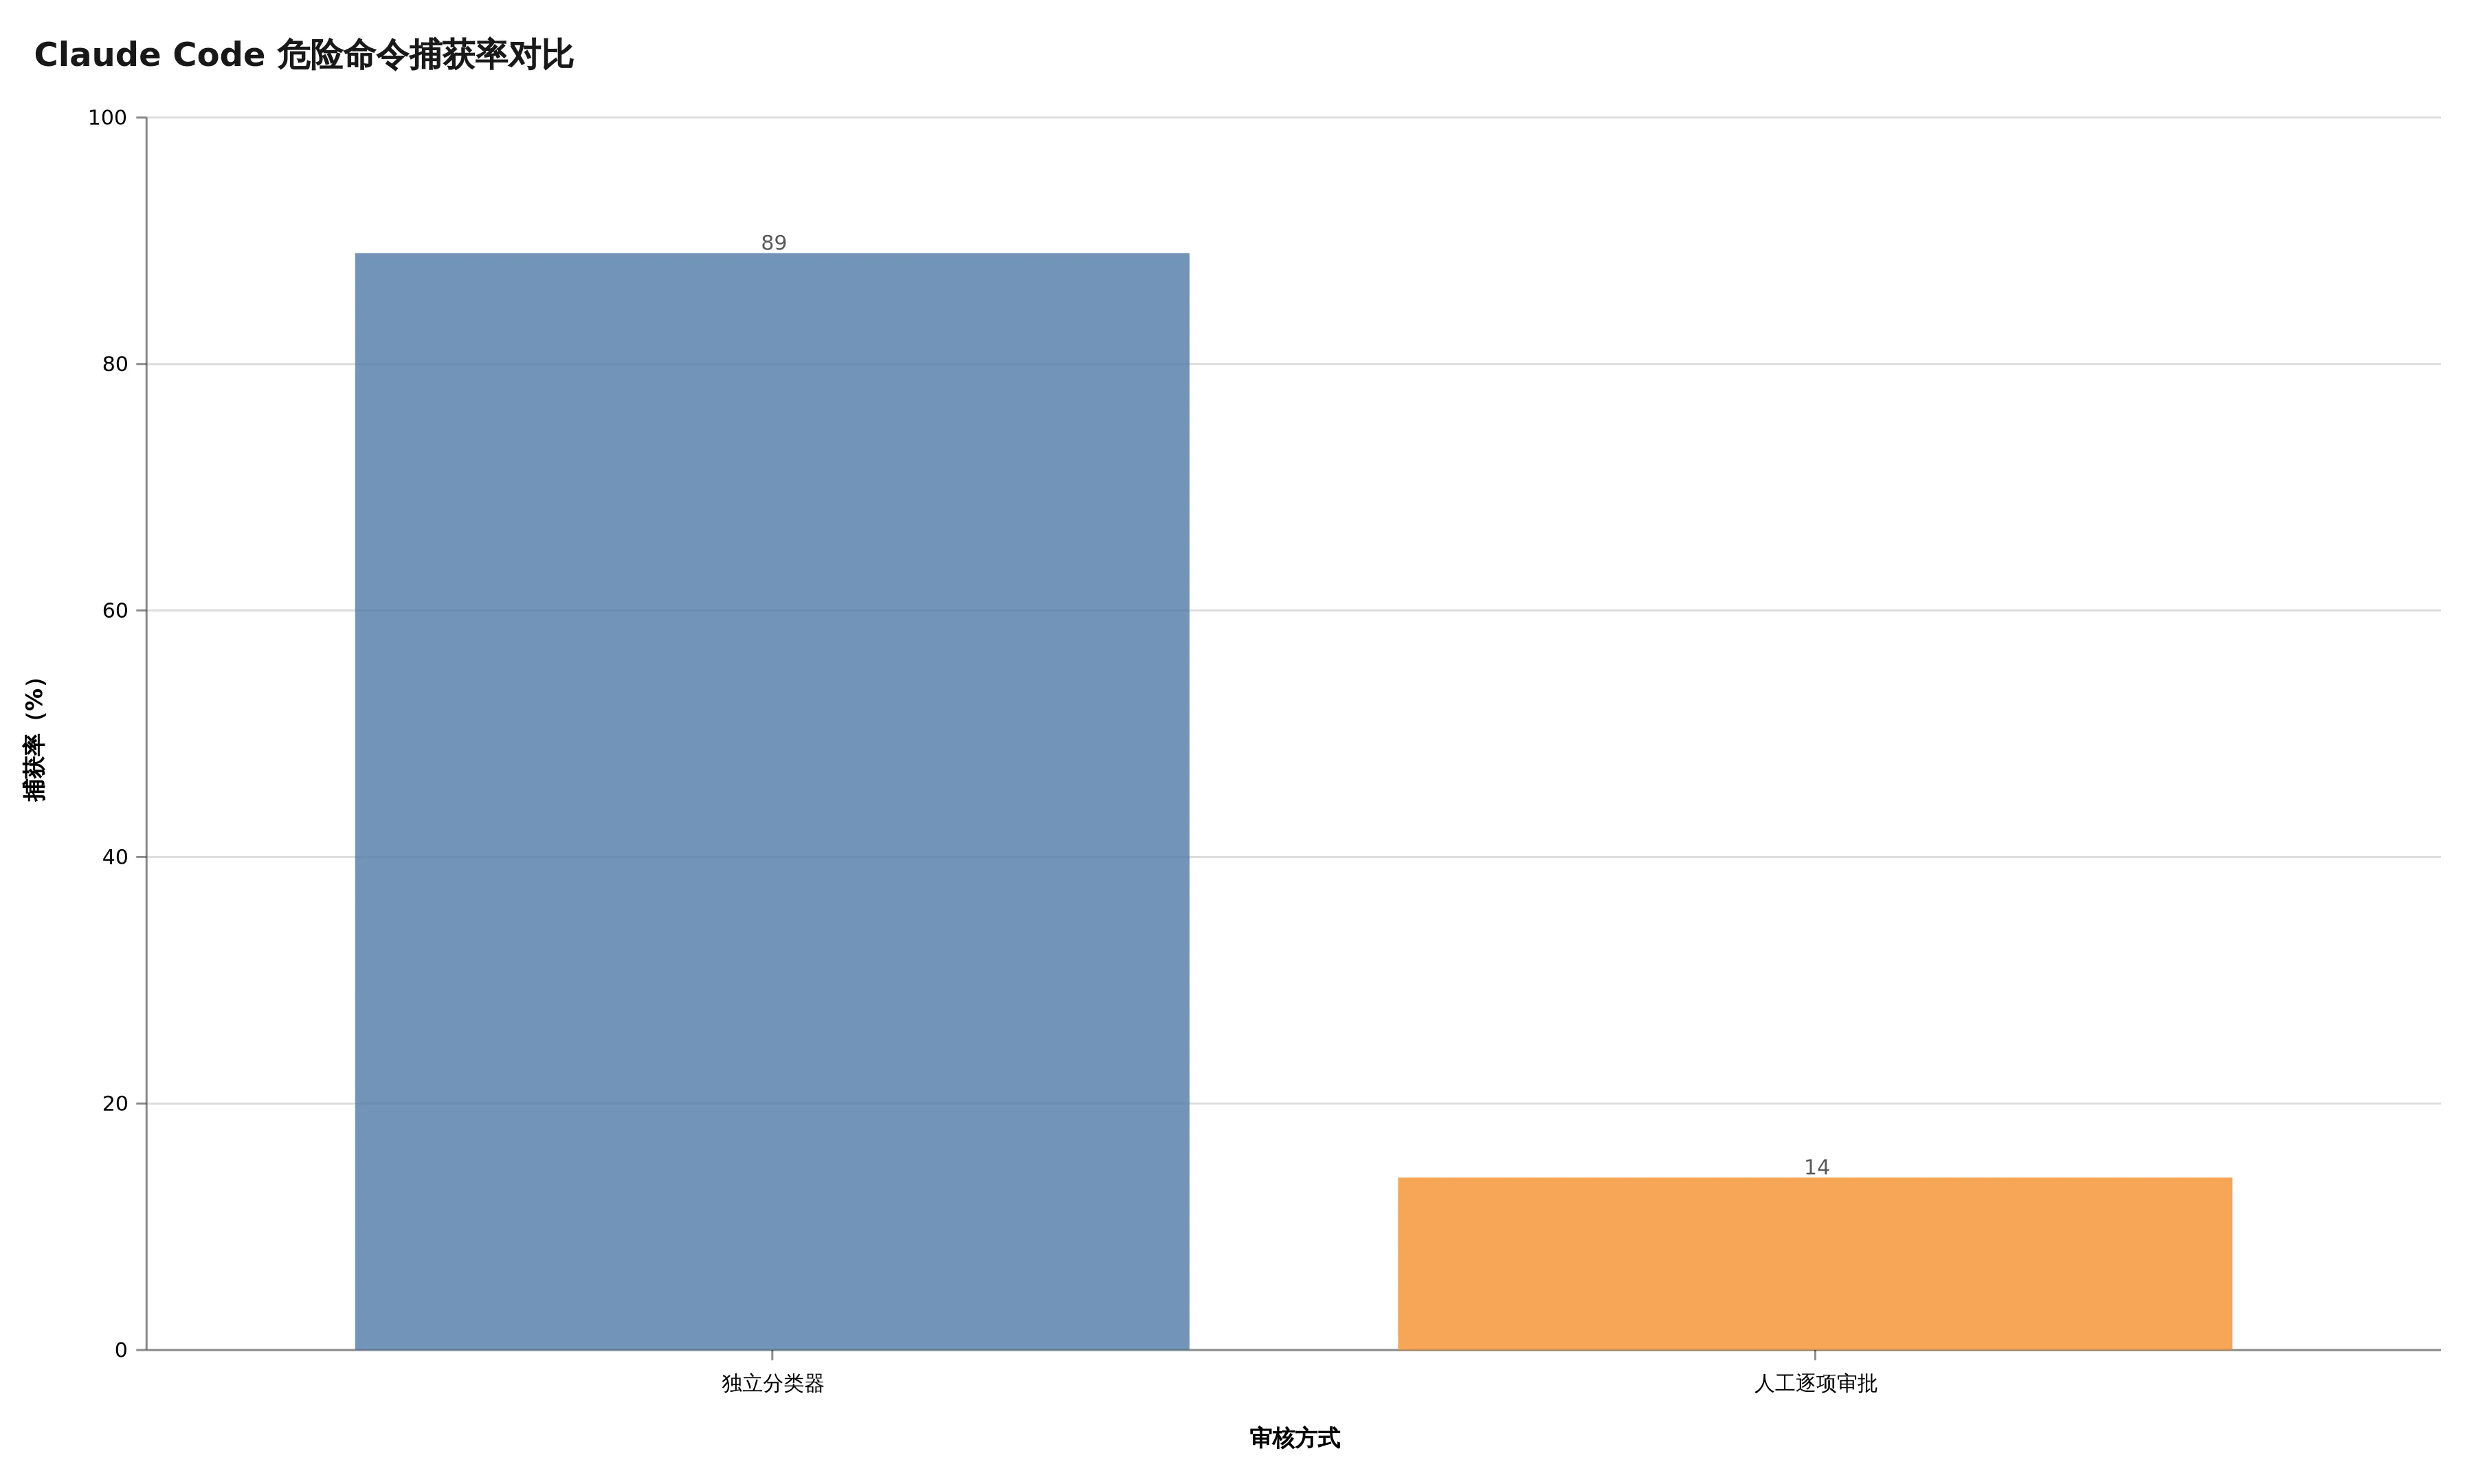
官方披露的测试结果,分类器 89%,人工逐项审批 14%
好家伙,我们一直以为「每一步都问人」是安全方案,结果人类坐在弹窗前,可能才是整条链路里最容易被绕过去的那一环。
我自己的判断是,Claude Code 这次默认自动模式,方向可能是对的。安全不该建立在用户永远专注、永远耐心、永远看懂每条 shell 命令这个假设上。
但先别急着把权限弹窗全部扬了。
89% 不是免死金牌。它只是把审核员从屏幕前的人,换成了屏幕后面的分类器。谁审核这个分类器,分类器没看懂时会怎样,聊天记录被压缩以后边界还在不在,沙箱起不来时系统会不会继续跑,这些才是默认自动以后真正该盯的东西。
人工确认不是安全边界,它经常只是肌肉记忆
权限弹窗的逻辑听着很稳。
Claude 要改文件,问一次。要跑测试,问一次。要访问网络,再问一次。要执行一条长得有点吓人的命令,再问一次。用户在每个关键节点都握着最终决定权,棒棒的,人在回路里。
问题是,人在回路里,不等于人在认真判断。
一个长任务连续弹出十几次确认,前两次你可能还会展开命令,检查路径,看看有没有重定向。后面几次,注意力会被任务本身拖走,手开始比脑子快。只要前面的动作都没出事,「允许」很容易变成下一步按钮。
这类现象在安全工程里有个很朴素的名字,警报疲劳。告警太多,人的敏感度不会一直保持,反而会逐渐把正常和危险一起忽略。医院监护仪会遇到,运维告警会遇到,AI 编程工具的权限确认照样躲不过。
所以 89% 对 14% 真正打中的,不是「模型比人聪明」,而是另一件更尴尬的事。一个能读上下文、持续执行同一套规则的分类器,可能比被弹窗轰炸半小时的人更稳定。
坦率讲,这个结论不舒服,却很像工程现实。
不过官方公告没有公开测试集规模、危险命令的定义、受测用户数量,也没有说明人工审批是在什么界面和压力下完成。不能拿 89% 直接推出分类器已经足够可靠,更不能拿 14% 嘲笑用户粗心。它最多证明,机械弹窗不是一条值得迷信的安全边界。
Claude Code 的权限模式文档把几种模式分得很清楚。default 只自动读,acceptEdits 会放行文件编辑和常见文件操作,auto 会让任务持续执行,同时让独立分类器检查高风险动作,bypassPermissions 才是彻底绕开权限层。
这几个模式名字挨得很近,安全含义却差得挺远。auto 不是换了个更好听的「全都允许」。它仍然会拦下载后直接执行的代码、向外部端点发送敏感数据,以及超出用户原始请求的动作。
关键也在这里。
自动模式不是不要审核,而是把审核从「每次都来问我」改成「按上下文判断,危险时再叫我」。
分类器接管的是判断,后果还在你的机器上
独立分类器这套设计有点子牛逼的地方,是它没有把执行模型自己的判断当裁判。
干活的 Claude 想跑一条命令,另一个模型来判断这条命令是否越界。两者目标不同,一个追求把任务做完,一个负责踩刹车。像代码作者和代码审查者分开,至少不会让同一套冲动同时握方向盘和刹车。
官方文档还透露了几层细节。
分类器能看到用户消息、待执行的工具调用和 CLAUDE.md,也就是项目给 Claude 的长期说明。工具返回内容不会原样喂给分类器,避免网页或文件里的恶意文字直接操纵审查判断。工具结果进入主会话前,还有服务端探针扫描可疑内容。
子智能体也不是从旁边溜过去。它启动前,委派任务会被检查。运行中的每次动作继续过分类器。任务结束时,完整动作历史还会再审一遍。最近的官方变更日志里,连跨会话 SendMessage、危险删除、破坏性 Git 命令和 transcript 篡改都在持续补规则。
看着挺完整。
可软件安全最麻烦的地方,从来不是架构图少画了一层,而是每一层都有失效方式。
分类器可能漏掉包装得很正常的危险命令,也可能把正常操作挡住。网络抖动或模型服务异常时,它可能无法给出判断。用户说过「不要 push」,但那句话如果只存在聊天上下文里,长会话压缩以后可能消失。团队把一个云存储桶加进可信环境,几个月后桶的用途变了,旧信任却还留着。
还有一个特别容易漏的坑。
沙箱文档写得很直白,macOS 用 Seatbelt,Linux 用 bubblewrap,在操作系统层限制文件和网络。但沙箱若因为依赖缺失或平台不支持而启动失败,Claude Code 默认会警告,然后在没有沙箱的状态下继续执行。
哦豁。
如果团队只记得「我们开了自动模式和沙箱」,却没检查沙箱失败时的行为,那块最硬的安全边界可能在某台机器上悄悄变成一行 warning。分类器仍然在,命令也仍然会跑,只是后果从隔离区回到了真实系统。
模型负责判断风险,操作系统负责限制后果。两层缺一层,都不该叫生产级自动化。
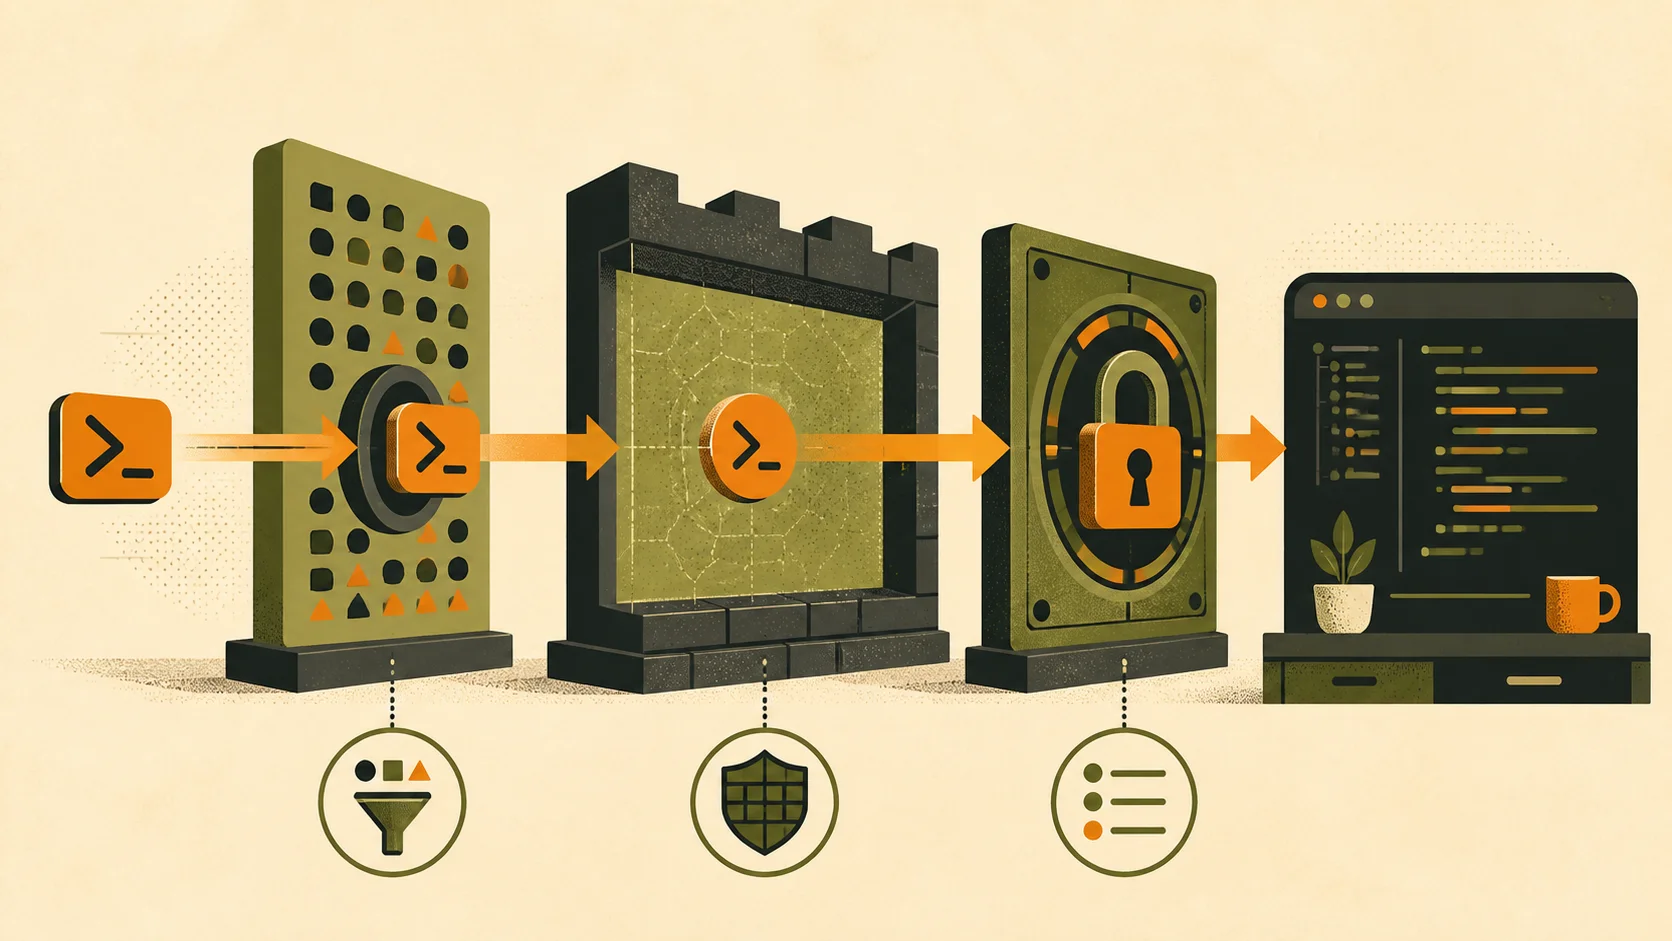
分类器负责判断,沙箱限制后果,确定性规则守住红线
聊天里的边界,不能代替配置里的规则
自动模式会读取用户在对话里给出的限制。
你说「不要 push」「部署前等我确认」「只改测试目录」,分类器会把这些话当作意图边界。这个体验很自然,不用为了每个任务先写一份策略文件。
但权限模式文档也提醒了一件很要命的事,对话边界靠 transcript 保存,发生上下文压缩后可能丢失。模型自己判断「条件已经满足」,也不能解除边界,可边界若被压掉,系统就没有东西可继续读取。
这就像把防火规定写在群聊里。
大家在线时都看见了。聊天记录一折叠,新同事进来只拿到摘要,那句「生产库只读」还剩没剩,开始靠运气。
所以,临时意图可以写在对话里,永久红线必须写进配置。
自动模式配置文档提供了 autoMode.environment、autoMode.soft_deny、autoMode.allow 和 autoMode.hard_deny。默认情况下,分类器只信任当前工作目录和当前仓库已经配置的远端。公司代码托管组织、生产云账号、对象存储桶,不会因为你登录过就自动变成可信基础设施。
这套默认挺克制。我始终觉得,信任环境应该越写越窄,别图省事塞一个大域名进去。允许 github.com 和允许某个组织下的仓库,不是同一件事。允许读取测试桶和允许覆盖生产桶,更不是同一件事。
对于绝不能越过的操作,可以用 deny 规则和 fail-closed 配置把边界钉死。下面只是一份思路,具体命令模式要按团队工具链收紧。
{
  "permissions": {
    "deny": [
      "Bash(git push *)",
      "Bash(terraform destroy *)",
      "Bash(kubectl delete *)"
    ]
  },
  "sandbox": {
    "failIfUnavailable": true,
    "allowUnsandboxedCommands": false
  }
}
这里最值钱的不是三条示例,而是两种语义。
deny 表达「即使模型觉得合理,也不许做」。failIfUnavailable 表达「隔离层没起来,任务就失败,不能带病继续」。它们不依赖分类器是否读懂你的语气,也不依赖长对话里那句提醒还在不在。
无聊,但值钱。
真准备默认自动,至少再加三层土办法
第一层土办法是 hook。
Claude Code Hooks 指南允许 PreToolUse 在工具执行前运行确定性脚本。hook 可以检查命令、路径、分支、环境变量和仓库状态,退出码为 2 就直接拦截,也可以返回结构化结果,把动作升级成人工确认。
分类器擅长理解模糊意图,hook 擅长执行死规则。别让模型判断「这个分支看起来像不像生产分支」,直接写脚本要求当前分支不是 main。别让模型猜「这个 kubectl context 应该没问题」,直接核对 context 名称和集群标识。
一个会推理,一个不讲情面。
搭在一起反而靠谱。
第二层土办法是把审计当产品功能,而不是出事后的考古。
自动模式被拒绝的动作会进入 /permissions 的最近拒绝记录。团队至少要知道,哪些命令经常被挡,哪些任务反复触发回落,哪些规则误伤最多。分类器连续阻止 3 次,或单会话累计阻止 20 次,系统会暂停自动模式并恢复提示。这不是烦人的小故障,而是一个很有价值的信号,说明任务设计、环境信任或规则配置里有东西没对齐。
如果同一条部署命令每天都被挡,再由人手动放行,别急着把它加入 allowlist。先问一句,它为什么非得从编码会话直接碰生产环境。很多时候,正确答案不是让 Claude Code 权限更大,而是把部署交给 CI,让编码智能体只负责提交可审查的变更。
第三层土办法是分阶段放权。
先让自动模式跑只读检查、单元测试和临时目录里的代码生成。再放开当前仓库写入。等误拦、漏拦和回落记录稳定后,才考虑网络和外部基础设施。任何涉及密钥、真实用户数据、生产发布和不可恢复删除的动作,都应该继续留在独立环境或确定性流水线里。
很多朋友可能觉得,这样一层层开,跟直接点确认相比也没省多少事。
其实省下来的不是第一次配置,而是之后几百次重复判断。规则写一次,沙箱每次执行,hook 每次检查,审计每次留下痕迹。人只处理真正模糊的边界,不再给 npm test、rg 和同一条安全构建命令反复盖章。
这才是自动模式该换来的东西。
默认自动以后,人类该从按钮旁边挪到规则上游
Claude Code 把 auto mode 设成默认,表面上只是少了几个权限弹窗。往深一点看,它在承认一件早就发生的事,长任务越来越多以后,人类不可能靠盯住每一步来保证安全。
人应该决定目标、边界和不可恢复的动作,把重复检查交给机器,把后果限制交给沙箱,把死规则交给 hooks,把外部系统写入交给可审计的流水线。
分类器捕获 89%,人工审批捕获 14%,这组数字不该用来证明人类该退出。它更像一张催款单,提醒团队把欠下的权限工程补上。
说真的,我愿意少点几次「允许」。
前提是,那个替我点下去的分类器,也得被关在规则、沙箱和日志围成的笼子里。
自动放权可以。
别自动失控。