posts/claude-code-everyone-ships-review-bottleneck.md
人人都能写 PR,最贵的却是合并权
一周 6000 多个 PR。
这是 Anthropic 刚发布的初创团队指南里,Artemis Security 给出的一组数字。旁边还有 ClickHouse 多交付 30% 的功能,Omni 工程效率提升 2 到 3 倍,Clay 把缺陷分流做到了 100% 自动化。
好家伙,几组数字放在一起,传统研发效能报表看着都像上个年代的东西。
Anthropic 把十多家高增长团队的经验归成五条规则,其中第一条很适合做海报,人人都能交付。懂业务的人不必把想法依次讲给产品、设计、工程,再等它在转述里慢慢走样。他可以直接让 Claude Code 做出原型,甚至提一个 PR。
但我看到这里,脑子里冒出来的不是「程序员还剩多少工作」。
我寻思的是另一件更麻烦的事。
当写 PR 变得便宜,谁有资格把它合进 main?
这才是这份指南里最值钱、也最容易被「人人都是工程师」口号盖住的部分。官方其实写得很谨慎。最有效的团队让更多人做出第一版,却没有让所有人随手改生产环境。生成的门槛降下去了,验证、权限、回滚和代码所有权反而被抬到了台前。
我的判断可能有点刺耳。
未来团队最稀缺的不是写代码的人,而是敢对合并结果负责的人。
Ship 和 Merge 中间,隔着一整家公司
「人人都能 Ship」很容易被听成「人人都能 Merge」。两个词只差几下键盘,风险差得可远了。
做出一个能跑的原型,目标是证明想法有戏。合进生产分支,目标是证明它在真实用户、旧数据、并发流量、权限边界和半夜告警面前也有戏。前者允许你兴奋地说「跑起来了」,后者会追问迁移脚本能不能重复执行,接口超时会不会重试三次扣三次钱,旧客户端传空字段时会不会直接 500。
很多朋友可能不知道,Anthropic 在原文里专门补了一句,这些团队没有让智能体直接合并到 main 后祈祷好运。
这句话很短,分量很重。
因为模型最擅长把一段工作做到八九成像样。类型能过,单测能绿,页面也能打开。剩下那一点通常藏在只有生产环境才凑得齐的条件里。一个过期的 feature flag,一条没人记得的兼容路径,一次消息重复投递,或者一个只在月末跑的账单任务。
AI 让前面八成更快了,没把后面两成变没。
甚至会让那两成来得更密。
假设以前五个工程师一天提十个 PR,资深同事还能逐个看。现在产品、运营、销售都能做原型,代码智能体又能同时开多个 worktree,PR 数量先膨胀,reviewer 的注意力却没有扩容。队列越来越长之后,团队很容易做一件看似合理的事,让另一个模型来审。
棒棒的,生成和审查都自动化了。
然后两个模型一起漏掉同一个前提。
所以合并权不是 GitHub 里一个按钮。它是一份责任清单,里面至少要回答四个问题。谁定义不能变的边界,什么证据足够证明改动安全,出事后怎样退回去,这块代码出了问题由谁接住。
答不出来,Ship 只是把代码送到门口。
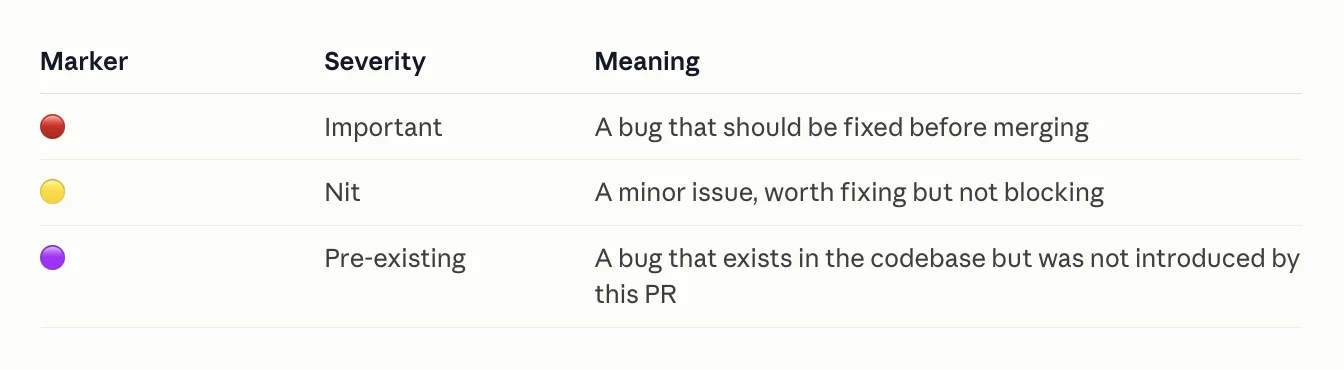
官方 Code Review 会把必须在合并前修复的问题与轻微建议分开标记。
把验收写成机器能执行的东西
这份指南里我最喜欢的部分,不是 6000 个 PR,而是「信任但验证」那一章。
Cainex 做医疗编码,不能拿「看起来差不多」当验收。它让审核员检查模型输出与推理,所有修正都进入版本记录。Claude Code 再去定位产生错误的规则,修改原则,拿失败样本、黄金数据集和随机样本一起回测。不是遇到一个错例就往提示词里塞一个补丁,而是要证明新规则没有把旧规则撞坏。
这个做法放到普通开发团队里,一点也不玄。
你可以把交付证据分成两类。第一类是确定性证据,编译通过、lint 通过、单元测试通过、迁移可重复执行、依赖没有新增高危漏洞。它们不需要模型发表意见,命令退出码就是裁判。
第二类是判断性证据,交互是不是更顺,错误提示是否误导用户,这次重构有没有偏离产品目标,安全修复是不是只堵住了演示里的那条路径。模型能参与,但不能自己写题、自己答题、自己宣布满分。
这块需要注意一下,很多团队现在恰好把顺序弄反了。
能用脚本判定的地方,塞一个模型进去,让它写一段挺像回事的评语。真正需要多视角审查的地方,却只看测试绿不绿。前者多花 token,后者多背风险,两头都没占着。
Claude Code 的 Hooks 很适合守第一类边界。Hook 会在固定生命周期运行,不管模型当时有多自信,都可以阻止未通过 lint 的写入,要求测试成功后才允许提交,或者在内容离开沙箱前清理密钥。它不是一句温柔提醒,而是一道真的过不去的门。
判断性证据要靠评测集和人。Anthropic 的智能体评测指南提到,早期靠手测、内部试用和直觉能走一段路,变化多了以后就会开始盲飞。用户说版本变差,团队却分不清是真退化还是随机波动。
所以别等智能体上线半年再补 eval。哪怕先收 20 个真实任务,固定输入、允许的工具、成功条件和失败样例,也比一句「帮我全面测试」有用。每次改 prompt、模型或工具权限,都跑同一组。新版本赢了再合,没赢就继续待在分支里反省人生。
验收不需要一开始就豪华。
它只需要可重复。
权限要跟任务走,别跟模型名走
指南里还有个容易被忽略的细节。Claude Tag 在 Anthropic 处理 CI/CD 故障时有自己的服务账号,只拿当班工程师需要的 Datadog、Grafana 等工具权限。运行说明写进仓库,团队可以像改代码一样 review 它。
厉害了,但真正厉害的不是模型会看监控,而是它没有借某个工程师的万能身份到处跑。
不少团队给智能体接工具时,会按模型能力分权限。强模型多给一点,弱模型少给一点。听着合理,实际很难管。模型会升级,任务会变化,同一个 Claude Code 会话里也可能先查日志,再改配置,再发消息。你最终说不清某次操作为什么被允许,只能回答「因为我们当时挺信这个模型」。
权限更稳的切法是跟任务走。
查故障的身份只读日志和指标,不能改生产配置。修代码的身份能开分支和提 PR,不能合并。发布任务只有在测试、审批和变更窗口都满足时,才拿到短时凭据。发外部消息则要单独确认内容与收件人。
你想想看,这套设计没有要求模型永远听话。它默认模型会误解、会跑偏、会被脏数据带歪,然后把单次错误能造成的损失压小。
这也是为什么 MCP 或 gh、kubectl、psql 这些工具接进智能体时,最先要设计的不是工具描述写得多漂亮,而是账号、作用域、超时、重试和审计。尤其是有副作用的操作,读和写最好从工具层就分开。模型不该靠克制来守权限,系统要靠边界来守。
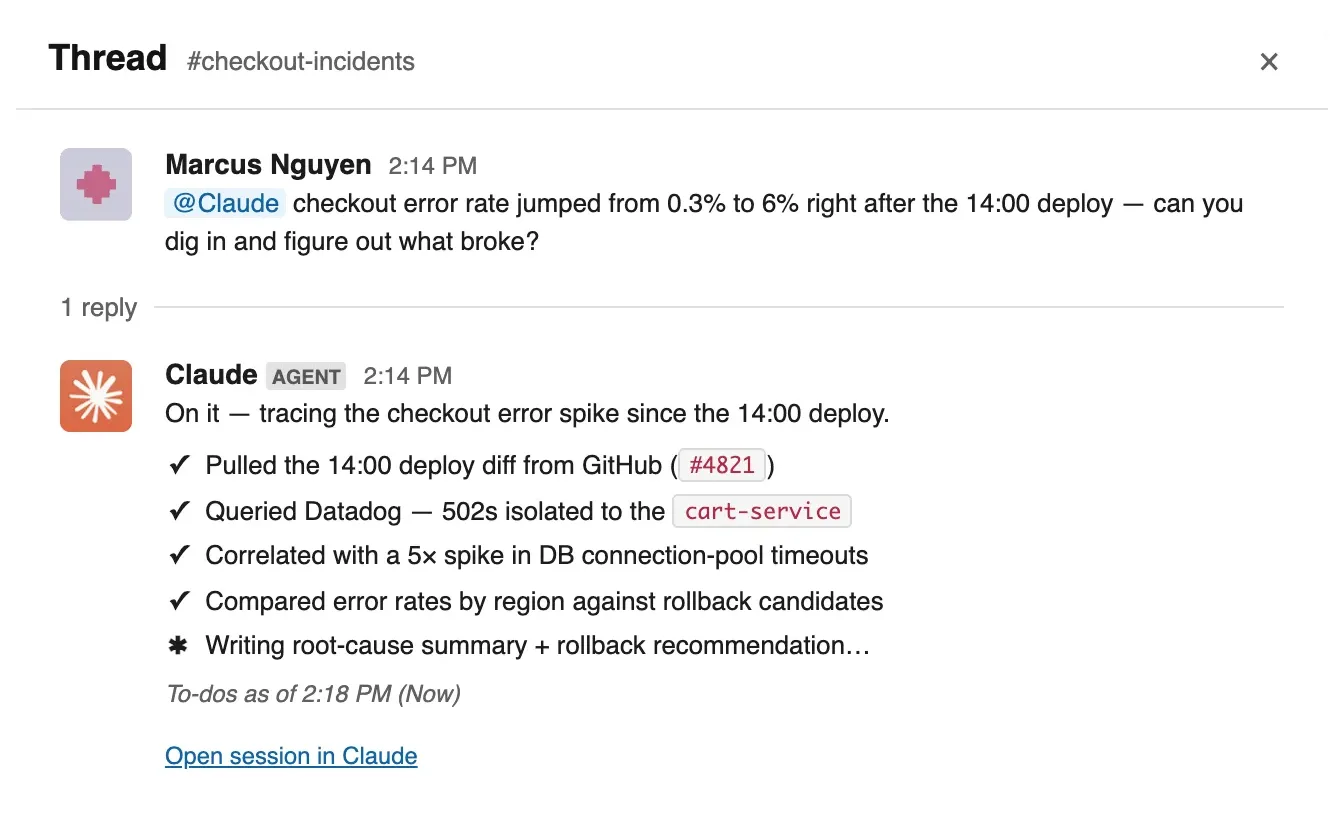
Claude Tag 在事故线程里查询部署差异与指标,但它拿的是任务所需权限,不是工程师的万能身份。
说真的,这部分不性感。发布会上没人举着「我们把只读账号配好了」的牌子欢呼。
可生产系统的安全感,经常就是由这些没法做海报的东西拼出来的。
让回滚比生成更快
Anthropic 观察到的另一条规则是为重建而设计。模型能力一直往前拱,今天费劲搭的脚手架,过几个月可能就该拆了。Clay 的说法更直接,同一个东西会造一遍、再造一遍,到了第四遍才真正知道需要什么。
这听着有点浪费,其实怕的不是重建,怕的是新旧两套代码黏成一团,谁也不敢删。
AI 会显著降低加代码的心理成本。多一层适配器,多一个兼容分支,多一套生成文件,看起来都只花几分钟。删除却需要确认调用方、迁移数据、观察指标,还得找到愿意签字的人。久而久之,仓库像一个只进不出的储物间,门还能关上已经算工程奇迹。
所以每个智能体改动都该提前回答回滚问题。数据库变更有没有向后兼容窗口,配置能不能一键切回,旧路径保留多久,指标出现什么信号就自动停止。不是上线失败后再开会想,而是在 PR 里和测试证据一起出现。
Git worktree 在这里很好用。它能让新版在隔离目录里与旧版并排存在,共用仓库对象,又不互相踩工作区。复杂重写则先用 plan mode,让模型先读代码、列影响面、写迁移方案,人在最便宜的阶段纠偏。
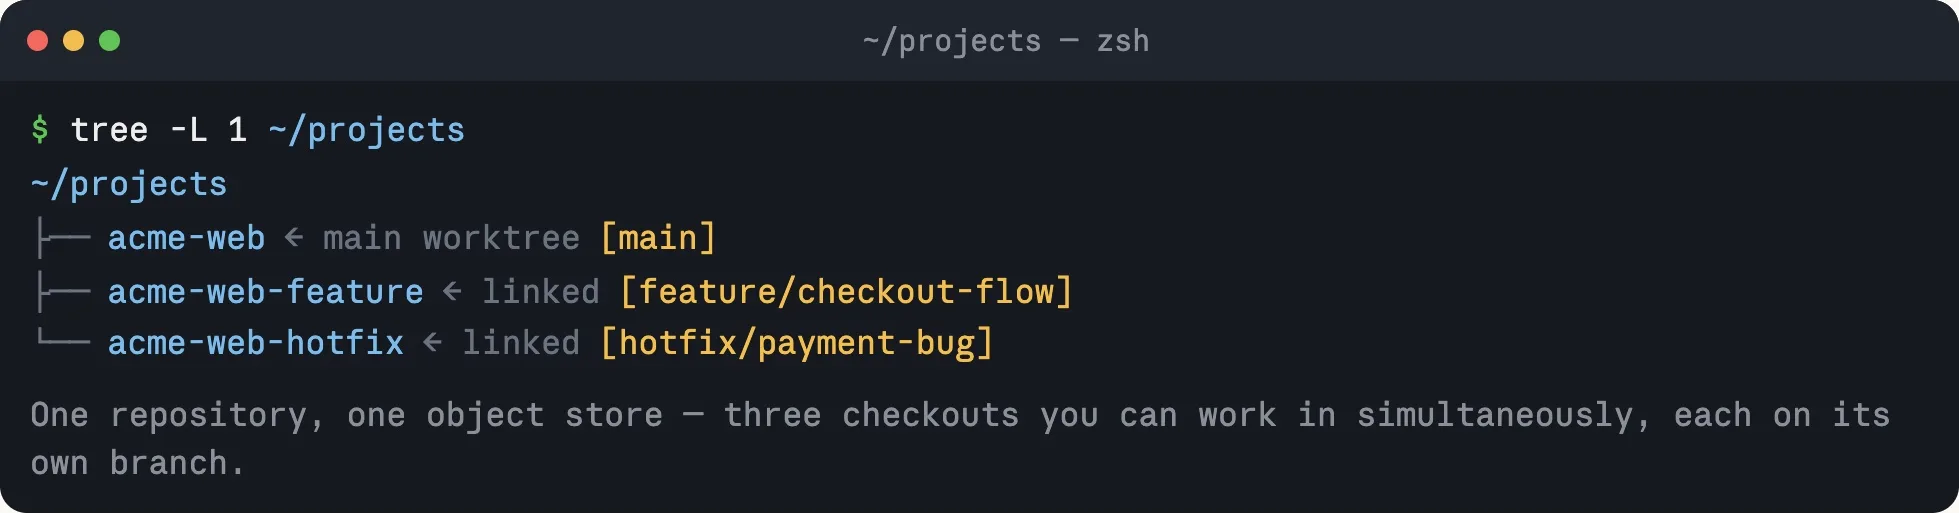
一个对象库旁边开三个隔离工作区,新版、主线与热修复不必互相踩脚。
这里的关键不是多学两个 Claude Code 功能。
是把团队默认动作从「生成完就往前推」,改成「先准备退路,再允许往前推」。
生成要三分钟,回滚要三小时,这条流水线不算快。它只是把时间账欠到了事故那天。
一张 PR 模板,把四道闸装进去
如果团队明天就想试,不必先采购一套写着 Agent Governance 的昂贵平台。先改 PR 模板就行。
入口处让提交者写清改动范围和禁止触碰的区域。不要只写「优化登录体验」,要写这次允许改前端表单和错误文案,不允许改鉴权策略、会话时长与数据库结构。模型拿到的任务越宽,reviewer 需要排除的可能性越多。边界写窄一点,不是在束缚智能体,是在给审查省命。
接着放验收证据。确定性检查要贴命令和结果,例如 pnpm test、ruff check、迁移 dry run、依赖扫描。判断性检查则贴前后对比、关键用户路径、失败样例和评测结果。别只截一张绿色终端图。一个测试套件全绿,可能只是它压根没覆盖这次真正改坏的地方。
再往下写本次任务实际用过的权限。读了哪些仓库,调了哪些服务,是否碰过客户数据,有没有向外部系统写入。模型生成的 diff 能看见,工具调用留下的副作用却常藏在聊天记录里。把它们拉回 PR,reviewer 才知道自己批准的是一份代码,还是连同数据库、工单和通知一起批准。
收口处只问退路。回滚命令是什么,谁能执行,多久能完成,哪些数据写入无法撤销,看到什么指标必须停。没有退路的改动不是绝对不能上,但它应该自动进入更高一级的人工审批,而不是混在几十个普通 PR 里悄悄过去。
模板可以很朴素。
改动范围  允许改什么,不允许改什么
业务负责人  谁确认需求与例外
生产负责人  谁确认架构与运行风险
硬性检查  命令、退出结果、制品链接
判断检查  对比、评测、人工结论
工具权限  读取、写入与外发记录
回滚路径  命令、耗时、不可逆数据
停止信号  哪个指标出现就立刻撤回
这八行的作用,不是再给工程师加一份表格劳动。它在训练团队把「模型说做完了」翻译成「我们有证据允许它合并」。随着流程稳定,其中大半都能由 CI 自动填写。人只需要确认边界、判断和责任人。
怎么说呢,AI 编程最容易让人上瘾的,是几分钟后屏幕上突然多出一大片能跑的代码。合并模板偏偏逼你慢下来,看那些没有掌声的东西。权限,失败样例,回滚,值班人。
慢这几分钟,通常比事故后快几个小时划算。
代码所有权不会被 token 稀释
走到这里,最难的一块反而不是工具,而是人。
假设一个常见场景,销售同学用 Claude Code 做了线索分流原型,工程团队把它接进正式系统,三个月后规则误伤了一批客户,这块代码归谁?原型作者可能不了解部署,接手工程师可能不了解业务,模型当然不会来值班。
如果答案是「大家一起负责」,通常等同于没人负责。
人人都能贡献,不等于所有权可以消失。更健康的做法是把原型作者当领域负责人,把工程 owner 当生产负责人。前者确认需求与例外,后者确认架构、观测、权限和回滚。两个人都不必包办所有工作,但合并之前必须有人对业务正确性签字,也必须有人对运行正确性签字。
Claude Code 的 Code Review 可以并行检查 PR,自定义 agent 也能从安全、性能、兼容性几个角度扇出审查。挺好,省下来的 reviewer 时间应该去看最需要判断的地方,而不是拿来把更多 PR 塞进队列。
工具的价值不是替团队取消责任。
是把人的判断留给真正值得判断的部分。
坦率讲,我也不确定未来的最佳组织结构会长什么样。也许产品和工程的边界会继续变薄,也许代码会像文档一样由更多角色共同编辑。但只要软件还会碰到真实用户、真实钱和真实数据,合并权就不会因为 token 便宜而自动民主化。
它只会变得更贵。
一周 6000 个 PR 确实有点子牛逼。可衡量一支 AI 原生团队的,不该只是它能生成多少改动,而是它能拒绝多少证据不足的改动,又能在出错时多快退回来。
人人都能写第一版,是创造力的扩容。
有人守门、有人签字、有人接住,才是交付。