posts/claude-eval-deployability-gap.md
Claude 的 0.613 过线了,16 人仍不敢让它顶岗
Anthropic 最新公开的风险报告里,藏着一组挺扎心的数据。
Claude Opus 4.6 在一套内部 AI 研究评测里拿到 0.613,越过了 0.6 的排除阈值。这个阈值由评测设计者设定,用来判断模型是否可能达到初级研究科学家或研究工程师的等价水平。
看起来,线过了。
可 Anthropic 又问了 16 名技术员工另一个问题。只做适度的脚手架和工具改进,三个月内把它变成初级 L4 研究员的直接替代,成功概率能不能超过 50%。
没有一个人点头。其中一人没有直接回答,其余人都认为还不行。
好家伙,排行榜说门已经开了,天天用它干活的人却还站在门口,不敢把工牌递过去。
这不是谁在打谁的脸。两组结果测的压根不是同一件事。
0.613 测的是模型能不能在一组被缩小、被定义、能自动判断成败的研究任务里交出答案。16 人的调查测的是另一回事,能不能把一块持续一周、目标会变、信息不完整、还得自己做取舍的真实工作扛下来。
一个像考试。
一个像上班。
差的那截,正好是做 Agent 产品最容易被忽略的工程层。
报告里的第一组证据来自 SWE-bench Verified 困难子集。这里的题目经过人工确认可以解决,Opus 4.6 平均做出 45 道里的 21.24 道。
第二组内部任务要求 Agent 改进机器学习代码、训练小模型,Opus 4.6 在大多数任务上达到或接近饱和。
第三组就是那条最容易被截成海报的 0.613。任务来自 Anthropic 的对齐研究培训材料,以及研究人员过去做过的项目缩小版。目标清楚,判分清楚,环境也为评测准备好了。
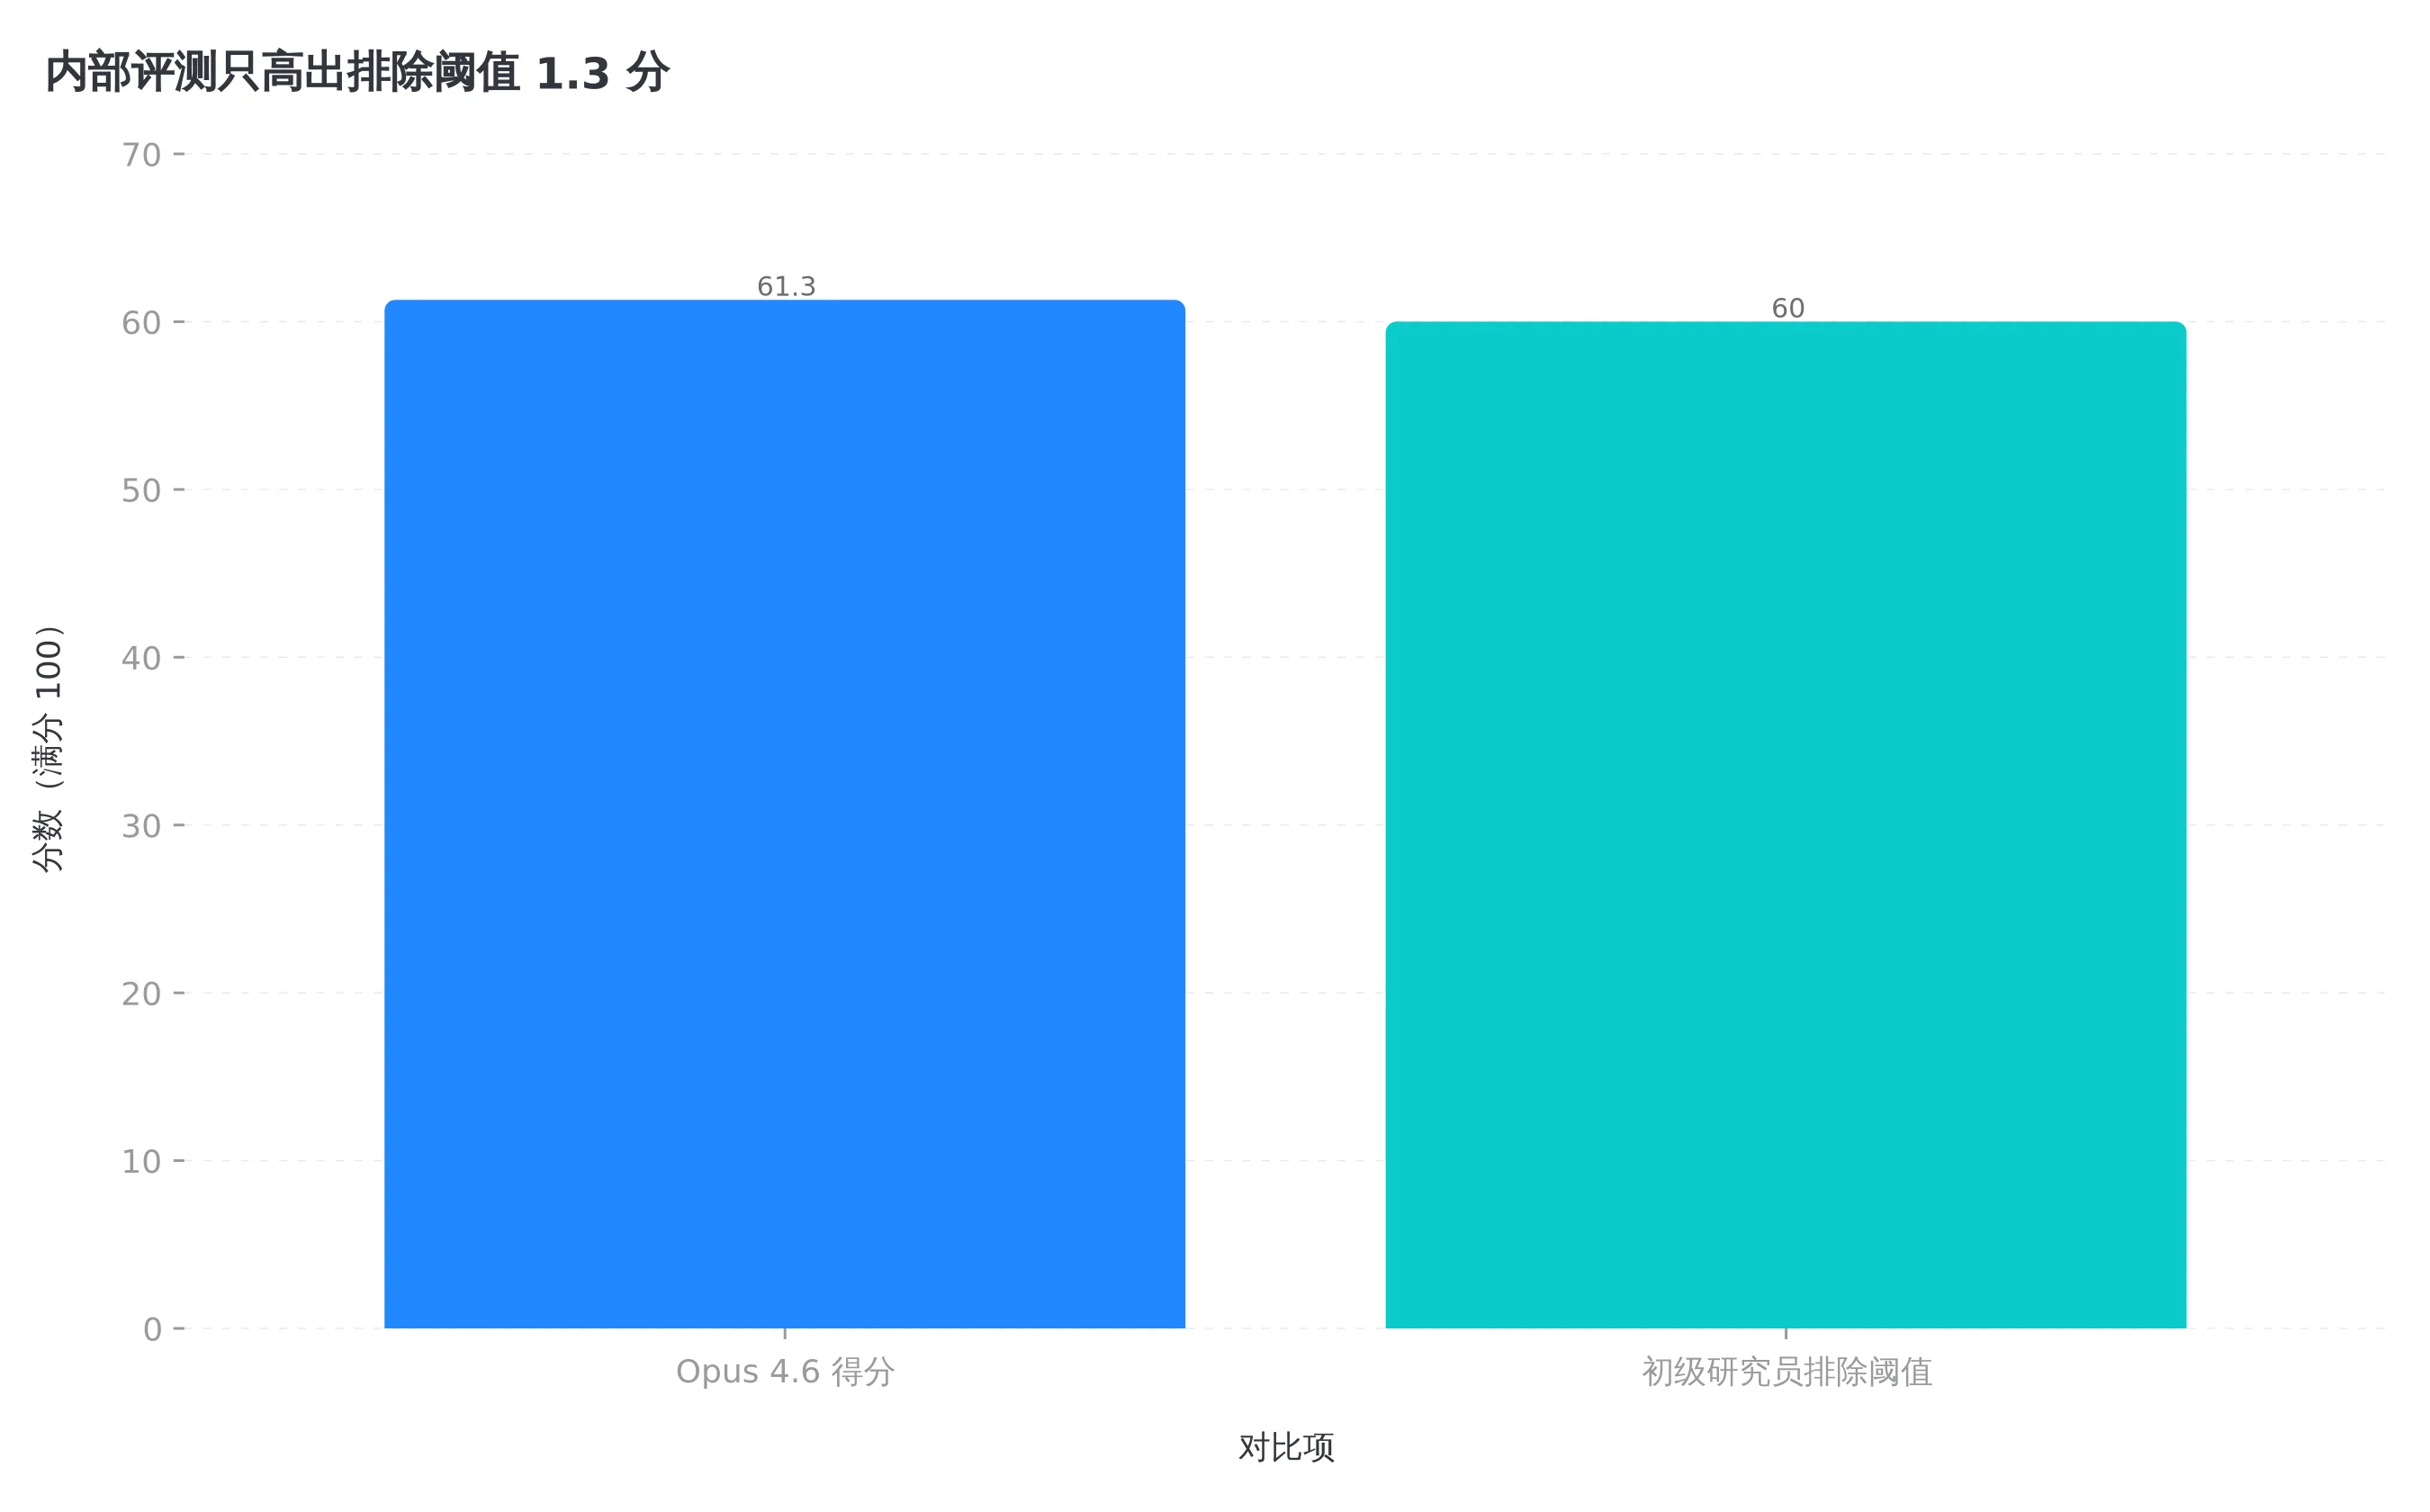
官方报告中的 0.613 换算为 61.3 分,只比 0.6 的排除阈值高 1.3 分。过线是能力信号,不是岗位验收。
厉害了,三个信号都指向同一个结论。只要问题边界收得足够好,Claude 已经能碰到初级研究人员的能力区间。
但报告紧接着写了一句更重要的话,模型可能正在接近处理「范围明确、成功标准清楚」的初级研究任务,距离自动化完整的 AI 研发工作仍然很远。
限定词都在引号里。
范围明确。
标准清楚。
很多 Agent 项目偏偏从这两个条件消失以后开始翻车。
假设一个常见场景。团队让 Agent 处理一个边界明确的 bug,仓库能安装,测试能跑,错误栈也给全了。它可以搜索代码、改文件、执行测试,直到绿灯亮起。这样的任务天然适合自动评测,成功与失败写在退出码里,模型也知道什么时候该停。
再把任务换成「把这个服务的延迟降下来,别影响下周发布」。
它得先判断延迟是数据库、网络、缓存还是观测口径的问题。中途发现业务准备改接口,还得决定原计划要不要扔。某个查询快了 20%,却让成本翻倍,它得知道团队更在意哪一个。测试全绿也不代表工作结束,因为发布窗口、回滚方案、值班风险和另一个团队的依赖都不在测试里。
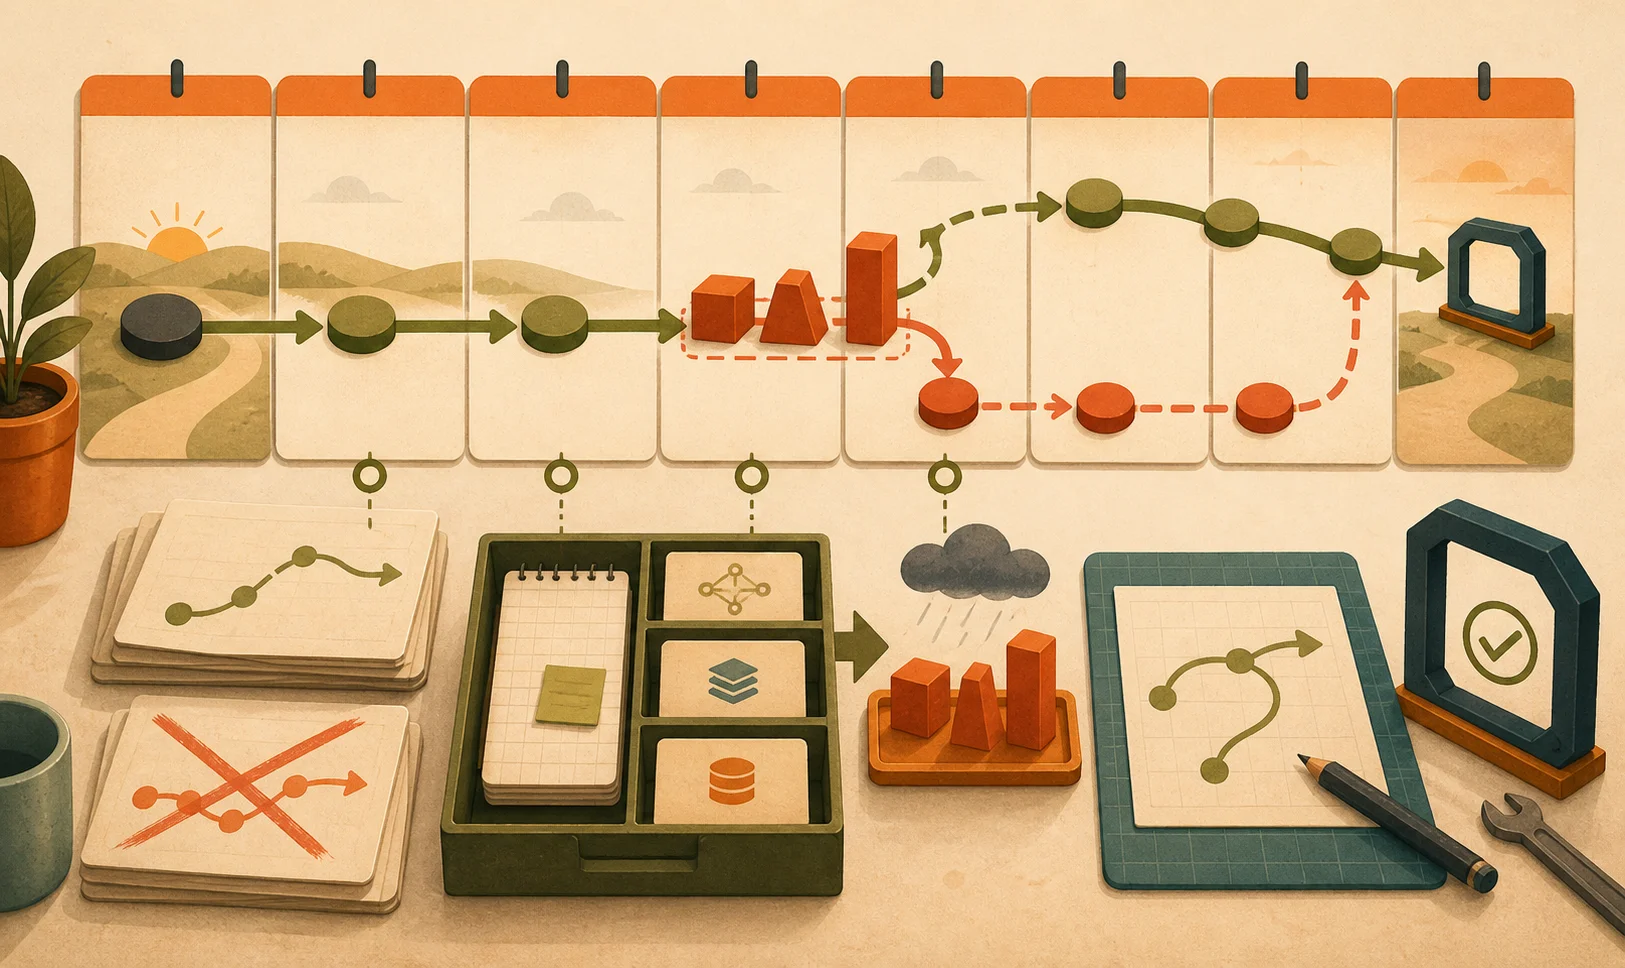
长任务真正难的不是让循环一直跑,而是保存中间判断,在约束变化后知道何时放弃旧路线。
不是哥们,这时候多给模型一把终端工具,解决不了「到底什么算做完」。
16 名员工指出的缺口非常具体。模型不能稳定地自主管理持续一周的模糊任务,缺少组织上下文来做优先级取舍,在大型代码库里缺判断品味,也不擅长在新信息出现后主动修订计划。
这里的「品味」听起来有点玄,其实一点不玄。
同样能通过测试的两个补丁,一个只改 30 行,沿着现有抽象走;另一个新建四层接口,顺手引入三个依赖。哪个更适合这个团队,不在语法里,也不在单次 benchmark 里。它藏在半年后的维护成本、仓库过去踩过的坑、谁负责值班,以及团队对复杂度的容忍度里。
这些信息很少完整地写进 prompt。
有些甚至从来没人写下来。
Anthropic 另一项基于约 40 万次 Claude Code 会话的研究给了一个很好的旁证。典型会话里,人做了约 70% 的规划决策,Claude 做了约 80% 的执行决策。领域经验更深的人,每条指令能带动 Agent 做更多工作,成功率也更高。
这个分工很像今天生产环境里的真实状态。人决定做什么、什么算对、出了新信息往哪转,Agent 负责把执行链跑起来。
所以,模型越强,人越不需要敲每一行代码,却越需要把模糊目标变成可验证任务。
有点子牛逼的地方在这儿。Opus 4.6 的原始能力已经强到让传统评测开始失去区分度,可员工调查依然能立刻指出它不够像同事的地方。不是不会写,而是不会长期拥有一个问题。
这也解释了为什么「任务时长」正在成为 Agent 评测里更重要的一条轴。METR 的 time horizon不只问模型能做多少题,而是问一件人类专家需要做多长时间的任务,Agent 能以给定成功率独立完成。METR 也明确提醒,超过 16 小时的测量在当前任务集上并不可靠。
连评测机构自己都在说,越长的任务,越难测准。
模型能连续运行很久,不等于它能连续做对很久。进程活着、token 还在吐、工具调用没有报错,只能证明循环没死。方向有没有偏,旧计划有没有过期,新增信息有没有被吸收,才决定那一夜的计算落地后是成果还是一张账单。
Anthropic 在长时间科学计算 Agent 的实践里给出的方案也很诚实。多日任务需要测试预言机、持久记忆和编排模式,把中间状态保存下来,让下一轮知道做过什么、为什么这么做、接下来用什么证据验收。
模型能力只是其中一层。
剩下的是脚手架。
如果正在给 Agent 上生产,我会把验收从「模型得分」改成五份任务合同。这里不是教科书答案,只是一套能把事故提前暴露出来的检查法。
第一份写目标边界。Agent 收到的不是「优化这个服务」,而是要把哪个接口的 P95 从多少降到多少,不能牺牲什么,允许改哪些目录,预算和截止时间是多少。
第二份写可验证证据。单元测试、回归集、性能曲线、diff 大小、成本上限、人工抽查,各自占多少权重。没有独立验收信号,Agent 很容易把「我已经做了」当成「事情已经对了」。
第三份写计划失效条件。依赖版本变了、需求口径变了、连续两轮没有改善、成本超过阈值,出现哪一种就必须停下来重做计划,不能沿着旧路线继续烧 token。
第四份写组织上下文。哪些模块不能碰,谁是代码所有者,历史上为什么放弃某个方案,发布窗口和回滚纪律是什么。让 Agent 读 README 只是起点,它还需要一份能被版本管理的决策记录。
第五份写责任边界。哪些动作可以自动执行,哪些必须让人确认,失败后谁接管,产物保存在哪里。权限给得越大,这份合同越不能靠一句「谨慎操作」糊过去。
把这五份合同放进流水线,模型更新时才有东西可回归。新模型跑分涨了,不急着全量切流,先让它在同一批黄金任务上比首轮成功率、重试次数、人工审查分钟数、工具成本和回滚率。
这几个数可能没有 0.613 好看,却更接近月底账单和凌晨告警。
还有一个容易被漏掉的指标,失败以后人要花多久把现场救回来。
有些 Agent 首轮成功率看着不错,失败样本却特别难收拾。它可能改了十几个文件,测试只红一条,真正的问题藏在一段悄悄变化的配置里。人工不是重新写一遍,而是先恢复上下文、判断哪些改动能留、哪些必须回滚,再把仓库带回可继续工作的状态。
这段接管时间应该单独记账。
同样是一次失败,沙箱里退出码为 1,和线上留下一堆需要人肉考古的半成品,成本完全不是一个量级。前者是模型没做成,后者是系统把失败扩散给了团队。
比较新旧模型时,可以把失败样本按类型固定下来。需求理解错了算一类,计划过期没有重做算一类,工具调用成功但业务结果错了算一类,越过权限边界算一类。每一类都保留可复现任务、预期证据和接管步骤。
这样模型升级才不是重新看一遍发布会跑分,而是把旧伤疤逐个按下去,看看还疼不疼。
如果新模型在黄金集里多做对五道题,却让失败接管时间翻倍,我不会把它叫作生产升级。顶多叫能力更强、收拾起来也更贵。
报告里的生产率估计也值得冷静读。员工给出的提升范围从 30% 到 700%,中位数是 100%。跨度大得像在讨论十六种不同的产品。
很可能确实如此。
任务边界、使用者经验、代码库质量、验证工具和权限设计只要换一项,同一个模型就像换了一份工作。拿超级用户的 700% 去承诺所有团队都翻倍,跟拿 benchmark 冠军去保证线上零事故差不多,都属于把条件从海报底部裁掉了。
Anthropic 的 Opus 4.6 发布页说它更擅长长任务、大型代码库、代码审查和调试。官方的系统卡索引则把能力评测、风险判断与部署决定放在一起。两份材料都重要,但它们回答的是模型能做什么、在什么保护下发布。
你的团队还得回答第三个问题。
它在你的任务、你的仓库、你的权限和你的失败成本里,能稳定做到什么。
这才是 Agent 上线前真正该过的线。
0.613 不是假的,16 个人的摇头也不是保守。前者说明模型的能力上限已经压到门口,后者提醒我们,真实工作不是一组边界干净的题。
模型可以租,判断不能外包。
等哪天 Agent 不只会执行计划,还能在新信息出现时知道什么时候该推翻自己,那张工牌才真的可以递过去。