posts/claude-fermat-proof-verification.md
1300 万行 Lean 代码,没替人类发现新数学
费马大定理早就被证明了。Claude 这次干的,是把一条 129 页的人类证明,变成任何人都能让机器逐步验算的工程制品。
1300 万行 Lean 代码摆出来,第一反应很容易跑偏。
有人会说,AI 11 天就把费马大定理证明了,数学家是不是该收拾书包了。
也有人会盯着数字犯嘀咕,1300 万行,这不就是把模型吐出来的代码堆成了山吗。
两边都没抓到这件事真正有劲的地方。
Anthropic 公开的成果,不是 Claude 在 2026 年突然找到了一条没人见过的证明路线。费马大定理从 1995 年起就有了人类认可的证明。Claude 做的是把 Frey、Serre、Ribet、Wiles 和 Taylor-Wiles 那条已经成立的论证路线,翻译进 Lean 4 这种形式化证明语言。
这活听着像翻译,干起来却一点不轻松。
自然语言里的数学证明,靠的是同行共享的背景知识。某一步省略了,读者知道该补哪条引理。某个符号换了记号,专家也能跟上。机器不吃这一套。每个定义来自哪里,某个结论依赖哪些前提,两个看上去一样的对象到底是不是同一个对象,都得落到能检查的符号上。
好家伙,原来那种「我大概看懂了」的阅读体验,到这里一律不算数。
不是解出一道题,而是交付一件能验收的东西
Anthropic 说,Claude 大体自主运行了 11 天。官方仓库给出的规模是 1300 多万行 Lean 代码,还把完整证明、阅读路径和核验方式一并开源在 GitHub。
这几个数字很猛,可我更在意仓库里那份有点枯燥的 README。它没有只写「模型得到了证明」,而是把怎么确认这份证明没有走捷径写得很细。
项目的默认构建会跑 FinalCheck.lean。这里检查的不是一张宣传海报,而是费马大定理那条声明到底依赖哪些公理。仓库明确限制为 Lean 的三条标准公理,并拒绝 sorry、额外 axiom、native_decide 这类能把空洞塞进证明里的东西。
这一步像什么。
你让一个代码 Agent 给线上服务改了几千行代码,它说「测试过了」。这句话本身没多少重量。你会继续问,跑的是哪套测试,依赖版本锁没锁,覆盖到了哪条交易链路,有没有把失败吞掉。
形式化证明也一样。模型写出几百万行并不自动等于结论可靠。可靠性来自那套能复跑的检查条件。
仓库里还给了三层核验。
第一层是从头构建,官方说明中写着,60,475 个模块被构建,每个声明交给 Lean kernel 检查。
第二层是 leanprover/comparator 对构建结果与挑战声明做比对,确认声明和常量没有偷偷换题。
第三层是用独立实现的 Rust 内核 nanoda 再检查一次导出的环境。这个细节特别像工程师的习惯,别只让一套验证器给自己签字。
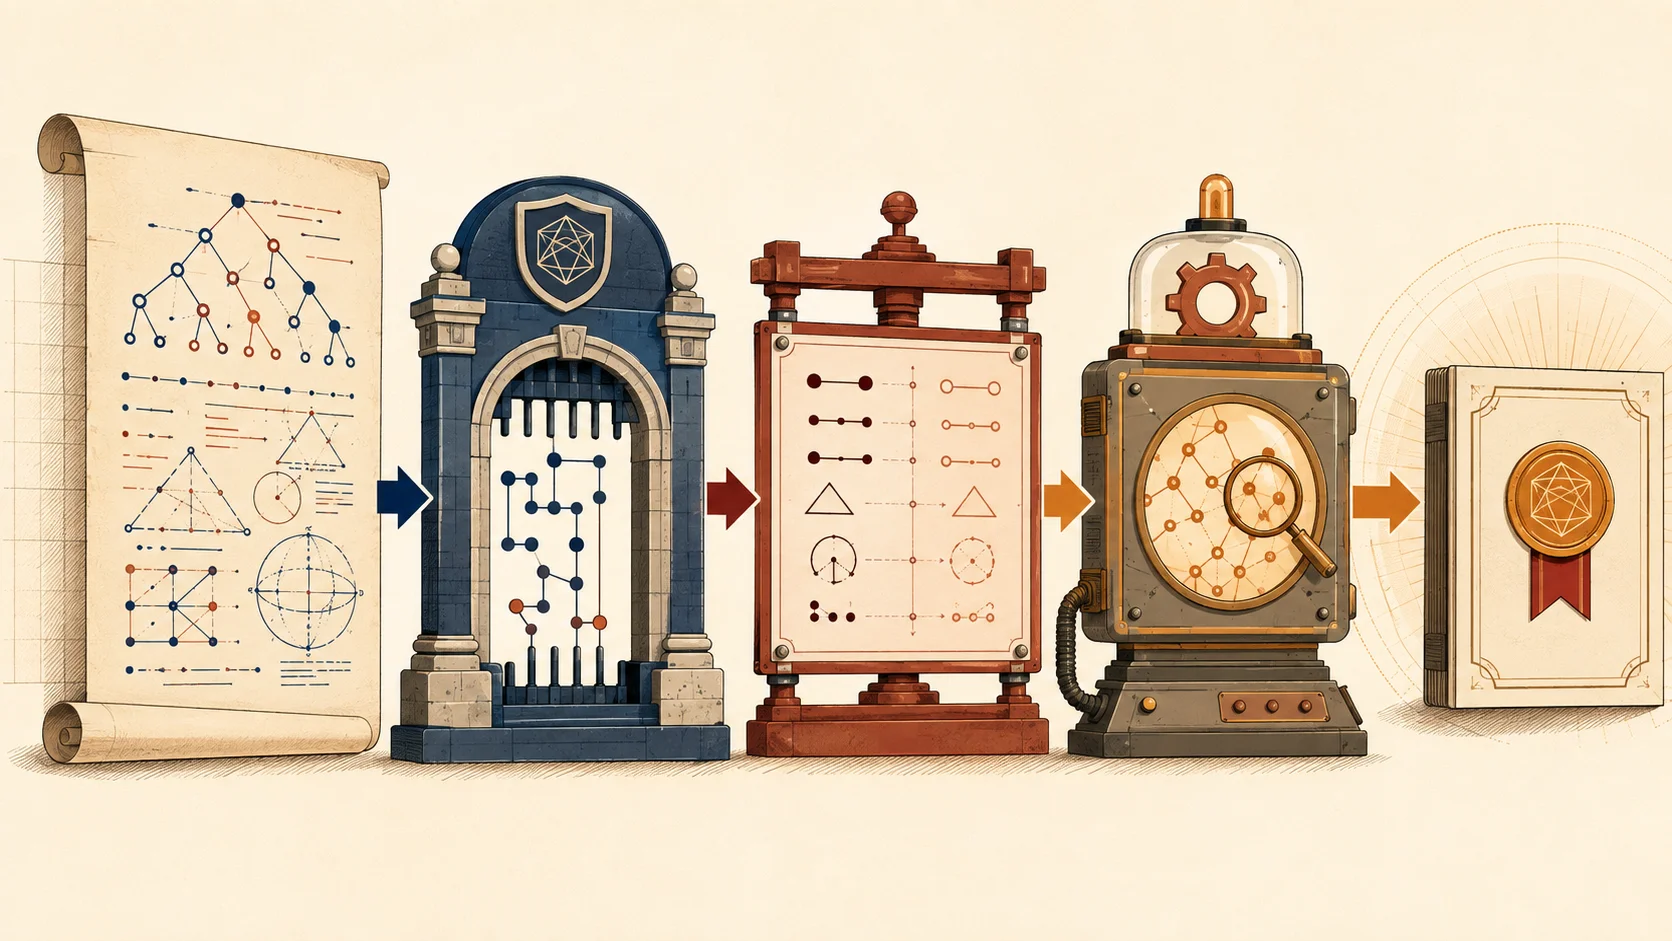
从模型生成,到 Lean 内核,再到独立比较器与第二内核。重点不是信任哪一个模型,而是把信任拆开。
厉害了,这才是我想看到的 AI 研究产物。不是一段「它好像做到了」的演示视频,而是一件别人能下载、构建、质疑、复查的东西。
机器检查很硬,但它没有替你理解数学
这里也得泼一点冷水。
Lean 能检查的是,给定这些定义、这些公理和这些推导规则,最后那条定理有没有被严格推出。它不替你判断一个中间定理的命名是否误导,不替你判断形式化出来的命题有没有在翻译时悄悄变形,也不替你发现人类最初选的研究方向是不是值得做。
Anthropic 在仓库里把这点写得很直接,工具能检查推导链,读者仍要判断每个中间结论的数学含义。于是那份 PROOF-PATH 才不是附件,它是让人能从人类数学语言走到机器对象的一张地图。
这也解释了为什么不能把新闻翻译成「AI 11 天解决了费马大定理」。
它解决的,是把一条已有证明变成端到端机器可检查对象的巨大工程问题。那条路上还有 Imperial College London 的 FLT 项目、Mathlib 和很多数学家的长期积累。Claude 把它们接到了一起,还跑完了一段以前昂贵得让人望而却步的路。
这两件事都很了不起,只是不是同一件事。
把「发现」和「验证」分开,不是给模型降温。恰恰相反,这让人看见了一个更能落地的变化。
科研里最贵的部分,经常不是写出第一个猜想,而是确认它到底经不经得住推敲。长证明会积累口头省略,复杂系统会积累隐含假设,跨学科协作会积累版本错位。过去这些活主要靠时间、专家和耐心硬磨。
现在,模型开始把其中一块搬进可执行的验证链路。它不能替代判断,却能把「请再检查一遍」从一轮漫长的人肉劳动,压成一次公开、可重跑的构建。
有点子牛逼的地方就在这儿。
对写代码的人,这件事比数学新闻更近
别急着去装 Lean。多数人今天不会写一个费马大定理证明。
但如果你已经在让 Agent 改代码、写迁移脚本、整理研究资料,这次项目给了一个很实在的提醒,模型输出别只当答案看,要把它当作一件待验收的工件。
第一件事,给结论留证据链。
一段 Agent 生成的修复,至少应该带上测试命令、输入样例和失败时的输出。模型写得再像人,也别只看 diff 顺不顺眼。它能跑过什么,跑不过什么,要和代码一起留下来。
第二件事,把环境锁住。
Anthropic 的仓库明确固定了 Lean 和 Mathlib 的版本。这个动作在日常工程里再普通不过,少了它,今天的通过可能只是因为本地依赖刚好宽容。研究和生产都一样,复现不是一句口号,是你下个月还能不能按下同一条命令。
第三件事,让检查器彼此独立。
单元测试、类型检查、静态分析、集成测试,最好别全用同一份假设给自己背书。费马项目用第二个内核复核,是很极端的版本。普通团队不用照抄,但可以问一句,你的验收是不是只是在重复模型已经做过的判断。
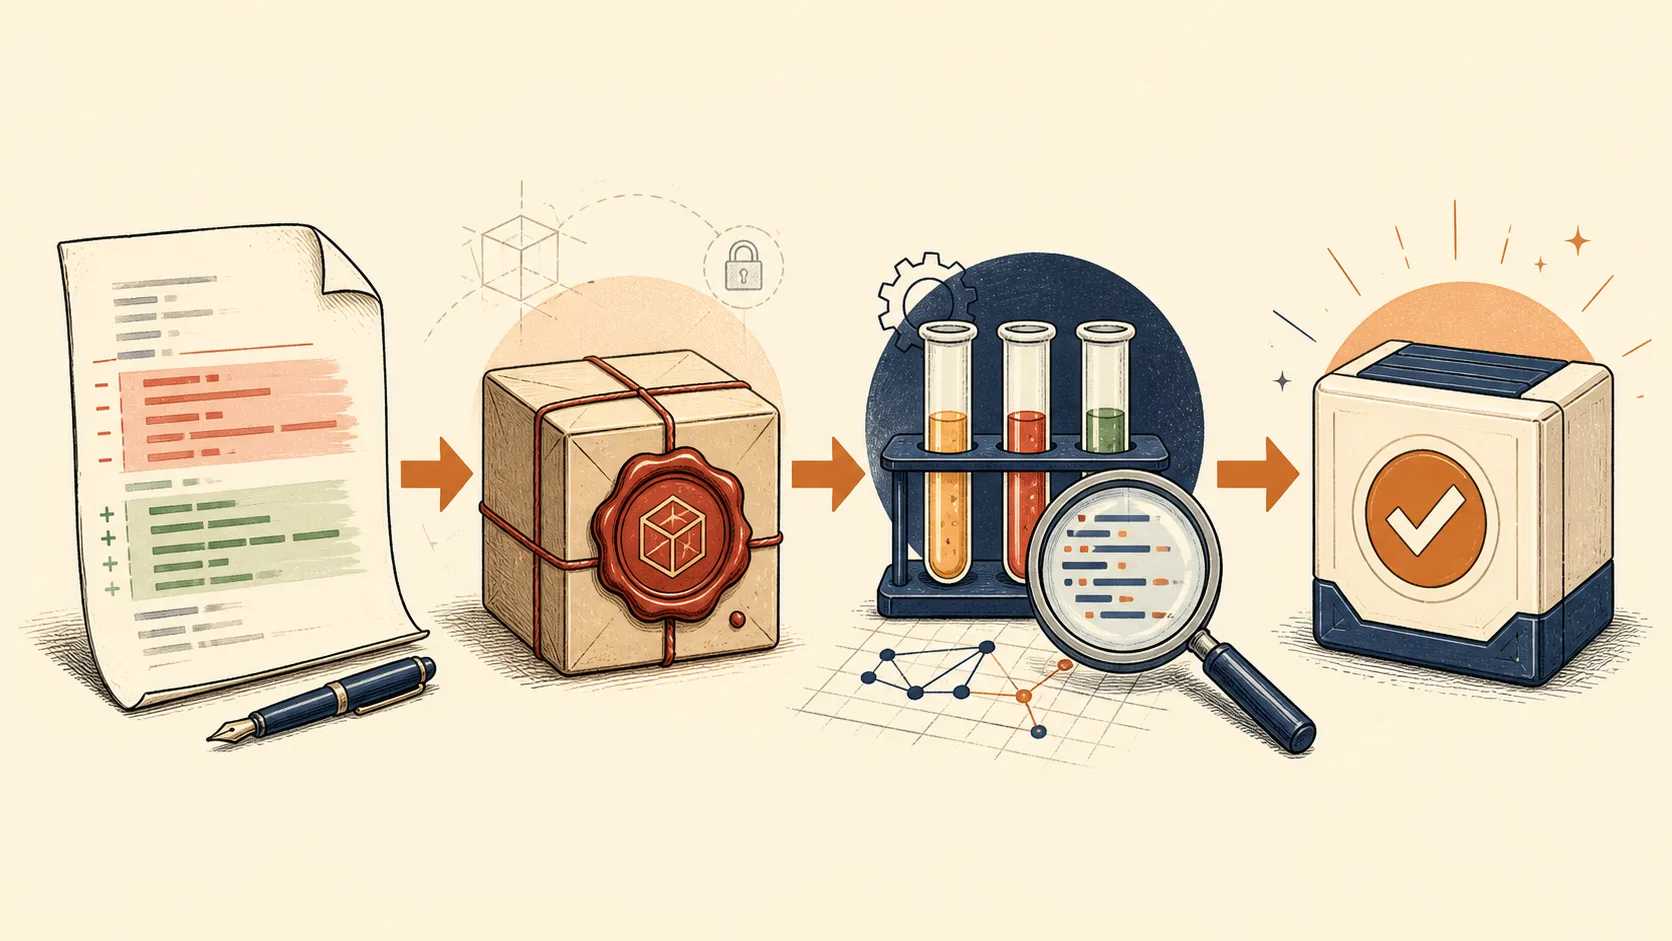
模型负责生成候选方案,版本锁和多种检查把候选方案变成能交付的工件。
这套想法听着不性感。发布会上不会有人为「可复跑」鼓掌。
可真到了线上,真正让人睡得着的,往往就是这些有点笨的东西。日志在,版本在,检查能重跑,失败不会被一段漂亮的解释盖过去。
这次更像一张路线图
费马大定理本身没有被重新发明。
Claude 也没有让数学家的工作结束。
它把一条极长、极难、极依赖专家耐心的证明路径,变成了一件可以公开交付的验证工件。人类仍然决定研究什么、符号有没有表达对、结论值不值得追。模型擅长的部分,是在这条路上持续写、持续补、持续接受机器的挑错。
以后回头看,1300 万行也许只是新闻标题里最显眼的那个数字。
更大的变化可能是,越来越多需要信任的复杂结论,不再只躺在某个专家的脑子里,或者一篇很难读完的 PDF 里。它们会带着构建脚本、版本、测试和一条别人能走回去的路。
这才值得慢慢想。
关键资料可查阅 Anthropic 的项目说明、完整 Lean 仓库、Lean 4 与 Mathlib。