posts/claude-maintenance-review-loop.md
388 个 PR 只合了 180 个,AI 维护最难的不是写代码
388 个 PR,合并了 180 个。
这组数字来自 Claude Code 团队的 Boris Cherny。他在一条公开帖子里说,过去几周,他们让 Claude 接管应用的日常维护。一个 Slack 频道,一批每天自动运行的例程,覆盖 iOS、Android、桌面端、Web、CLI 和 Agent SDK。
崩溃模糊测试会在模拟器里到处点击,找到崩溃路径,再追根因、提修复。重复代码统一会扫描那些长得差不多、行为又悄悄分叉的抽象。死代码清理更谨慎,它先删静态不可达的部分,再给疑似死代码加日志,等第二天确认没被调用,才继续动刀。
好家伙,这已经不是让 Claude 帮忙补一个函数了。它在干过去总被塞进下个迭代、然后永远留在下个迭代的维护活。
数字也足够漂亮。388 个 PR,180 个经过 Claude Code Review 和人工审查后合并。Claude 如果没改对,团队就让它调整例程,第二天再来,有时连续调几天。
但我盯住的不是 388,而是两数相减后的 208。
先说清楚,208 个未合并,不等于 208 个都被拒绝。公开帖子没有给出它们是待审、关闭、重复,还是仍在修改。把未合并偷换成失败,属于给数字硬加戏。
可这 208 个依然重要。因为它们把维护型智能体最真实的瓶颈照了出来。
代码生成速度上去以后,稀缺资源会从写代码的人,转移到能判断这段代码该不该进主干的人。
自动维护不是更长的待办清单
很多团队第一次做维护 Agent,思路很自然。把 Dependabot、lint、静态分析、测试失败、错误日志和技术债清单都喂进去,让模型一件件修。模型能跑 shell,能改文件,能开 PR,剩下的不就是定时执行吗?
Anthropic 的 Routines 文档已经把基础设施铺得很完整。例程可以按时运行,可以被 API 调用,也可以监听 GitHub 事件。它跑在云端,电脑合盖也不耽误,仓库、环境变量、网络权限和连接器都能配置。
厉害了。调度问题越来越不像问题。
真正麻烦的是,维护任务并不是一堆同质的工单。
修一个稳定复现的崩溃,验收条件很清楚。测试从红变绿,崩溃路径消失,改动范围可控。删除静态不可达代码也相对好判,编译、测试和调用图能给出硬证据。
可一旦任务变成统一重复抽象,判断就软了。两段代码相似,不代表它们应该共享同一个抽象。今天看着重复,可能只是两个业务域暂时长得像。强行合并后,一个小需求就要在公共层加第三个布尔参数,再过两个月,它会长成团队里没人敢碰的工具函数。
修复泄漏的抽象更难。什么算泄漏,谁有权改边界,改完会不会让调用方更绕,这些东西很少能靠一个测试断言说完。
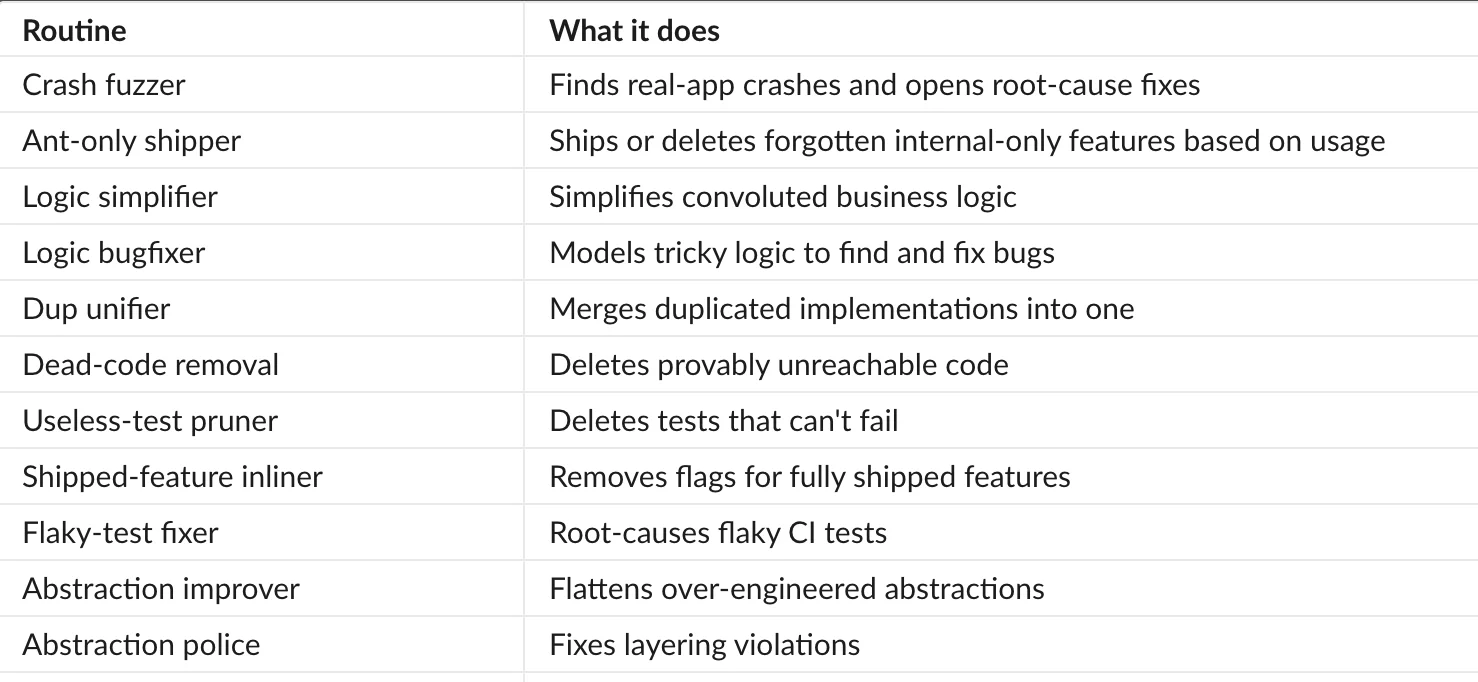
所以维护 Agent 的任务池不能只按仓库或标签分。更实用的做法,是按验收确定性分。
像崩溃复现、格式修复、已知弃用 API 迁移,可以进自动开 PR 的快车道。像死代码删除,应该先观察再执行,让日志窗口成为任务的一部分。涉及公共抽象、跨包边界、权限和数据迁移的改动,则应该默认慢下来,要求代码所有者给出明确判断。
这不是保守,是把模型用在合适的摩擦系数上。
很多朋友可能会问,Agent 不是会自己审自己吗?Claude Code 确实已经有独立的 Code Review 能力,能够在 PR 上找问题、核对改动。但自审解决的是代码有没有明显缺陷,不会自动替团队决定某个抽象是否符合未来半年的产品路线。
测试能证明代码做了它写下来的事,证明不了这件事值得做。
180 个合并背后,是一条验收流水线
原帖里有个容易被 388 抢走风头的细节。180 个 PR 不是 Claude 写完就自己进了主干,它们经过了 Claude Code Review,再经过人工审查。
这条顺序很关键。
模型负责生产候选改动,另一层模型先做机械检查,人类把注意力留给边界、意图和风险。它不是无人化,更像把人从逐行找低级错误,推到更靠近决策的位置。
可一旦候选改动源源不断,新的问题就来了。一天开十几个维护 PR,人类审查队列很快会比待维护代码更脏。PR 在列表里躺三天,基线变了,冲突出来了,原本十分钟能看的小改动,重跑测试、重新同步、重新建立上下文,又要多花一轮时间。
段错误。
这时候别急着给 Agent 加并发。先给审查队列设预算。
每个例程都应该有自己的日配额和合并窗口。低风险例程可以一天多跑几次,高风险例程一次只保留一个候选。旧 PR 没处理,新一轮就不要继续开同类 PR。否则你得到的不是持续维护,而是一台自动制造待办事项的机器。
还要给 PR 带上验收包。不是写一段五百字的总结,而是把审查者真正需要的证据放在最前面。触发这个改动的信号是什么,改了哪些边界,哪条测试证明问题消失,回滚路径在哪里,还有哪些不确定点需要人判断。
如果是崩溃修复,就附最小复现和修复前后的测试结果。如果是死代码清理,就附观察窗口、调用日志和删除范围。如果是抽象统一,就列出两个实现的行为差异,以及为什么这些差异可以消失。
我跟你说,验收包写得好不好,往往比 Agent 的解释写得像不像人更重要。审查者不是来听模型讲故事的,他要在几分钟内判断能不能承担这次合并的责任。
Anthropic 在 Claude Code 与 Slack 的介绍里强调过,团队可以在 Slack 里带着上下文召唤 Claude 开一个编码会话。Boris 的实验又往前走了一步,Slack 不只是入口,也成了例程运行和反馈汇集的控制台。
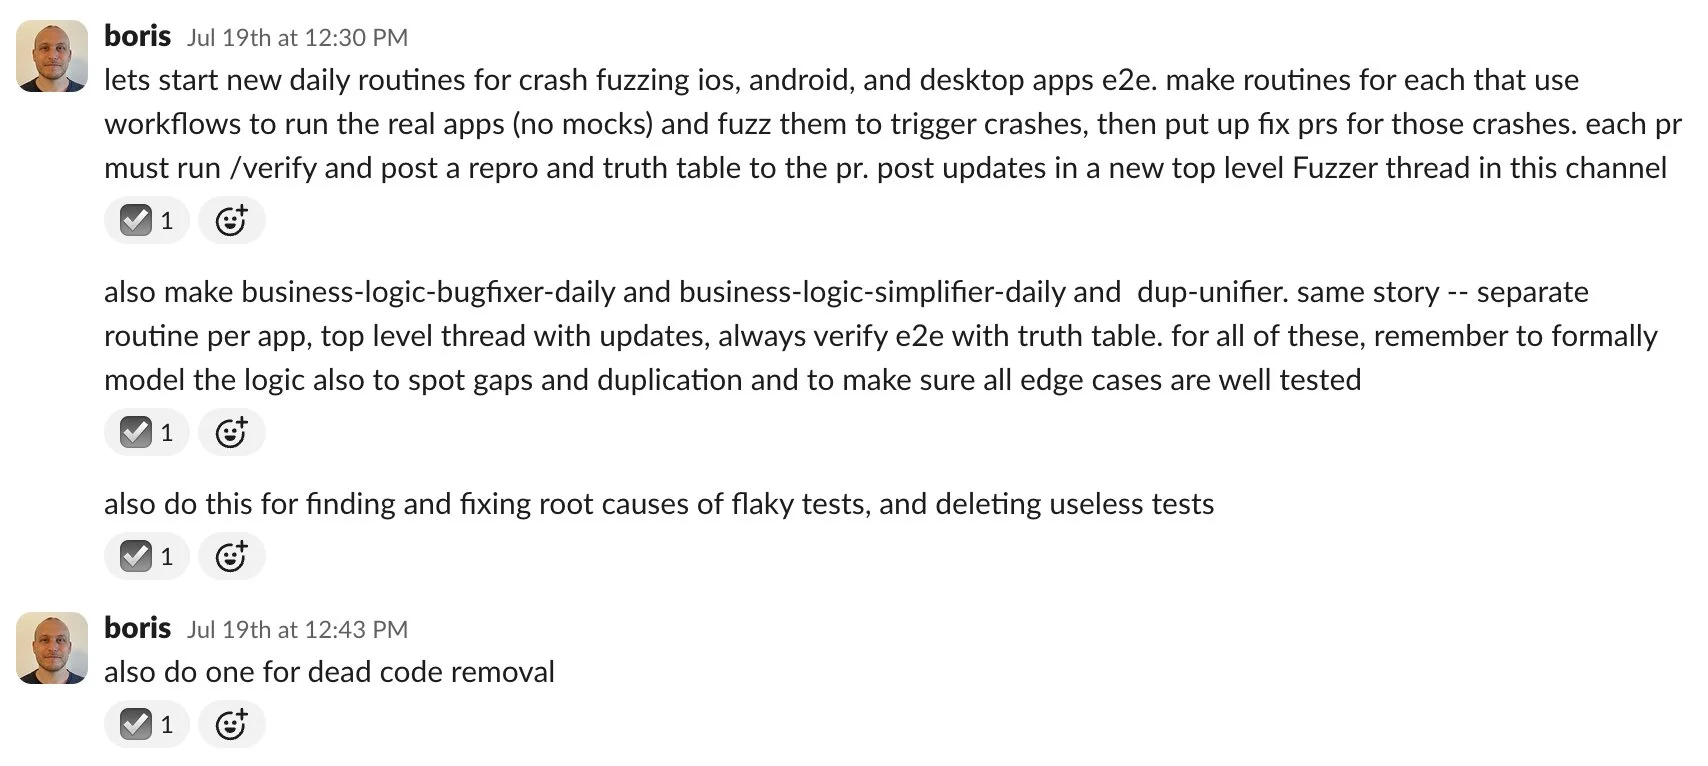
这里的关键不是聊天界面,而是上下文能不能回到同一条任务线上。谁提出问题,哪个例程接单,PR 为什么没合,第二天改了什么,最好都能沿着同一条记录追下去。否则反馈散落在 Slack、GitHub 评论和某个人脑子里,例程每天准时醒来,却每天从失忆开始。
别只调提示词,要调失败分类
原帖里我最喜欢的一句,是 Claude 没做对时,团队会让它调整自己的例程,让第二天更好。有时要连续调几天。
这个思路有点子牛逼,但也很容易被学歪。
最常见的歪法,是看到 PR 没合,就往提示词里补一句更加仔细,再补一句不要修改无关文件。几轮之后,例程提示词变成一面贴满便利贴的墙,什么都提醒了,什么也没说清。
更稳的办法,是先给未合并结果分类。
任务不该做,说明选题器错了。任务该做但范围太大,说明拆分器错了。代码没通过测试,说明执行或验证环节错了。代码没问题但不符合团队方向,说明例程缺少产品和架构约束。PR 长时间没人看,说明容量规划错了,不该怪提示词。
把这几类混成一个没合并,Agent 学不到东西,人也只能凭感觉加规则。
每次审查结束,最好让人只付出一个很小的结构化动作。选择未合并原因,必要时补一句边界说明。例程下一次启动前,先读取最近同类任务的原因分布。某类任务连续两次因为范围过大被挡住,就自动缩小文件数或改成只给建议。连续出现架构边界不清,就暂停自动开 PR,先生成一份候选清单交给代码所有者。
这才像反馈回路。不是让模型记住一句批评,而是让系统改变下一次行为。
Claude Code 的常见工作流文档也提醒,自动运行的任务要把成功标准和结果处理方式写清楚,因为它不会在半夜停下来找人澄清。对维护例程来说,成功标准不能只写测试通过,还要写什么时候不该开 PR,什么时候应该停,什么信号出现后要降级成人工确认。
坦率讲,我不建议一上来就复制 Boris 的全部例程。人家的仓库、测试、代码所有权和审查文化,可能已经为这种玩法准备了很久。把同样的提示词扔进一个测试常年半红半绿、模块边界全靠口口相传的代码库,自动化只会把旧问题开成新 PR。
可以从一条窄例程开始。
选一个高频、低风险、验收硬的任务。给它一个仓库、一小块目录、一个明确的停止条件和每天一个 PR 的额度。跑两周,不只数开了多少 PR,还记录合并率、首次通过率、人工审查时长、返工次数和回滚次数。
如果合并率低,别急着换更强的模型。先看是哪一种失败在堆积。如果审查时长持续上涨,也别庆祝 PR 产量。那只是把技术债从代码库搬进了人的收件箱。
把例程当成生产服务,不是定时提示词
维护例程一旦每天运行,它就不再是一段好用的 prompt,而是一个会持续消耗算力、审查时间和仓库变更额度的生产服务。
服务要有合同。
这份合同至少要回答几件事。它从哪里拿任务,只能动哪片目录,单次最多改多少文件,要交出什么证据,失败几次后停下来,谁能把它重新打开。你不一定要上复杂平台,哪怕先在仓库里放一份机器可读的配置,也比把边界全藏在长提示词里强。
像下面这样就够起步。
routine: crash-fixer
scope: apps/desktop/**
trigger: verified-crash-reproduction
max_open_prs: 1
required_evidence:
  - failing_test_before
  - passing_test_after
  - rollback_note
stop_when:
  - touches_auth_or_billing
  - changes_more_than_8_files
  - same_failure_twice
这不是某个官方模板,只是一份可以照着改的最小合同。重点在于,Agent 在写代码前就知道权限边界,审查者在打开 PR 前就知道该找哪些证据,系统也知道什么情况下必须刹车。
Anthropic 的目标模式文档有个很实在的建议,长任务应该定义一个可测量的终态,像测试结果、构建退出码、文件数量或清空队列。维护例程也该沿用这个思路。把修好崩溃写成目标太松,把指定复现测试从失败变成通过,且不触碰鉴权与支付目录,就清楚多了。
还有一个经常被忽略的量,改动的新鲜度。
一个维护 PR 放得越久,它越不像当初那件小事。主干继续向前,依赖升级,附近代码被人改过,旧结论会快速过期。所以例程除了限制同时打开的 PR 数,还应该给候选改动设过期时间。超过窗口没人审,就自动关闭或重新基于最新主干生成,不要让人周五下午去考古周一的自动修复。
说实话我也不确定每个团队该把窗口设成一天还是三天,这取决于仓库节奏。但有窗口,和让 PR 永久躺着,完全是两种系统。
再往前一步,给例程做影子期。前几轮只生成问题报告和拟议补丁,不真的开 PR。人类看它选的任务是否靠谱,确认误报和越界率在可接受范围,再逐步开放写分支和开 PR 权限。权限不是开或关两个档位,它可以随着证据一点点长出来。
这话听着有点像给一段脚本做入职培训,多少有些荒诞。可当它每天会改你的仓库时,这份荒诞恰好是工程该有的认真。
维护 Agent 的北极星,不是 PR 数
388 很吸睛,180 更有用。
PR 数量是生产端指标,合并质量和审查成本才是系统指标。再往后看,真正该关心的是例程有没有减少线上崩溃,有没有压低重复代码增长速度,有没有让代码所有者少接几次半夜告警。
如果一个例程每周开二十个 PR,却让两名核心工程师每天多花一小时审查,它也许很勤快,但未必在维护系统。如果另一个例程一周只开两个 PR,却能稳定复现崩溃、附齐证据、一次通过,它反而更接近团队真正需要的那位同事。
怎么说呢,软件工程一直在重复同一个朴素道理。写出改动只是开始,知道什么时候接受改动,才是团队能力。
Claude 已经可以每天准时来上班了。
现在轮到我们给它一套不会把人淹没的验收制度。