posts/claude-mythos5-defender-boundary.md
Claude Mythos 5 不给裸访问,才是 Agent 上线的正解
不是把 Claude Mythos 5 交给用户。
是把漏洞发现、补丁建议和安全告警交给用户。
Anthropic 刚把 Claude Mythos 5 接进 Claude Security,还准备通过合作伙伴的网络防御产品扩大覆盖范围。一起公布的还有 3500 万美元 Defender Advantage Fund,用来支持开源漏洞修复、安全自动化和新的防御方法。
这些信息都很大,够写好几轮发布通稿。但整份官宣里,我最在意的只有一个产品选择。
终端用户不会直接和 Mythos 对话。
他们只会通过一个为特定任务做好的界面,让模型在后台扫描代码,只拿到规定好的产物。想让它找漏洞,可以。想顺手把同一个入口拐成攻击工具,不行,因为产品根本没有把那扇门做出来。
好家伙,这才是高能力 Agent 真正该有的上线姿势。
很多团队还在讨论怎么把 system prompt 写得更严,怎么多加一句「禁止执行危险操作」,Anthropic 已经把问题往下压了一层。别指望模型每次都自觉守规矩,先从产品结构上限制它能接收什么、能返回什么、能把结果送到哪里。
模型能力是油门。
任务接口、权限边界和人工审批,才是刹车与方向盘。
模型开放了,聊天框却没开
Claude Mythos 5 的麻烦在于,它对网络防御很强,对网络攻击同样可能很强。漏洞发现、利用验证、补丁生成,本来就隔着一条很细的线。同一段能力,交给维护者是修门锁,交给恶意使用者就是配钥匙。
Anthropic 过去的做法,是通过 Project Glasswing 把 Mythos Preview 交给少数负责关键软件安全的组织,让防御者先获得发现与修补漏洞的时间窗口。后来又用安全分类器扩大模型覆盖范围,同时拦住高风险的双重用途请求。
这次再往前走一步,思路不再只是「谁能用模型」,而是「用户到底需要模型,还是只需要模型产出的结果」。
答案很现实。
绝大多数安全团队不需要一个可以随便聊的 Mythos。他们需要的是代码库里哪里有问题,严重程度多高,为什么判断它有问题,建议补丁长什么样。把这些交付出来,工作就能继续。至于模型背后能不能写攻击利用代码,对防御流程没有帮助,反而多了一条被诱导和滥用的路径。
所以 Anthropic 与合作伙伴选择了 purpose-built interface,也就是只为一个明确任务做的界面。用户授权一个代码库,产品在后台调用 Mythos,返回漏洞清单或补丁。界面里没有任意提示词入口,输出也不是一段不受约束的原始模型回复。
这听起来像少给了用户自由。
但安全产品里,自由从来不是白送的功能。每多一种输入形式,就多一片提示词注入面。每多一种输出通道,就多一个数据泄露位置。每多一个可以自动执行的动作,就多一条权限升级路径。
把通用模型藏在专用任务后面,不是把能力阉割掉,而是把能力收束成可以验收的合同。
用户买的不是聊天自由。
用户买的是一个结果,而且这个结果能被复核。
Anthropic 官宣配图。强能力不必暴露成通用入口,先把可交付的结果定义清楚。
一次安全扫描,背后其实是五道闸
Claude Security 现在可以用 Mythos 5 扫描代码库。官宣把流程写得很清楚,企业用户选择一个自己有权扫描的仓库,模型查找漏洞,再为每个发现返回 CWE 类别、置信度、严重性评级和建议修复方案。
CWE 是 Common Weakness Enumeration,常见弱点枚举。你可以把它理解成漏洞类型的标准目录。模型不能只说「这段代码看着危险」,它得把判断挂到一个大家都认识的类别上,再给出置信度、严重性和修复证据。
这就是第一道闸,输入范围。
用户先选定自己拥有的代码库,模型不是对整个互联网随便找目标。授权对象从一开始就被圈住。
第二道闸是任务范围。Mythos 在这里执行的是扫描、分流和补丁建议,不是通用网络操作。产品没有给用户一个万能提示框,让他临时把任务改成另一件事。
第三道闸是输出范围。返回的是结构化 finding,也就是一条带类别、置信度、严重性和修复建议的安全发现。不是完整思维过程,不是任意脚本,更不是可以继续追问的裸会话。
第四道闸很容易被忽略。Mythos 负责扫描,但用户随后在 Claude Code Web 里实现补丁时,只能使用组织本来就有权限访问的模型。官方明确写了,Mythos 扫描不会把 Mythos 访问权顺手扩展到其他入口。
同一个人,同一个仓库,同一条修复链,模型权限仍然分开算。
厉害了。
很多 Agent 产品的权限设计,恨不得登录一次就全家桶通行。模型读到了仓库,于是也能开终端。能开终端,于是也能拿云端凭据。拿到凭据,于是顺便可以部署。大家把丝滑当成体验,把权限继承当成便利,直到一次提示词注入把整条链串起来。
Anthropic 这里反着做。扫描模型有扫描模型的入口,交互式修复有交互式修复的模型权限。任务往前走,能力不会偷偷跟着膨胀。
第五道闸是人工批准。每个补丁都必须由人类审核、批准,才可以实施。模型给出的只是候选变更,不是生产事实。
把这五道闸串起来,流程大概长这样。
仓库授权
  ↓
Mythos 5 扫描
  ↓
CWE + 置信度 + 严重性 + 建议补丁
  ↓
受限模型实现修复
  ↓
人类审核与批准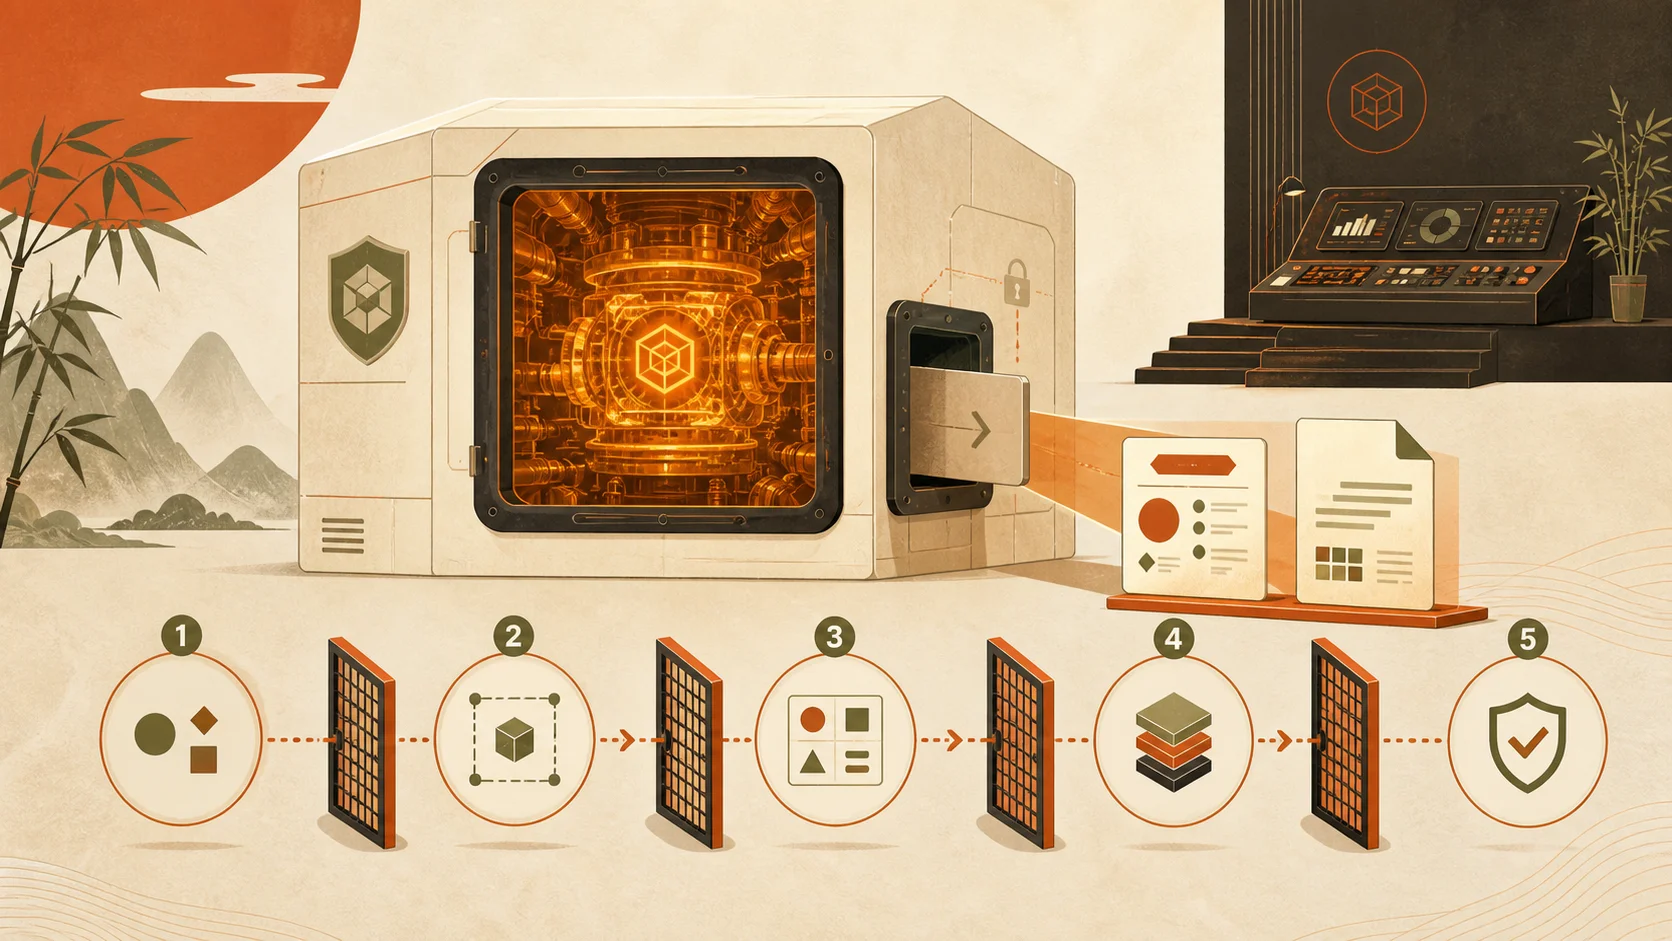
输入范围、任务范围、结构化输出、独立权限与人工批准,把模型能力收束成可审计的工作流。
这不是一串漂亮的产品步骤。
它是一条可追责的证据链。哪一个仓库授权了,哪一个模型做了扫描,返回了什么发现,谁把补丁变成代码,谁按下批准,出了问题能沿着链往回查。
Agent 真正进入生产,不是它终于能自己干完活。
而是它干的每一段活,终于有人能说清楚。
别把拒绝提示词当安全边界
如果把 Mythos 这套设计从网络安全场景里抽出来,会发现它对普通 Agent 团队同样适用。
模型拒绝危险请求当然有用。分类器、内容策略、风险检测,也都该做。但它们依然是一道会概率性判断的门卫。门卫再认真,也可能被绕过,也可能误伤,也可能在模型升级后表现漂移。
真正稳的边界,应该由系统替它兜住。
一个能帮客服退款的 Agent,不需要任意金额转账能力。产品可以只给它生成退款建议的工具,金额超过阈值就进入人工队列。一个能帮运维排查故障的 Agent,不需要默认拥有生产写权限。它可以读指标、查日志、生成变更单,真正执行时再换一套短时凭据并等待批准。
一个代码 Agent 也一样。读仓库、改分支、开 pull request、合并主干,看起来是一条自然流程,权限却不该一次发完。读代码时用只读 token,提交改动时只允许推临时分支,合并时交给 CI 与 reviewer。模型想一步走到发布,系统就该礼貌地说,不好意思,这里没这条路。
不是靠 prompt 里那句「请勿直接部署」。
是真的没有部署凭据。
这块最值得抄的,是把 Agent 的能力合同写成机器可以检查的东西。哪怕先从一个很朴素的结构开始。
{
  "input_scope": ["repo:team/service-a"],
  "allowed_task": "scan_vulnerability",
  "output_artifact": "security_finding",
  "actions": ["read_code", "suggest_patch"],
  "requires_human_approval": true
}
模型每次运行前,runtime 先把这份合同和真实权限对一遍。输入是不是授权对象,工具是不是白名单里的,输出是不是预期 artifact,动作有没有越界,需要人工批准的节点有没有人签字。
这里的 artifact 可以理解成有固定结构、可以保存和复核的任务产物。安全扫描返回 finding,代码 Agent 返回 diff,数据 Agent 返回查询结果与来源,财务 Agent 返回待审批单。只要产物是明确的,系统就能做 schema 校验、内容扫描、版本对比和审计归档。
反过来,如果输出只是「模型回复了一大段话」,后面的系统就很难判断它到底完成了任务,还是用一段听起来很自信的文字糊过去。
很多 Agent 项目真正卡住,不是模型不会调用工具,而是团队一直没有定义什么叫完成,什么叫允许,什么叫可回滚。
模型会越来越强,这三笔欠账不会自动消失。
它们只会被更快地放大。
3500 万美元买的不是 token,而是维护者时间
Anthropic 这次还设立了 3500 万美元的 Claude 使用额度,给帮助开源维护者保护软件的组织。这个数字很适合做标题,但如果只把它理解成免费算力,多少有点浪费。
开源安全最缺的经常不是发现漏洞的人。
是有人把漏洞复现出来,判断影响范围,联系维护者,写出不会破坏兼容性的补丁,跑回归测试,协调披露,再盯着新版本真正发出去。
模型可以把扫描速度拉高十倍,维护者的周末不会跟着多出十倍。告警越多,分流和验证压力越大。要是前端疯狂吐 finding,后端没人审核,所谓 AI 安全就只会变成一座新的红点山。
Defender Advantage Fund 把资助放在三个方向。修补广泛使用项目中的活跃漏洞,把扫描与修补做成其他项目可以复用的自动化流程,以及探索能抵御一整类攻击的新方法。
这三个方向其实对应了三个不同瓶颈。
第一个补人手,第二个补流程,第三个补方法。模型额度只是燃料,真正要跑起来的是维护者、基金会、协调机制与公开工具链。
Anthropic 早期通过 Project Glasswing 向开源安全组织直接捐赠过 400 万美元,也提供过额度并参与漏洞协调。这次 3500 万美元基金的规模更大,但官方仍然先从少量较大的试点开始,观察什么做法有效、什么能复制。
这个节奏挺克制。
安全自动化最怕一上来就追数量。扫描了多少仓库,发现了多少问题,生成了多少补丁,数字都很好看。可补丁没人合、误报没人清、维护者被打扰到关掉入口,跑得越快反而越像 DDoS。
真正有价值的指标,应该是有效漏洞从发现到修复用了多久,补丁合并后有没有回归,多少流程能被下一个项目复用,维护者的负担到底降没降。
这也是 Agent 产品常见的错觉。调用次数、自动完成率、节省 token 都容易统计,真正该盯的却是返工率、越权率、人工审核时间和事故恢复成本。
看起来没那么性感。
但那才是上线后的世界。
真正要复制的,是能力交付方式
Claude Mythos 5 这次没有给普通用户开一扇更大的模型入口。它选择进入 Claude Security,进入合作伙伴的专用工具,进入经过验证的组织与明确任务。
有人会觉得这不够开放。我反而觉得,这可能是前沿 Agent 能力大规模落地时更现实的路线。
模型越强,产品越不能只做一层聊天壳。它得知道用户有权处理什么对象,当前任务允许调用哪些工具,输出应该长成什么样,下一步由哪套权限接管,哪个节点必须让人签字。
如果你正在做 Agent,设计评审时可以先问一句,用户真的需要直接访问模型吗。
很多时候,答案是不用。
客服需要一张待审核退款单,工程师需要一个 diff,安全团队需要一条带证据的 finding,运营需要一份能追到数据源的报表。把这些结果做扎实,比再造一个万能聊天框难得多,也值钱得多。
我一直觉得,Agent 的未来不会是每个人手里都牵着一只无所不能的电子神兽。更可能的画面,是模型藏进一堆边界清楚的工作流里,平时不露脸,交付时给你一份能审核、能拒绝、能回滚的产物。
能力很大,门开得很窄。
这不是胆小。
这是终于准备上线了。