posts/claude-platform-agent-primitives.md
Claude Platform 补齐原语,没补齐生产 Agent
一份理赔材料先被读进来,Agent 按照公司的申报手册检查字段,再打开保险公司的网页,把表单填完,保存一份确认文件。
这是 Anthropic 在 8 月 20 日官方公告里给出的例子。
看着平平无奇,对吧?
但它背后同时用了三样刚刚全面开放的东西。Computer Use 负责操作软件,Skills API 负责装进团队的做事方法,Files API 负责保存输入和成品。网页场景还多了一把 Browser Use 工具,能读页面结构,不必只靠截图猜按钮坐标。
好家伙,这次不是再给模型塞一把新锤子。
Anthropic 正在把生产 Agent 最常见的三块底座,执行面、能力包、文件状态,收进同一个平台接口。过去你得自己拼浏览器自动化、对象存储、脚本仓库和上下文加载。现在这些东西终于能用同一套 Messages API 串起来。
可我越往文档深处看,越觉得发布页最值得聊的不是「都能用了」。
而是哪些东西依然没有替你做。
我的判断可能有点扫兴。Claude Platform 这次补齐的是 Agent 原语,不是一套可以直接交给生产环境的 Agent 运行时。三项能力越顺手,工程团队越容易把剩下的责任误认为平台也包了。
没有。
Computer Use 给了手,没给你机房
Computer Use 官方文档里,新版 computer_toolset_20260801 一共暴露 17 个动作,包括截图、缩放、点击、输入和拖拽。Claude 可以在一个模型回合里返回多步动作,你的程序按顺序执行,再把结果送回去。
这个变化很实在。旧式电脑操作经常是点一下,截一张图,再调一次模型。一个填表任务能在网络往返里磨掉大半时间。现在点击、输入、截图可以批量返回,模型调用少了,延迟也会跟着降。
Browser Use 更进一步。官方文档把它定位成网页内任务的优先选择。它既看页面,也读页面结构,动作对准的是某个输入框或按钮,不只是屏幕上的一组像素坐标。
有点子牛逼。
但这里藏着一个很容易被「正式可用」四个字盖住的主语。
动作由谁执行?
你的应用。
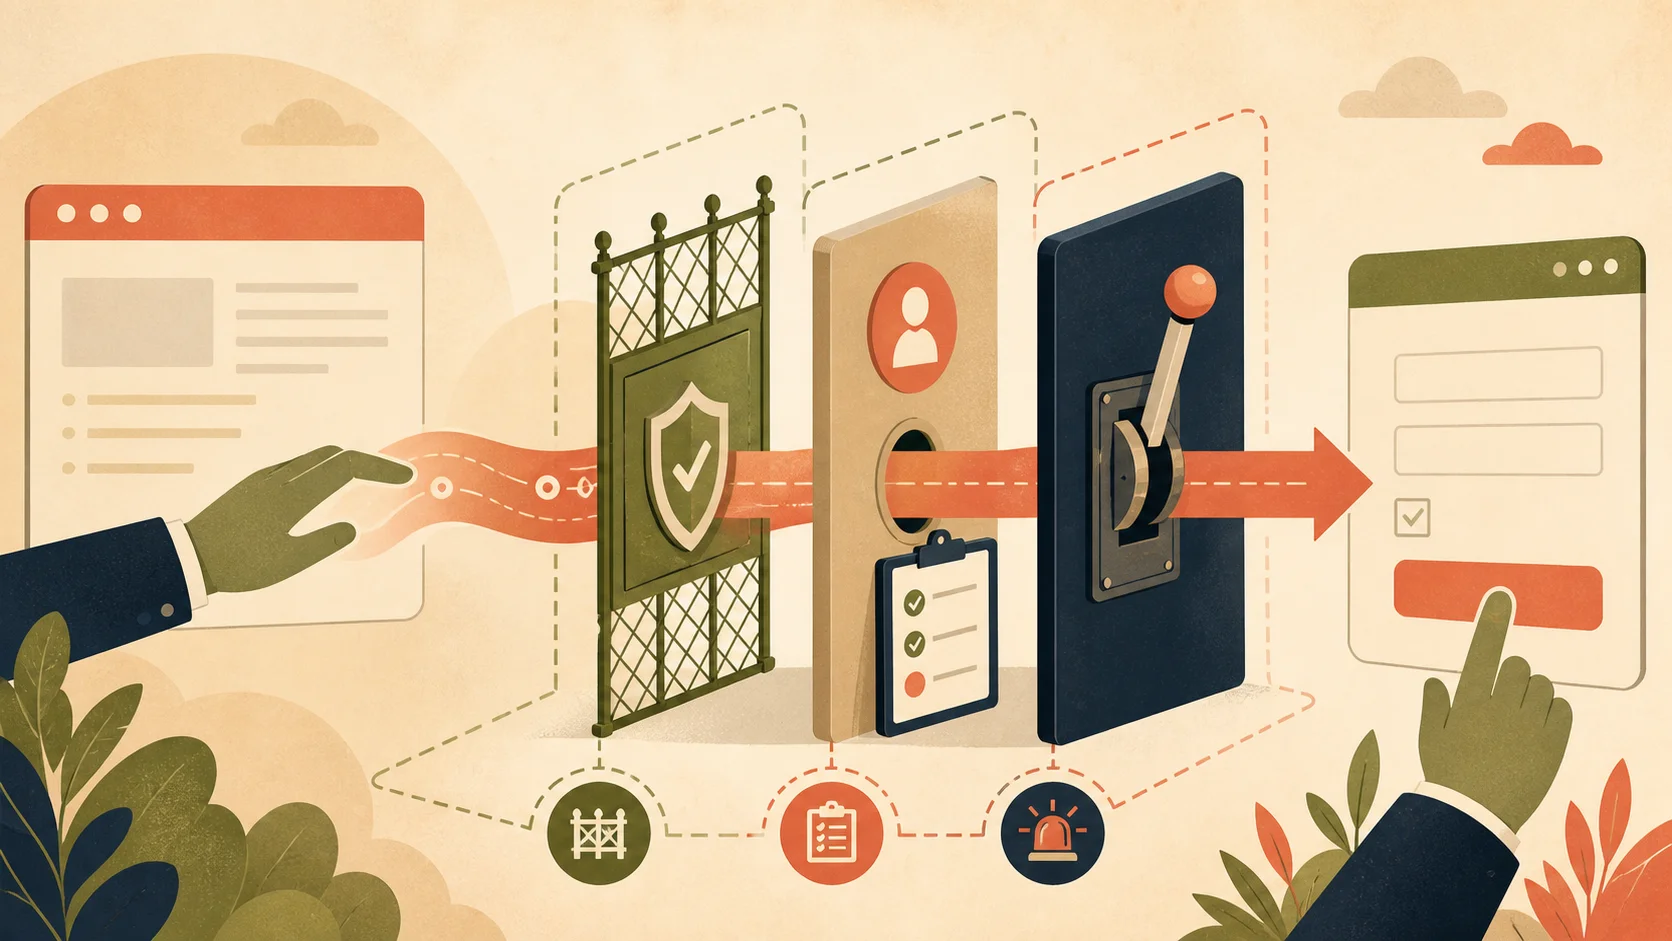
Anthropic 返回 tool_use,你要准备虚拟显示、浏览器或桌面环境,逐个执行动作,回传截图,处理超时,动作失败时中止后续步骤,还得保证同一批动作不会因为重试执行两遍。模型的手伸出来了,手术室、门禁和急停按钮仍然是你的。
这不是文档里的小字。官方安全建议直接写了低权限虚拟机或容器、敏感数据隔离、联网域名白名单,以及对付款、接受条款这类有现实后果的操作请求人类确认。
网页提示词注入也没有因为 GA 消失。页面里一段恶意说明,可能诱导 Agent 忽略原任务,去读取登录态、下载文件或点开不该碰的入口。Anthropic 会用分类器检查截图,在疑似注入时引导模型请求确认。可官方同一页也提醒,这层防护不能替代隔离。
很多朋友可能会把确认弹窗当作万能闸门。真到了生产里,弹窗只是其中一层。更稳的做法是让执行器在动作发生前检查策略,读取可以,写入要缩小范围,跨域要拦,提交要确认,付款干脆不进自动路径。
别让模型自己判断「这个动作风险不大」。风险等级应该来自你写死的策略和业务状态,不该来自模型当下的语气。
Skills API 把经验装箱,也把供应链带进来了
第二块是 Skill。
Agent Skills 文档把它描述成一个文件夹,里面可以有说明、脚本、模板和参考资料。启动时只把名字与描述放进上下文,真正命中任务后才读 SKILL.md,需要某份参考时再继续加载。
这套渐进式加载很重要。
团队知识真正变多以后,不可能把所有产品规则、数据库字段、报销流程和代码规范,一股脑贴进每次请求。上下文不是仓库,是模型眼前那张工作台。东西全堆上去,不仅贵,真正要用的那把螺丝刀也更难找。
Skills API 现在允许你上传、版本化和引用自定义 Skill。API 使用指南里,请求通过 container.skills 指定 skill_id 和版本,Skill 在 Code Execution 环境里运行。你可以固定某个版本,也可以跟随最新版本。
固定版本还是最新版本,听着像一个普通配置项,其实是生产事故的分水岭。
如果线上请求永远跟随 latest,同一份输入今天和明天可能走两套脚本。出了问题,你很难复现当时到底加载了什么。更稳的办法是把 Skill 版本写进任务记录,灰度新版本时双跑一小部分样本,验证通过再提升默认版本。
棒棒的,提示词终于有了版本号。
然后供应链问题也跟着有了版本号。
Skill 不是一段无害的文字。它可以带脚本、读取文件、调用代码执行工具。Anthropic 的安全文档干脆让你把它当成安装软件来审计。来源不明的 Skill、会从外部拉内容的脚本、突然扩大的文件读取范围,都可能把「团队经验包」变成数据外传通道。
还有两个现实限制很容易在 demo 以后撞上。
Claude API 里的 Skill 沙箱没有网络,也不能运行时安装新包。依赖外部 SaaS 的步骤不能直接塞进去假装能跑,得拆成受控工具调用。不同产品面的 Skill 也不会自动同步,API、claude.ai 和 Claude Code 各管一份。你以为自己维护的是一套能力,结果可能养出了三个版本分叉的表亲。
所以团队真正需要的不是一个 Skill 上传按钮,而是一条发布链。代码审查、依赖扫描、版本固定、灰度样本、失败回退和审计记录,一个都不神秘,少一个都可能在半夜变得很具体。
Files API 解决重复上传,没替你做租户隔离
第三块看起来最朴素。
Files API让应用把文件上传一次,拿到 file_id,后续请求直接引用。Skill 或 Code Execution 生成的图表、表格和文档,也能通过文件接口下载。正式版提供每个组织 1 TB 存储,单文件上限 500 MB,还增加了自动过期与更高的速率上限。
对长任务来说,这块非常实用。同一份 PDF 不用每一轮重新上传,生成的 Excel 也不必塞进模型文本响应。输入和成品终于有了一个稳定句柄。
可稳定句柄不等于安全句柄。
官方文档把警告写得非常直白。文件属于工作区,不属于某个用户、某次对话或某个会话。同一工作区里的任意 API key,都可能访问那里上传的文件。应用如果直接接受终端用户传来的 file_id,一个用户就可能读到另一个用户的材料。
这一下就从「省一次上传」跳到了多租户安全。
假设你在做企业报销 Agent,甲公司的发票和乙公司的合同进了同一个工作区。前端把文件 ID 原样回传,后端没有重新核对租户归属。模型甚至不需要越狱,只要应用把合法但不属于当前用户的 ID 放进请求,数据边界已经破了。
这个场景是假设,但边界来自官方文档,不是危言耸听。
正确的映射必须留在服务端。每个 file_id 都要绑定租户、用户、业务对象、用途和过期时间。请求进来先核验所有权,再组装给 Claude 的内容块。强隔离场景还得为不同租户划分独立工作区,不能指望文件名或目录前缀充当权限系统。
文件生命周期也要自己管。上传后不能改名或修改内容,更新要重新上传再删除旧文件。文件会保留到手动删除或达到 expires_at,删除后不可恢复。官方数据保留说明还需要和你的业务合规要求一起核对,不能看见「自动过期」就默认所有文件都会按你想要的时间消失。
文件存储是状态,状态就会带来归属、保留、删除和审计。
躲不掉。
三块原语拼起来,缺的那块叫控制面
回到开头的理赔 Agent。
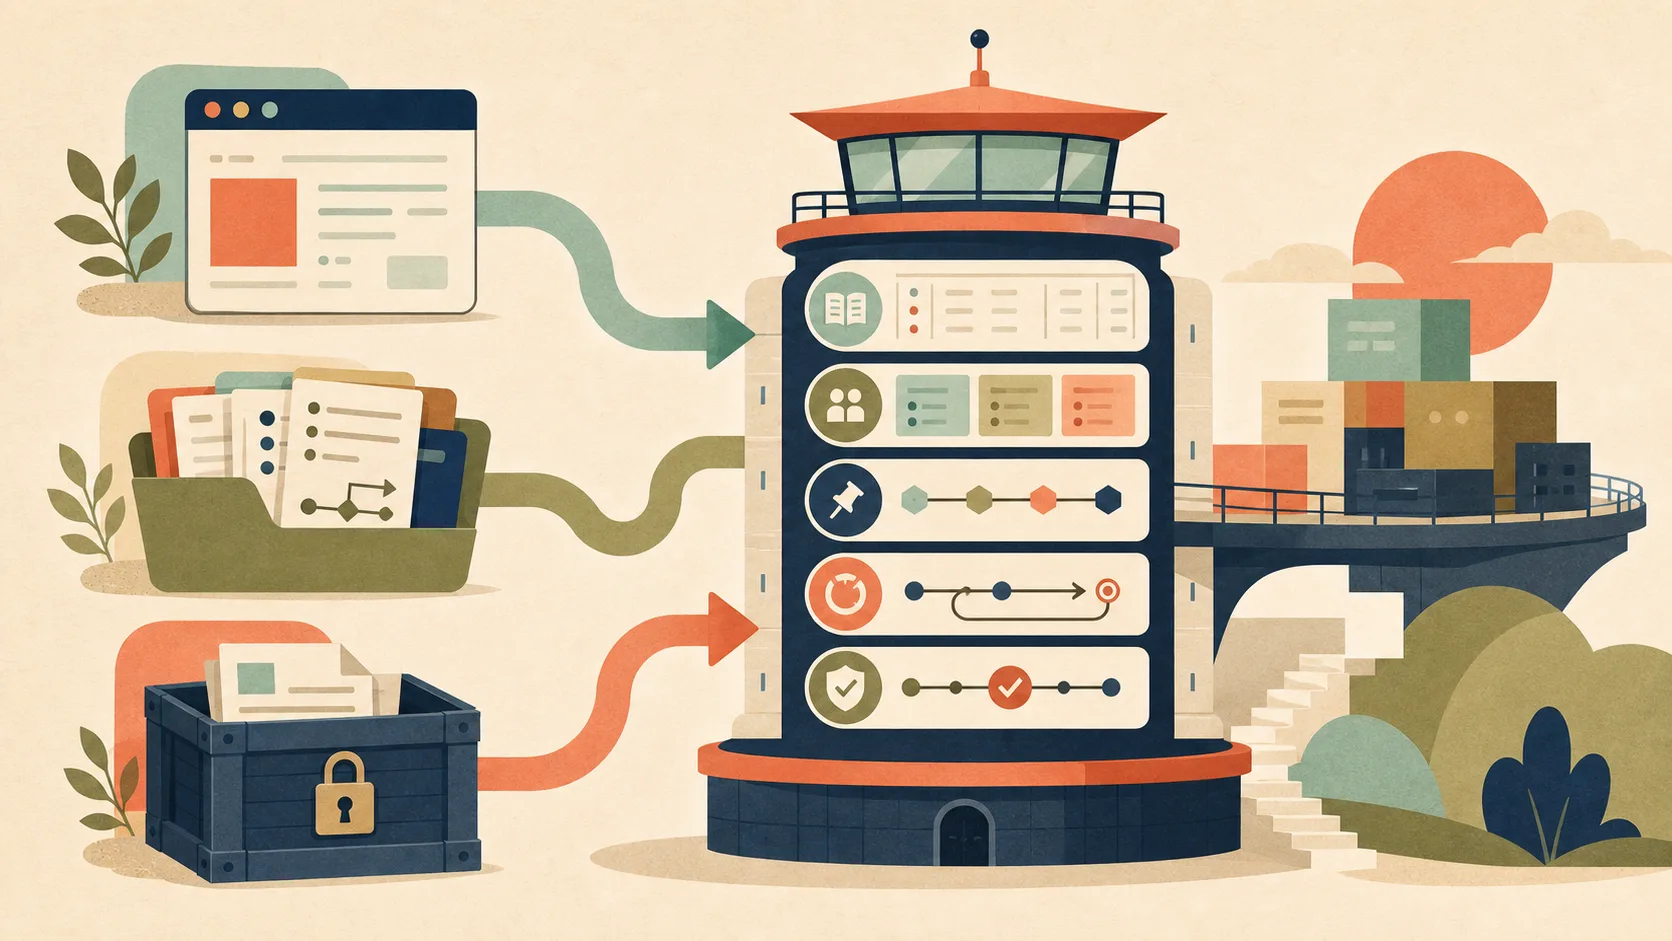
公告里的路径没有问题。Files API 提供材料,Skill 提供流程,Browser Use 完成门户操作,再把确认文件留下。真正投产时,工程团队还要在外面包一层控制面。
这层控制面至少要记住每次任务用了哪个模型、哪个 Skill 版本、哪些文件、进入过哪些域名、执行过哪些写操作,以及哪一步由谁确认。每个外部动作都要有幂等键,超时重试不能重复提交。每个生成文件都要回到租户映射里,不能只把 file_id 扔给前端。每个高风险动作都要能停下来,交给确定性策略或人。
听着像传统后端工程,没错。
Agent 把交互方式换了,没有把分布式系统里的老问题删掉。重试还是会重复扣款,状态还是会串租户,依赖还是会漂版本,外部输入还是会带恶意内容。模型越会操作,旧问题越有机会从日志里走到现实世界。
我是真的觉得,这次发布很重要。它把以前散落在脚本、浏览器和对象存储里的东西,拉进了一套可组合的平台接口。普通团队做 Agent,不必再从每颗螺丝开始造。
但平台给你的,是积木。
房子的承重墙还得自己算。
那份理赔材料能顺利走完流程,当然很好。更值得庆祝的,是它走错时能停,拿错文件时进不去,Skill 升级出问题时能回退,每一步还能查到是谁允许的。
那才叫生产 Agent。