posts/claude-protein-design-lab-loop.md
Claude 的蛋白质实验,最值钱的不是 35% 命中率
Claude 没有穿白大褂,也没有碰移液枪。
它在云端跑了 1,320 个蛋白质设计,外部实验室把这些设计真正生产出来,再一个个放进湿实验里测。结果有 354 个被确认能结合目标蛋白,覆盖 15 个靶点中的 14 个。
单靶点模式的总体命中率是 35.1%。Anthropic 给出的行业常见参照是 10% 至 15%。
好家伙,这组数字很容易把文章带去一个熟悉的方向。模型又赢了,药物研发要加速了,科学家是不是快被替代了。
但我觉得,Anthropic 今天公开的这组实验里,最值钱的根本不是 35.1%。
最值钱的是模型生成的答案,终于被送出了聊天框,走完了一条能被现实世界验收的证据链。
这条链不浪漫。它很贵,很慢,里面塞满专用模型、GPU、权限审批、失败样本和外部实验室。恰恰因为这些麻烦都在,结果才有分量。
先把实验本身讲清楚。
Anthropic 让 Claude Mythos Preview 和 Opus 4.8 设计蛋白质小型结合剂。结合剂可以理解成一把专门配出来的钥匙,它要牢牢贴住某个目标蛋白,进而抑制、激活或者递送别的东西。很多现代药物的早期设计都绕不开这一步。
过去做一轮从零设计,蛋白质工程师通常要花数周甚至数月。今天已经有不少机器学习模型能生成结构、设计序列、预测折叠,可这些专用模型不会自己组成项目组。哪个模型先跑,哪个结果该扔,候选怎么去重,哪些结构容易聚集,算力预算怎么分,仍然需要计算专家在中间编排。
Claude 在这里扮演的角色,不是一台突然学会生物学的万能机器。
它更像一个研究任务的调度层。
官方给了它约 3 万 token 的蛋白质设计说明、互联网与论文资料、Google Drive、Slack、Gmail、BioRxiv 连接器,以及运行专业蛋白质设计和折叠模型的 GPU。Claude 自己挑设计位点,调用结构设计、序列设计和共折叠模型,再做多轮计算优化,筛掉不新颖、不稳定、不易溶解或者看起来结合不上的候选。
多靶点实验给了 48 小时墙上时间,专业计算最多可用 12,500 个 NVIDIA H100 小时。单靶点实验给每个靶点 24 小时,最多 2,500 个 H100 小时。
看到这里,先别急着把它总结成「一个 Prompt 做药」。
不是哥们,这背后是 3 万 token 的任务合同、整套领域工具、成千上万 GPU 小时和外部实验室。把这些全藏起来,只露出一个聊天框,就跟把数据中心藏在搜索框后面,然后夸搜索框特别聪明差不多。
这也是整项实验第一个有点子牛逼的地方。Anthropic 没把专用能力偷偷揉进一句模型跑分,而是公开了 Claude 到底拿到了什么资源。你能看到实验提示词和数据,也能看到完整技术报告。
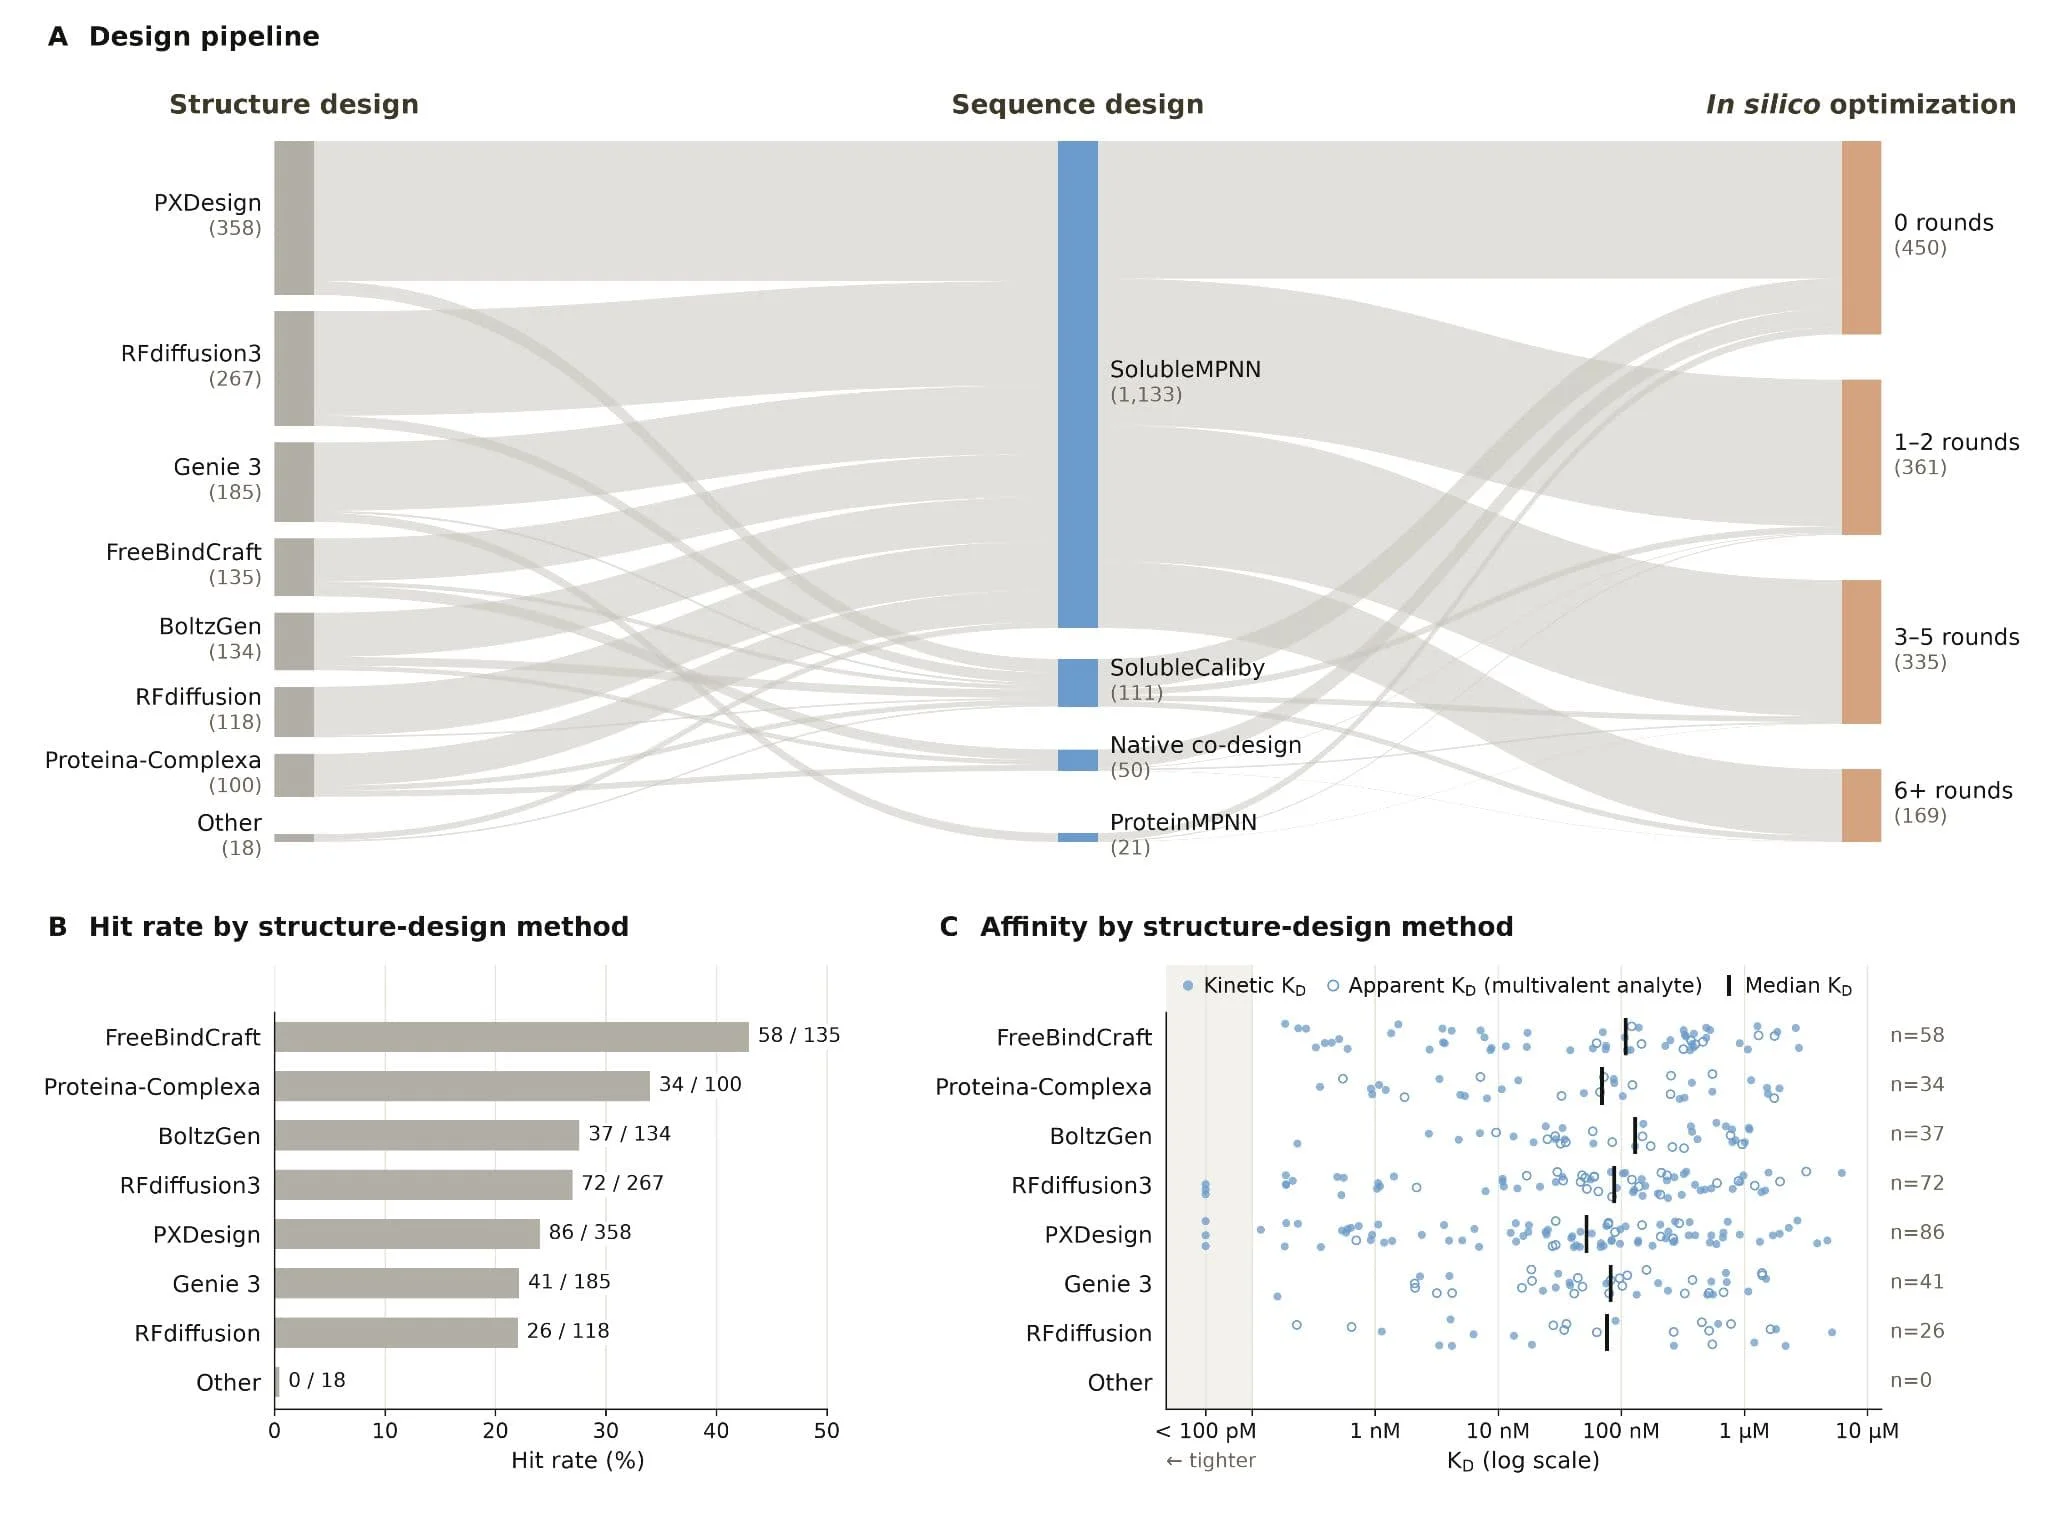
通用模型负责调度,领域模型负责生成与筛选候选结构
科学 Agent 的能力从来不是一个模型参数。
它是一份乘法表。模型推理、领域工具、算力、任务合同、权限系统和验收机制,只要有一项接近零,整条链就趴下。
这跟我们平时做代码 Agent 很像。模型会写函数,不代表它能交付一个改动。仓库得能读,测试得能跑,依赖要锁住,失败要留下日志,越权操作要停下来等批准,到头来还得有人愿意为合并按钮负责。
蛋白质设计把这件事放大了很多倍。代码写坏了还能回滚,湿实验一轮要花几周,试剂和设备不会因为模型很自信就免费重来。
所以 Anthropic 没让 Claude 自己给自己打分。设计完成后,候选被交给 Adaptyv Bio 与 Twist Bioscience 独立生产和检测。
这个动作,才把「模型说它能」变成了「现实世界测过它能」。
多靶点模式里,Mythos Preview 的总体命中率是 26.7%,Opus 4.8 是 22.6%。换成每个靶点独立运行的单靶点模式,Mythos Preview 提升到 35.1%。
注意,这不是一个所有靶点都很稳的平均童话。不同靶点的命中率从接近 90% 一路掉到 0%。
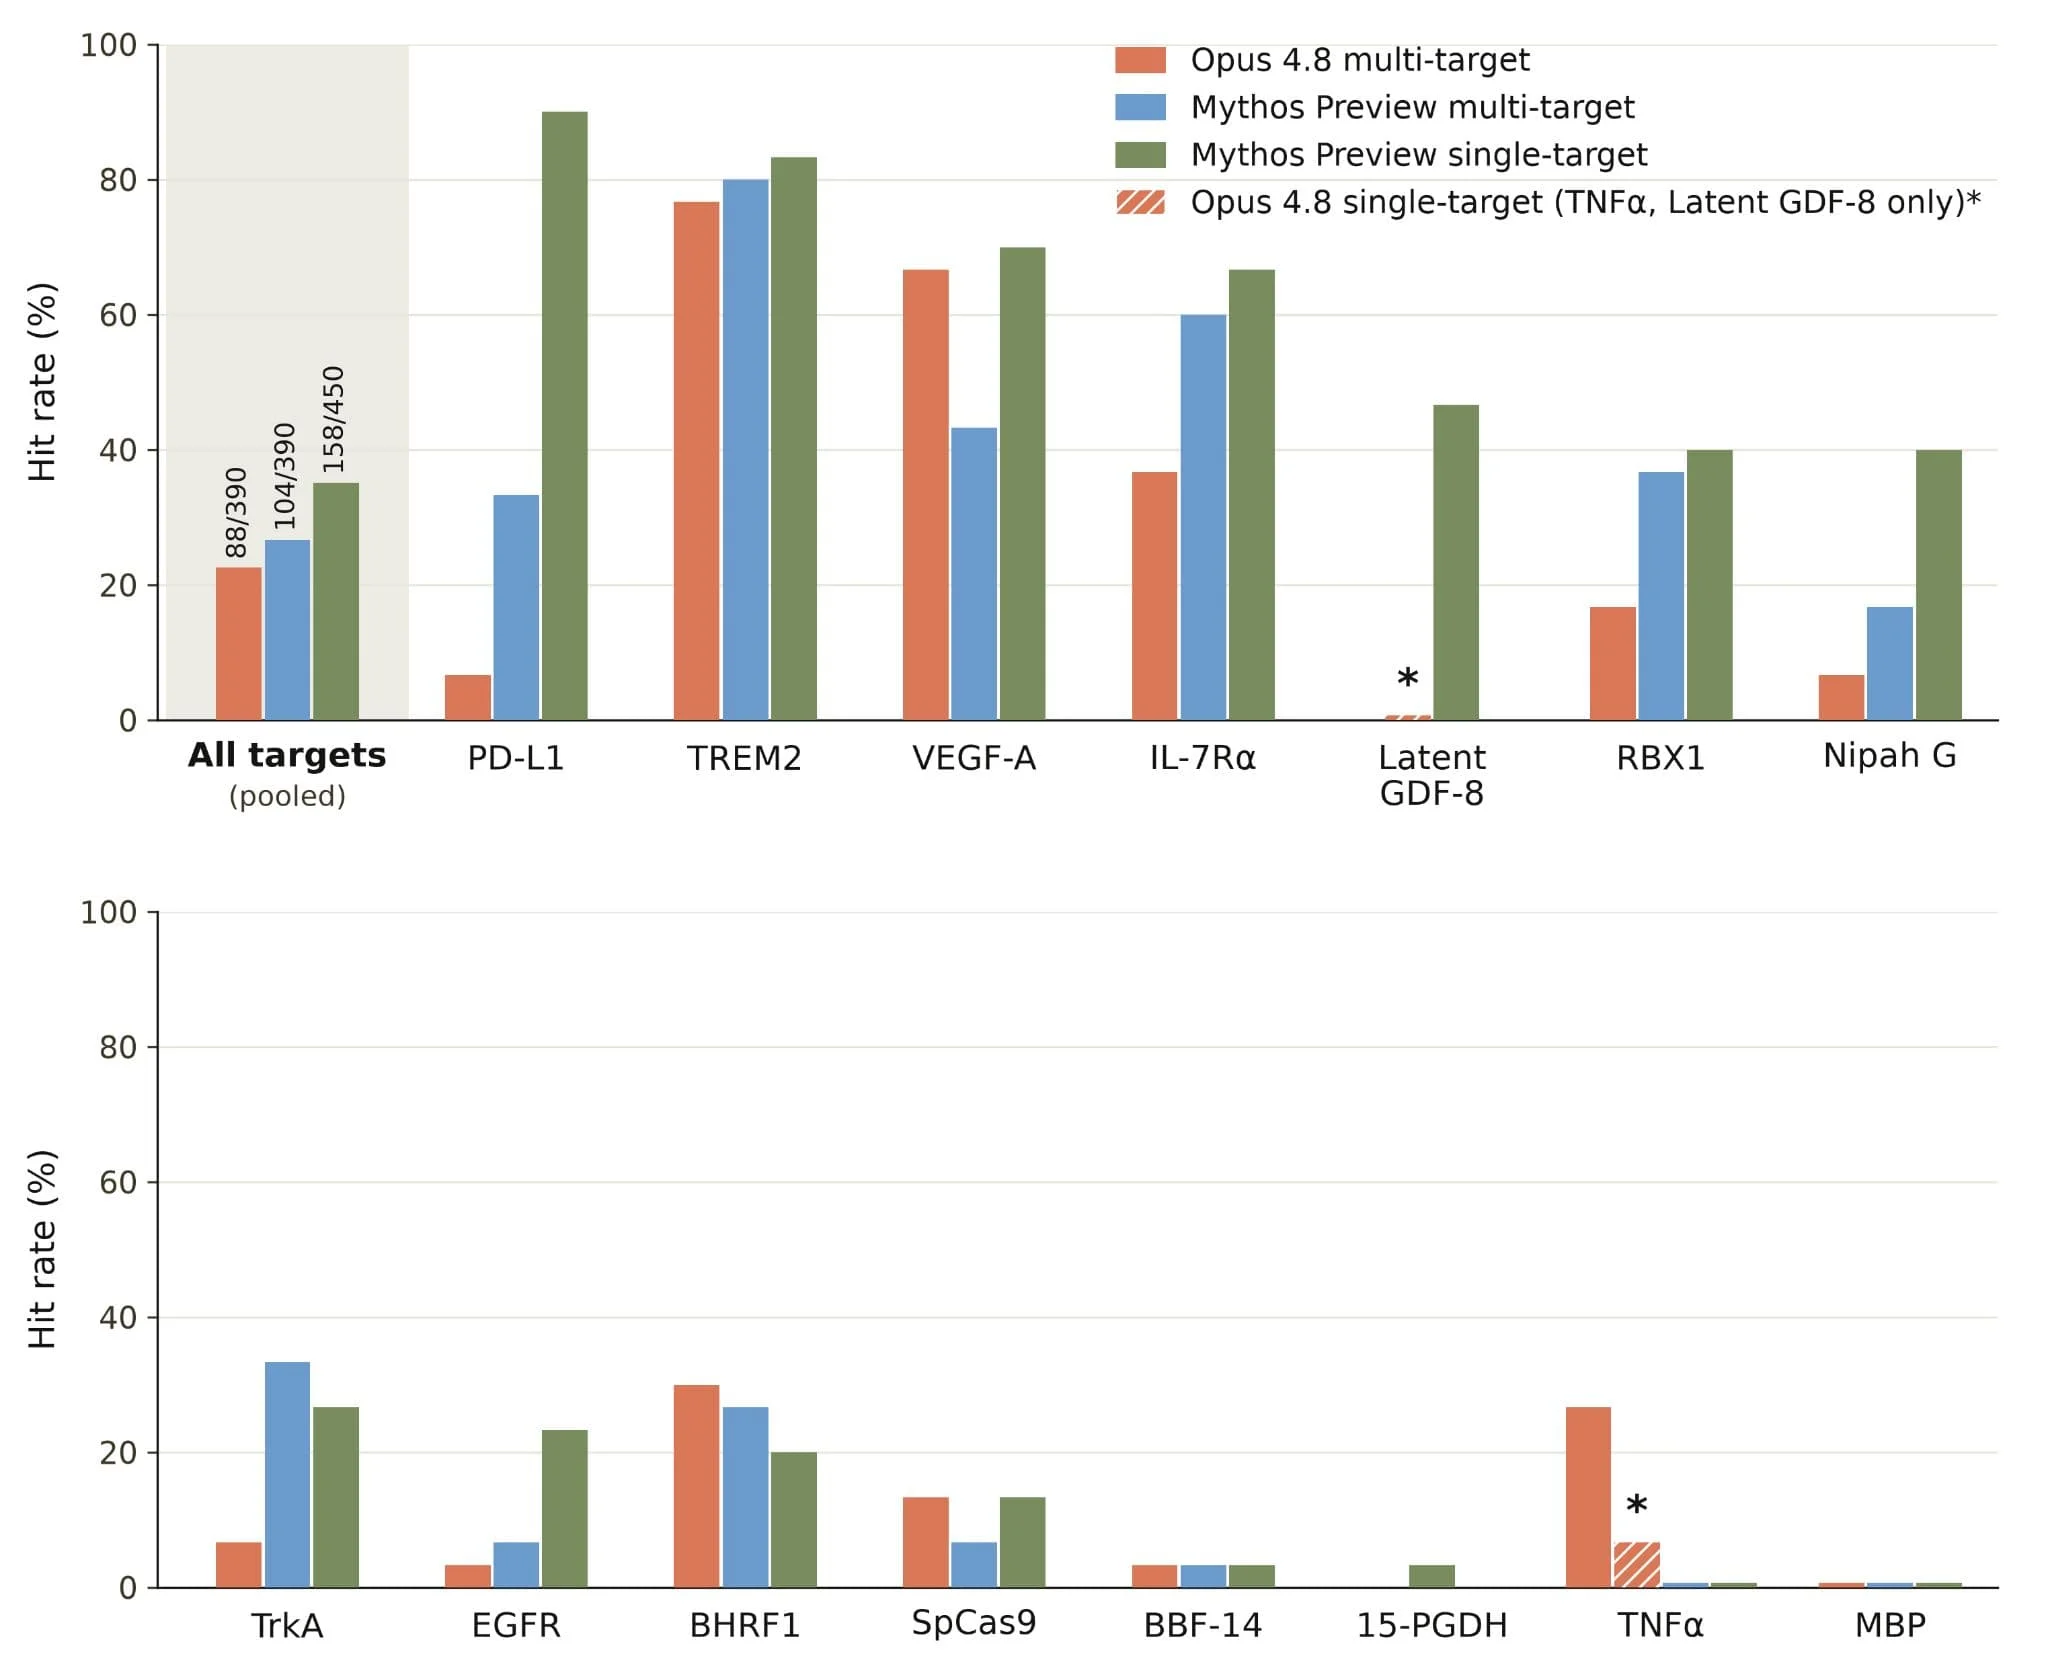
单靶点模式提高了总体命中率,但靶点之间的波动依然巨大
模型在 RBX1 靶点上做到了 40% 命中率,同类竞赛参与者的总体命中率只有 3.7%。它还做出了亲和力超过竞赛获胜方案的设计。
可到了麦芽糖结合蛋白 MBP,90 个设计没有一个被确认结合,只有一个出现微弱但可重复的信号。
更有意思的是 TNFα。整体更强的 Mythos Preview 没做成,Opus 4.8 却做出了多个结合剂,其中一些还能同时结合人、食蟹猴与小鼠的 TNFα。Anthropic 很诚实地写了一句,他们也不清楚为什么。
厉害了,榜单上的模型排序一进具体靶点,照样会翻过来。
这对做 Agent 评测的人很重要。一个总分只能告诉你平均表现,不能替你回答某个任务为什么成功。更不能保证排第一的模型在每个局部都排第一。
真正能进入生产的评测,至少要保留任务分布。哪些靶点成功,哪些完全失败,失败是候选生成不行、排序不行、工具调用不行,还是现实中的分子根本不愿意配合。平均数很适合写发布会,故障分布才适合写运行手册。
这组实验还有一处容易被忽略的细节。
人类没有在会话启动后继续提供科学指导,但并没有彻底消失。人要批准网络访问和代码执行,要处理会话之外的基础设施问题,还要把最终设计送去真实实验。
「最少人类参与」不是「没有人类责任」。
很多自动化系统喜欢把批准动作算成不够自治,好像 Agent 每停下来问一次,人类就输了一分。我自己的感受正相反。知道什么时候必须停,是一个成熟系统的能力。尤其到了科研、金融、医疗这些昂贵场景,审批不是模型能力外面的绊脚石,它就是系统设计的一部分。
模型可以快速扩大候选空间,人类和外部实验负责把幻想压回物理世界。
嘶,这个分工听起来没那么像科幻片,却比「全自动科学家」靠谱多了。
Anthropic 同一篇文章还放了第二项实验,反而更容易让工程师看懂。
Claude Opus 5 拿到一组 NMR 与 LC-MS 原始文件。NMR 是核磁共振谱,化学家靠峰的位置和面积判断分子结构与氢原子数量。LC-MS 是液相色谱质谱,用来分离成分、看纯度和分子质量。
仪器采集通常只要几分钟,折磨人的是后处理。每家仪器厂商都有自己的原始格式,数据要在专用软件里校准、找峰、积分、归属,再整理成报告。
这次 Claude 没拿到厂商软件,也没有操作员在旁边教。它只收到两句短指令,分别在 23 分钟和 19 分钟内处理完 NMR 与 LC-MS,两项并行完成。
结果里的纯度是 96.4%,合同实验室给出的数字是 96.33%。氢原子积分也和实验室结果对上了。
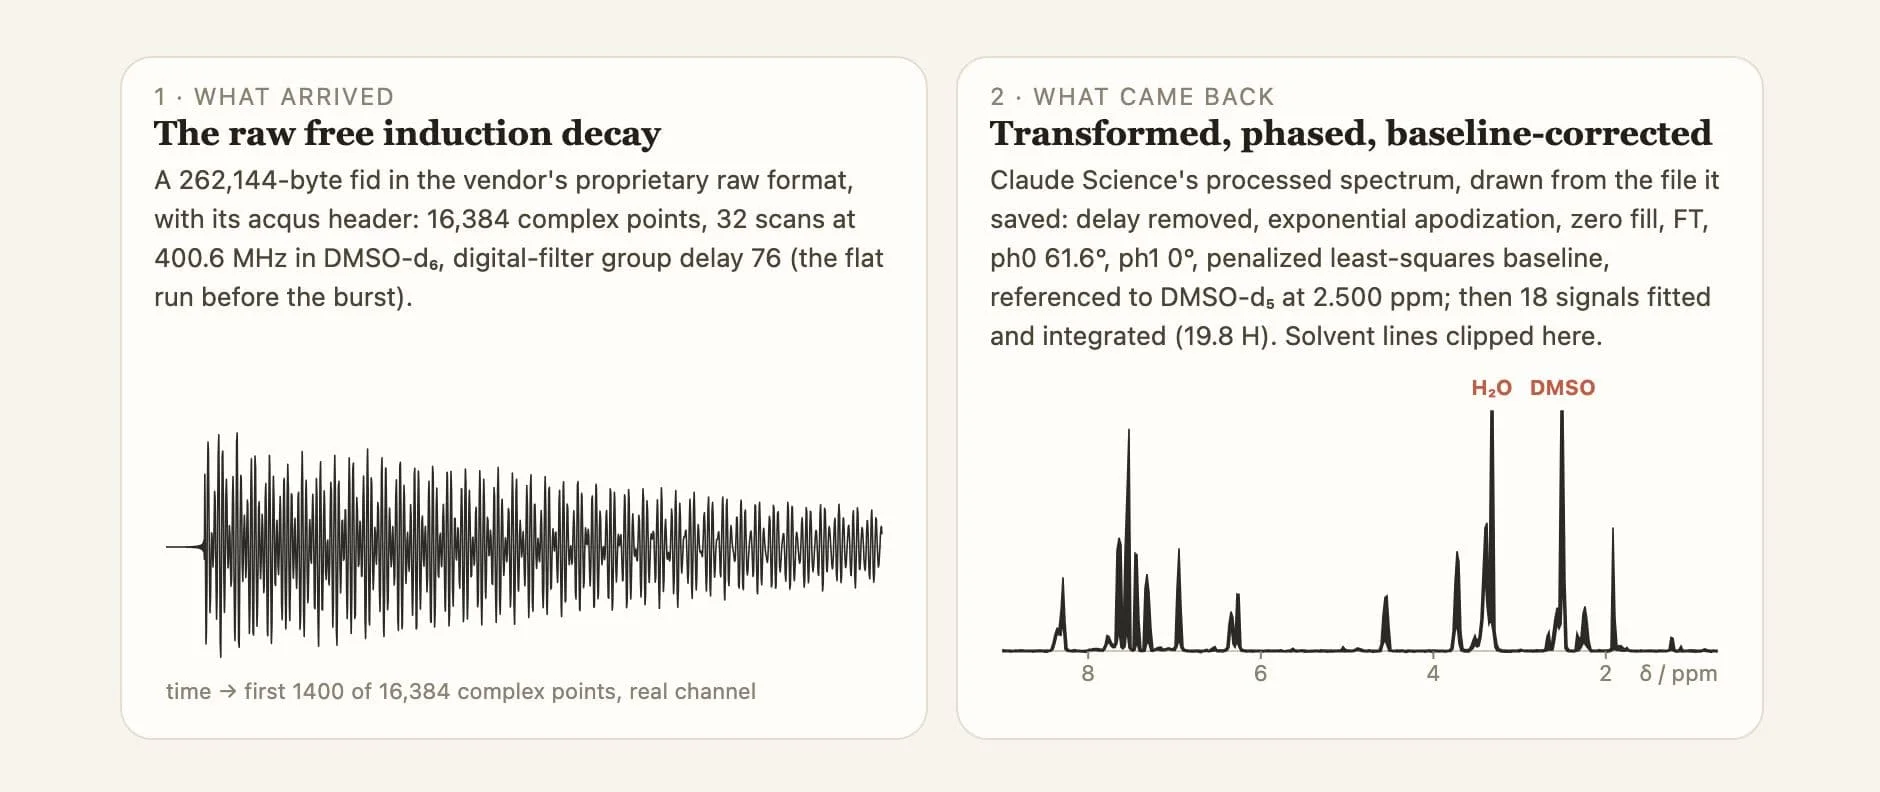
左侧是仪器原始信号,右侧是 Claude 处理并标注后的谱图
数字对上当然很好,但我更在意它怎么防止自己读错。
LC-MS 文件用的是未公开的厂商格式。Claude 先推断编码,再复现仪器记录的全部 2,664 次扫描汇总值,确认读取器没有把字节看歪,然后才做后续分析。
这就是一张很像样的机器回执。
不是「我成功解析了文件」,而是「原文件记录了 2,664 次扫描,我重建后的总数也等于 2,664」。一句话从状态宣言变成可核对证据,可信度完全不是一个东西。
NMR 那边更有意思。Claude 第一次判断 4 个可疑峰都在追加实验里消失了,随后自己的复核发现只有 2 个峰消失,于是改正结论。它还建议用重水交换做验证,而合同实验室三天后独立做了同一种检查。
它会犯错。
它也留下了发现错误的路径。
坦率讲,后者比一开始全答对更有工程价值。真实系统不可能靠永不犯错上线。我们能做的是让每个关键步骤都有回执,让异常能被下一层撞出来,让改正后的结论保留来路。
如果把这套做法搬回普通 Agent,动作其实很具体。
让文件解析器返回记录数与校验值,不要只返回成功。让检索工具附来源覆盖率,不要只塞一段摘要。让代码 Agent 报测试命令、退出码与失败用例,不要只说「修好了」。让高风险操作停在批准前,把预览和最终写入拆成两个状态。
模型负责提出候选,工具负责生成回执,外部验证器负责否决。
三层不要揉成一句自然语言。
怎么说呢,今天不少 Agent 产品的问题并不是模型不够聪明,而是团队太着急相信它。只要回复读起来顺,任务卡片就绿了。只要生成一张像模像样的图,报告就算完成。可一旦问「它和哪个外部事实对上了」,现场开始安静。
Claude 的蛋白质实验给了一个很贵的提醒。生成候选正在快速变便宜,验证候选依然昂贵,而且会成为整条系统最值钱的部分。
这也解释了为什么不能把 35.1% 直接写成药物研发已经自动化。
蛋白质小型结合剂并不是最常见的药物形态。高亲和力结合也只是漫长开发过程的早期一步。后面还有药物性质、毒理、制造、动物实验、临床试验和监管。Anthropic 自己也在原文里主动降温,技术进步只能解决其中一部分,政策与运营瓶颈不会因为模型升级自动消失。
算力账同样不能藏。数千到上万个 H100 小时换来的不是一个普通实验室明天就能复制的工作流。它证明了能力上限开始松动,还没有证明成本曲线已经落到大众可用。
再加上生物研究的双重用途风险,能力开放也不能只放一个同意按钮。Anthropic 目前仍限制最强模型的高风险生物设计能力,并准备通过可信访问计划向科研人员提供。能力、权限与责任得一起交付。
我始终觉得,科学 Agent 真正的分水岭不会是它写出多少像论文的段落。
而是它能不能把猜想交给仪器,把结果交给实验,把失败交给下一轮设计,再把整条证据链交给一个愿意负责的人。
这一次,Claude 还没有独立走完药物开发的航程。它只是把 1,320 个候选送到了湿实验室门口,其中 354 个拿到了现实世界的回信。
回信比答案贵。