posts/claude-workbench-repo-migration.md
Claude Workbench 今天退役,提示词不进 Git 就不算资产
今天有一批 Claude 开发者会失去一个用了很久的页面。
不是页面改版,也不是入口藏深了。Claude 旧版 Workbench 在 2026 年 8 月 17 日正式退役,里面保存的提示词、提示词版本和评测数据,过了时间就不能再访问。Anthropic 在官方帮助页写得很直白,旧数据不能导入新版,导出包只能由开发者自己保存。
同一天退役的还有三个实验性接口,generate_prompt、improve_prompt 和 templatize_prompt。继续请求只会拿到错误,Claude Platform 发布说明已经把日期钉死。
好家伙,一个网页和三条 API 在同一天关灯。
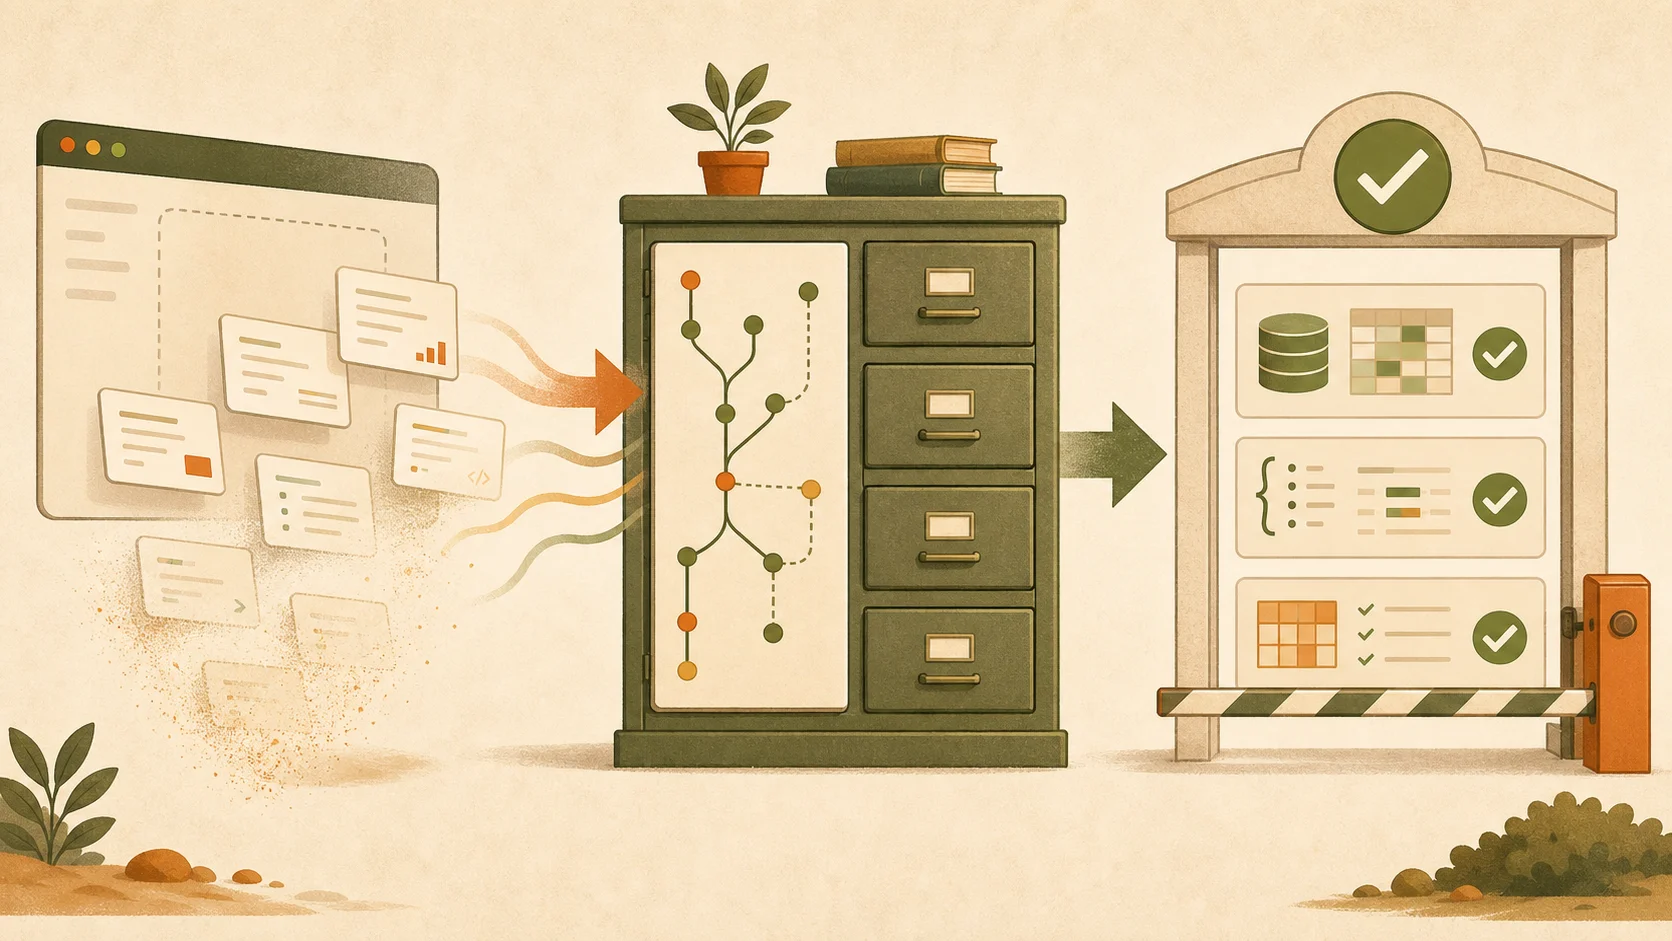
如果你只把这事理解成「记得点一下导出」,会漏掉更大的信号。新版 Workbench 不是旧产品换皮,它被改成了一个无状态试验台。草稿留在浏览器,页面不替你保存历史,不替你跑长期评测,也不负责团队共享。你可以试模型、看完整请求、导出代码,然后把真正的资产带回自己的系统。
我自己的判断挺硬,提示词不进 Git,就不算生产资产。
今天这次退役,只是把这笔迟早要还的工程债亮了出来。
页面消失不可怕,只有页面里有真相才可怕
很多团队调 Prompt 的过程,跟改线上配置差不多随缘。
甲在网页里改了一句,效果好像变好了。乙把温度从 0.2 调到 0.4,跑了三个样本,觉得也行。丙复制一份叫「最终版 3」,后来又冒出「最终版 3 修正版」。等线上结果漂了,大家围着聊天记录考古,没人能回答当前生产版本到底从哪一轮实验来的。
这不是 Prompt 写得好不好看,这是版本管理失效。
Claude 新版 Workbench 直接基于公开的 Messages API,页面展示的请求形状与代码实际发送的请求一致。这个设计有点子牛逼,它把边界划得很清楚,网页负责探索,仓库负责记忆。
边界一清楚,迁移目标也跟着变了。
你要带走的并不只是一段 system prompt。至少还有模型名、temperature、最大输出 token、工具定义、结构化输出 schema、样本输入、期望结果、评分规则,以及某个版本为什么被采用的说明。少一个,日后都可能复现不了当时那次「效果很好」。
提示词只是入口,完整请求才是实验对象。
这块需要注意一下,官方的提示词工程概览在开头就要求先定义成功标准、准备可实证的测试办法,再去优化提示词。顺序不是先把文案磨得顺眼,而是先说清楚什么叫成功。
没有成功标准的 Prompt 迭代,跟蒙着眼调数据库索引差不多。CPU 偶尔下来了,谁也不知道是不是刚好没流量。
先别忙着重写,导出后把实验拆开
今天还拿得到旧版数据的团队,动作其实很具体。去旧版 Workbench 顶部横幅点「Export data」,把提示词、历史版本、模型补全和上传文件一起导出来。官方会打包成 JSON,再通过邮件给下载链接。
拿到 JSON 以后别直接扔进网盘,文件在那儿躺三个月,跟没导出区别不大。
建议先做一次盘点,把每条 Prompt 分成三类。
第一类已经在生产里跑,要补齐当前模型、参数、工具和输出契约。第二类还在实验,但有明确负责人和下一轮验证计划。第三类只有一段文案,没有调用方,没有样本,也没人记得为什么存在。
第三类先归档,别带着历史包袱搬家。迁移不是数字考古抢救赛,垃圾也完整版本化,仓库只会变成另一座网页坟场。
生产 Prompt 可以从这样一个很朴素的目录开始。
prompts/
  ticket-triage/
    system.md
    request.yaml
    output.schema.json
    cases.jsonl
    rubric.md
    CHANGELOG.md
system.md 放固定指令,request.yaml 记录模型和采样参数,output.schema.json 定义机器要消费的结果,cases.jsonl 存回归样本,rubric.md 写清评分标准。至于 CHANGELOG.md,专门回答一个人类问题,这一版为什么改。
目录不高级,甚至有点土。
但它能 diff,能 review,能回滚,能跟代码一起发版。某次更新把工单分类准确率打掉 8 个点时,你不用翻聊天记录,只要看 commit 和评测结果。Claude Sonnet 默认版本升级以后开始漏字段,你也能判断是 Prompt 变了、模型变了,还是输出契约变了。
这才叫能维护。
Prompt 版本号不重要,可复现的请求才重要
不少人会给提示词加版本号,v1、v2、v2-final,看上去挺像工程化。说真的,单独给一段文字编号,解决不了多大问题。
生产请求通常由几块一起决定结果。
model: claude-sonnet-5
temperature: 0
max_tokens: 1200
system_prompt: prompts/ticket-triage/system.md
output_schema: prompts/ticket-triage/output.schema.json
dataset: prompts/ticket-triage/cases.jsonl
模型快照、参数、系统提示词、工具定义和测试集,必须作为一个整体锁住。只改 Prompt 不记模型,下一次官方更新默认模型,你会误以为自己的文字突然失灵。只记模型不存测试集,团队又会陷入「我感觉以前更好」的玄学争论。
如果下游要解析 JSON,别再把「请严格返回 JSON」当契约。Claude 的结构化输出可以用 JSON Schema 约束返回结构,严格工具调用还能校验工具名和输入。Prompt 负责表达任务,schema 负责兜住机器接口,两件事分开,维护成本会低很多。
还有一个容易被忽略的坑,数据保留策略也得写进设计。Anthropic 的 API 数据保留说明列出了不同能力的保留边界。新版 Workbench 不替你保留提示词,不代表你的应用日志就该什么都不留。应该留下可复现所需的版本标识、指标和脱敏样本,同时把用户隐私、公司资料与访问凭证挡在日志之外。
存得越多不等于越工程化。
能复现,又不把敏感数据铺满硬盘,才是。
评测别留在某个人的浏览器里
旧版 Workbench 最让人舍不得的,不只是保存 Prompt,还有页面里的 eval。
新版不再承担这件事,反倒逼着团队回答一个早就该回答的问题,评测到底是临时试验,还是发布门禁。
如果评测只在某个人浏览器里跑,它就没有稳定环境,没有强制执行,也没有失败归属。结果再漂亮,也挡不住另一个人直接把新 Prompt 合进主干。
真正有用的做法,是从导出数据里挑一组小而硬的回归集。别一上来追求一万条样本,先找 30 到 100 条最能暴露业务风险的案例。正常输入要有,边界输入要有,空字段、长文本、相互冲突的指令也要有。
每次改 Prompt 或模型配置,CI 自动跑这组样本。准确率、格式通过率、拒答率、平均 token 与 P95 延迟都记下来。核心指标掉过阈值就不合并,成本突然翻倍也不合并。
假设一个常见的工单分流场景,团队可以把门禁写成这样。
分类准确率 >= 0.92
JSON Schema 通过率 = 1.00
高风险工单漏判率 <= 0.01
平均输入输出成本涨幅 <= 15%
P95 延迟涨幅 <= 20%
这些数字不能照抄,要从自己的业务损失倒推。客服摘要和资金风控,漏判一次的代价根本不是一个量级。Claude 官方的分类任务指南也把测试集、准确率、F1、稳定性和输出结构放在部署之前,而不是上线后再补作业。
坦率讲,CI 里的 eval 不会让 Prompt 从此不翻车。模型有随机性,真实输入也永远比测试集野。它的价值是把「我觉得更好了」换成「这 73 个关键案例没退步,成本涨了 4.6%,可以接受」。
一句话从审美判断,变成工程判断。
网页仍然有用,但它不该是唯一的家
别误会,新版 Workbench 不是没用了。
用它快速换模型、看原始请求、试 tool use、检查 stop reason,依然很顺手。官方还保留了 Console 里的提示词生成、模板变量和 Prompt improver,它们很适合解决空白页问题,帮你得到第一版可测试的 Prompt。
只是第一版不等于生产版。
比较稳的节奏,是在网页里探索,导出为代码,放进仓库,补测试样本,再让 CI 决定能不能合。线上出现坏案例,就脱敏后回灌到 cases.jsonl。下一次改动必须重新越过这块礁石。
久而久之,团队真正积累下来的不是一堆漂亮 Prompt,而是一套知道哪里会翻船的航海图。
Claude Workbench 今天关掉旧仓库,确实会让一些人难受。但从工程角度看,这次改版也把话挑明了,模型厂商提供试验台,你得自己拥有生产记忆。
网页会换,API 会退役,默认模型会更新。
仓库里的历史、评测和回滚路径,才是自己的家底。