posts/claude-zeta-research-swarm.md
Claude 的 67.2%,最值钱的是那 650 次失败
3100 万个输出 token。
大约 60 个 Claude 子 agent。
2400 条 shell 命令,数百个 Python 脚本,54 篇论文检索。
最开始的 650 个想法,全挂。
然后,Claude 在没解出黎曼猜想的情况下,把一个相关问题的已知下界从 41.6% 推到了 67.2%。
好家伙,这几个数字放在一起,很容易被写成一篇「AI 数学家要来了」的爽文。但 Anthropic 公布的完整研究过程真正有意思的地方,偏偏不是模型突然灵光一闪,也不是 67.2% 看起来比 41.6% 大了多少。
真正值钱的是那 650 次失败,和失败之后长出来的一整套验证链。
对做 agent 的人来说,这比又一个跑分第一实用多了。
先把这件事讲明白
黎曼猜想从 1859 年悬到现在,是数学界最著名的未解难题之一,Clay 数学研究所还给它挂着 100 万美元奖金。它关心黎曼 zeta 函数的零点是否都落在一条特定的直线上,这件事和素数如何分布紧紧连在一起。
Claude 没有证明黎曼猜想。
这个边界必须钉死,不然标题一路传下去,下午就会变成「AI 解决了百年数学难题」,晚上再变成「数学家失业倒计时」。互联网的消息队列偶尔不保证幂等,大家都懂。
数学家过去能证明至少有 41.6% 的相关零点位于那条关键线上。Anthropic 的研究版本借用了 Baluyot、Goldston、Suriajaya、Turnage-Butterbaugh 近年的工作,又接上 Bombieri 在 2000 年的一条研究路线,给出了 67.2% 的新下界。完整论证在 Claude 写出的论文里。
这离 100% 仍然很远,而且 Anthropic 自己也明确说,他们不预期这套技术会直接通往黎曼猜想的完整证明。
可它依然是个像样的新结果。
两名 Anthropic 数学家检查了工作,相关领域专家 Brian Conrey 和 Dan Goldston 也审阅了论文。团队另外给出一份更短的专家说明,还把结果做成了 Lean 形式化证明。Lean 可以把证明拆成机器逐步检查的逻辑对象,不靠读者看着顺眼就点头。
到这里,67.2% 才从一段模型输出,变成一个能被人类继续检查的研究主张。
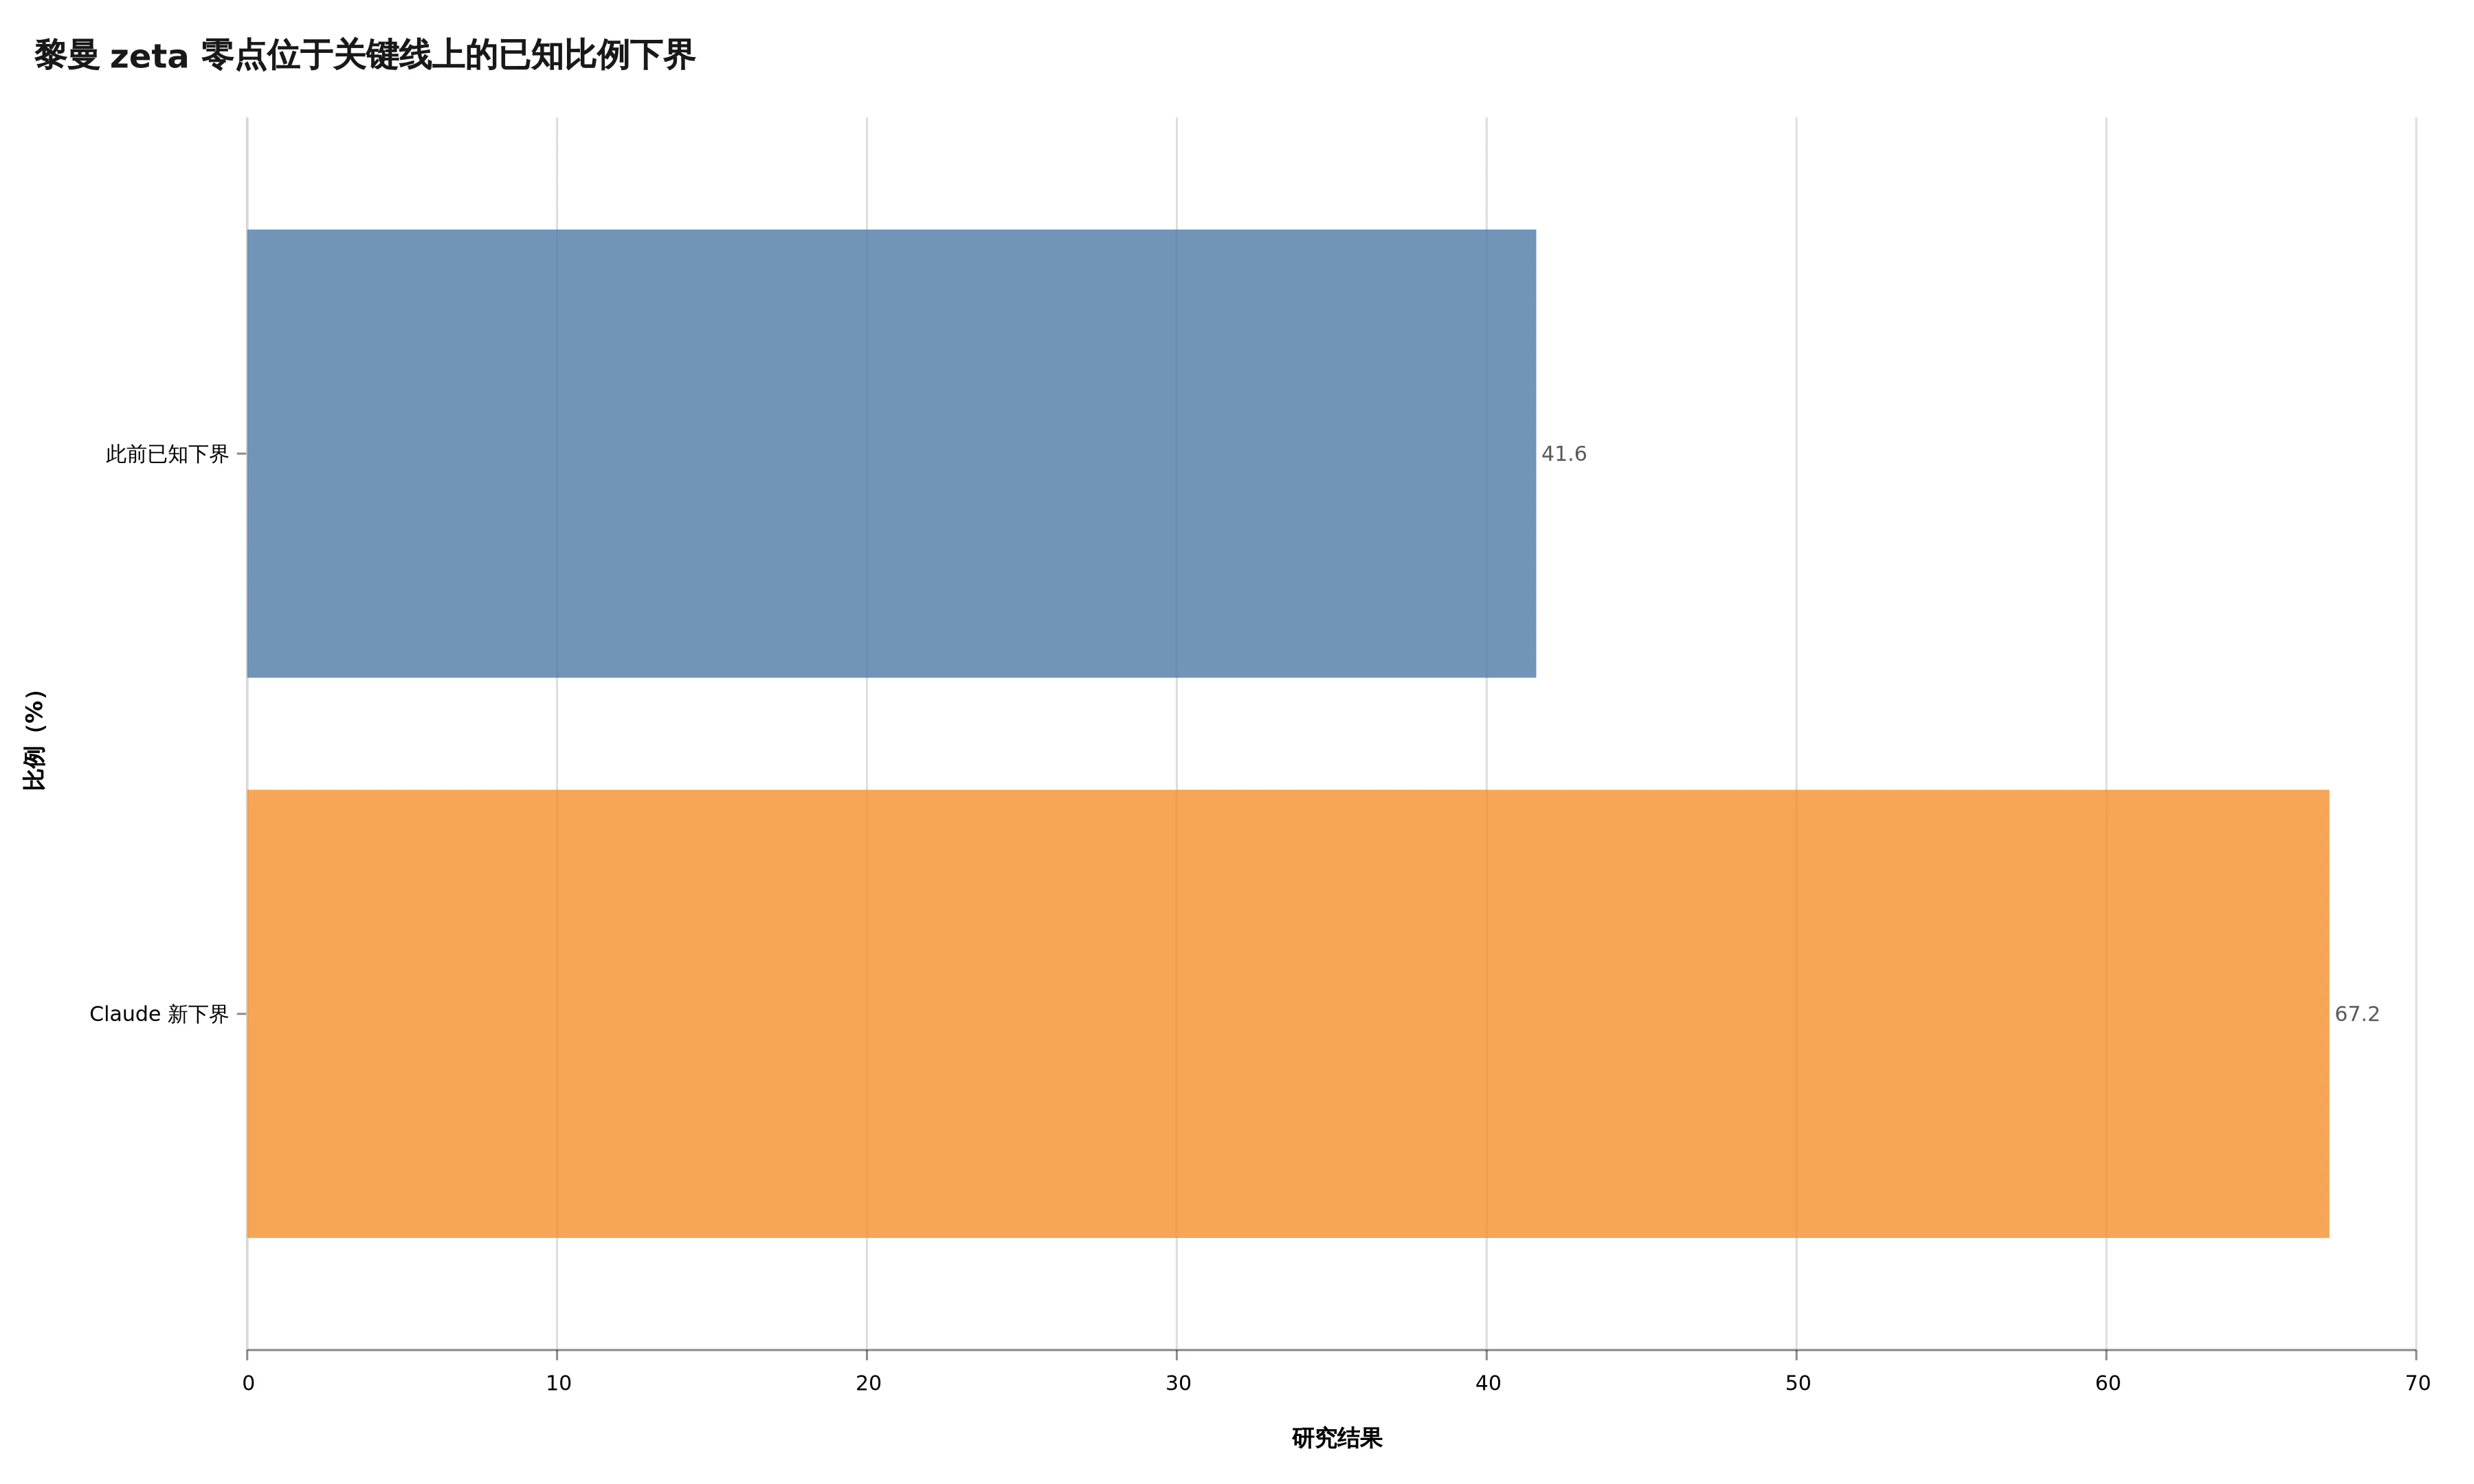
图|Anthropic 公布的新旧下界对比,67.2% 不是完整证明
650 个失败想法,不是废料
Anthropic 员工 Jarred Sumner 不是数学家。他给 Claude 的原始任务非常宽,让它真正尝试一下黎曼猜想,数学路线由模型自己选。
Claude 先生成了 650 个想法。
没有一个能走通。
很多 agent 系统跑到这儿就结束了。重试次数耗尽,状态标成 failed,日志里留下一句「未能完成任务」。产品经理叹气,工程师去调温度,下一版再把模型换贵一点。棒棒的,预算先涨了,系统还是只会更昂贵地撞墙。
Claude 这次没停。第二轮里,它花了一天半协调大约 60 个子 agent。它们不是排队给同一个答案表决,而是把研究任务拆成探索、数值检查、互相审阅、反例搜索、文献查重和独立重证。
这里有个很容易被忽略的工程判断。
探索阶段允许大量失败,验证阶段却不能靠气氛。
如果把生成候选和判定候选塞进同一个 prompt,模型往往会爱上自己的答案。它刚写完一套证明,转头让它检查,多少有点让 PR 作者自己当唯一 reviewer 的味道。60 个子 agent 真正有价值的地方,不是并发数看着唬人,而是让不同上下文承担互相冲突的职责。
一个负责找路,一个负责挑错。一个下载论文确认新颖性,一个完全不看原推导,从头再证一次。还有一组只拿已知 zeta 零点做数值检查。
这套设计有点子牛逼,因为它把「相信模型」换成了「让不同失败模式互相打架」。
做普通 agent 也能直接抄。写代码的 agent 负责出补丁,另一个只跑测试和静态检查,第三个拿需求逐条对照,第四个从空分支复现。做数据分析时,生成 SQL 的 agent 不碰最终结论,验证 agent 专门查口径、空值、时间边界和重复行。
别让一个上下文从提案一路包办签字。
那不叫自治,叫自己给自己盖章。
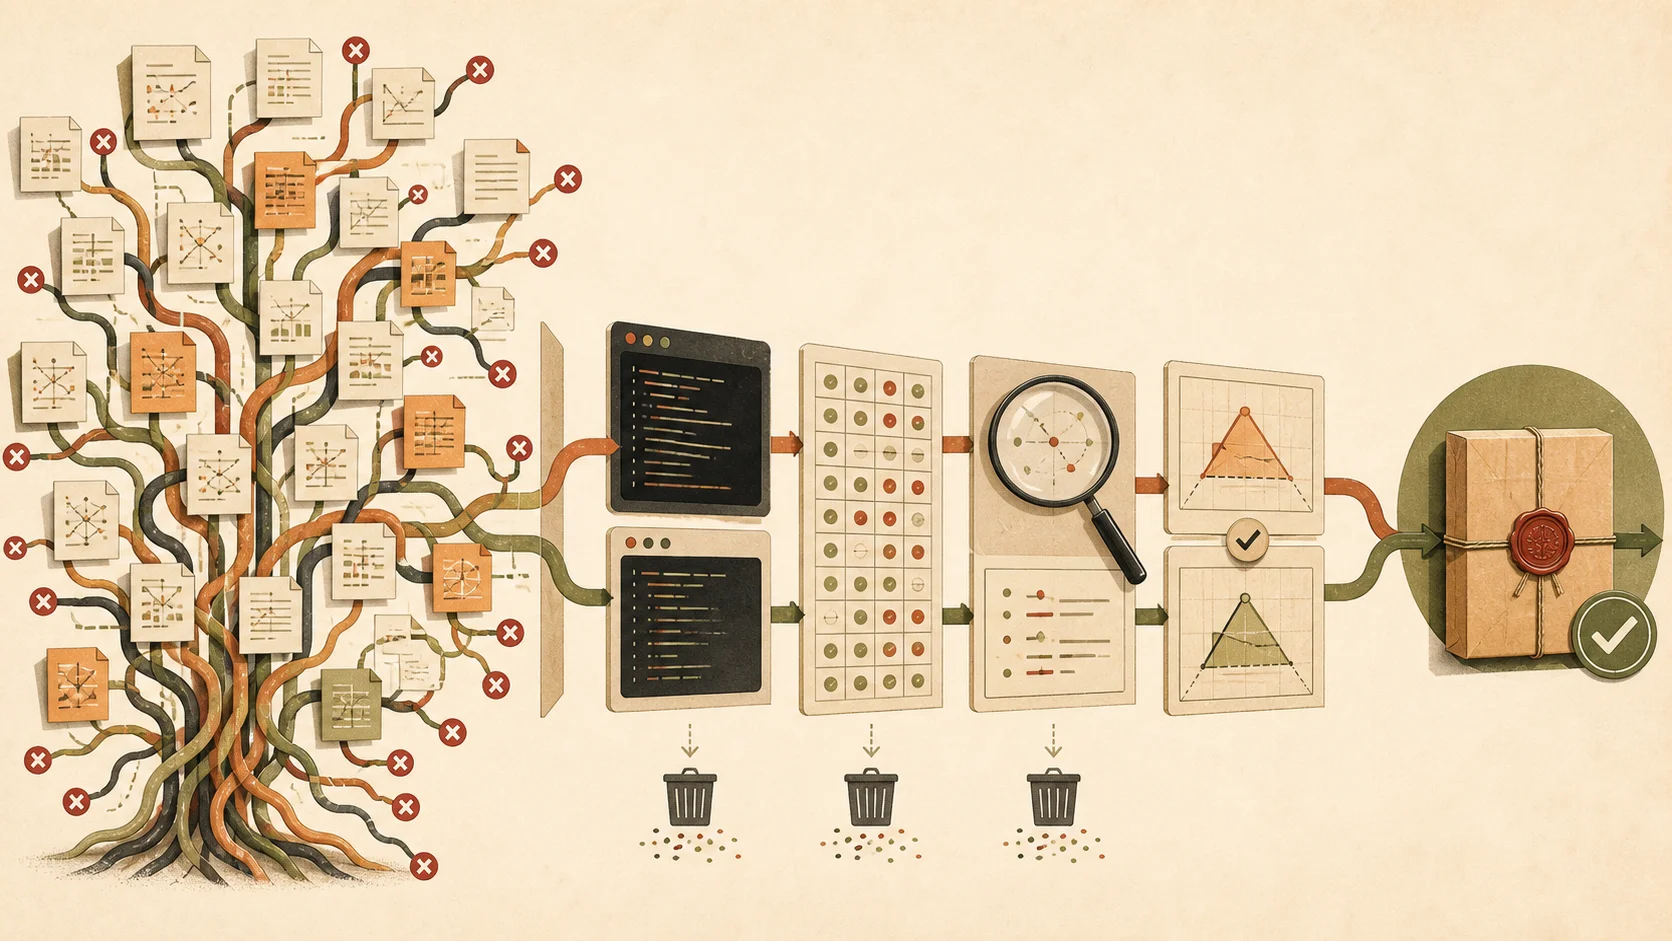
图|失败候选可以多,进入结论前必须层层收紧
真正的 agent 能力,是把证据留下来
这次研究在两个 Claude Code 会话里生成了 3100 万个输出 token。60 个子 agent 跑了 2400 条 shell 命令,写下数百个 Python 脚本,还围绕已知零点做了数千次数值检查。
厉害了,但 token 数本身不是能力证明。
31M 也可能只是一次非常昂贵的递归碎碎念。决定这些计算有没有价值的,是过程留下了什么。
Claude 找到结果后,没有只写一段看起来像论文的文字。它让不同子 agent 复核证明,主动搜索反例,下载 54 篇 arXiv 论文检查这个结果是不是早就有人做过,又安排一条独立路线从头重证。完整过程还被整理成了可追溯的记录。
到收尾阶段,人类数学家进场,Lean 再进场。
研究 agent 的输出单位因此不再是「答案」,而是一包证据。
里面应该有主张从哪来,用了哪些前人结果,执行过哪些计算,遇到哪些失败,谁尝试推翻过它,独立复现能不能过,还有哪些部分只能交给人类判断。
如果把它写成一个最小验收合同,大概长这样。
可交付结论 = 主张 + 来源链 + 反证记录 + 独立复现 + 人类签字 + 形式化检查不是每个任务都需要 Lean。让 agent 改一个按钮颜色,没必要请三位专家审稿。但风险越高,验证层就该越厚。改 README 可以跑一次 diff,改支付逻辑要有测试和人工 review,做数学新结论则需要专家与形式化工具接力。
同一个模型,接上不同的验证器,能成为完全不同的系统。
真要把这套东西抄进项目,也不用一上来就开 60 个 agent。先把四个角色拆开,收益已经很大。
规划器只维护假设树,记录哪些路线试过、为何被淘汰,避免系统隔两个小时又把同一个坑踩一遍。探索器在隔离环境里跑命令、写脚本、产候选,但没有资格宣布任务完成。验证器不读探索器那段自我感动的推理,只拿产物、测试和原始来源挑错。汇总器则负责把通过门槛的少数候选压缩成人能审的证据包。
角色拆开以后,预算也好管。探索器可以有较高 token 上限,验证器按候选数量触发,昂贵的人类 review 只留给通过自动闸门的结果。某条路线连续出现相同错误,就冻结分支,不再无脑重试。发现旁路成果时另开任务,不让它被原目标的失败状态一起埋掉。
这里最容易漏的是状态。每个候选至少要带来源、命令、产物哈希、反例结果、复现状态和当前负责人。没有这些字段,所谓多 agent 协作很快会退化成一群聊天窗口互相转述,消息很热闹,证据在路上丢完了。
你甚至可以先拿一个普通代码任务试。让探索器提出三种修复,让验证器在全新工作树里各跑一次测试,再让汇总器只提交能复现的那一个。模型不用换,prompt 也不用写成经书,系统可信度就会往前走一截。
这也是我一直觉得跑分容易让人误判的地方。跑分测的是模型在一个干净题面上能答到哪儿,生产环境关心的却是它答错后有没有留下痕迹,能不能被拦住,能不能复现,能不能回滚。
真正贵的不是一次聪明,是一条可靠的证据链。
人类没有退场,只是换了工位
Anthropic 的叙事里还有个挺妙的细节。Jarred Sumner 大部分时候没有指导具体数学路线,他给 Claude 的输入主要是「继续」「再试试」「相信自己」这类鼓励。
听着多少有点玄。
但别把它理解成给模型做心理按摩。更实在的解释是,人类没有在每一步抢方向盘,也没有因为前 650 个想法全挂就过早结束搜索。他把探索空间留给系统,把最终可信度交给数学家、独立专家和形式化验证。
人类的工位从「每一步怎么做」,挪到了「什么算完成」。
这对 agent 产品很关键。很多所谓自主系统,表面上工具调得飞起,实际上每两分钟弹一个确认框。人类没有被解放,只是从执行者变成了一只不停点允许的鼠标。
另一头也不行。把所有权限扔给 agent,等它回一句「已完成」,那是在拿不可观测换省事。
更靠谱的分工,是人类定义目标、预算和验收门槛,agent 负责大规模探索与产出证据。系统自动淘汰大部分烂路,把少数带着完整来历的候选送到人类桌面。人不必读 31M token,只需要审查那条被压缩过、能追溯回原始记录的证明链。
这才是规模化协作。
回到那 650 个失败想法。它们没有一个直接成为论文,却帮系统摸清了哪些路不通,也逼着第二轮把探索和验证拆得更细。
Claude 没解出黎曼猜想。
但它展示了一件更接近现实的事。研究型 agent 不需要每次都命中终点,它得会在失败里识别旁路成果,再把成果交给一套比自己更挑剔的验证系统。
67.2% 是今天的新闻。
那条允许失败、坚持留证、层层收紧的流水线,才是明天还能复用的代码。