posts/cloudflare-computer-agent-runtime.md
Cloudflare 想让 Agent 90% 时间不用容器
90%。
Cloudflare 刚发布的 @cloudflare/computer,给自己定了一个挺激进的目标,让容器承担 Agent 不到 10% 的工作。
剩下九成呢?尽量交给更轻的 isolate,也就是彼此隔离、启动极快的 JavaScript 运行环境。只有碰到完整 Linux、原生二进制、包管理器这类重活,才临时叫容器上场。
好家伙,过去一年,大家还在忙着给每个 Agent 配一只沙箱容器。现在 Cloudflare 端上来的观点却是,别急着给它分房,先给它一张能长期保留的书桌。
这张书桌就是文件系统。
我觉得这比「又一个 Agent 框架」有意思多了。模型可以换,执行后端可以换,容器可以随用随起,真正贯穿一次长任务的,是那批不断被读写的文件、代码仓库、测试结果和操作记录。
官方发布博客把标题写得很直接,Agent 需要的是一台电脑,不是一只容器。话有营销味,但它背后那条工程边界,值得做 Agent 的人认真看一眼。
容器一直很顺手,顺手到我们忘了它有多重
今天搭一个编码 Agent,最省脑子的方案是什么?
拉起容器,克隆仓库,装依赖,启动 Agent 循环,让模型在里面读文件、改代码、跑命令。任务结束后,要么保留容器等下次继续,要么销毁,再想办法把有用状态搬出去。
一只容器包住一切,权限、文件、Shell、运行时都在里面。开发阶段很舒服,出了问题也容易把环境整个封存。
但用户一多,账就变了。
很多 Agent 大部分时间根本没在编译,也没在跑原生程序。它可能只是在读几份 Markdown,改一段 JSON,比较两个补丁,整理日志,或者等模型返回下一轮工具调用。为了这些动作一直养着完整 Linux 环境,像是为了写张便签,先租一间带机房的办公室。
容器当然可以休眠、复用、做镜像缓存,可调度系统仍要处理启动延迟、镜像体积、CPU 与内存配额、闲置回收、文件持久化,还有一堆让人深夜盯着监控图怀疑人生的边角问题。
Cloudflare 的判断很凶。若未来同时跑着数亿个 Agent,业界没有足够的通用 CPU,给每一个都长期配一只容器。
这个数字现在没法验证,官方也没给容量模型。不过方向并不玄。Agent 的并发和传统 Web 请求不同,一个用户能同时开很多任务,每个任务又会在思考、等待、执行之间反复切换。你按峰值能力为整个生命周期预留重环境,利用率很容易难看。
Cloudflare 以前就在押轻量隔离。Workers 用 isolate 快速启动,Durable Objects 把状态与单线程协调放在一起,后来又允许 isolate 按需拉起 Cloudflare Containers。原来的推荐架构,是让 Agent 脚手架运行在 Durable Object 里,再把容器当工具调用。
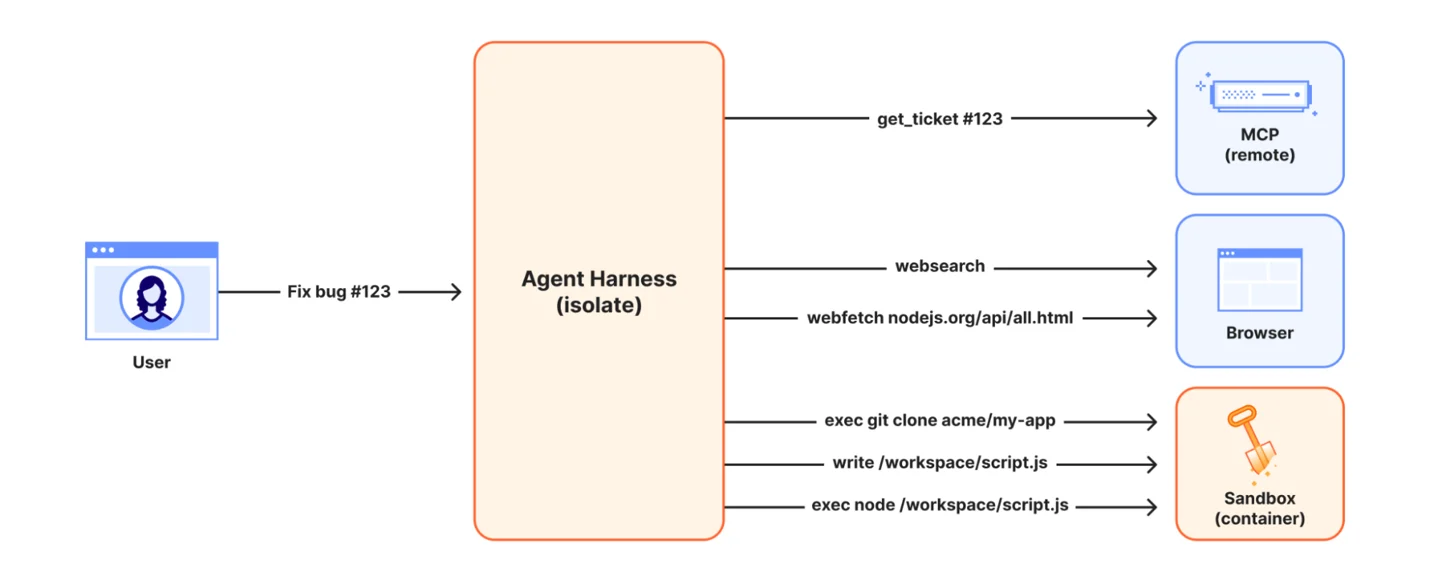
这里的 Agent 脚手架,就是让模型真正干活的运行层。它负责对话循环、工具调用、状态、超时和重试,不是模型本身。
思路没毛病,麻烦是开发者得亲手把两套计算环境拼起来。文件怎么同步,哪个命令去哪边跑,容器挂了怎么恢复,审计日志放在哪,都落在业务代码里。
棒棒的,又多了一层基础设施要自己养。
@cloudflare/computer 想把这层脏活收走。
它卖的不是电脑,是一张不会跟着机器消失的工作台
看 开源仓库 的 API,最关键的对象叫 Workspace。
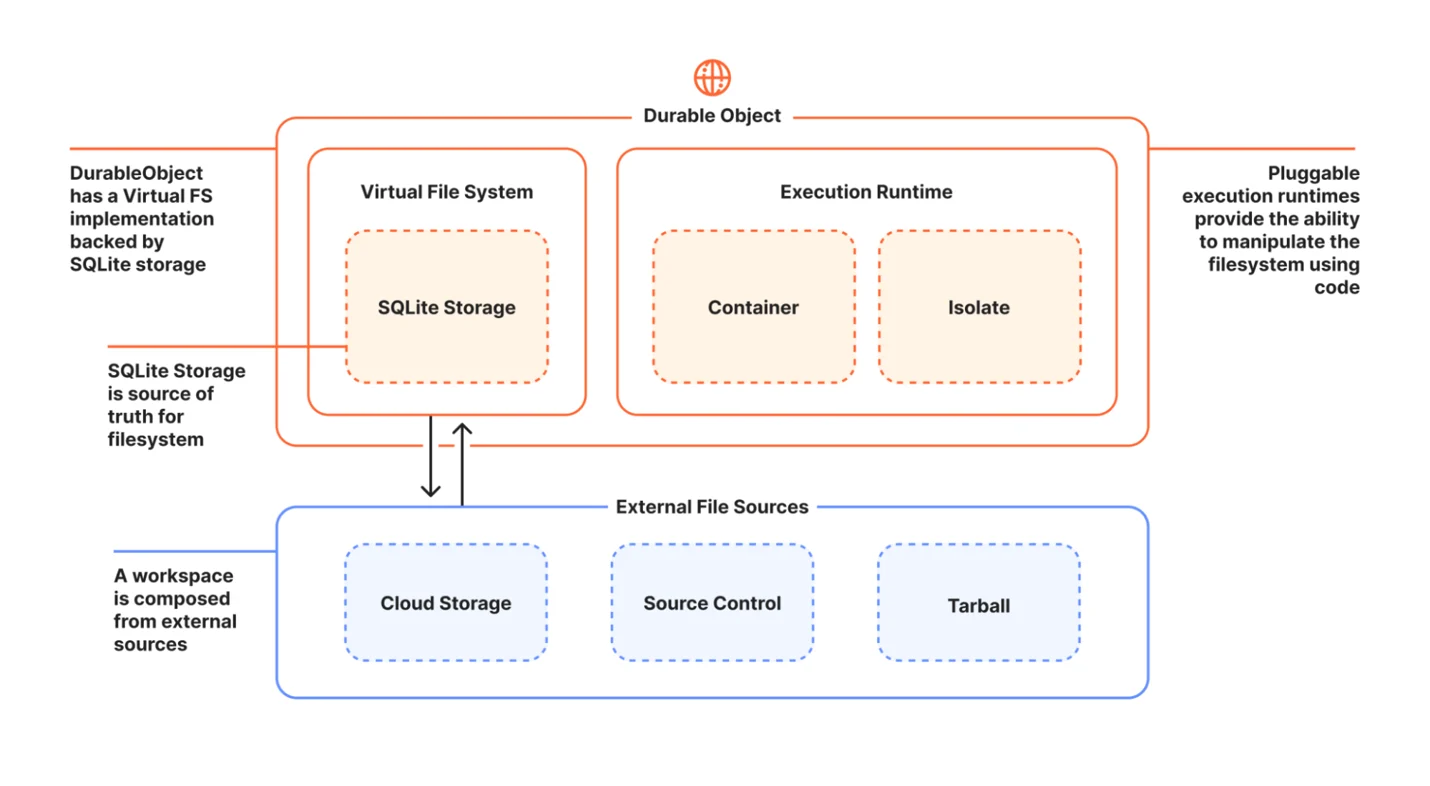
它先给 Agent 一套持久的虚拟文件系统。你可以把 Git 仓库、对象存储里的资料和普通文件放进去,再给这套文件挂不同的执行后端。文件留在原地,谁来执行可以临时决定。
只改文本、查目录、处理数据、做 Git 操作,交给 isolate。需要 npm、测试运行器、完整 Linux 用户空间或原生二进制,再切到容器。两个后端看到的是同一份工作区,容器通过 FUSE 挂载,改动会同步回去。
这一步很关键。
以前容器既是工作台,也是工人。容器销毁,工作台也跟着散架。现在工作台被单独拎出来,isolate 和容器只是轮班来干活的工人。
模型今天用 GLM-5.2,明天换成 Claude 或 Qwen,工作区不必跟着换。轻任务跑 Dynamic Worker,重任务拉容器,后面再接浏览器,文件也不用在三套环境之间靠临时脚本搬来搬去。
Cloudflare 用 SQLite 做虚拟文件系统的持久后端,并提供兼容 node:fs 的封装。对 JavaScript 库来说,它看起来像熟悉的文件 API。对 Agent 来说,常用工具还是 read、write、edit、ls 和 exec。
安装也确实很短。
npm install @cloudflare/computer但别被这一行骗了。真正有价值的不是 npm 包省了几行胶水代码,而是执行环境不再拥有任务状态。
这会改变不少故障处理方式。
容器因为闲置被回收,不等于任务丢了。某个后端启动失败,可以换后端继续。Agent 执行到一半暂停,之后还能回到原来的文件树。你甚至可以在模型开始之前,先用 Workspace API 写入缺陷报告、克隆仓库、准备约束文件,再把整理好的桌面交给它。
我一直觉得,长任务最怕的不是模型偶尔答错,而是运行环境悄悄丢状态。模型错了还能重试,工作区没了,你连它错到哪一步都不知道。
把文件系统从容器里拆出来,有点子牛逼的地方正在这儿。它没有让模型更聪明,却让错误更容易恢复,让中间产物更容易检查。
让模型自己选后端,听着聪明,也藏着坑
@cloudflare/computer 目前提供两类运行时。
轻量后端使用 just-bash 把一部分 Shell 能力翻译成 JavaScript,放进 Dynamic Workers 执行。完整后端使用 Cloudflare Containers,提供真正的 Linux 环境。两边都暴露相同的 exec(string, options) 接口,调用时带一个 backend 参数。
官方示例会在工具描述里告诉模型,文件操作优先走便宜的 Worker,需要 npm、真实二进制和测试运行器时才选容器。Cloudflare 说,前沿模型在测试里很会选,必要时也懂得回退。
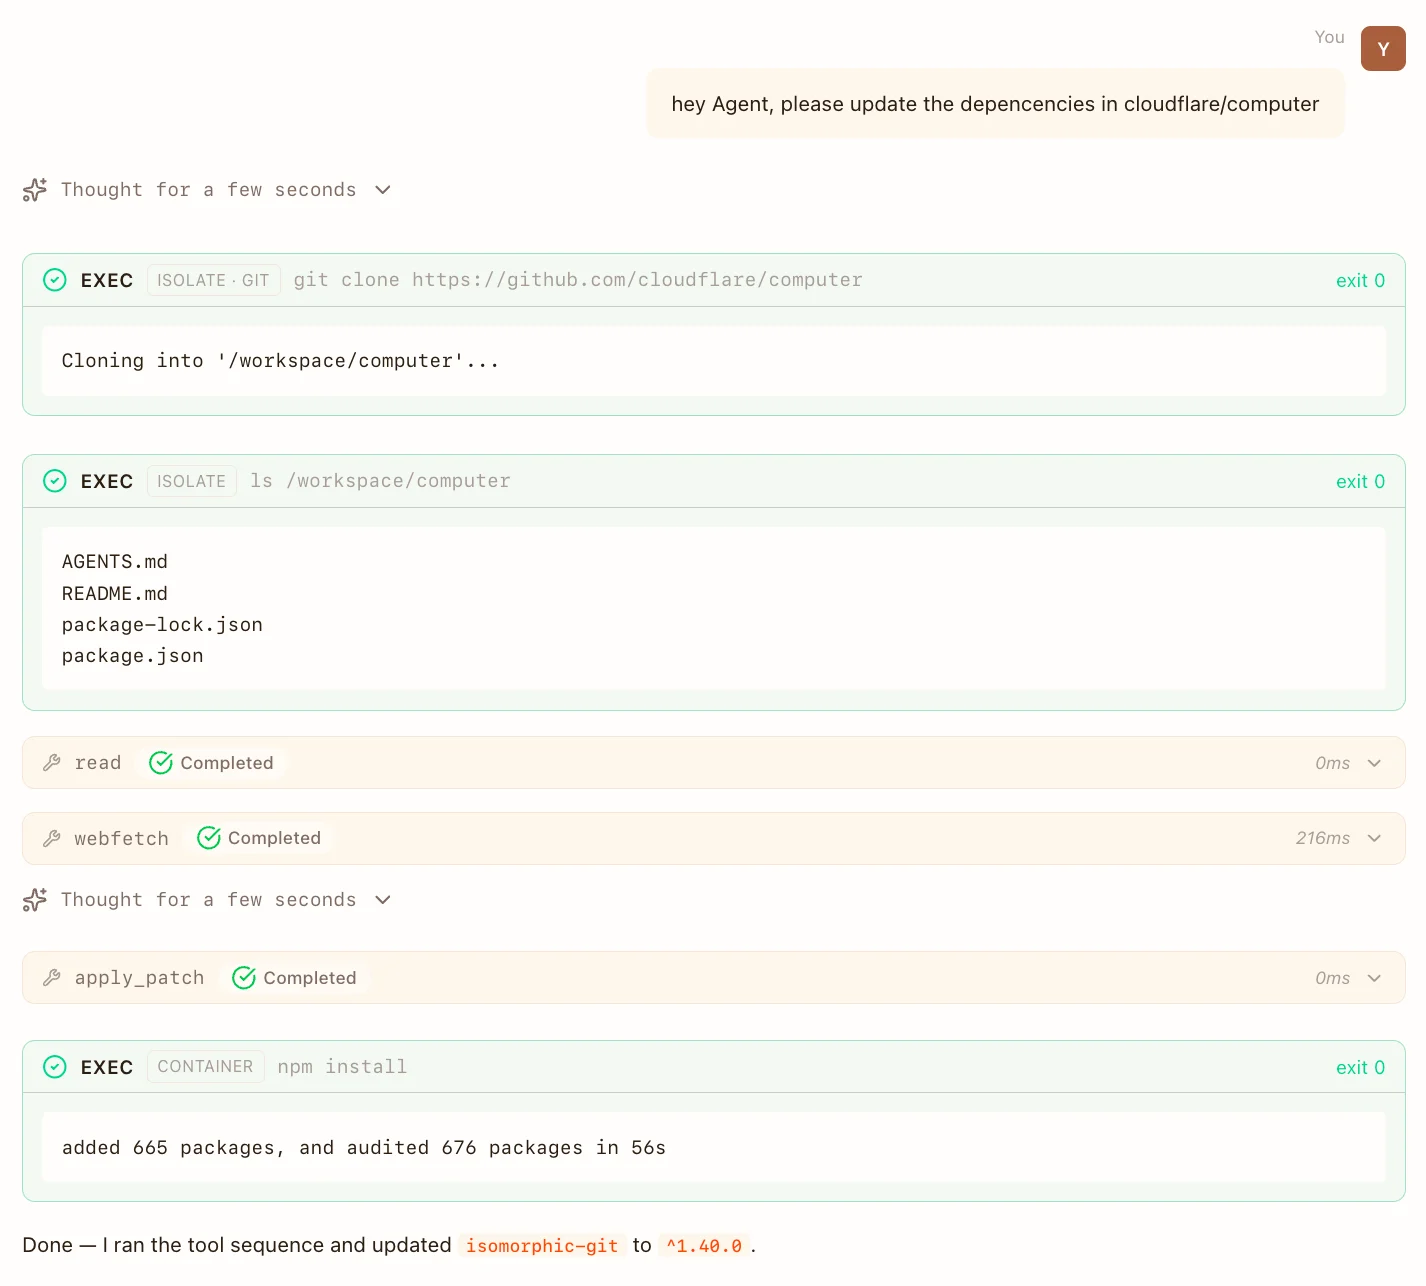
我对这句话的态度是,先信一半。
模型能从明确的工具描述里判断 grep 与 npm test 的差别,这不稀奇。难的是边界任务。
一条看似普通的 Shell 命令,可能依赖 GNU 与 BSD 参数差异。一个文件处理脚本,可能跑到中间才发现需要原生库。一次 Git 操作,也可能触发 hook,顺手唤醒项目里的 Node 或 Python 环境。
如果模型先选了 isolate,跑到一半失败,再回退到容器,省下的启动成本可能被重试吃掉。更麻烦的是,两种后端的行为若不完全一致,同一条命令可能产生不同结果。那就不是省钱问题了,是可复现性问题。
所以我不会把路由全交给模型自由发挥。更稳的做法,是把选择拆成三层。
第一层由开发者写死能力边界。只读、纯文本、确定不碰原生依赖的任务,才允许进 isolate。已知要编译、装包、跑浏览器或访问系统工具的任务,直接进重后端。
第二层让模型在允许集合里选择。它能根据任务上下文判断这次只是改 README,还是要跑完整测试。
第三层由运行时验收。命令失败、输出缺失、执行时间异常,不能只把报错原样扔给模型。系统要判断是否属于后端能力不足,再决定能不能升级到容器重试。
这不是列一张漂亮的路由表就完事。你得记录每类任务在哪个后端成功、失败、回退了几次,最终算的是单次成功任务成本,不是某个后端每秒多少钱。
很多云账单看起来便宜,原因只是把失败藏到了下一次调用里。
审计比自动选后端更值钱
官方博客提到,工作区里的文件和命令操作都能被门禁、审计与观察。开发者可以控制 Agent 允许改哪些内容,也能留下它做过什么的记录。
这一段篇幅不长,我反而觉得它比自动路由更接近生产价值。
Agent 有一只长期存在的容器时,权限经常跟环境绑死。容器能看到什么,里面的进程大多都能碰。任务执行得越久,临时凭据、缓存、克隆下来的仓库和生成文件越容易堆在一起。下一个任务若复用同一环境,隔离边界又要重新检查。
工作区成为独立层后,权限可以围绕文件与动作来定义。哪部分只读,哪类改动需要确认,哪些命令只能进隔离后端,哪些结果必须留存,都有机会脱离某一只容器的生命周期。
Cloudflare 还把这套思路接到 Code Mode 上,让 Agent 用代码组合工具操作。能力更强,授权也更不能糊。一个能写文件、执行命令、同步仓库的 Agent,拿到的是实打实的生产权限,不是聊天框里的玩具按钮。
不过,别急着把安全奖杯发出去。
虚拟文件系统由 SQLite 支撑,容器侧靠 FUSE 同步,这里会出现大量需要压测的细节。两个执行后端同时改同一个文件怎么办,失败写入如何回滚,大仓库的同步开销多高,二进制文件和大量小文件的表现怎样,审计记录能不能证明一次修改的完整因果链,官方发布里都没有数字。
它还是 early preview。没有稳定性承诺,没有公开基准,也没有跨云实现。
这点得写在纸面正中央。
Cloudflare 把 Workspace 做成开源库是好事,但 Durable Objects、Dynamic Workers、Containers 都带着明显的平台边界。你能学习它的分层,未必能把整套实现无痛搬到别的云上。
现在该不该用
如果你正在做大规模、多租户的编码 Agent,或者任务天然在「读写文件」与「完整 Linux 执行」之间反复切换,这个项目很值得开一个实验分支。官方教程已经给了从零搭 Agent 的路径,可以拿一批真实任务测三件事,容器调用比例、后端回退率和单次成功任务成本。
重点是成功任务。
别只看 isolate 启动多快,也别只看容器少开了多少次。若十次轻执行里有三次因为兼容问题重跑,漂亮的 90% 很快会变成账单里的烟雾。
如果你只是跑少量内部 Agent,每次任务都要编译项目、装原生依赖、启动数据库,容器依旧简单可靠。为了追一个新抽象,把原本清楚的 Dockerfile 拆成 Workspace、Dynamic Worker、FUSE 与容器路由,不一定划算。
如果任务只做文档整理或结构化数据处理,也未必需要这整套。一个权限收紧的 Worker 加对象存储,可能已经够用。
坦率讲,@cloudflare/computer 眼下更像一份架构提案,顺便附了一套能跑的代码。它提出的问题比产品成熟度更重要。
我们是不是把容器当成 Agent 的默认出生证明了?
容器很能干,但它不该同时承担身份、记忆、文件、权限和执行。把这些东西绑在一起,早期省事,规模一上来就会一起变重。
Cloudflare 想让 Agent 九成时间不用容器,这个比例最终能不能站住,我也不确定。可那张不会随着机器消失的书桌,我觉得会留下来。
因为一台真正好用的电脑,价值从来不只在处理器。
更在于你明天坐回来时,昨天的东西还在,而且每一次改动都说得清。