posts/codex-agents-control-plane.md
Codex 能管一群 Agent,还不算调度系统
四个终端标签页,名字都叫 codex。
一个在改接口,一个在补测试,一个卡在权限确认,剩下那个已经结束十分钟,只是没人发现。
这不是模型能力问题,是人脑的线程列表快溢出了。
Codex CLI 0.149.0刚加了两个很小、也很要命的入口。codex agents 会打开交互式任务仪表盘,可以搜索、启动、打开、重命名和停止任务。codex queue 能把新消息投递给已有的本地或远程会话。
好家伙,终端里的 Agent 终于不只会干活,也开始有人管了。
我觉得这版最值得聊的不是又多了两条命令,而是产品边界悄悄挪了一格。过去的 Codex CLI 更像一位坐在当前目录里的结对程序员。现在它开始出现控制面的形状,你可以看见一群任务,再把工作送到指定会话。
但先别急着把它叫成调度系统。
能看见一群 Agent,和能可靠地运营一群 Agent,中间还隔着一整套工程合同。
面板解决的是失明,不是失控
多 Agent 工作最早暴露的痛点往往很朴素。
不是模型不会写代码,而是你不知道哪条会话在写什么。终端标签页只能告诉你有几个窗口,tmux 只能告诉你窗格还活着,它们都不知道某个线程正在等审批、已经失败,还是把结果留在了另一个 worktree。
这类需求早就有人在 GitHub 议题 #30713里讲得很直白。开发者想知道哪些 Agent 仍在运行,分别属于哪个项目和 worktree,谁在等待输入,谁已经完成,以及怎样快速跳回指定线程。
0.149.0 的仪表盘先补了最关键的一层可见性。相关实现把 Agent 概览放进 TUI,后续提交又让它变成可操作的任务面板,并加上独立命令和可配置快捷键。
这一步有点子牛逼,因为多会话一旦从标签页变成任务列表,人的注意力才有可能从「我开了几个窗口」切到「现在有哪些工作」。
不过面板里出现一个绿色状态,不代表任务真的健康。
进程还在跑,可能已经连续重试同一个失败工具。线程显示完成,可能只完成了代码生成,没有跑测试。名字叫 fix-auth,也可能在十分钟前被追加了一条改数据库迁移的消息。
仪表盘提供观察面,任务是否可交付仍要靠状态定义。
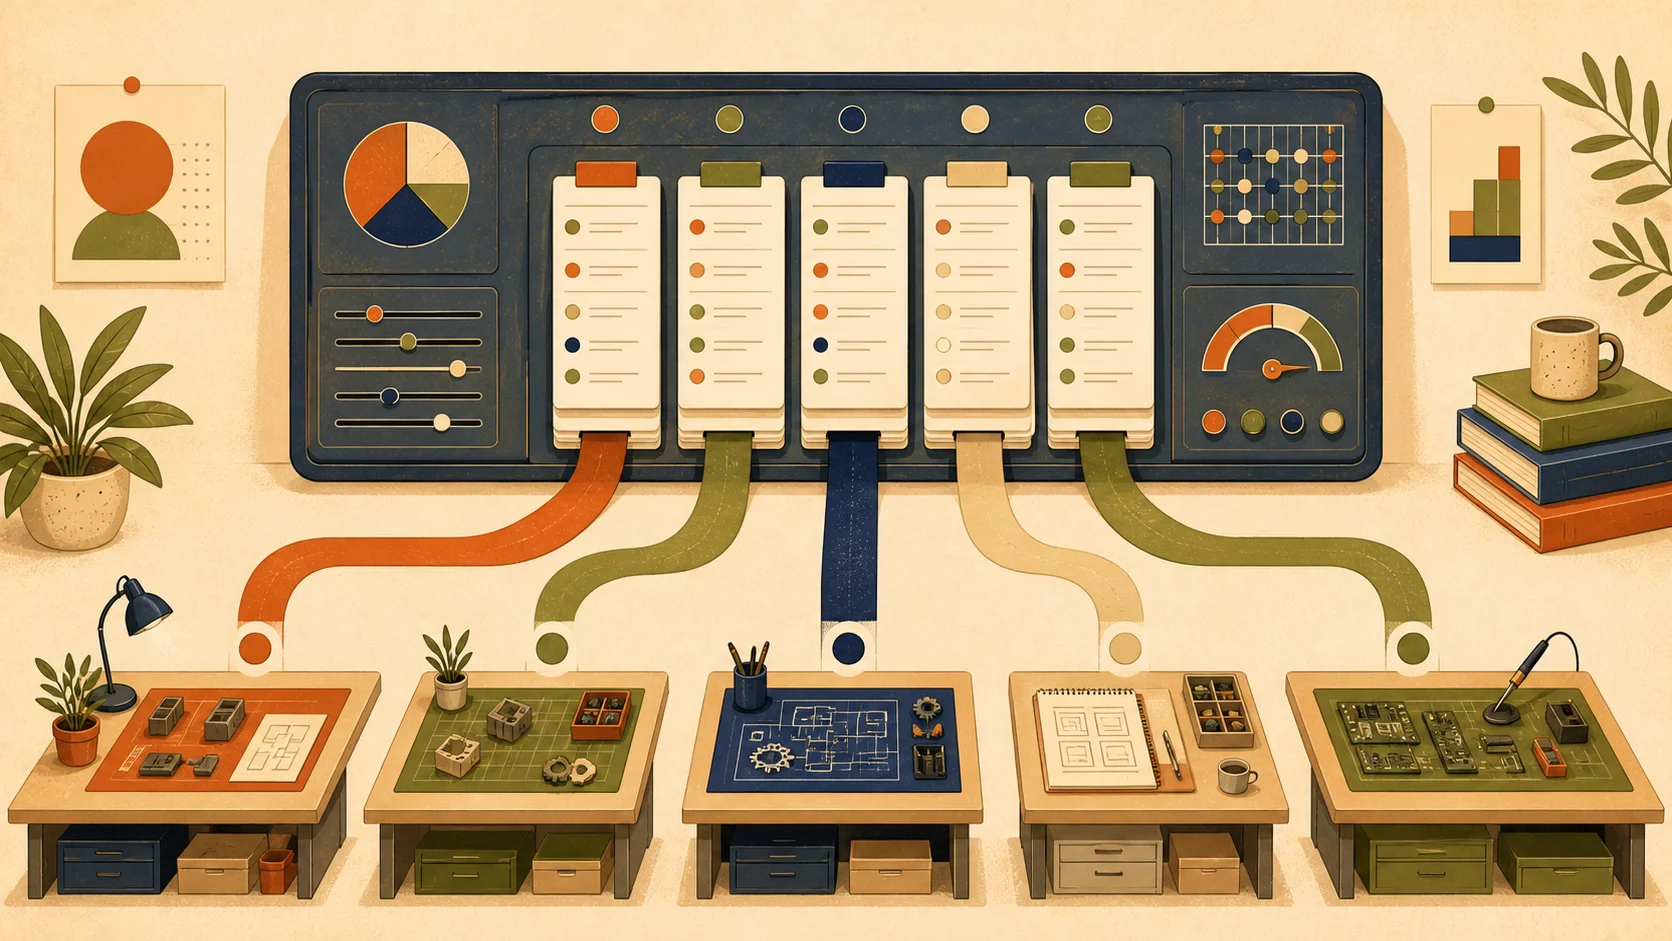
面板让任务可见,真正的状态仍要由产物和验收条件定义。
如果团队真要同时跑多条 Codex 会话,至少要给状态补上人话合同。运行中表示还有明确的下一步,等待中要写清楚在等谁,完成必须指向可检查的产物,失败要保留最后一个可恢复节点。只看进程生死,迟早会把僵尸任务当成生产力。
queue 把聊天变成了消息投递
codex queue 的实现比面板更容易被低估。
以前你要给另一条会话追加要求,通常得切回那个窗口,确认没找错,再把消息贴进去。现在可以从外部把消息送到已有的本地或远程会话。官方还专门修了几个看起来很碎的细节,队列消息能可靠唤醒空闲会话,重名时更合理地选择目标,粘贴内容和延迟命令的语义也会保留。
这些修复为什么和新命令放在同一版里?
因为消息一旦跨进程投递,聊天框那套「看见了就算送达」的直觉不够用了。
假设一个常见场景,测试会话发现接口字段变了,于是给实现会话排队一条修复消息。网络闪断后上层脚本不知道投递是否成功,又发了一遍。Agent 收到两次,第一次改字段,第二次把已经改好的代码再重构一轮。测试最后绿了,可 diff 多出一大片无关变化。
不是哥们,消息队列可不能靠缘分。
生产里至少要给每条任务一个稳定 ID,再给每次投递一个消息 ID。接收方记录处理过的 ID,重复消息直接回执,不重新执行。任务名可以给人看,路由不要只靠名字。0.149.0 会在重名时偏向最近会话,这是好用的交互兜底,却不是自动化该依赖的唯一定位规则。
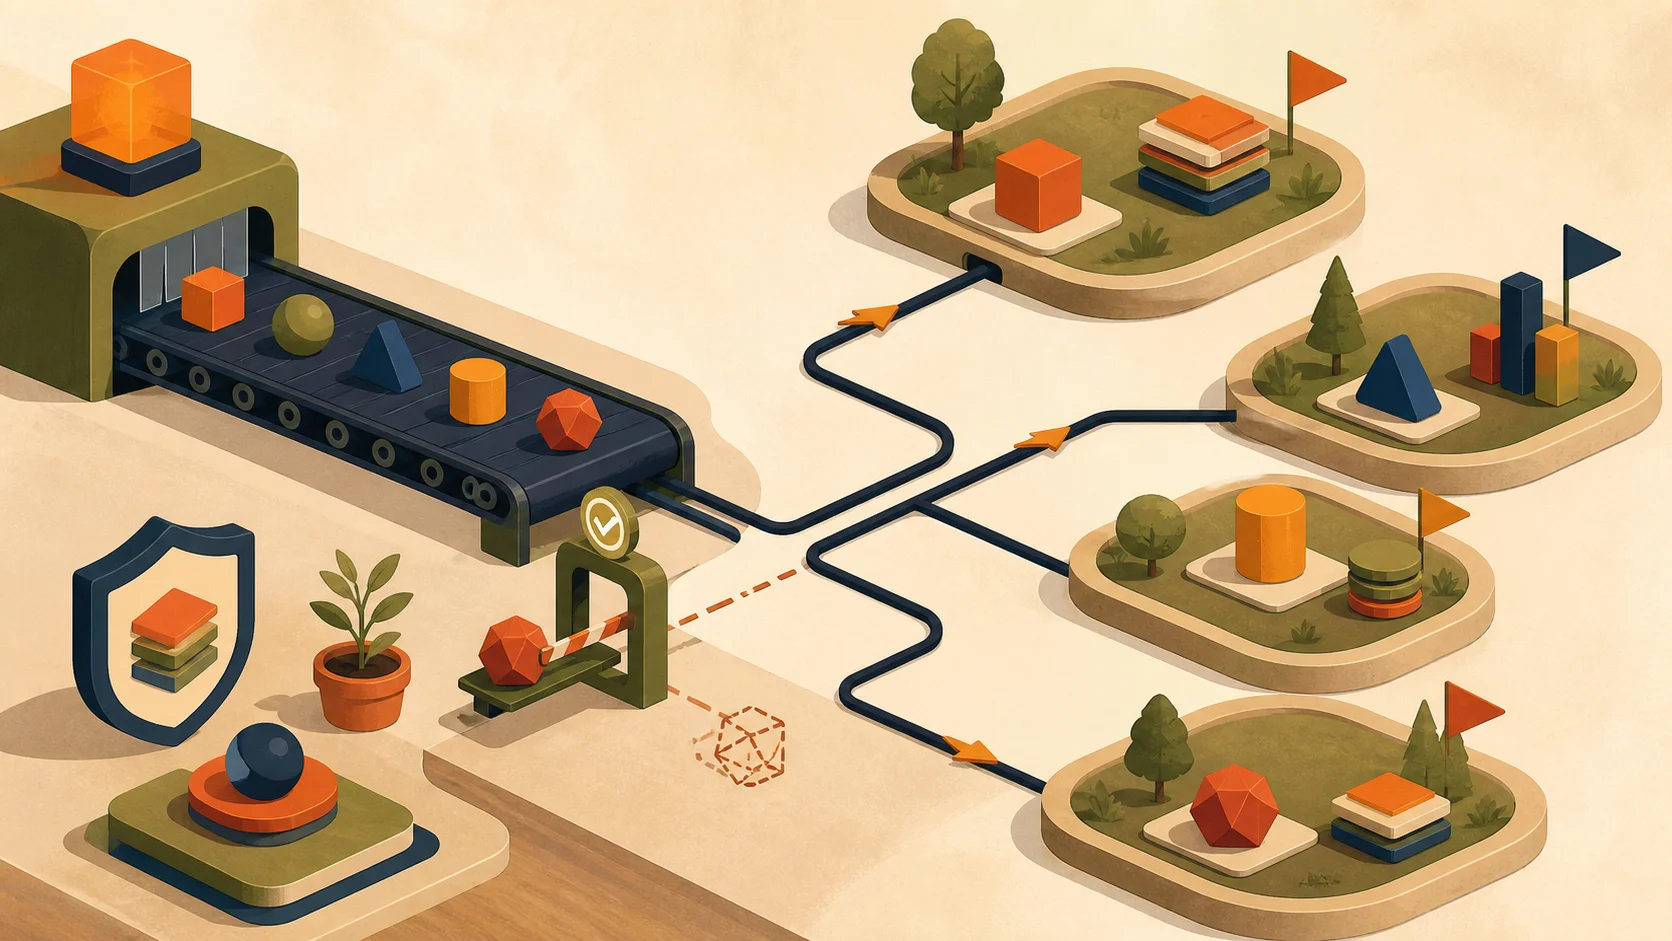
消息能送到只是起点,去重、隔离和明确归属才决定它会不会制造第二次修改。
还有一件容易漏掉的事,排队消息应该写预期产物和停止条件。
「继续修」是聊天。「把 auth.spec.ts 的三个失败用例修到通过,不改公开接口,若需要迁移数据库就停下等待确认」才接近任务。
前者把判断全塞给模型,后者给了它一条可以验收的跑道。
真正的控制面要管权限、预算和产物
0.149.0 的发布说明里,还有几条修复比新功能更能说明问题。
恢复和分叉线程现在会恢复原来的权限配置,不会悄悄退回当前默认值。子 Agent 的重复活动被修掉,通知与审批的 TUI 路由也收紧了。Realtime 旁路连接断开后会重连,不丢待输出内容。
看着都是边角料,其实全是多会话控制面的承重墙。
同一条任务恢复后如果权限变了,它不是「继续干」,而是换了一份安全合同。审批通知跑错线程,人可能在看 A 的 diff,却批准了 B 的命令。连接恢复后如果只补文本、不补动作状态,界面说任务还在继续,底层也许已经把同一条命令跑了两遍。
厉害了,多 Agent 把单会话里偶发的小 bug,放大成了系统问题。
所以团队在真正放开并行任务前,最好先把三条边界钉住。
权限跟着任务走,不跟着当前终端的默认配置走。预算跟着会话走,到 token、时间或重试次数上限就暂停。产物跟着验收规则走,提交、测试报告、截图或基准结果至少要有一个能被另一个进程确定性检查的落点。
这三条里,最容易被忽略的是预算。
一个 Agent 慢,不一定危险。十个 Agent 同时在错误方向上很勤奋,才是真的贵。没有单会话上限和全局配额,仪表盘只是让你更漂亮地看着账单增长。0.148.0已经把估算成本放进 /status、状态栏和终端标题,0.149.0 又增强了 codex doctor 的网络、代理和桌面状态诊断。信号已经有了,团队还得自己把「看到成本」接成「超过阈值就停」。
worktree 也一样。
一个 Agent 一个 worktree,能隔开文件修改,却隔不开数据库、开发端口、缓存目录和外部服务。两条会话都觉得自己在跑干净测试,实际可能共用同一个 Redis 前缀。一个刚把测试数据清空,另一个就报出一片随机失败。
真正可运营的做法,是让任务启动时领取一份环境清单。仓库路径、分支、端口、临时目录、数据库 schema、允许访问的网络目标都写进去。恢复线程时重新校验清单,资源已经被别人占用就先停,不要让模型临场猜。
产物也不能只写一句「已完成」。
代码任务至少留下 commit 或 diff、执行过的命令、测试结果和未解决风险。研究任务留下来源列表、判断依据和无法验证的部分。界面任务留下可复现的启动方式与截图。然后由另一条确定性流程检查这些文件真的存在、测试真的退出为零、链接真的能打开。
Agent 的自然语言总结适合给人读,不适合单独充当完成凭证。它可以很真诚地说一切顺利,同时把一个失败的退出码埋在上面三百行日志里。
棒棒的,活干完了,证据没跟上。
到这里就能看出控制面和调度系统的差别。前者让你找到任务并对它发消息,后者还要保证任务拿到正确资源、只执行该执行的一次、在预算内结束,并交出可验证的结果。0.149.0 把入口补上了,后半段仍是工程活。
控制面的价值从来不是让更多东西同时动,而是让错误能被尽早看见,也能被及时叫停。
多 Agent 的尽头不是更多窗口
8 月 23 日的开发者工具观察把这一周的主线概括成多会话控制、成本可见性和更稳的子 Agent 路径。Codex 不是唯一往这里走的工具,只是它把变化直接塞进了很多程序员每天打开的终端。
这会改变一个很具体的工作习惯。
以前大家把 Agent 当成更聪明的命令行,一次开一条,盯着它跑完。以后更像值班工程师看一组服务,平时不需要盯每个 token,异常时能定位线程,任务变化时能投递消息,结束后有统一验收。
屏幕前如果已经同时开着几个编码 Agent,可以先做个很朴素的改造。任务名写成稳定的动宾短语,每条会话只认一个所有者,追加消息都带验收条件,跨 worktree 的改动禁止自动合并,完成状态必须由测试或产物检查触发。
不需要先造一个宏大的平台。把这几条写进脚本和团队约定,已经能挡住不少事故。
我自己的判断是,codex agents 和 codex queue 不会让多 Agent 自动变可靠,但它们把真正的问题暴露出来了。
过去我们缺的是模型能力。后来缺工具。再后来工具多到满屏都是,缺的变成任务所有权、状态语义和停止条件。
终端标签页终于不用数了。
接下来该数的,是每条任务有没有人负责,有没有预算,失败后能不能恢复,结束时拿什么证明它真的做完。