posts/codex-image-compaction-budget.md
Codex 给图片补预算,视觉 Agent 早该补课了
Codex CLI 0.149.1 的发布说明,短得像没写。
页面上只有一个 Full Changelog 链接。点进去,5 个提交,23 个文件变更,没有模型升级,没有新工具,也没有一眼能拿去截图转发的大功能。
好家伙,真正有意思的那一行藏在第二个提交里。
过去那套保留消息预算会数文本,却没有把图片算进去。截图多的会话看起来没超预算,实际塞进去的上下文已经比账面大。等系统自动压缩时,它只能拿一把只量文字的尺子,去裁一段图文混在一起的历史。
这不是 Codex 独有的小毛病。只要你的 Agent 会看截图、读扫描件、操作浏览器、分析图表,这笔账迟早会找上门。
很多团队已经给 prompt、工具返回和模型输出设了 token 上限,却还把图片当附件。附件听起来不要钱,推理时可不是。
64000 token 里,图片曾经是账外资产
OpenAI 的官方压缩指南把 compaction 用在长对话、多工具调用和超长任务里。它会把旧状态压成可继续使用的内容,减少后续请求占用的上下文。官方也提醒,压缩结果应该被当作不可解析的内部状态,不要依赖它的具体形态。
道理不复杂。一个 Agent 连续工作几小时,跑了终端、浏览器、测试、图片分析,历史不可能无限增长。到某个节点,系统得决定什么留下,什么被压缩,什么直接离场。
0.149.1 之前的一个具体问题在于,远程压缩的保留消息预算主要按文本计算。源码里这块默认预算是 64000 token,但图片没有按已有的尺寸估算进入同一本账。
文本是刷卡消费,图片像签单消费。月底一对账,厉害了,额度没爆,钱先没了。
假设一个常见的视觉调试任务。Agent 打开网页,每轮拿一张截图,再读一段 console 日志。十几轮之后,文本预算可能仍很宽松,可截图已经占掉大量输入。压缩器若只盯文字,就会误以为还能多保留几轮历史。
结果不一定立刻报错。更麻烦的是它可能继续跑,只是后面的判断开始变飘。
它记得报错文字,却忘了按钮当时在哪。它留下了图片说明,却把对应截图裁掉。它还能说出上一轮做了什么,却无法确认页面视觉状态有没有变化。
这种故障特别烦。没有 500,没有 stack trace,测试偶尔还能过。你只会觉得模型今天怎么有点笨,然后顺手把锅甩给随机性。
我一直觉得,Agent 最危险的失败不是当场崩,而是带着一份残缺历史继续表现得很自信。视觉上下文没进预算,正好会制造这种安静的失忆。
不过,把图片换算成 token 也只解决了容量问题,不等于解决了价值问题。
两张分辨率相同的图,推理价值可能差得很远。一张是几乎空白的加载页,另一张是塞满错误标记的架构图。按字节或像素估算,它们吃掉的预算差不多。对任务而言,后者却可能是后面十轮判断的唯一证据。
所以图片预算应该有两层。底层负责容量,回答还能不能塞进去。上层负责任务价值,回答真要裁时先保哪张。
上层不用一开始就做成玄学评分器。先把图片和产生它的动作绑在一起就很有用。浏览器点击后的截图、测试失败时的 diff、用户上传的原始设计稿,这三种图的身份不同。前两种通常能重新生成,后一种可能是不可再生的输入。
如果系统只按时间从旧到新裁,用户最早上传的设计稿反而最先消失。后面的 Agent 还能看到十几张自己操作网页的截图,却忘了最初要对齐的目标长什么样。棒棒的,执行过程全在,任务定义没了。
更稳的办法,是把不可再生输入、里程碑状态和可重放过程分层。压缩时优先保留任务定义与关键里程碑,可重放的中间截图允许只留引用和生成路径。这里没有万能顺序,至少得让策略知道它正在裁哪一种证据。
这部分不是 0.149.1 的官方承诺,而是从它暴露的问题往生产环境推一步。容量记账解决「装不下」,来源与可重放性解决「该留谁」。两笔账缺一笔,长任务都会在某个下午开始失忆。
截断不是删掉最老的一张图
0.149.1 没有粗暴地把图片换算成一个数字就收工。它新增了 compaction_image_budget 开关,复用已有的图片大小估算,并把图片与相邻标签当成一个整体处理。
注意,这个开关在 0.149.1 的功能表里仍标成开发中,默认关闭。
所以别看到版本号就急着写「升级后已经修好」。不是哥们,代码进了正式 release,不等于功能已经对所有会话默认生效。这条边界如果不写,新闻稿就从信息变成许愿池了。
更值得看的,是它怎么处理截断边界。
Codex 的本地图片消息并不只有一块二进制数据。图片旁边可能还有开始标签、文件路径和结束标签。若预算刚好卡在中间,只保留图片不留标签,或者只留下说明不留图片,后面的模型都会拿到一份语义断裂的历史。
新逻辑把图片和相邻标签视为原子组。放得下就一起留,放不下就一起丢。若边界处的图片已经塞不进剩余预算,系统也不会为了把数字填满,再绕过去捞更老的消息回来。
乍看有点浪费。
但上下文预算不是俄罗斯方块。填得满不代表拼得对。
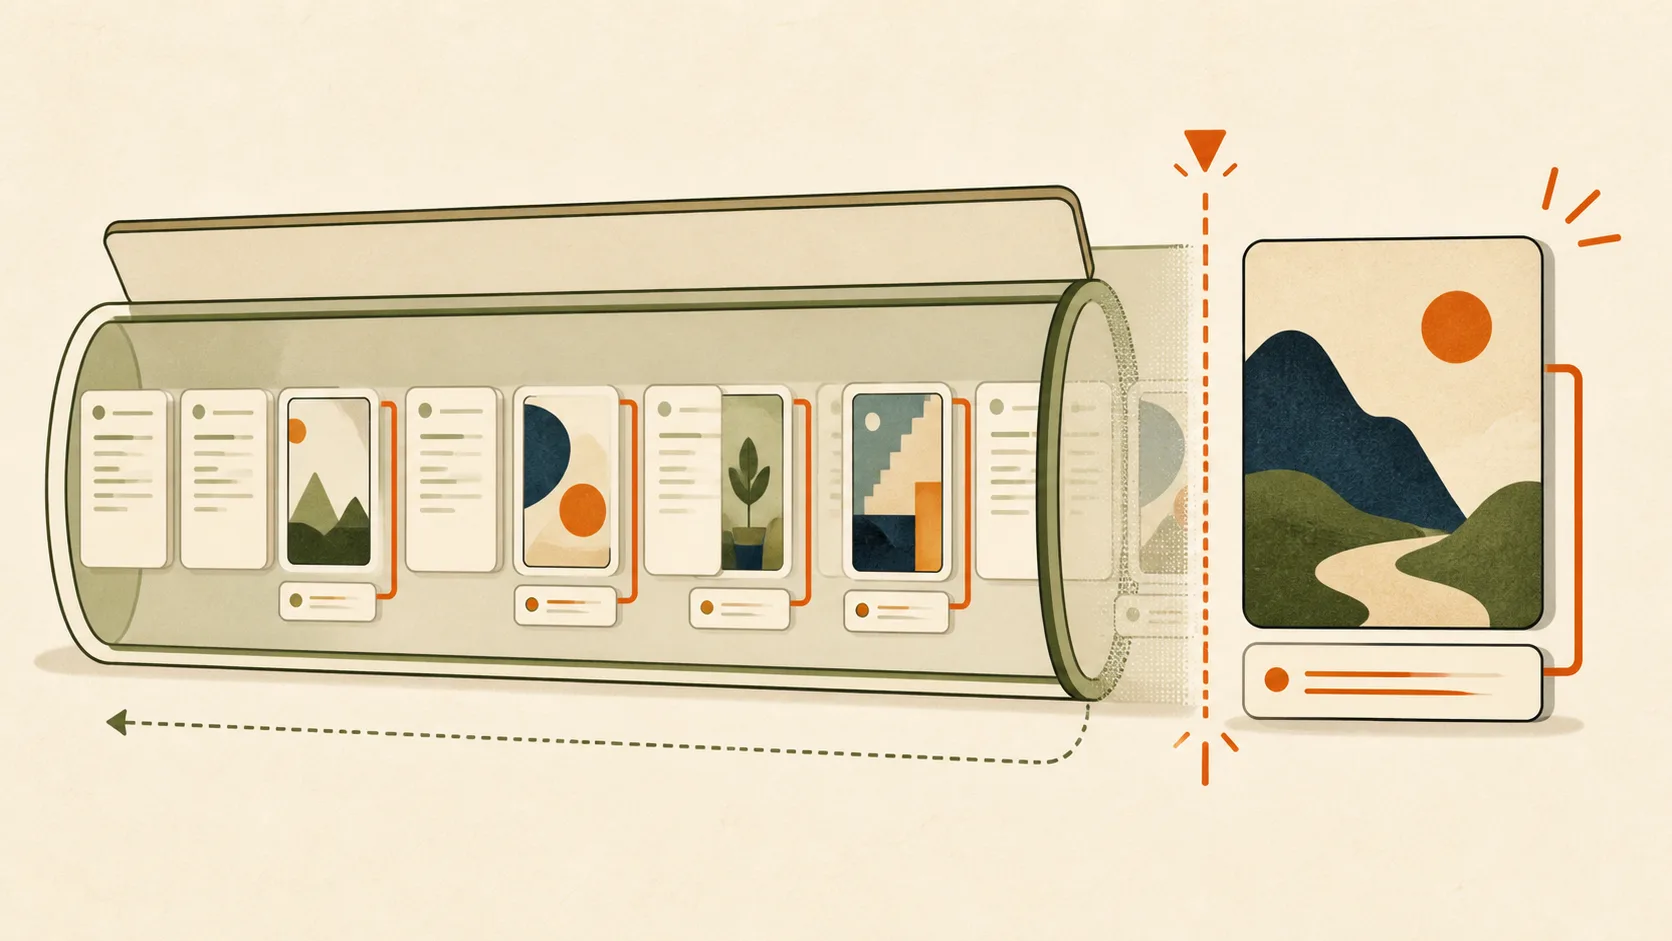
图片和相邻标签要作为一个整体保留或丢弃,预算不能只追求填满。
从新到旧截取历史时,中间出现一个放不下的图片组,继续回填更老的文本,会制造一段看似充分、时间关系却断掉的记忆。宁可留白,也别让 Agent 误以为那几段旧话紧挨着最新状态。
这一手有点子牛逼。它承认上下文里有些东西不能切半,也承认预算利用率要让位给语义完整性。
工程上可以把这件事再往前推一步。别只问压缩后剩多少 token,还要问保留了多少图片、丢了哪一轮视觉状态、图片说明是否仍能定位到原图、压缩边界落在哪个工具调用之后。
对应的远程压缩实现已经记录保留图片数量。对于生产里的视觉 Agent,这类指标比一个孤零零的总 token 数有用得多。
因为总量只能告诉你箱子多重,图片计数和边界事件才告诉你箱子里少了什么。
这里最好别只打一行「compaction succeeded」。成功太宽了,几乎等于没说。
一次可追踪的压缩,至少要能串起压缩前的线程版本、触发原因、预算上限、保留图片数、丢弃图片数、边界消息 ID 和压缩后的新窗口 ID。若图片与标签是原子组,还应该记录这一组是整体保留还是整体丢弃。
这样排查时才能从结果往回走。Agent 在第 42 轮看错按钮,先找到它使用的压缩窗口,再看对应边界有没有丢掉第 35 轮截图。若截图还在,再查图像理解。若截图已经被裁,就别拉着模型团队开半天会了。
图片本身也需要稳定 ID。不要只拿本地临时路径当身份,容器重启、远程执行和媒体上传都会让路径变化。更实用的是内容哈希加语义角色,例如 user_reference、browser_state、test_artifact。前者解决同一张图跨环境怎么认,后者解决策略裁图时怎么选。
还有一个容易踩的坑,OCR 文本和原图不要各活各的。
很多视觉流水线会先对截图做 OCR,再把文字作为一条独立消息塞回上下文。若压缩只保留 OCR、丢掉原图,布局信息就没了。若只保留原图、丢掉 OCR,后续又得付一次识别成本。两者应该共享同一个证据 ID,让系统知道它们是同一份状态的不同表示。
你想想看,这和数据库里只保留外键、不管被引用记录还在不在,是一回事。模型很新,数据完整性的问题却一点都不新。
thread_source 那一行,比新参数更值钱
这次另外两个提交看起来更小。
一个给 codex exec 增加了 --thread-source,新建或 fork 线程时可以写入来源。另一个把 detached memory request 标成 memory_consolidation,也就是把后台记忆整理和普通用户请求区分开。
codex exec --thread-source scheduled_writer官方提交明确了参数边界。省略时来源默认是 user。它只在新建线程时生效,恢复已有线程不会覆盖原值,TypeScript SDK 也同步暴露 threadSource。
另一条 memory consolidation 提交则保证,请求头与嵌套客户端元数据里的线程来源一致。
这两条不会让模型写代码更快,演示视频里也看不出区别。可一旦 Agent 从单次聊天变成系统,它们会突然很值钱。
同一个模型请求,可能来自用户手动输入、定时任务、代码审查、失败重试、后台记忆整理,或者某个父 Agent fork 出来的子任务。全都记成 user,监控面板自然很漂亮。请求都成功,延迟也能算,成本还能按天画线。
出了事就傻眼。
某天凌晨成本多了 30%,到底是用户变多,定时任务卡循环,还是记忆整理被重复触发。某个线程压缩后质量下降,是视觉任务丢图,还是后台整理任务污染了统计。没有来源标签,日志越多,排查越像在仓库里翻没有单号的快递。
更骚的是,来源分类还不能只留在应用数据库。请求进队列、被重试、fork 新线程、写入 trace 以后,这个字段得一路跟着走。中间任何一层把它丢了,末端那张成本报表都会把后台任务伪装成人类需求。
我会把来源拆成三层看。
最外层是触发者,用户、定时器、Webhook 或系统维护任务。中间是工作类型,代码审查、写稿、测试修复、记忆整理。最里面是谱系,当前线程从哪个父线程 fork,经历了第几次重试,恢复时沿用了哪段历史。
只放一个自由文本字段当然装不下全部信息,但 thread_source 至少把第一块地基铺出来了。应用可以把更细的任务类型和父子关系放进自己的 trace,而不是继续把所有请求叫作 user。
重试尤其要单独看。同一个用户动作因为网络超时执行三次,业务请求量还是一,模型调用量却是三。若三次都生成新线程,来源和父请求 ID 没跟过去,成本平台会告诉你今天来了三位勤奋用户。
这画面多少有点幽默。用户没变多,报表先完成了增长目标。
来源字段真正的验收点也在这里。发起任务时写进去不算完成,排队后还在、重试后还在、fork 后能继承或明确改写、resume 时不漂移,到 trace 与账单维度仍能对得上,才算完成。
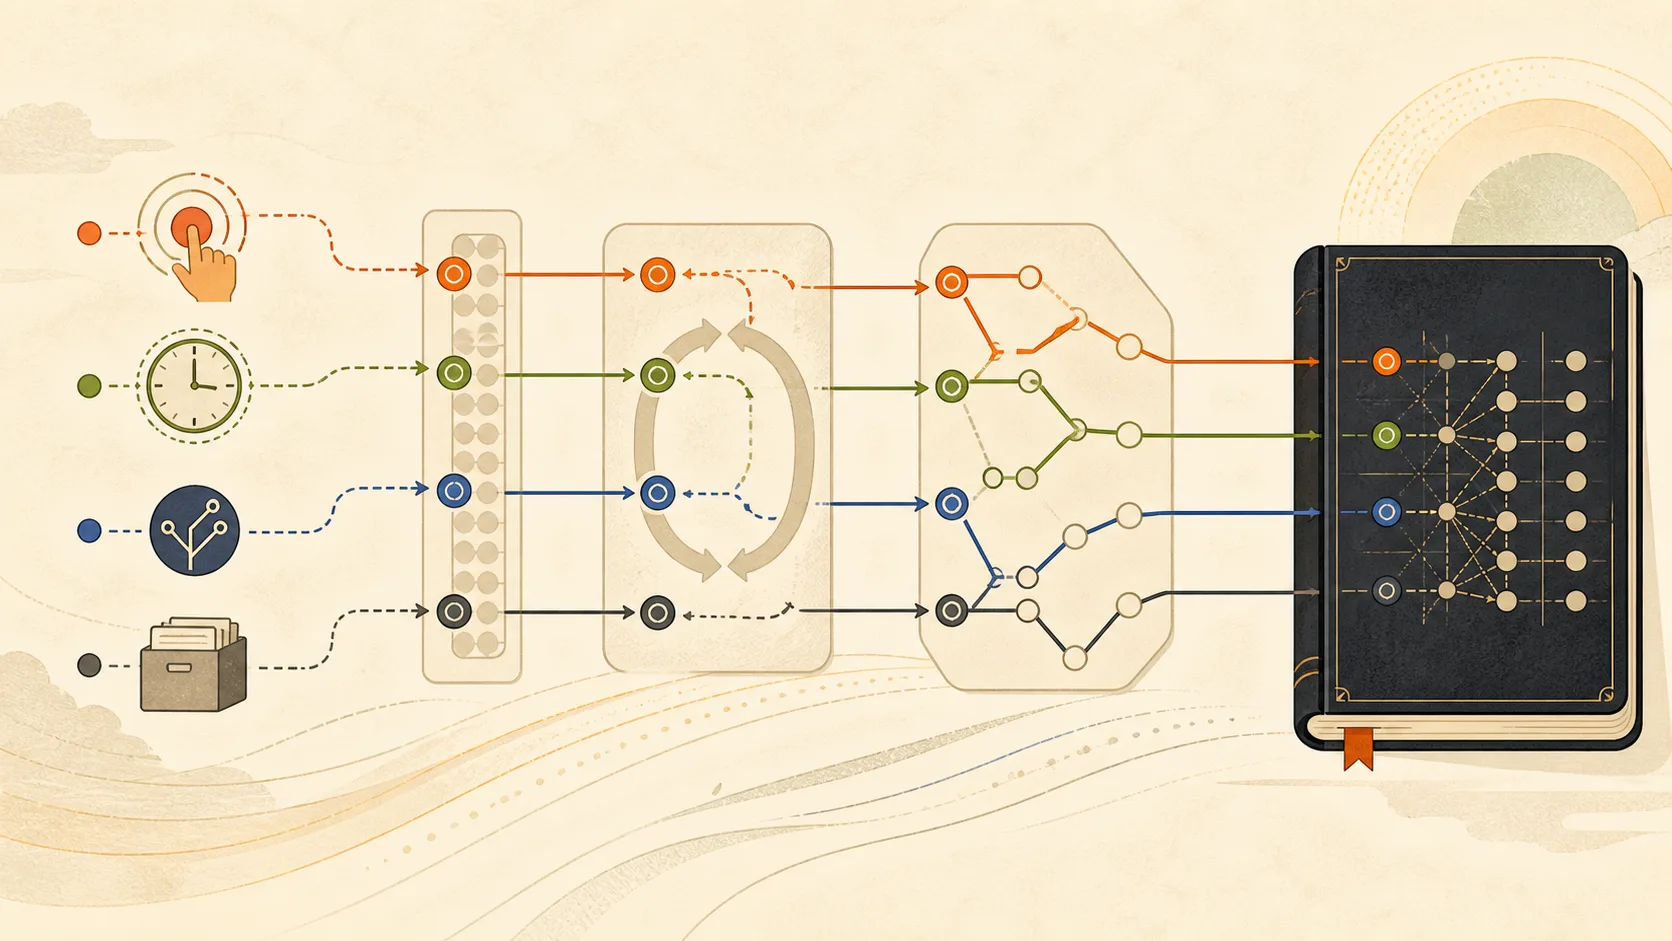
用户触发、定时任务、分叉线程与记忆整理,穿过队列和重试后仍要能追溯来源。
这里得说清楚,thread_source 不是权限边界,也不是安全沙箱。它只是元数据。可没有可信元数据,权限审计、成本归因和质量评测连起跑线都站不上去。
真正该抄的是一份验收合同
如果你的系统只跑纯文本短任务,0.149.1 大概率只是个小补丁。
如果任务里有浏览器截图、设计稿、PDF 页面、摄像头帧或者图表,建议把它当成一次提醒。模型能看图,不等于你的上下文工程已经会管图。
可以先写一份很朴素的验收合同。
context_contract:
  text_tokens: measured
  image_cost: estimated
  image_label_pair: atomic
  compaction_boundary: traced
  dropped_images: counted
  thread_source: preserved
  resumed_thread_source: immutable
  memory_consolidation: separated
这不是让每个团队照抄 Codex 的内部实现。重点是,压缩之前和之后都得有可比较的状态。
同一组任务,在压缩开关关闭和开启时各跑一遍。记录图片数量、边界位置、后续工具成功率和人工判定质量。再故意构造一张刚好放不进剩余预算的大图,确认系统不会把标签拆散,也不会跨过它回填一段更老的历史。
测试样本不要全是漂亮 demo。放一条纯文本长任务,确认新逻辑没有改坏旧行为。放一条图片与音频混合的任务,确认图片开始计量后音频处理仍符合原合同。再放一条 developer message 携带图片的任务,检查系统级约束不会在边界裁剪时被误伤。
视觉任务还要准备两类反例。一类是同尺寸不同价值的图片,空白加载页与关键架构图并排出现。另一类是同一证据的两种表示,原截图和 OCR 文本一起进入上下文。压缩后让 Agent 回答既依赖文字又依赖布局的问题,看看它究竟保住了证据,还是只保住了字数。
别急着先定一个漂亮的通过率。把旧版本与新版本跑在同一批代表性任务上,人工标记失败属于丢图、错配、来源漂移还是模型判断,再决定门槛。没有故障分类的总分,很容易把四种问题压成一条看似稳定的曲线。
还要跑恢复线程。threadSource 按官方设计不该在 resume 时被新参数覆盖。若你的封装层每次恢复都重写来源,那就把一次持续任务切成了多段身份漂移的账。
至于成本表,至少分开用户交互、自动任务、子任务和记忆整理。别只画总 token。总 token 很适合周会上看趋势,不适合事故里找凶手。
官方 Compact a Response 接口允许文本、图片和文件作为输入,也建议在重要里程碑后压缩,而不是每一轮都压。这个原则放到 CLI Agent 上同样好用。压缩是一种状态转换,不是垃圾回收按钮。每次转换都应该有原因、有输入快照、有结果指标。
说真的,0.149.1 最让我在意的不是图片终于被估了多少 token。
而是它把三件经常被揉成一团的事拆开了。内容有预算,边界有语义,线程有来源。
模型能力继续涨,视觉输入也会越来越多。可一个 Agent 能不能长时间稳定工作,终究还是落在这些不性感的小账本上。图算没算,标签断没断,请求从哪来,压缩后还能不能解释。
罗盘很亮,海图也很新。
别忘了给货舱称重。