posts/codex-open-harness-app-server.md
Codex 开源的不是模型,是 Agent 底盘
8 月 19 日,OpenAI 发了一篇开发者文章,标题里最关键的词不是 Codex,而是 Platform。
文章说得很直接,开源的 Codex Harness 正在驱动 App、CLI 和 IDE 等体验,开发者可以把同一套 Agent 能力塞进运维面板、安全调查、客服工作台,或者公司内部那堆长得不太好看但谁也离不开的系统里。
两天过去,这件事又在开发者圈里冒头。有人把它概括成「Codex 全面开源」。听着很猛,也很容易听歪。
先把边界钉死。OpenAI 没有在 8 月 21 日突然放出 Codex 模型权重,也没有把托管后端和所有云服务打包扔上 GitHub。2 月 4 日那篇 App Server 工程文章 才是架构说明的起点,8 月 19 日的新文章做的是平台化重申。
真正开放出来的,是模型外面那层让 Agent 能长期干活的工程底盘。
这层东西,我们通常叫 Harness。第一次看到这个词的朋友,可以把它理解成「给模型搭脚手架的那层工程」。模型会生成文字和代码,Harness 负责找上下文、调工具、管会话、收 Diff、卡审批、做沙盒、处理中断,再把这些过程变成用户能看懂的进度。
好家伙,开源的不是大脑,是神经、手脚和驾驶舱。
我反而觉得,这比又开放一个模型 API 更值得工程师认真看。
先把「开源」两个字掰清楚
OpenAI 的 官方开源组件清单 现在写得很清楚。Codex CLI、Codex SDK、Codex App Server、Skills 和 Plugins 都有公开源码,核心代码集中在 openai/codex,许可证是 Apache-2.0。
同一张表里,IDE extension 和 Codex cloud 被明确标成不开源。云端使用的基础环境另有公开仓库,但基础镜像开源,不等于整套托管后端开源。8 月 19 日的文章还专门补了一句,开放层是 Harness 和集成接口,模型访问与托管服务保持分离。
所以,开发者拿到的不是一个离线可复刻的完整 Codex 商业服务,更不是一份模型权重。
你可以检查 Agent Loop 怎样组织上下文,工具调用怎样进入沙盒,审批怎样暂停一轮工作,Thread 怎样持久化。你也可以改这些代码,编译自己的二进制,给它接一套业务界面。
但要调用 OpenAI 模型,仍然需要对应的 ChatGPT 或 API 访问。想要 Codex cloud 那种托管容器、后台任务、账号治理和整套在线体验,也不能从一个 git clone 里凭空长出来。
这条线必须画清楚。否则「开放 Harness」被传成「Codex 全家桶开源」,开发者拉完仓库才发现模型、配额和云端能力还在服务侧,多少有点标题负责起飞,README 负责降落。
真正拿到手的,是一套会跑的底盘
打开仓库,最值得看的不是最外层 CLI 参数,而是 Rust workspace 里的 codex-rs/core。OpenAI 把它定义为所有 Agent 逻辑所在的库和运行时。它能启动 Agent Loop,也能管理一个 Codex Thread 的持久状态。
这里的 Agent Loop,不是一段把 Prompt 发给模型再打印答案的 while true。
一次任务开始以后,Core 要把用户输入、仓库指令、当前目录、会话历史和工具能力拼成模型能工作的上下文。模型要求执行命令或修改文件,运行时要落到工具层和沙盒。动作需要批准,整轮工作就暂停,等客户端返回允许或拒绝。输出太长,要流式发送。网络断了,Thread 还要能恢复。用户中途补一句,系统还要决定是 steer 当前 Turn,还是再开一轮。
这些听起来都是边角料,真做过生产 Agent 的人会知道,边角料往往会长成仓库里最大的几个目录。。。模型调用常常几天就能跑通,失败恢复、权限、状态迁移和 UI 同步能陪你过好几个季度。
Codex Core 还把配置、认证、Shell 与文件工具、MCP servers、Skills、会话存储放在同一套策略模型下。codex-app-server 的 Cargo 依赖直接连着 codex-core、codex-tools、codex-sandboxing、codex-thread-store、codex-login 和 codex-mcp。
它不是一个给现有 API 换皮的薄代理。
它是一套已经知道 Agent 会怎样失控、卡住、断线、要权限、产生 Diff 的运行时。
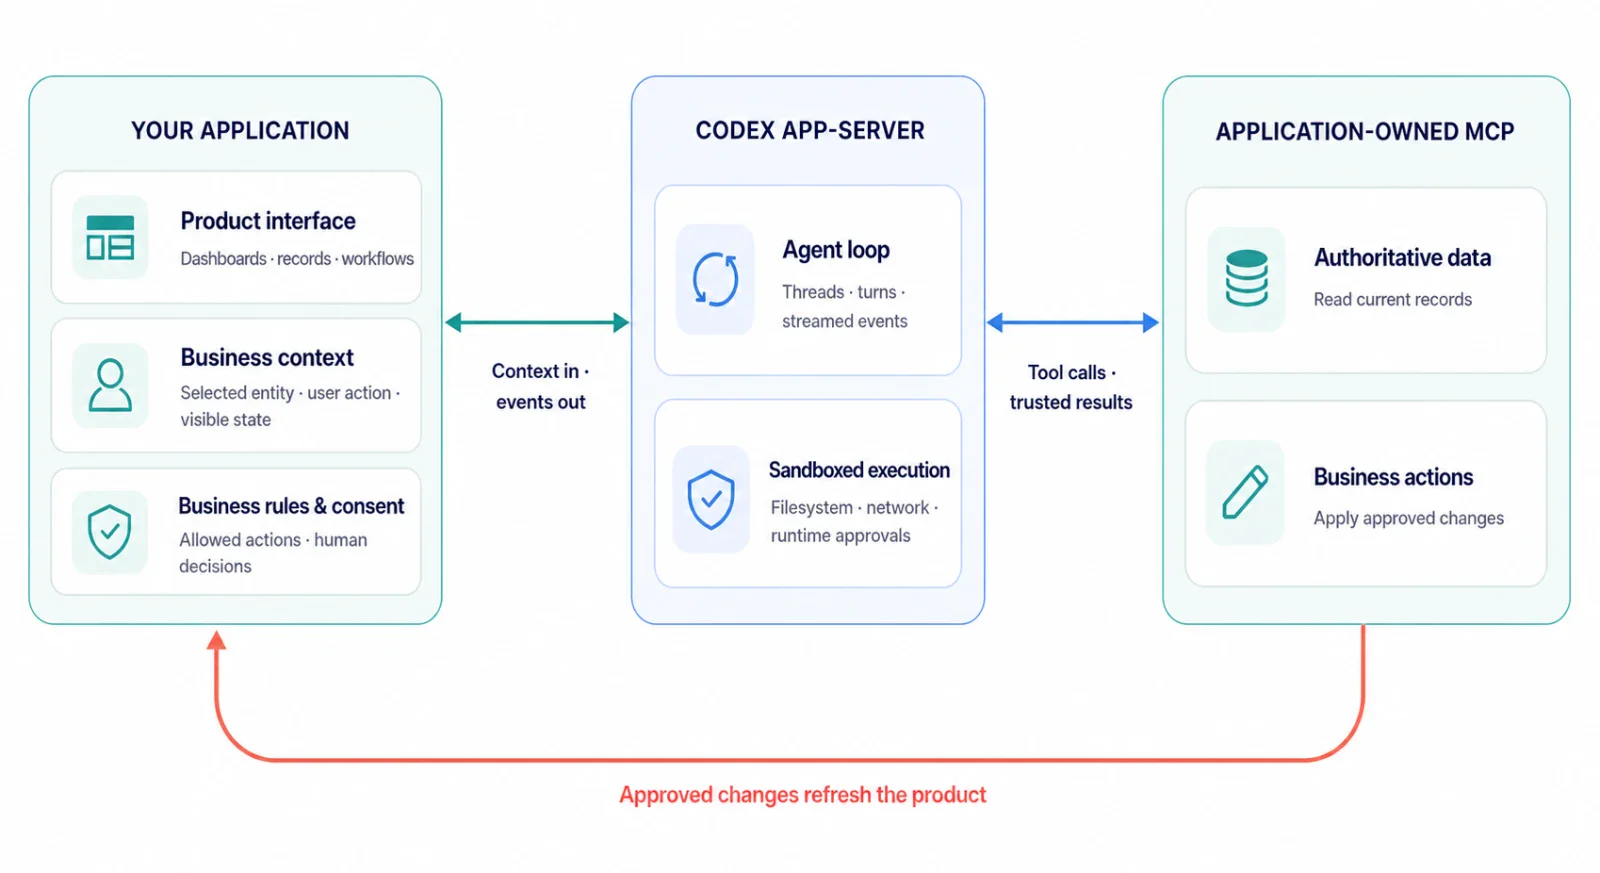
这张官方架构图有个很重要的分工。左边的产品界面、业务上下文、规则和用户同意归你的应用。右边的权威数据和业务动作也归你的系统。中间 App Server 提供 Agent Loop 与沙盒执行。
这比「做一个万能聊天框」克制多了。Agent 不负责吞掉整个产品,它负责进入产品原有的工作流。
App Server 把过程变成了产品契约
Core 有了,客户端怎么用?这就是 Codex App Server 的工作。
它一半是长期运行的进程,一半是双向 JSON-RPC 协议。进程里有 stdio reader、消息处理器、Thread manager 和多个 Core sessions。客户端发进来的请求被翻译成 Core 操作,Core 吐出的细粒度事件再被整理成稳定的通知。
这里最有点子牛逼的设计,是它没有把 Agent 对话硬塞回传统请求响应。
官方用了三个原语。
Item 是最小输入输出单元。用户消息、Agent 消息、命令执行、文件修改、工具调用、审批请求、Diff,都可以是 Item。它从 item/started 开始,流式内容通过 Delta 事件往外冒,收束到 item/completed。
Turn 是一次用户输入触发的完整工作。里面可以有很多 Item,可能先读文件,再跑测试,再改代码,再解释结果。
Thread 是可持久化的会话容器。它装着多个 Turn,可以 start、resume、fork 和 archive。
于是客户端不必盯着一段混合文本猜 Agent 走到哪了。看到命令 Item,就渲染终端进度。看到文件修改 Item,就展示 Diff。收到 Server 主动发来的 approval request,就弹出审批卡片并暂停当前 Turn。断线重连以后,继续从 Thread 历史恢复时间线。
默认传输是 stdio 上的一行一个 JSON,也就是 JSONL。协议保留 JSON-RPC 的请求、响应和通知形态,只在线路上省略标准头。当前文档也提供 WebSocket 和 Unix socket,但 WebSocket 明确标着 experimental and unsupported。拿它做本地试验没问题,直接裸露到公网,属于周五晚上主动给自己加班。
只给 API 和交出 Harness,差了多少
这里容易出现另一个误会。开放 Harness,不是说模型 API 没用了。现在的模型 API 本来就能流式输出、请求工具,也能提供不同形式的会话能力。
差别在责任边界。
只给 API 时,开发者仍要决定长任务怎么拆,历史怎么存,中断怎么恢复,命令、Diff 和审批在 UI 里怎么表示,Shell 与文件写入套什么沙盒,工具失败以后重试还是回滚,客户端断线后以谁的状态为准。
这些都不是模型能替你拍脑袋决定的产品语义。
App Server 把一套已经被 Codex 多个界面使用的语义交了出来。Thread、Turn、Item 是状态契约,审批是双向协议,工具执行有统一事件,认证和配置也在运行时里。开发者不必从几十个松散回调开始,重新发明一个看起来像 Codex、跑起来像周末 Hackathon 的 Agent 壳。
官方 8 月文章给了一个 Relay 示例。它是虚构的物流运维面板。用户选中异常运单,应用把可见状态和业务上下文交给 Codex,Agent 通过应用自己的 MCP 工具读取最新记录,提出恢复方案。真正改动运单前,必须拿到人工批准。
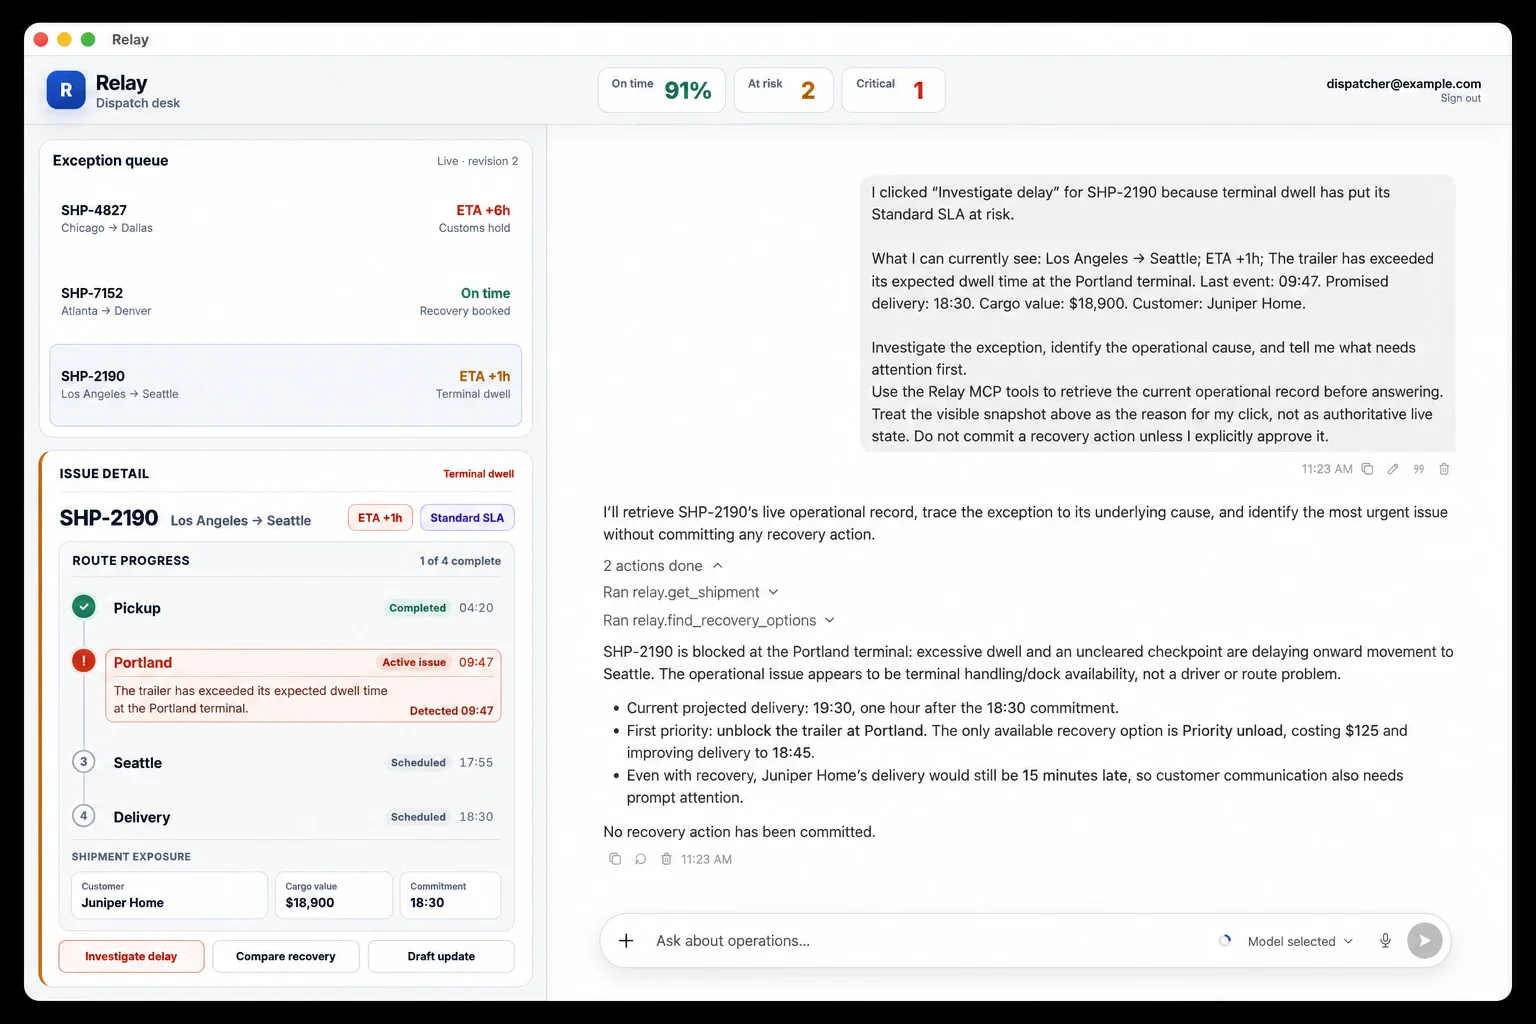
注意这个过程里,Harness 没抢走业务系统。运单记录仍在原系统,按钮仍在原界面,审批仍由人做。Agent 只是获得了一套可靠的执行循环。
这就是开放底盘比开放一个端点更有意思的地方。端点让你调用能力,底盘让你把能力放进真实产品,同时保留状态、边界和刹车。
真想动手,最小入口并不复杂
公开仓库已经给了 源码构建说明。想先用现成版本,可以安装 Codex CLI。想看 Rust 实现,就从 Cargo workspace 编译。
npm install -g @openai/codex

git clone https://github.com/openai/codex.git
cd codex/codex-rs
cargo build
把 Agent 嵌进自己的产品,不需要先改 Core。启动 App Server,再为客户端生成和当前二进制完全匹配的 TypeScript 定义或 JSON Schema。
codex app-server
codex app-server generate-ts --out ./schemas
codex app-server generate-json-schema --out ./schemas
最小生命周期也不玄学。客户端连接后先 initialize,再发 initialized。随后 thread/start 创建会话,turn/start 提交输入,然后持续读取 item/* 和 turn/completed。遇到审批请求,客户端返回决定,Turn 才继续。
如果只是跑 CI、脚本或一次性后台任务,codex exec 更省事。应用代码想启动、恢复和流式消费任务,可以先看 SDK。只有当 Agent 真的是产品交互的一部分,需要长期会话、细粒度事件和审批界面时,才值得直接接 App Server。
这个分层挺实用。别为了证明自己懂协议,给一个 nightly 脚本手搓双向 JSON-RPC。工程不是越底层越高级,合适才是。
Fork 很自由,维护账单会晚点寄来
Apache-2.0 给了开发者很大的修改空间,但 Fork 这件事最会制造一种错觉。今天改二十行 Rust 很爽,半年后追上游两千个提交时,快乐会自动进行上下文压缩。
第一笔账是协议演进。App Server 现在区分稳定接口和 experimentalApi,生成出来的 TS 与 JSON Schema 只保证匹配运行它的那个 Codex 版本。你改了 Item 类型、审批字段或 Thread 存储格式,就要自己维护客户端兼容矩阵。
第二笔账是安全。沙盒、网络权限、命令审批、文件审批、登录、凭据刷新和 MCP 工具策略不是装一次就不动的依赖。上游修一个绕过,你的 Fork 没跟,省下的升级时间可能会换成一份事故复盘。棒棒的。
第三笔账是模型与 Harness 的共同演进。开放底盘不代表模型行为从此固定。Prompt、工具描述、压缩策略和模型能力会彼此影响。你在 Core 里做的优化,换模型后可能变成回归。没有一套真实任务评测,只靠 Demo 跑通,很容易把「能工作」误认成「能维护」。
更稳的做法,通常是先不 Fork。固定一版经过验证的 App Server 二进制,把差异化放在应用界面、业务上下文、MCP 工具、审批规则和观测系统里。升级时用协议 Schema 做契约测试,至少覆盖初始化、Thread 恢复与派生、审批拒绝、工具超时、Turn 中断和历史迁移。
只有当你确实要改变核心状态机、调度、沙盒或持久化语义,而且愿意长期背这套回归测试,Fork 才是工程选择,不是开源纪念品。
回到开头那个容易听歪的说法。
Codex 没有在今天把模型、后端和云服务全部送出来。OpenAI 真正公开的,是模型与产品之间那层最难复用、也最容易被低估的 Agent 底盘。
模型仍然是租来的能力,Harness 开始变成可以检查、修改和共同维护的工程资产。
对想把 Agent 放进真实业务的人来说,这已经够重了。