posts/context-engineering-github-path.md
上下文工程别按 Star 学,最火的仓库最费时间
GitHub 的 context-engineering topic 里,已经挤了两千多个仓库。
名字一个比一个大。有的叫 Course,有的叫 Handbook,有的从 Context 一路讲到 Memory、MCP、Multi-Agent,再顺手捎上量子语义和自我进化。
好家伙,收藏夹还没建完,人已经开始怀疑自己是不是该先补一遍操作系统和认知科学。
我自己的判断很直接。学上下文工程,最危险的不是仓库太少,而是把链接目录当成学习路径,把 Star 数当成课程质量。
上下文工程也不是「把 prompt 写得更长」的豪华说法。一个 agent 每次调用模型之前,都要回答几件很朴素的事。现在处于什么状态,哪些信息跟下一步有关,哪些工具可以露给模型,刚才的错误该保留多少,旧指令有没有失效,大段结果要不要留在窗口外。
模型调用之后,还得把输出变回可查询的状态,准备下一轮。
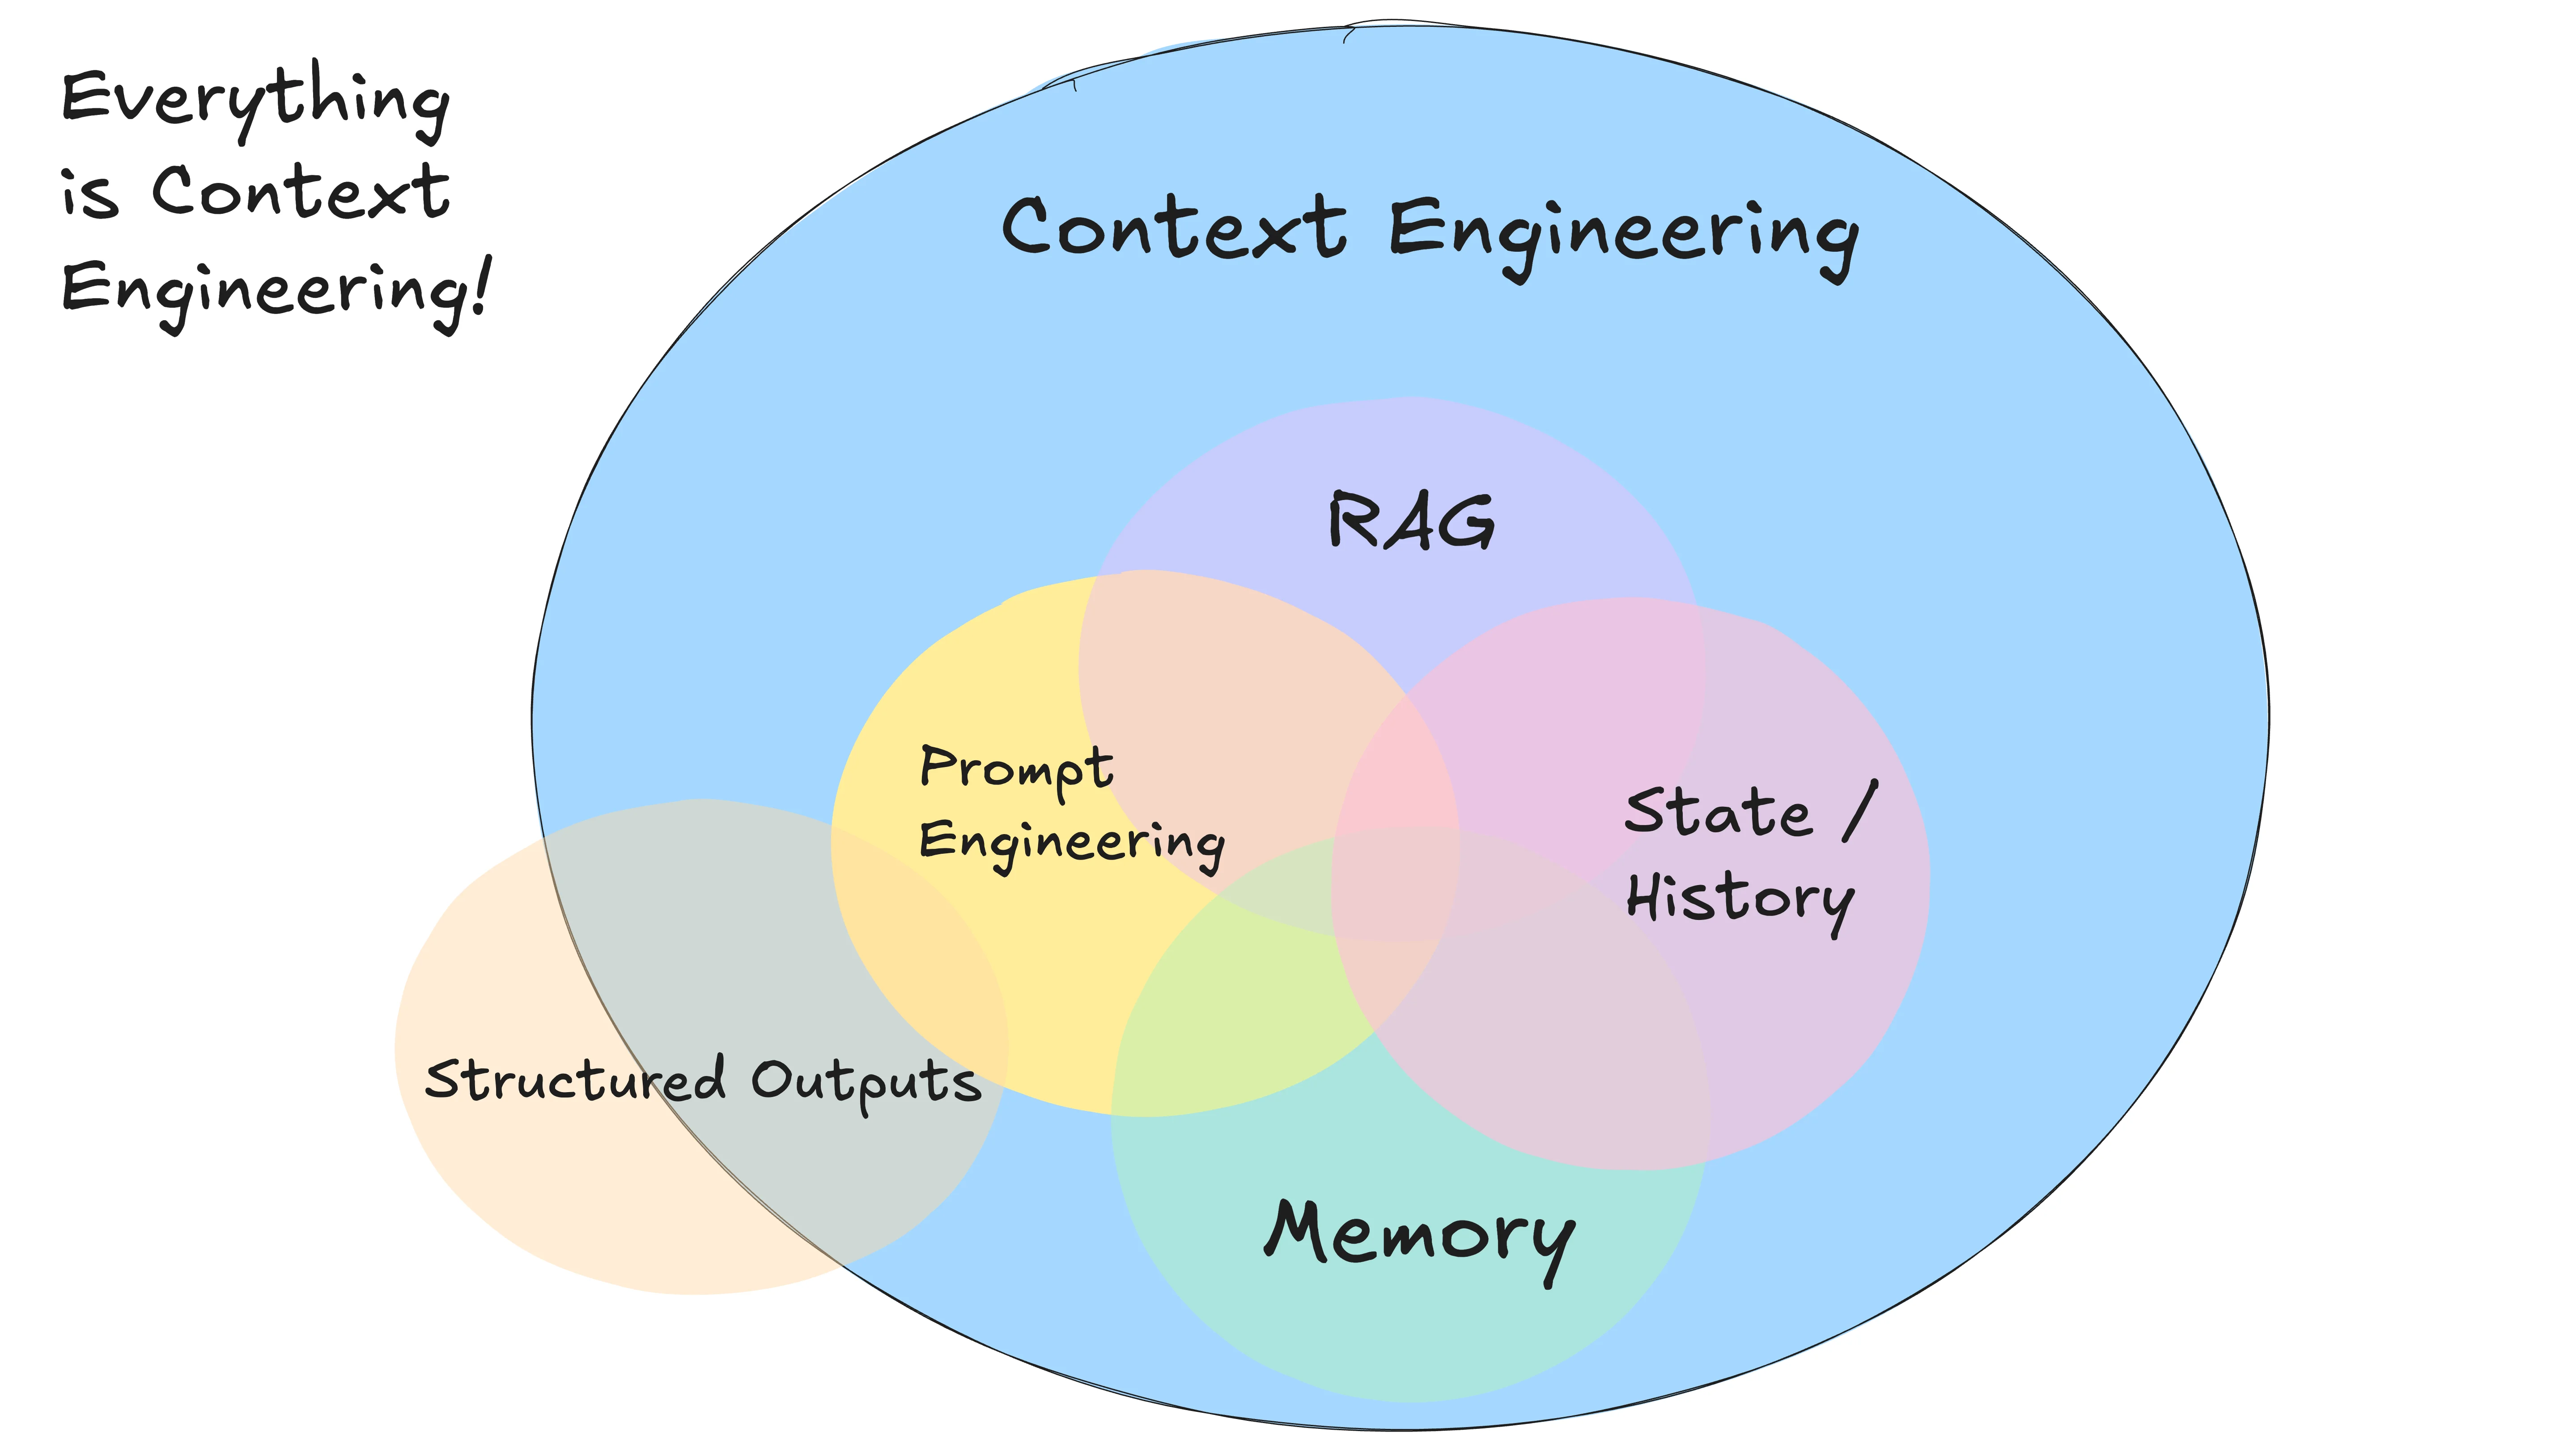
所以我筛仓库时只看一条,它能不能让你看清下一次模型调用到底收到了什么,以及这份上下文为什么长这样。
按这条标准,阅读顺序应该是 Microsoft → HumanLayer → LangChain → Hugging Face → Meirtz。先认识故障,再接管上下文窗口,然后练写入、选择、压缩和隔离,最后才补生态地图。
顺序反过来,十有八九会学成名词收藏家。
第一站只花四十分钟,先给故障起名字
第一站不是最炫的那个,而是 Microsoft AI Agents for Beginners 第 12 章。
注意,只读第 12 章。整个仓库很大,还有 Azure 和 Microsoft Agent Framework 的示例,这一轮都不用碰。我们的目标只是拿到一张够用的地图。
先记住上下文的几种来源。指令、外部知识、工具定义和工具结果、对话历史、用户偏好。它们进入同一个窗口,却有完全不同的保鲜期和信任等级。
系统规则可能长期有效,检索片段只对当前问题有用,工具返回值可能五分钟后就过期,用户刚改口的新偏好应该覆盖旧偏好。把它们全当 messages 数组里的字符串,翻车只是时间问题。
真正值得抄进笔记的是四种失败。
Context poisoning 是错误事实混进来,后面的步骤还把它当真。Context distraction 是历史太厚,模型盯着旧剧情不放。Context confusion 是工具和资料一次给太多,模型选了一个名字很像但完全不该碰的东西。Context clash 是新旧指令同时躺在窗口里,谁也没被明确废止。
这四个名字不高深,却很好用。以后 agent 做错事,别急着补一句更凶的 prompt,先问一句。
它是中毒了,分心了,混淆了,还是撞车了?
第一个练习也别写代码。找一个你见过的 agent 失败,把「模型不行」换成一张故障卡。写清楚错误信息从哪里进来,哪一轮本该被删掉,下一次调用应该保留什么证据。
做到这里,你才有资格往下读。要不然后面看到 memory、RAG、subagent,脑子里只有一排功能名,没问题可解。
第二站接管窗口,别把 messages 当数据库
第二站读 HumanLayer 的 12-Factor Agents。这个仓库谈的是生产级 agent,但不用十二条全啃。
先看 Factor 3,Own your context window。它把模型调用描述成一个无状态函数。每一轮输入都在讲「到目前为止发生了什么,下一步该做什么」。
这个视角有点子牛逼的地方,不是它用了 XML,而是它把 SDK 提供的 message 格式从「事实」降成了「一种选择」。你可以保留原始事件,可以把工具结果压成结构化摘要,也可以在错误恢复后移除已经没用的失败堆栈。
窗口不是聊天记录仓库。窗口是你为下一步临时组装的工作台。
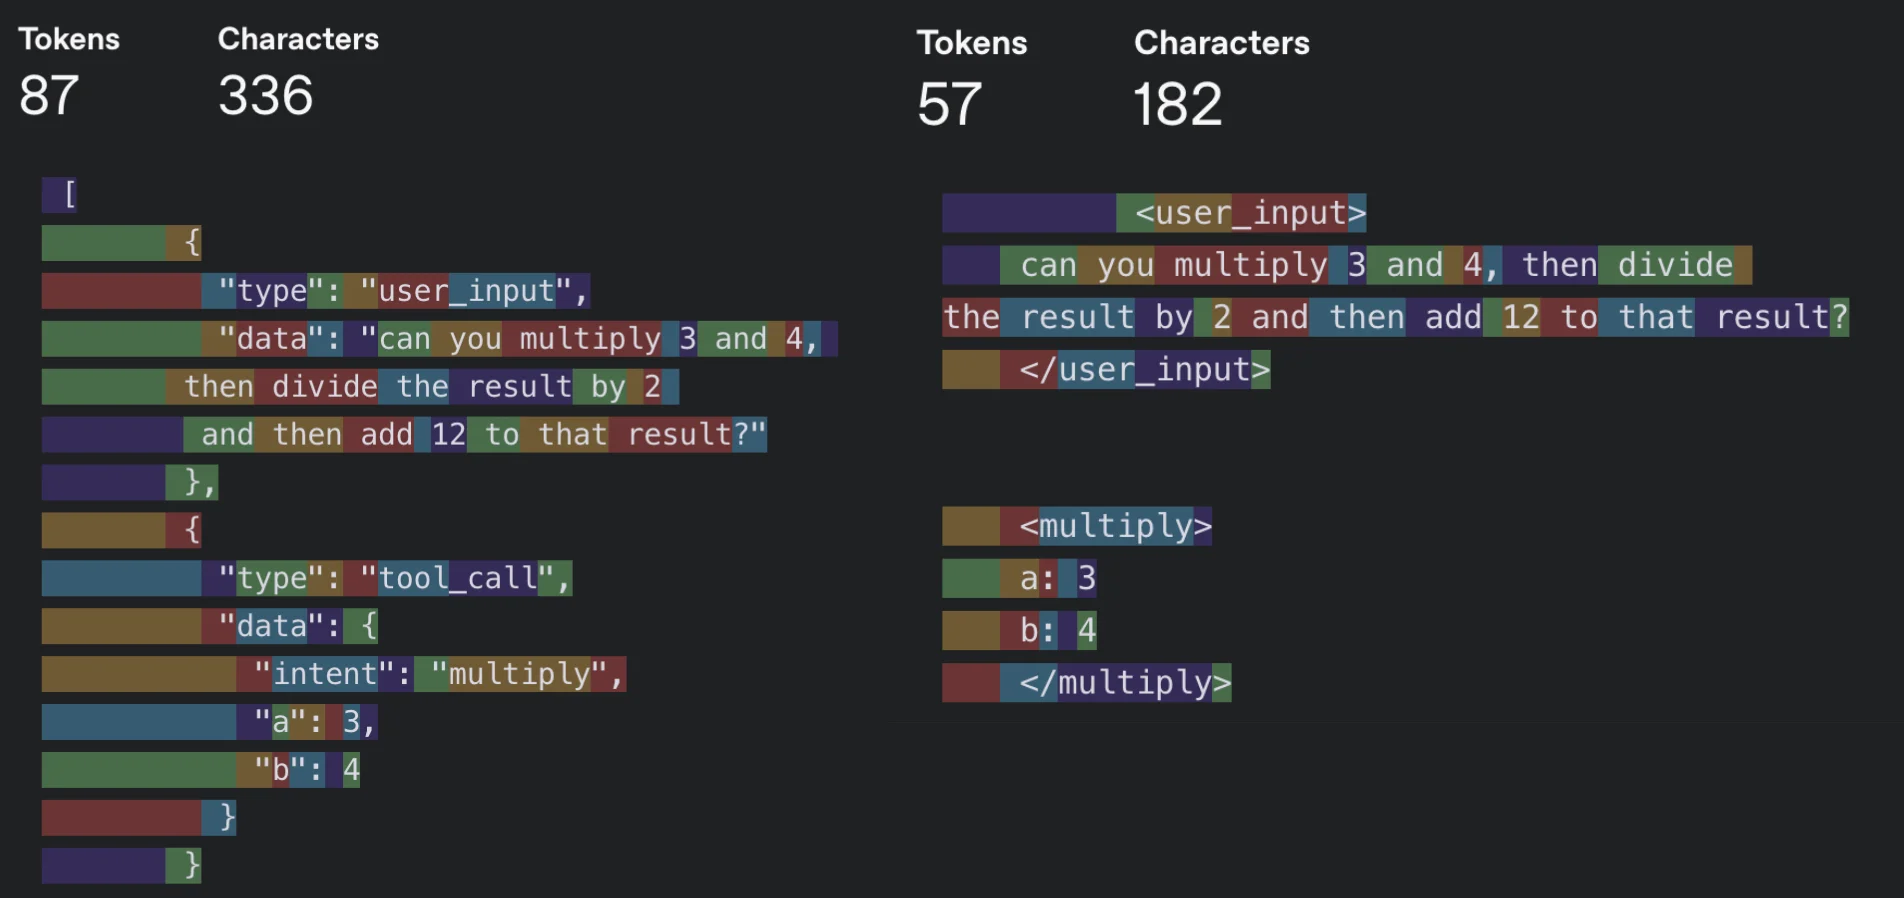
接着看 Factor 5 的执行状态,Factor 9 的错误压缩,再看 Factor 10 的小而专注的 agent。四篇连起来,刚好是一条工程线。
业务状态应该能被查询,不能只活在模型说过的话里。错误要给模型足够的恢复线索,不能把两万行日志原样塞回去。子 agent 的价值也不是会议室里多坐几个人,而是让研究、编码、审查各自拿到边界清楚的上下文,最后只把有界结果交回来。
读完就把自己的 agent 画成三个函数。先别追求能跑,伪代码够了。
context = build_context(state, task)
output = model(context)
next_state = reduce(state, output)
build_context 负责选择与格式化,model 只做一次推理,reduce 把结果落回确定性状态。模型换了,工具加了,历史变长了,这三个边界仍然看得见。
很多 agent 项目最难调的地方,就是这三件事糊在一坨。prompt 模板偷偷读数据库,tool node 顺手改内存,失败重试又把整段消息历史复制一遍。最后 token 账单涨了,效果掉了,谁也说不清哪份信息在哪一轮出现过。
HumanLayer 这一站的作业只有一个,把上下文装配从业务代码里单独拎出来。
第三站跑四个 notebook,编号顺序先别信
第三站是 langchain-ai/context_engineering。仓库很小,核心就是四个 notebook,分别讲 write、select、compress、isolate。
但我不建议按文件编号从 1 跑到 4。我更推荐 2 → 3 → 1 → 4。
先跑 2_select_context.ipynb。大多数刚做 agent 的人,最早遇到的不是「信息没地方存」,而是「手里有什么就全给模型」。十几个工具定义、整页检索结果、三十轮历史、用户资料、项目说明,一股脑塞进去,然后祈祷 attention 自己会做垃圾分类。
挺浪漫。也挺贵。
Select 这一节要盯三处,memory 怎么检索,tool 怎么按任务挑选,knowledge 怎么只取相关片段。别只看 LangGraph 的 API,要记录候选数、入选数、选择规则和被排除项。没有这些字段,线上只剩一句「RAG 好像没召回对」。
然后跑 3_compress_context.ipynb。这里看对话摘要、工具输出压缩和 state summary。仓库展示过把一段轨迹从 115k token 降到 60k token 的例子,数字很抓眼,但真正要学的是压缩的证据链。
摘要来自哪一段,压缩前后大约多少 token,原文是否从下一次调用排除,摘要能不能追到 source id。少一个都可能出问题。只有摘要没有出处,debug 时像拿着一张撕掉题目的答题卡。
第三个才跑 1_write_context.ipynb,分清 scratchpad、checkpoint 和跨会话 memory。临时计算过程、可恢复执行状态、长期用户偏好不是一回事。全写进向量库看着省事,半年后检索出来一锅隔夜粥。
最后跑 4_isolate_context.ipynb,看 supervisor、专门子 agent、sandbox 和 state schema 怎么切开上下文。这里别被多 agent 的热闹带跑。隔离是否有用,只看父任务少收了多少噪声,以及子任务回来的是不是一个可验证的有界结果。
四个 notebook 跑完,每个都用不依赖 LangGraph 的伪代码重写一次。如果你只能复述 StateGraph,却说不清哪条信息为什么在这一轮进入模型,那学到的是框架,不是上下文工程。
第四站把静态知识和动态能力接起来
第四站读 Hugging Face Context Course。它面向 Claude Code、Codex 和 OpenCode,把 skills、MCP、plugins、subagents、hooks、nano harness 放在一门课里。
这次也别从 Unit 0 一路点下一页。
先去 Unit 1,看 what-are-skills.mdx、skill-format.mdx、building-skills.mdx。Skill 可以理解成按需加载的静态知识包。它不是把所有项目规范永远粘在 system prompt 里,而是在任务匹配时,把相关指令、脚本和参考资料送进来。
再去 Unit 2 看 key-concepts.mdx 和 mcp-clients.mdx。MCP 处理的是动态能力与外部数据。数据库状态、日历、代码托管平台、内部服务,不该复制成一份过期文档塞给模型,它们应该在需要时通过工具查询。
接着跳到 Unit 4 的 patterns.mdx。这里只关心一件事,子 agent 拿走了哪些上下文,回来时交了什么。父 agent 把全部历史转发过去,子 agent 再把全部日志倒回来,这不叫隔离,这叫搬家。
Unit 5 的 hooks 用来补观察和拦截。你可以记录每轮选择了几个工具、哪次触发压缩、哪个 policy 阻止敏感信息入窗,而不是把所有原始 prompt 和用户记忆裸奔进日志。
最后看 Unit 6 的 agent-loop.mdx 与 tools-and-sandboxing.mdx。前面的零件要在这里装回一个最小循环。厉害了,绕了一大圈,终点不是更大的框架,而是一个你终于能看懂的 while loop。
这一站的作业是一张数据流图。用户请求进来后,经过哪些静态指令,调用哪些动态工具,哪部分交给独立窗口,什么被压成摘要,哪个钩子留下审计证据,最后如何拼成下一次模型输入。
画不出来,就还没学会。
第五站只当地图,别从 README 第一行顺读
前四站走完,再打开 Meirtz/Awesome-Context-Engineering。
这个仓库收了 long context、RAG、memory、agent communication、tool use、evaluation 等论文和项目,2026 版又补了 agent harness、开放协议、project memory 和 observability。
它很有用,但用法不是从 README 第一行读到最后一行。
带着问题进去搜。上下文越长效果为什么会掉,就搜 context rot。工具太多怎么选,就搜 tool retrieval。长期记忆到底怎么评,就搜 memory evaluation。长任务怎么续跑,就搜 compaction、checkpoint 和 trace。
Awesome 仓库是地图,不是徒步路线。没走过前四站时看它,每个链接都像重要,每篇论文都像应该马上读。真做过一次选择和压缩后再回来,你会自动忽略八成目录,只捞当前缺的那一块。
这才是它正确的位置。
9.2k Star 的那个,我建议先跳过
现在说浪费时间的。
jasontang-ai/Context-Engineering 的 GitHub 页面当前显示约 9.2k Star。README 自称十二周 mastery course,目录从 foundations、guides、templates、examples、reference,一路扩到 protocols、agents、field integration。它还用 atoms、molecules、cells、organs、neural fields、protocol shells、meta-recursion 搭了一套生物隐喻。
看上去非常完整。
我却不建议把学习的前五小时投进去。
第一个问题,学习依赖被隐喻盖住了。初学者真正需要的顺序,是识别失败、控制输入、记录状态、验证下一次调用。atoms 走到 meta-recursion 很有气势,但它不会替你决定一次 30KB 的工具输出该删、该存,还是该压成三行。
第二个问题,内容规模远大于反馈回路。目录很多,概念很多,模板也很多,却缺一条足够小、足够连续的主线,让你对同一个 agent 制造失败、记录 trace、改 context builder、再验证修复。
读着读着,很容易得到一种危险的满足感。我今天又懂了 context field、symbolic residue、meta-recursion,棒棒的。可下一次模型为什么拿到了旧配置,还是查不出来。
第三个问题,成熟工程模式和前沿研究想法被放在同一条坡道上。没有评测基线的初学者,很难判断哪部分今天能进生产,哪部分适合先留在待读列表。
我不是说这个仓库一无是处。它可以当灵感库,也能拿来找论文入口。但当入门课程,它的信息密度没有转化成清晰的学习回路。Star 数证明传播能力,不证明课程结构。
这个判断当然可以反驳。你如果已经做过 agent runtime,有自己的 trace、eval 和状态模型,进去按主题捞资料,可能会觉得很爽。可那已经不是入门了。
最后给一条九小时路线
如果周末只留九小时,我会这么排。
-
用四十分钟读 Microsoft 第 12 章,给自己见过的失败贴上 poisoning、distraction、confusion、clash 四个标签。
-
用九十分钟读 HumanLayer 的 Factor 3、5、9、10,写出
build_context、model、reduce三段边界。 -
用四小时跑 LangChain 的 select、compress、write、isolate,每次都保存候选、入选、压缩前后 token、排除项和 trace id。
-
用两小时读 Hugging Face 的 skills、MCP、subagents、hooks 和 nano harness,画出一次请求的上下文数据流。
-
最后半小时进 Meirtz 的 awesome 仓库,只补一个你已经知道自己缺的专题。
九小时结束时,别拿一页收藏夹当成果。做一个最小实验,让终端能打印候选上下文、最终选择、被排除的大块输出、压缩摘要的 source id、子 agent 返回的有界结果,以及下一次模型调用对应的 trace。
上下文工程学到这里,才算从「怎么跟模型说」走到了「模型每一步到底看见什么」。
两千多个仓库还在那里。你不用全看。
真正该学的,恰好就是怎么不把它们全塞进来。