posts/culture-mt-social-translation.md
翻译模型最危险的错,是把每个字都翻对了
一个英文用户刷到中文帖子,开头是「各位刘亦菲们」,结尾是「姐妹们闭眼冲」。
每个字都认识,逐词替换也不难。可真把人名译成人名,把「闭眼」译成 close your eyes,把「冲」译成 rush,海外用户大概只会怀疑手机是不是进水了。
这类句子不是语法题。它在同时做三件事,夸读者好看,拉近社交距离,再顺手完成一次带情绪的购买劝说。字面意思只占了三分之一,剩下的都藏在平台语境里。
小红书技术在官方说明里介绍了联合浙江大学、复旦大学做的 CULTURE-MT,这项工作刚被 ICML 2026 接收。团队拿 1002 条中文社媒笔记、14 个内容领域去测 15 个模型,结果挺扎眼。
表现最好的 Gemini 3,达到「完美文化有效」的比例只有 38.30%。GPT-5 是 36.73%。
好家伙,最强的一批模型面对中文互联网的梗、语气和暗号,也有接近三分之二的样本没拿到满分。
更有意思的是,BLEU、ChrF 这些传统指标看着挺平静。不同模型的真实文化表现已经拉开一截,它们的分数却像一条不太想上班的监控曲线,波澜不惊。
我觉得这篇论文最值得聊的,不是又多了一个排行榜,而是它戳中了 AI 产品里一个很常见的工程错觉。
系统把能量化的东西做得越来越好,然后悄悄把无法量化的东西当成不存在。
翻译模型最危险的错,未必是把词翻错。更麻烦的是,它把每个词都翻得像模像样,却把原文里的关系、情绪和文化位置一起抹平了。验收面板还全绿,你甚至不知道它已经错了。
CULTURE-MT 把文化传递与社媒情绪共鸣放进同一套翻译评测。
翻译对了,社交关系却没了
CULTURE-MT 的开放数据集 里有不少很有画面的样本。
「160/90 Day1」放在健身笔记里,不是两道除法题,而是在省略身高、体重和减脂打卡背景。「真香定律虽迟但到」也不是在讨论气味。「氛围感拿捏得死死的」更不是一只手真的抓住了空气。
还有《甄嬛传》这种专有名词。把它拼成 Zhen Huan Biography,字面上似乎讲得过去,读者却找不到那部已经有固定英文名的电视剧。专名、单位、平台黑话、人物称呼、表情符号,它们混在同一段里,任何一处处理失误都会让整条内容变得古怪。
这也是团队提出「文化有效性」的原因。它不只问语义有没有对上,还问两件更难的事。
一件是表达准确性。信息不能丢,情绪也不能丢。原文是在认真建议、夸张种草、自嘲,还是带点阴阳怪气,译文不能统一磨成客服话术。
另一件是文化适应性。目标语言的读者要读得自然,还得获得接近原文的语境体验。这里没有固定的逐词答案。像「各位刘亦菲们」这样的称呼,保留人名、换成功能相近的夸赞,还是加一句解释,要看平台、受众和产品目标。
你会发现,传统翻译喜欢问「这句话是什么意思」,社媒翻译还得追问「说这句话的人,正在和谁建立什么关系」。
差别就在这儿。
前一个问题主要处理文本,后一个问题开始处理社交行为。模型如果只交付一串语义正确的英文,很可能把一篇活蹦乱跳的笔记翻成使用说明书。内容没有事实错误,传播力却被清空了。
对做出海产品的人来说,这不是文艺层面的遗憾,而是很硬的业务损失。用户看不懂梗,会少停留。语气不对,会少互动。种草感被翻成广告腔,会直接伤信任。推荐系统把内容送到了人面前,翻译层再亲手把它劝退,前面的算力和流量都白花。
厉害了,漏斗最窄的地方,可能不是推荐不准,而是翻译太「正确」。
BLEU 为什么看不见这类失败
BLEU 和 ChrF 的常用实现 sacreBLEU,思路是看机器译文和参考译文有多少词组或字符片段重合。像 COMET 这样的学习型指标,会借助模型去判断语义质量,已经比纯重合聪明不少。
这些工具并不是没用。它们很适合抓漏译、错译、句法崩坏,也让大量实验有了可重复比较的基础。问题在于,它们擅长检查答案像不像参考答案,却不一定知道读者有没有接住那个梗。
一条「绝绝子,家人们谁懂啊」的译文,可以在词义层面相当接近原句,却在英语社媒里读得像一场突发语言事故。反过来,一条真正自然、能让目标读者获得相近情绪的译文,可能改掉大量表面措辞,传统重合指标反而给它低分。
这不是某个指标写坏了,而是验收目标变了。你要验收的是语义复刻,它们够用。你要验收的是跨文化传播,它们只覆盖了其中一层。
工程上最容易踩的坑,是拿一个方便算的代理指标,慢慢把它当成真实目标。
推荐系统里会发生,点击率被当成满意度。智能体里也会发生,任务结束被当成任务成功。翻译系统同样会发生,参考译文相似度被当成读者真的看懂了。
然后团队开始优化模型、清洗数据、调解码参数,一轮轮把 BLEU 往上推。季度汇报里的箭头一直向上,评论区里的海外用户还是在问「这句话到底想说什么」。
哦豁。
指标没撒谎,只是我们问错了问题。
CULTURE-MT 为了让这个新问题能规模化评测,又训练了一个自动裁判 JUDGER。它基于 Qwen3-32B,训练数据来自 3000 条专家标注和 4 万条大模型标注,再经过均衡采样得到约 3 万条数据。最终准确率是 86.03%,和人类专家判断的一致性 Cohen κ 系数达到 0.72。
这个结果有点子牛逼,因为文化判断以前很依赖昂贵的人评。现在团队至少有机会把大量候选译文先自动过一遍,快速找到最值得人工看的失败样本。
但我也想泼一小勺冷水。86.03% 不是 100%,κ 0.72 也不是裁判已经成仙。自动评估模型同样带着训练数据的偏好,它可能不懂新梗,也可能把某一种英语社媒风格当成唯一正确答案。
所以 JUDGER 更适合当分诊台,不适合当最高法院。
高置信度的明显失败可以自动拦,模型分歧大的样本交给母语审核,涉及品牌口吻、敏感语义和高曝光内容的再做专项抽检。这样才是一个能上线的评测系统。要是把旧指标换成一个新裁判,然后继续迷信单一总分,不过是给同一个坑换了张壁纸。
8B 从 4.09% 跑到 28.24%,规模不是唯一答案
论文还有一组数据,我看完觉得比闭源模型排名更实用。
在 Qwen3 的基础模型系列里,文化有效性确实和模型规模强相关。参数越大,捕捉隐含单位、平台语气和文化符号的能力整体越好。这个结果不奇怪,理解复杂语用本来就需要更丰富的知识和上下文建模。
可团队随后用「文化有效性引导的自我精修」构造了大约 5 万条训练数据,专门微调 8B 和 32B 模型。Qwen3-8B 的满分档比例,从基座的 4.09% 拉到了 28.24%。
不是小涨几点,是接近七倍。
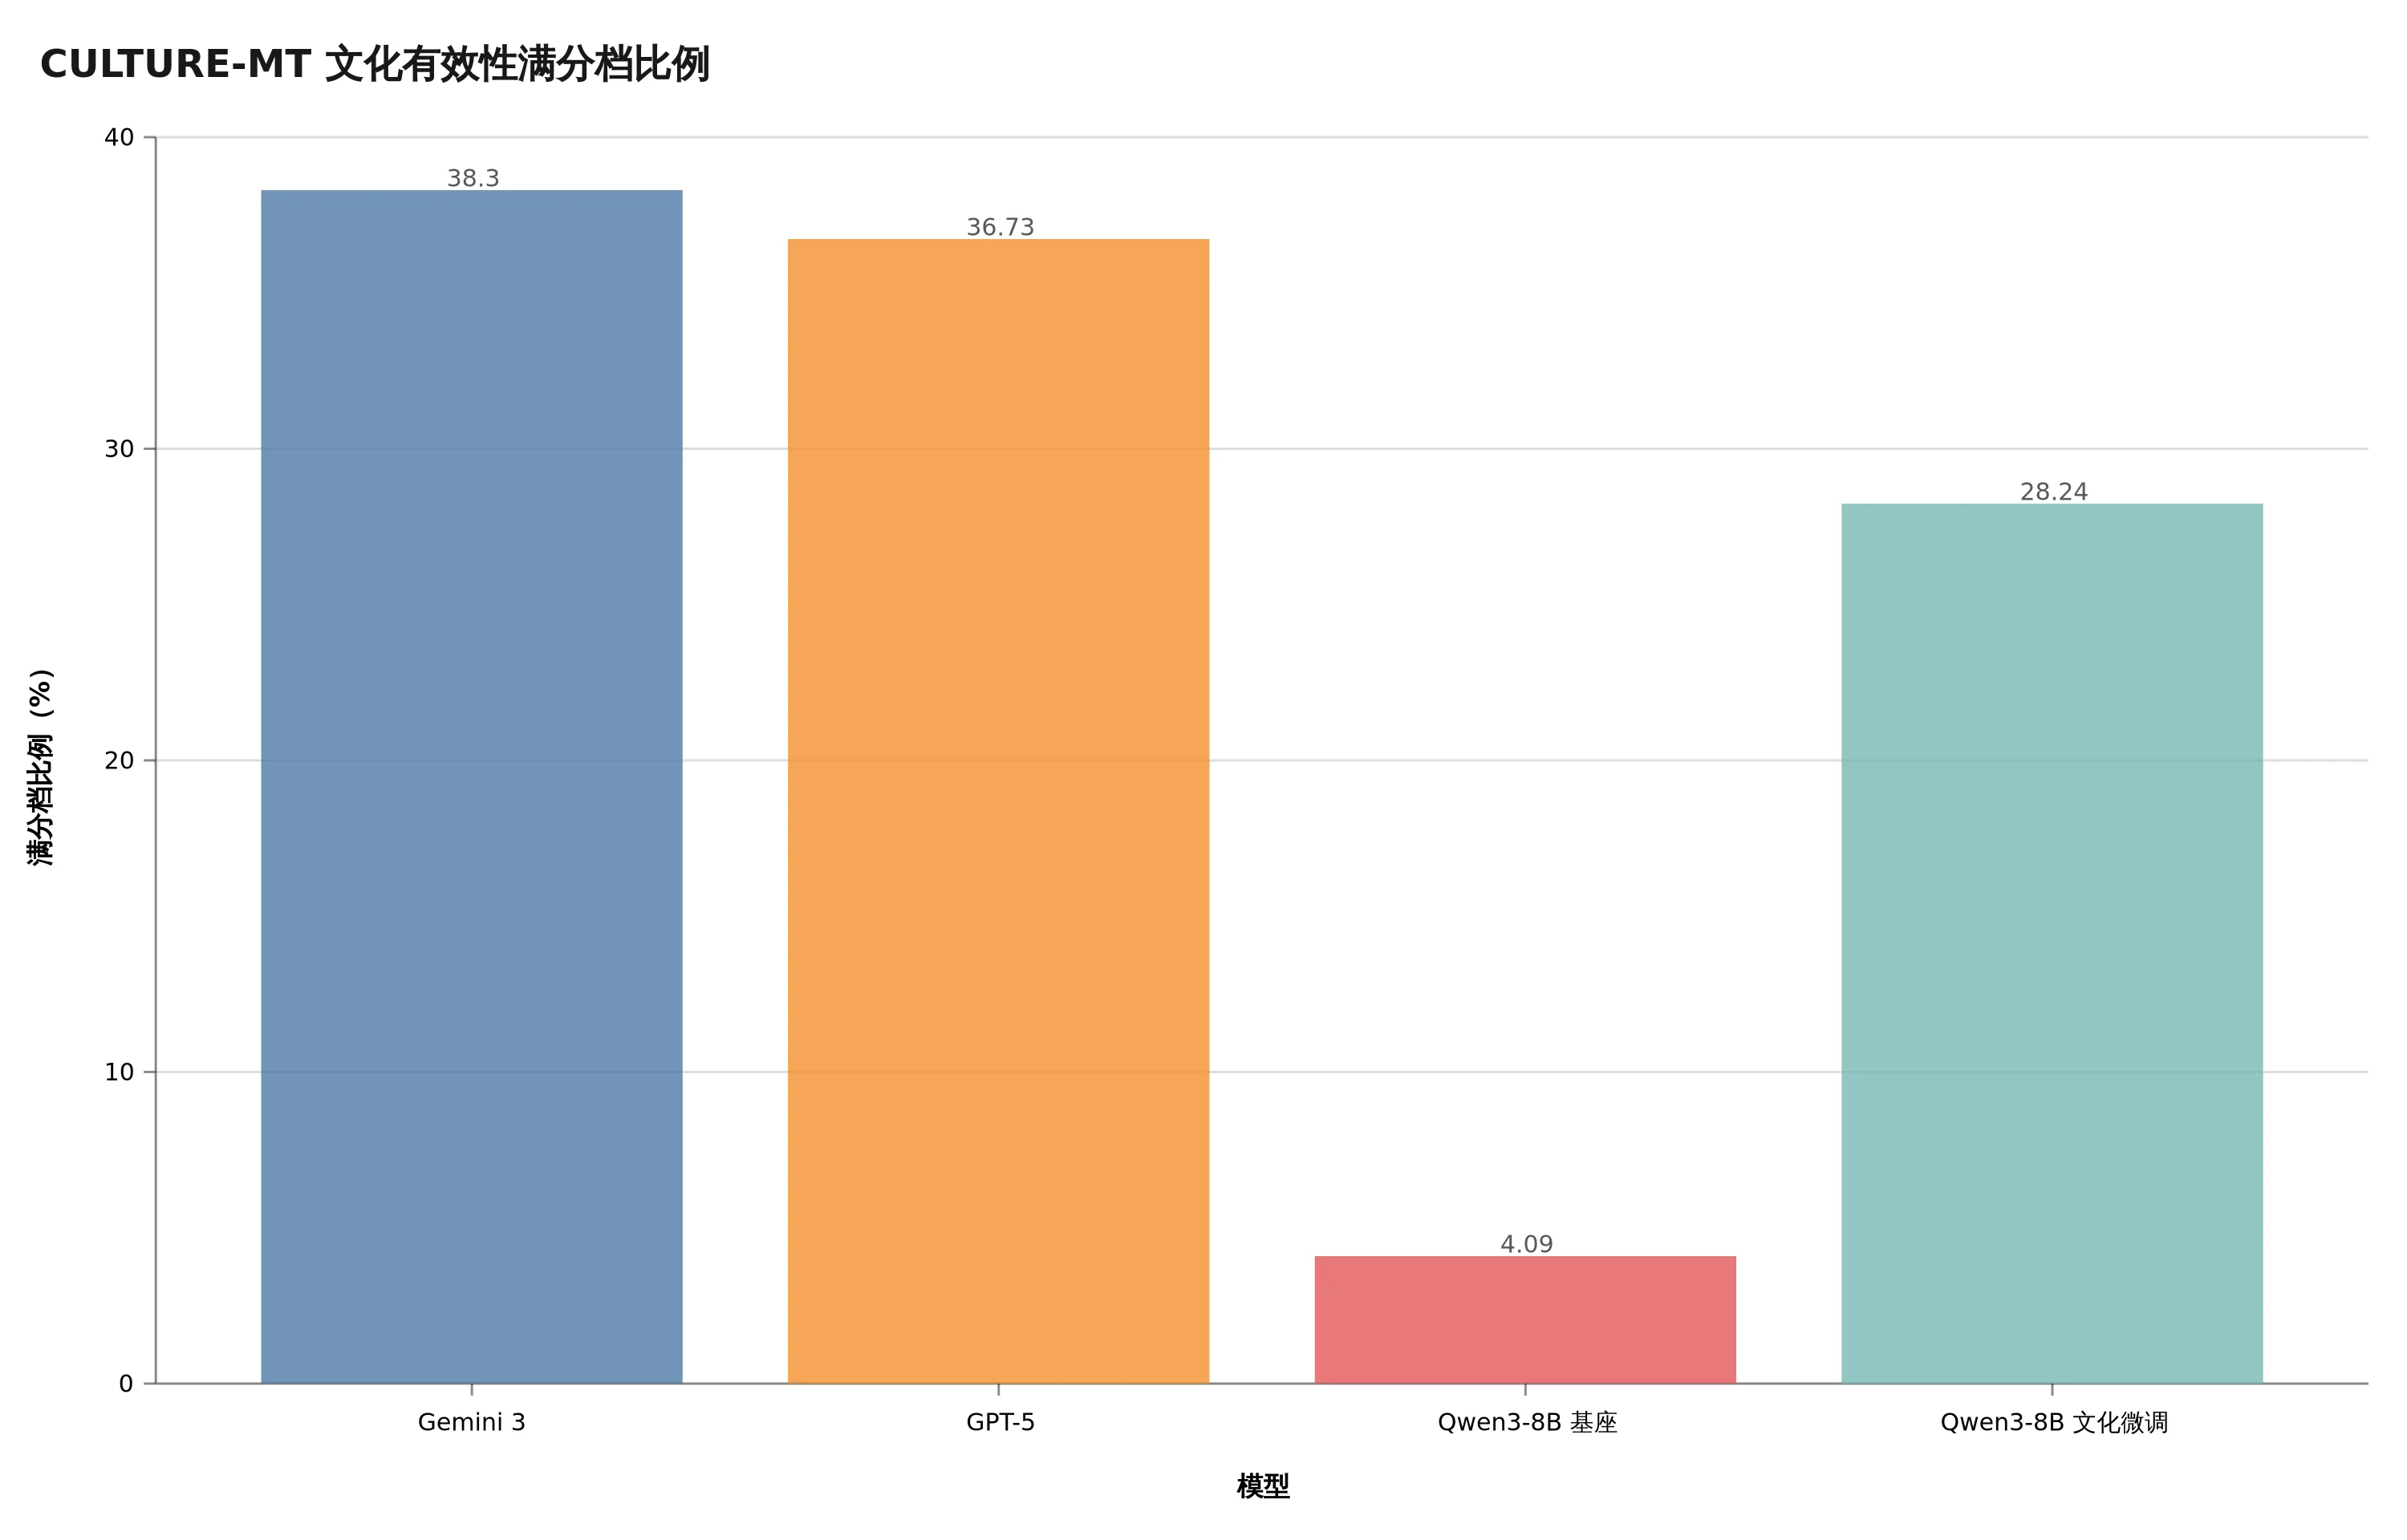
同一评测里,文化微调让 Qwen3-8B 的满分档比例从 4.09% 提升到 28.24%。
它仍然没有追平最强闭源模型,但已经逼近许多大得多的通用模型。在美食、游戏、运动、明星内容这些文化密度高的领域,提升尤其明显。
这组结果给产品团队的信号很明确。碰到文化翻译问题,别一上来就把所有请求路由到最贵的旗舰模型。模型规模能补知识,但贴场景的数据、失败样本和验收标准,可能更值钱。
坦率讲,很多团队的翻译流水线现在还是一条直线。原文进来,模型吐译文,算个通用分数,过线就上线。模型换得很勤,错误分类却几年没动。今天是 GPT,明天是 Gemini,后天换 Qwen,大家像在不停换发动机,却没人检查方向盘是不是接着轮子。
更靠谱的做法,是先把失败拆开。
专名错了,是知识与检索问题。省略单位没恢复,是上下文问题。情绪被抹平,是风格控制问题。网络梗直译,是文化适配问题。品牌口吻跑掉,是约束和样例问题。不同错误需要的修法不一样,把它们全压成一个总分,模型团队只会收到一句毫无操作性的反馈,「翻得还不够好」。
一旦失败类型稳定下来,后续数据才真能滚起来。线上投诉和低分样本进入对应切片,人工修订变成高质量对照,专项集进入回归测试,训练和提示词改动只要碰坏某个切片,CI 就直接亮红灯。
这里的 CI,就是持续集成测试。代码团队每次提交会自动跑测试,翻译模型每次换版本也该跑自己的文化回归集。不是发版前找几个人随手看十条,而是让那些曾经翻车的梗,以后每次都回来敲门。
这事儿看着不如换旗舰模型热闹,却非常值钱。棒棒的,终于从「玄学看译文」走到了能追责、能回归、能迭代的工程流程。
真要上线,别只换个指标名
如果让我把这篇论文翻成一份产品工单,我会先从样本切片下手。
不要只按美食、旅行、科技这些内容频道切。还要按失败机制切出专名、隐含单位、谐音梗、身份称呼、夸张种草、反讽、自嘲、表情符号和平台黑话。频道告诉你错误发生在哪,机制才告诉你为什么错。
接着做分层验收。
最底层用确定性规则守住不能错的东西。数字、货币、时间、链接、品牌名和固定译名,能查表就别全交给模型猜。中间层用文化评估模型抓语气和适应性。最上层保留母语人工抽检,专门看模型分歧、低置信度和高曝光内容。
三层里任何一层都不神,但叠起来会比一个万能总分稳得多。给 AI 搭能真正干活的工程时,最怕的就是把所有信任押在一个概率判断上。翻译也一样,能确定的交给规则,模糊的交给模型,高风险的留给人。
然后把平均分拆掉。
总分可以留在看板上,但它旁边必须站着每个失败切片的通过率。一个模型整体 92 分,如果在影视专名上只有 60 分,在反讽样本上只有 48 分,那它就不该被全量放进对应频道。平均值能告诉你天气不错,切片才会告诉你哪条路正在塌。
灰度上线时也别只盯离线分数。文化翻译最终服务的是人,线上要看目标语言用户的停留、互动、隐藏、举报和「看不懂」反馈。离线文化分上升,线上阅读却下降,就得回去查是不是模型过度本地化,把内容原本的中国语境也洗掉了。
这里有一道很难的边界。文化适配不是把所有内容都改写成英语互联网熟悉的样子。真正好的翻译,应该帮读者跨过理解门槛,同时保留原文从哪里来。要是「适配」到头,地方感、陌生感和独特表达全没了,那不是翻译成功,是把世界做成了同一个信息流模板。
我自己也不敢说这条边界有标准答案。不同产品、不同社区,甚至同一个词在不同月份,都可能需要不同处理。新梗冒出来的速度,肯定比任何评测集更新得快。
可这不等于我们只能靠感觉。
把不确定性标出来,把分歧样本留下来,让母语用户的反馈能回到评测集里,再定期淘汰已经过时的参考答案。评测不是一张考卷,而是一套持续更新的航海图。潮水变了,图也得跟着改。
回到开头那句「各位刘亦菲们」。
真正负责的翻译系统,不会满足于把刘亦菲的拼音写对。它得知道这里的人名正在完成一次夸赞、一次拉近关系,也得知道目标读者可能从没看过她的电影。
字翻完了,理解才刚开始。