posts/cursor-origin-agent-code-hosting.md
Cursor Origin 在抢的不是仓库,是 agent 运行时
Cursor 刚把代码托管塞进了自己的产品里。
不是再接一个 GitHub 插件,也不是把仓库列表做得更顺眼。Origin 的官方更新写得很直接,Cursor 现在可以托管你的代码。早期 Beta 从今天起向所有付费方案逐步开放,先上的能力包括代码仓库、PR、代码浏览、GitHub 同步,后面还会继续补智能体原生能力。
好家伙。
一个 AI 编辑器,开始自己管 Git 仓库了。
很多人第一反应大概是,Cursor 要做一个 GitHub 替代品。这个判断不算错,但只看到了最外面那层。仓库当然重要,真正值钱的是仓库旁边那一圈状态,谁开了 PR,检查跑到哪一步,评论有没有解决,哪条分支能合并,预览环境是否可用,部署失败卡在哪个 job。
代码 agent 想真正把活干完,缺的往往不是再聪明一点,而是能不能连续拿到这些状态,并在正确的时机做正确的动作。
我自己的判断是,Cursor Origin 在抢的不是一块硬盘,也不只是 GitHub 的页面流量。它在把代码仓库变成 agent 的运行时。
这话听着有点大,先看它到底做了什么。
Origin 原生仓库会使用 cursor.com/codebase/组织名/仓库名 这一套地址。开发者在新的代码库页创建仓库,用 CLI 克隆或推送,本地代码随后直接托管在 Cursor。每个仓库自带 PR 页面,可以看时间线、提交、检查项和变更文件,也能审查 diff、评论、合并。
如果团队暂时不想搬,Cursor 留了一座桥。
把 GitHub 组织连进来以后,可以选择同步哪些仓库。同步副本能在 Origin 里浏览、搜索和拉取,但 push 仍然发往 GitHub,GitHub 继续是权威来源。PR 评论双向同步,在 Cursor 里发评论会出现在 GitHub,GitHub 的回复和表情也会在几秒内回到 Cursor。
这块设计挺聪明。
它没有逼团队第一天就迁库,而是先把 GitHub 变成后端,把 Cursor 变成开发者和 agent 看到的前台。等大家习惯在 Cursor 里看仓库、审 PR、跑 agent,再讨论代码到底存在哪儿,阻力会小很多。
厉害了,迁移最难的那一步,被改成了一个同步开关。
但真正让我在意的,是官方文档里的另一句,每个代码仓库都有智能体。你可以让 Cursor 回答当前代码的问题、修改代码、更新 PR,或者推送分支。仓库、PR 和 agent 被放进了同一个控制面。
这和今天常见的代码 agent 流程差别很大。
假设一个常见场景,你让 agent 修一个线上 bug。它先要从 GitHub 拉仓库,找到正确分支,读取 issue 或聊天记录里的上下文,再拿一个有权限的 token 去推分支。接着创建 PR,等 CI 回调,解析失败日志,补一轮修复,再等审查意见。审查通过以后,可能还要去 Vercel 找预览链接,或者去 Buildkite 看流水线。
模型写代码,只占这条链路里最显眼的一段。
剩下全是胶水。
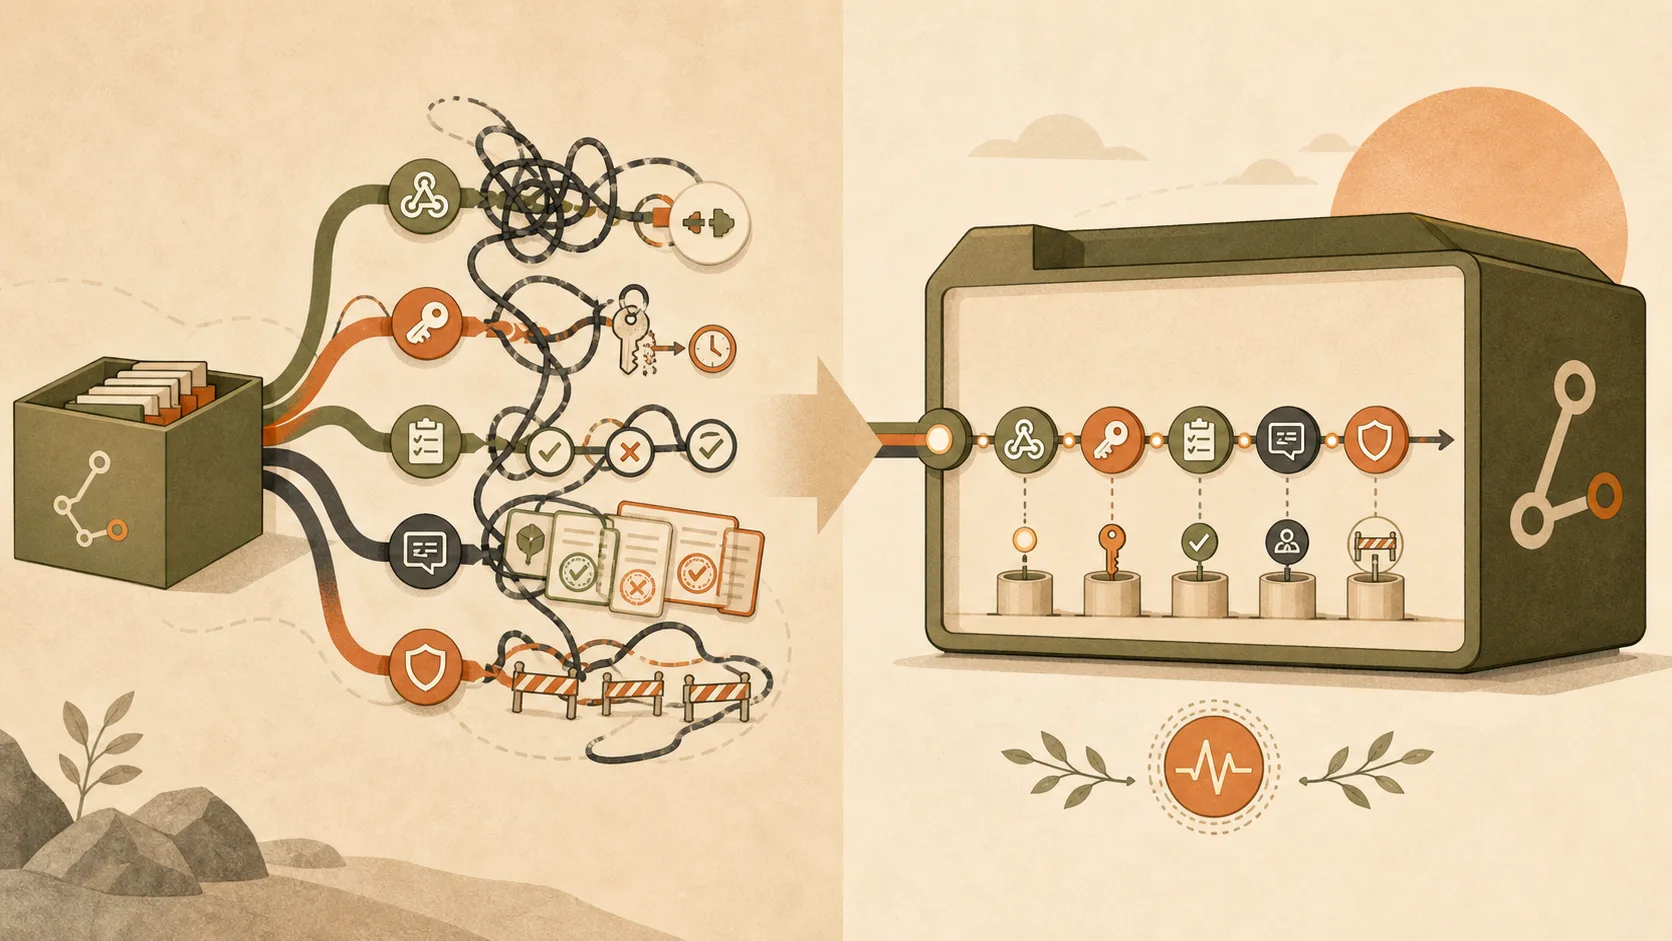
GitHub Webhooks负责把事件推出去,GitHub Actions负责跑工作流,agent 平台自己维护任务状态、权限和重试,部署平台再维护另一份构建状态。任何一个 webhook 丢了,任何一个 token 过期了,任何一轮任务恢复时没把旧状态接回来,agent 都可能从一个能改代码的同事,退化成一个在群里追问「现在到哪了」的实习生。
Origin 想砍掉的,正是这些缝。
Cursor 同时知道当前用户是谁、正在看的仓库是什么、PR 里哪些检查失败、agent 刚改了哪几个文件。对于 Cursor 自己的 agent 来说,它不必再通过五个外部 API 猜工作流发生了什么。一次 PR 评论可以直接变成下一轮任务输入,一次 CI 失败可以直接唤醒修复,一次权限变化也能在同一个系统里生效。
从工程角度看,这有点子牛逼。
上下文更短了,状态跳转更少了,失败恢复也更容易。过去要靠队列、数据库和一堆 webhook 拼起来的事件链,现在有机会缩成一个平台内部的事务。这里的事务不是数据库术语,而是让一组动作要么一起成功,要么能明确知道断在了哪儿。
代码 agent 最怕的就是半成功。
分支推了,PR 没开。评论读了,修复没进正确的 commit。CI 绿了,agent 却还拿着十分钟前的失败日志继续改。模型偶尔犯蠢还能靠测试拦住,状态错位会让一个完全正确的模型在错误世界里持续努力。
那才是真麻烦。
Origin 还接了 Vercel、Depot 和 Buildkite。连接 Vercel 后,每个 PR 能生成预览部署,合并后再进生产。需要 CI 的团队可以接 Depot 或 Buildkite,两边都能继续运行现有的 GitHub Actions 工作流,Buildkite 也支持自己的原生流水线。
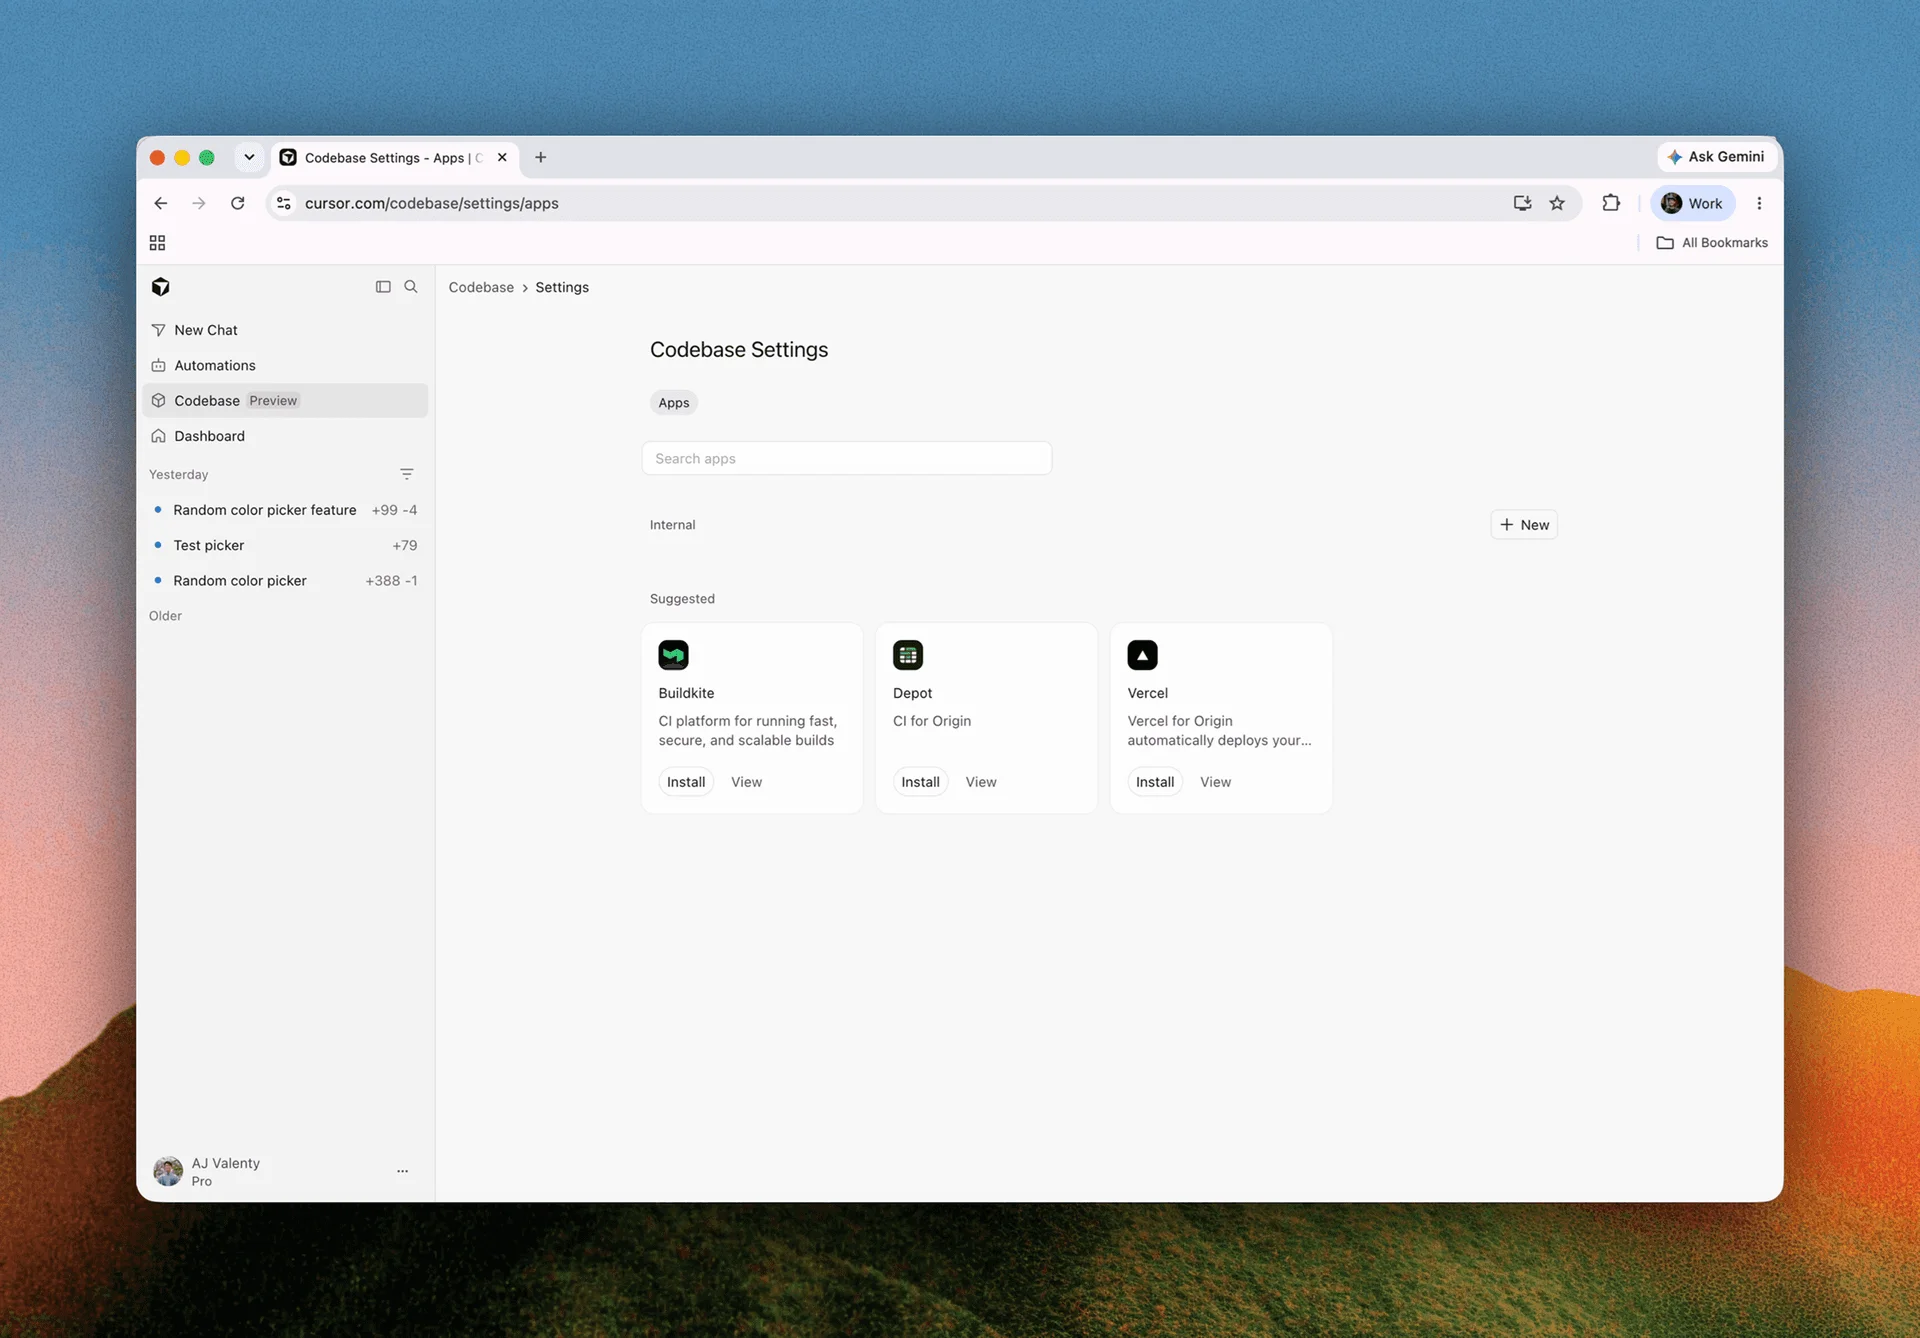
这几项集成看着像功能列表,其实在补运行时最关键的反馈回路。
agent 改完代码,不该只说一句「完成」。它得看到构建有没有过,预览页面能不能打开,测试是不是因为环境问题而失败。反馈越靠近代码修改发生的地方,agent 越少需要把一大坨日志从一个系统搬到另一个系统,判断也会更稳。
不过,胶水少了,不等于代价没了。
恰恰相反,代价从「我得维护很多集成」变成了「我把多少关键状态交给同一个平台」。
这块需要认真算账。
第一笔账是权威来源。
Cursor 对 GitHub 同步仓库给了很清楚的边界,GitHub 仍是权威来源,push 仍回到 GitHub。这是早期采用最舒服的姿势,因为随时能断开同步,现有权限、审计和备份策略也不用立刻推倒重来。
可一旦用上 Origin 原生托管,团队就该问几个不那么性感的问题。仓库怎么导出,PR 评论和审查记录能不能完整迁走,分支保护规则是否兼容,审计日志保留多久,服务不可用时本地镜像能不能承担恢复入口。
这些问题不会出现在产品发布图里,却决定了平台锁定到底是一根细线,还是一扇焊死的门。
第二笔账是权限半径。
当 agent、仓库、PR 和部署入口在同一处,授权会顺滑很多,也会更危险。一个只该读代码的 agent,能不能评论 PR。一个能改分支的 agent,能不能碰保护分支。一个能看到预览部署的 agent,是否也拿得到生产环境信息。
以前权限散在多个系统里,麻烦归麻烦,天然多了几道断点。现在路径变短,团队反而更需要把最小权限做细。别给一个「能修 bug」的宽泛角色,然后默认它需要仓库写权限、CI 重跑权限和部署权限。把读取、开分支、开 PR、合并、部署拆开,每一步都留下清楚的主体和证据。
不然 agent 的效率是上去了,事故半径也一起上去了。
第三笔账是平台是否真的理解你的工作流。
Origin 目前强调的是仓库、PR、代码浏览、同步和几项构建部署集成。对于走标准 GitHub Flow 的团队,这套路径很顺。可很多公司还有单体仓库里的自定义检查、内部制品库、灰度发布、人工审批、合规扫描,甚至一条祖传 shell 脚本决定今晚能不能下班。
平台把标准路径做得越丝滑,非标准路径就越容易显得像杂质。
我并不觉得所有团队都该马上迁到 Origin。说真的,早期 Beta 最适合拿来验证控制面,而不是拿核心仓库练胆量。
比较稳的试法,是先连一个非关键 GitHub 仓库,只开同步,不搬权威来源。让 agent 做三类低风险任务,解释代码、根据明确 issue 开分支、在 PR 里回应审查意见。部署只接预览环境,不给生产权限。然后故意制造几次失败,CI 超时、评论冲突、同步延迟、权限被撤回,看看任务能不能恢复,审计能不能把动作串起来。
别只测 happy path。
真正要看的不是 agent 成功写了多少行代码,而是它失败以后有没有留下一个人类能接手的现场。分支在哪儿,最后一次有效检查是什么,哪条评论触发了修改,谁批准了合并。信息都在,换个人或换个平台还能继续,这套运行时才算靠谱。
还有一个细节值得盯着。
Cursor 的 Origin 文档把 GitHub 共存放在很显眼的位置,官方更新也反复强调同步和断开连接。这说明 Cursor 很清楚,今天没人愿意为了一个 Beta 把代码资产整箱搬走。它先卖的不是替代,而是更近的控制面。
把它放在 Cursor 加入 SpaceX之后看,会更有意思。模型、算力、编辑器、仓库、PR、构建和部署正在被串成一条更长的链。单看任何一块都像已有功能,连起来以后,竞争对象就不只是另一个编辑器了。
它在争夺一件更底层的东西,谁来保存软件开发的真实状态,谁来决定下一个动作该由人还是 agent 执行。
GitHub 当然不会因为一个 Beta 就被替代。它的生态、权限体系、企业采购、开源网络和历史数据,不是一页漂亮的仓库界面能搬走的。可 GitHub 有可能先被绕过去。
代码还在 GitHub,开发者每天停留的地方却变成 Cursor。评论仍同步回 GitHub,判断和动作却先在 Cursor 发生。等到团队发现自己已经很久没直接打开 GitHub,平台迁移在心理上其实完成了一半。
坦率讲,我觉得这才是 Origin 最狠的地方。
它没有喊着掀桌子,而是把桌上的工作一件件搬进自己屋里。
仓库只是第一件。