posts/deepseek-cache-price-agent-bill.md
DeepSeek 缓存最高涨 1114%,Agent 成本该重算了
三个问题,4.30 美元。
不是买了三份研报,也不是让模型吐了三本小说。DeepSeek 新价格生效后,一名用户在 Reddit 公开了自己的账单体感,他说,类似用法以前大约花 0.20 美元,这次早上问了三个问题,余额少了约 4.30 美元。
这个帖子很容易把人带向一个粗暴结论,DeepSeek 不便宜了,换模型。
先别急。
帖子没有给出完整的 token 构成,三个问题也可能带着很长的上下文、很多轮工具调用和大量输出。它是一个真实公开的个案,不是平均账单。拿它证明所有用户都会贵二十倍,不靠谱。
但它把一件更值得工程师警惕的事掀开了。
这次最狠的一刀,不在大家最容易盯住的输出 token,而在原本负责省钱的缓存。
好家伙,省钱项开始放大账单了。
1114% 到底涨在了哪里
先把数字摊开,不然讨论很容易变成情绪接龙。
在 DeepSeek 当前官方价格页 里,V4 Pro 每百万缓存命中输入 token,非高峰时段是 0.022 美元,高峰时段是 0.044 美元。缓存未命中输入分别是 0.66 美元和 1.32 美元,输出分别是 1.98 美元和 3.96 美元。
旧价还能在 此前的官方价格页面缓存 里看到。V4 Pro 每百万缓存命中输入是 0.003625 美元,缓存未命中输入是 0.435 美元,输出是 0.87 美元。
把两张表放在一起,缓存命中输入的非高峰价涨了约 506.9%,高峰价涨了约 1113.8%。缓存未命中输入的涨幅温和得多,非高峰约 51.7%,高峰约 203.4%。输出则是非高峰约 127.6%,高峰约 355.2%。
所以标题里的 1114% 有严格边界。
它只指 V4 Pro 的缓存命中输入在高峰时段相对旧价的涨幅。不是每一类 token 都涨 1114%,更不是你的总账单固定翻十二倍。这个限定必须说清楚,不然数字很炸,判断却是空的。
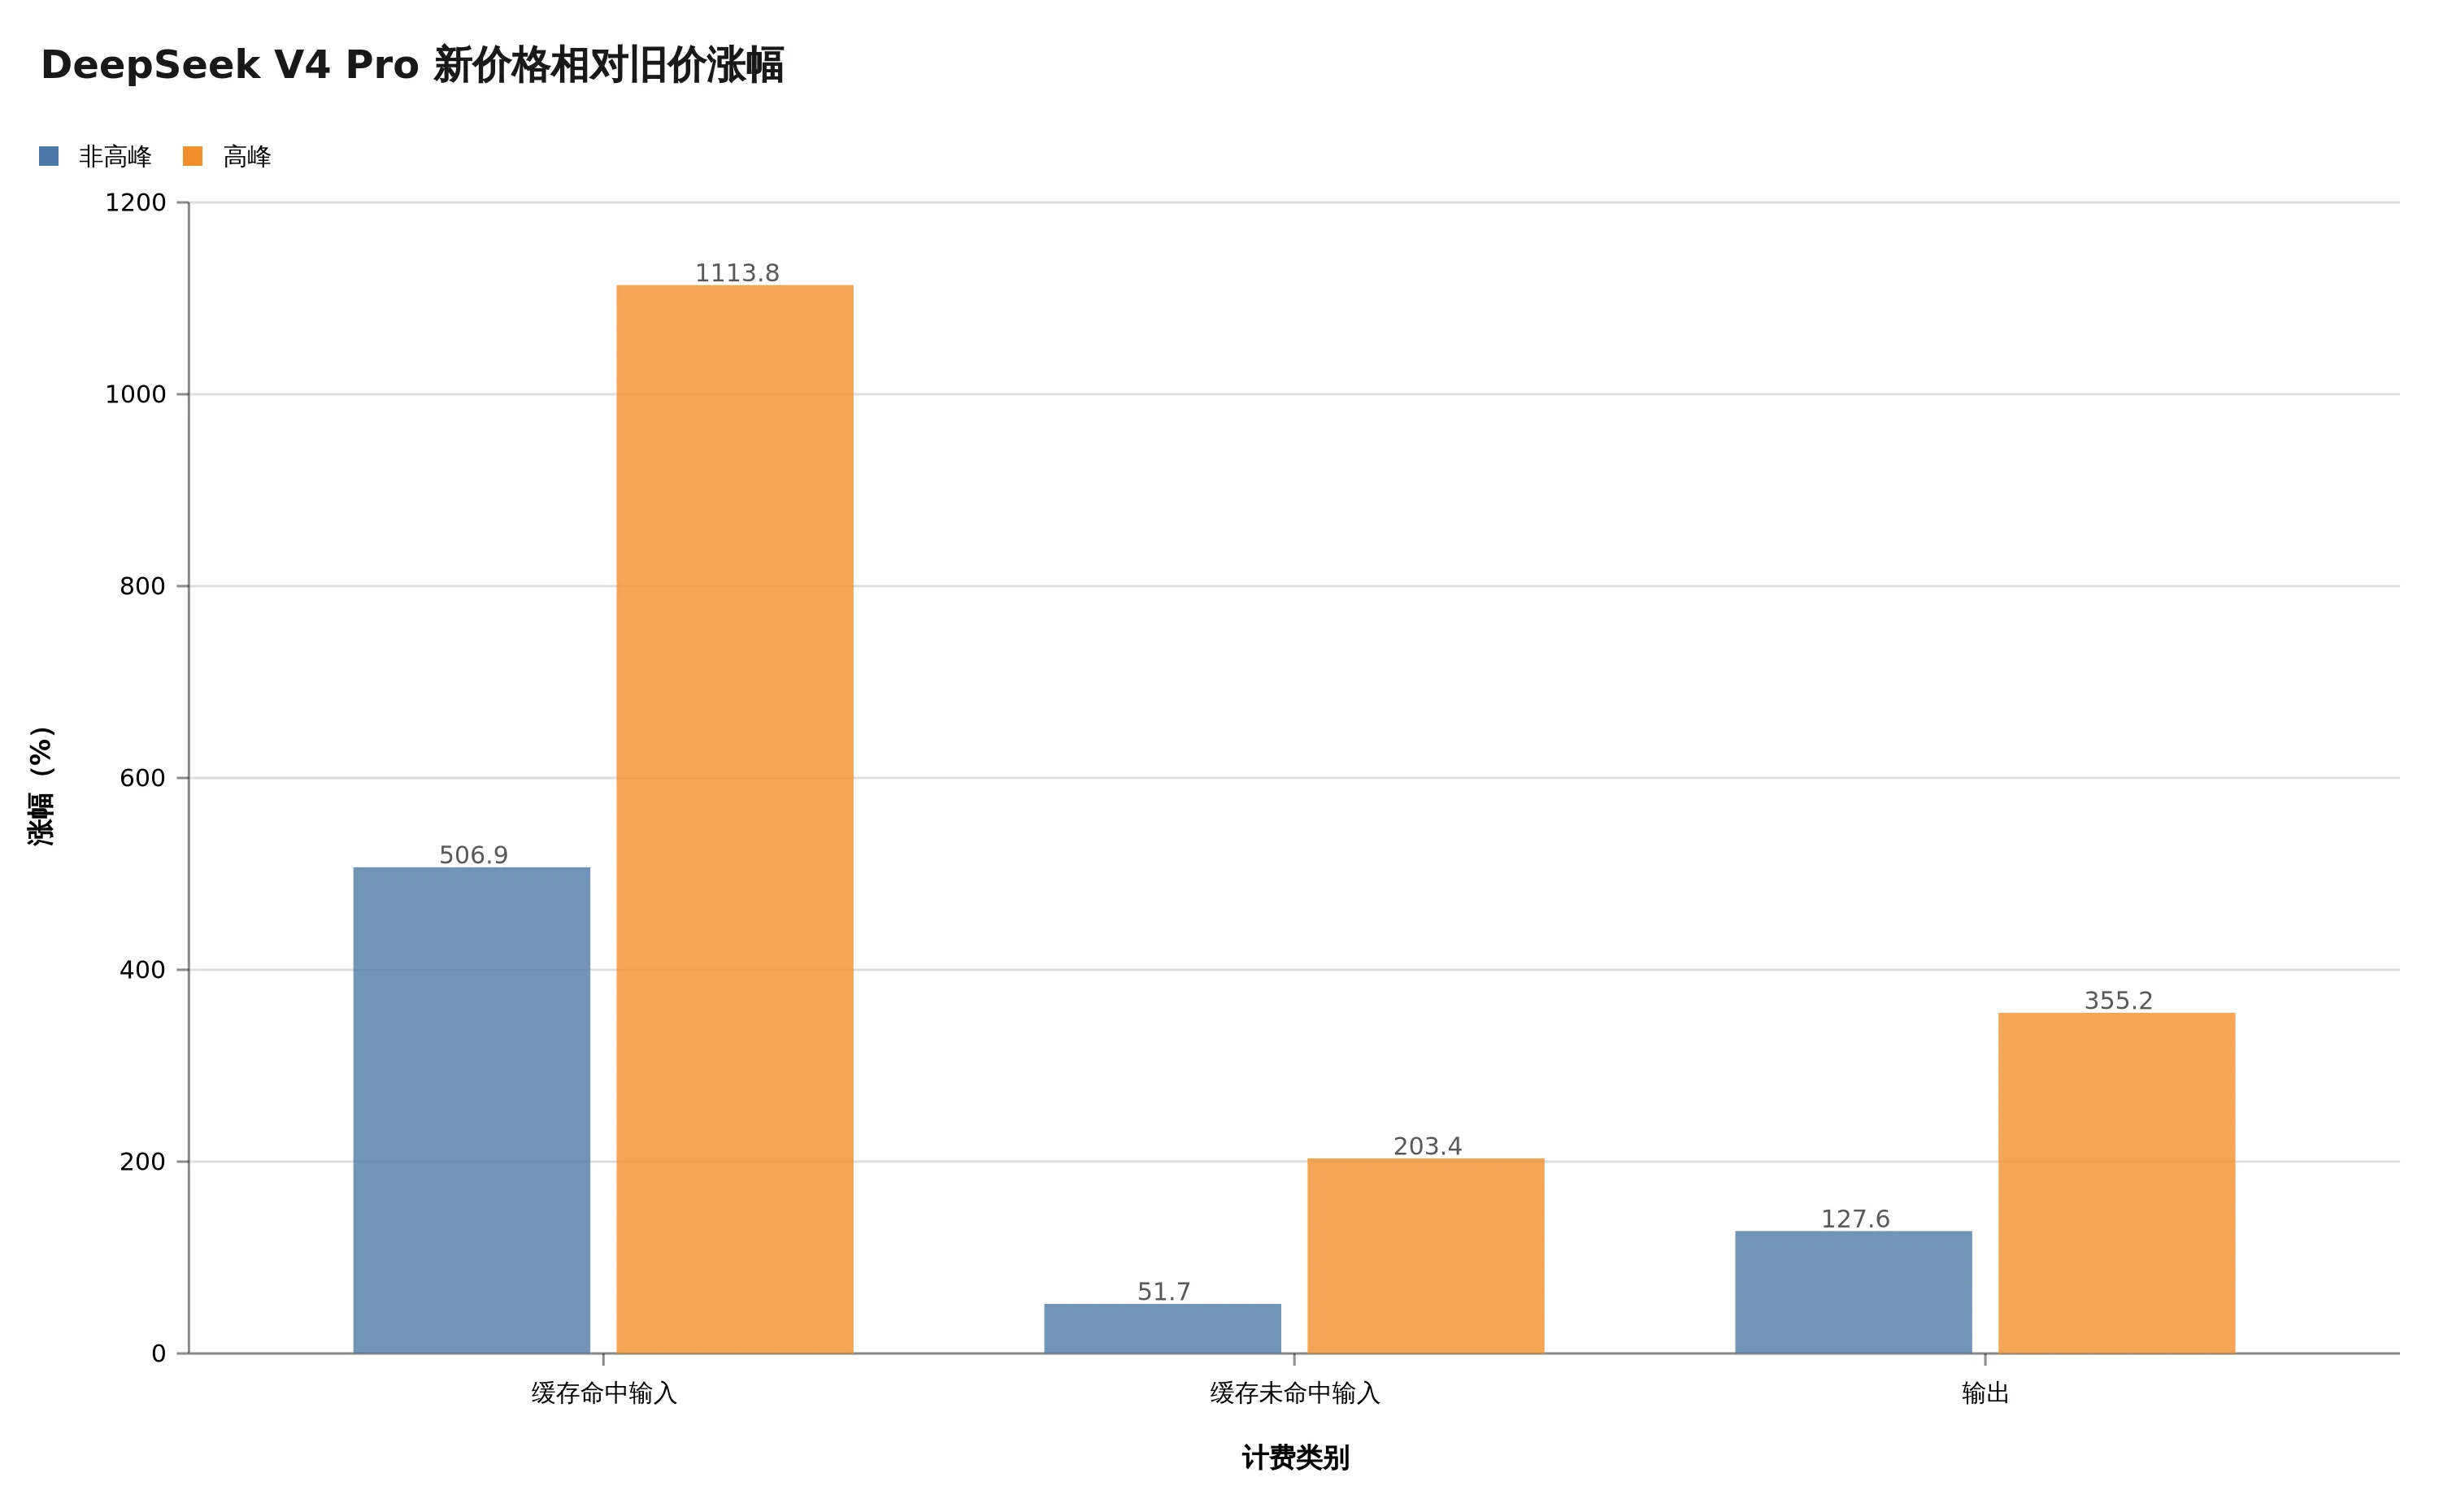
缓存命中输入的涨幅最高,1113.8% 只对应高峰时段这一项
DeepSeek 规定的高峰时段是 UTC 01:00 到 04:00、06:00 到 10:00。换成新加坡和北京时间,正好是上午 9 点到中午 12 点、下午 2 点到 6 点。
厉害了,亚洲团队最正常的工作时间,正好覆盖了全部高峰窗口。
如果你跑的是夜间批处理,这个峰谷价还能调度。如果你做的是白天在线的编码 Agent、客服 Agent 或文档分析,用户不会因为模型便宜一点,等到晚上再点提交。峰谷差不是一张运营海报,而是系统约束。
Agent 为什么比普通聊天更疼
缓存命中为什么值得单独讲?因为 Agent 的输入形态跟普通问答很不一样。
一次普通聊天,可能就是两三轮短对话。一个生产 Agent 往往会反复携带系统规则、工具说明、仓库摘要、任务历史、上一次执行结果和失败日志。每调用一次工具,模型再回来继续推理,这些前缀又要送一遍。
在 DeepSeek 的缓存指南 里,相同前缀可以被磁盘上下文缓存复用。API 也会在 usage 中分别返回 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens。缓存不是玄学,它是账单里能直接读到的两个计数器。
过去那套省钱逻辑很顺。
把稳定规则放前面,尽量保持前缀不变,提高缓存命中率。长仓库、长文档、多轮会话虽然输入巨大,只要大量命中缓存,成本依旧能压得很低。
现在这个方法没有失效。0.022 美元依然远低于 0.66 美元,命中缓存还是比不命中便宜三十倍。别因为涨价就故意破坏前缀稳定,那相当于车票涨了以后决定改坐出租车,多少有点赌气。
真正改变的是,旧价下可以忽略的计费桶,如今不能再当成零。
一个长程编码 Agent 每轮带着几十万 token 的相同仓库上下文,连续跑几十轮,缓存命中输入会积出十亿级 token。以前它便宜到财务表里只占一个小数点后的尾巴,现在尾巴长出了牙。
怎么说呢,缓存仍然负责省钱,只是不再负责让你忘记钱的存在。
一份 40 亿 token 的账单给了答案
社区里有一份更完整的材料。一名用户导出了 7 月 19 日到 8 月 16 日的 28 天 API 用量,并做了 同一批 token 的新旧价格复算 。
这份记录包含约 40.22 亿 token、18445 次请求。所有输入 token 里,97.74% 命中了缓存。历史实际花费是 53.38 美元。
保持 token 数量和构成完全不变,全部放在非高峰时段,新价约 130.48 美元。如果流量均匀分布在一天 24 小时,估算约 168.53 美元。全部落在高峰时段,则约 260.95 美元。
对应旧账单的 2.44 倍、3.16 倍和 4.89 倍。
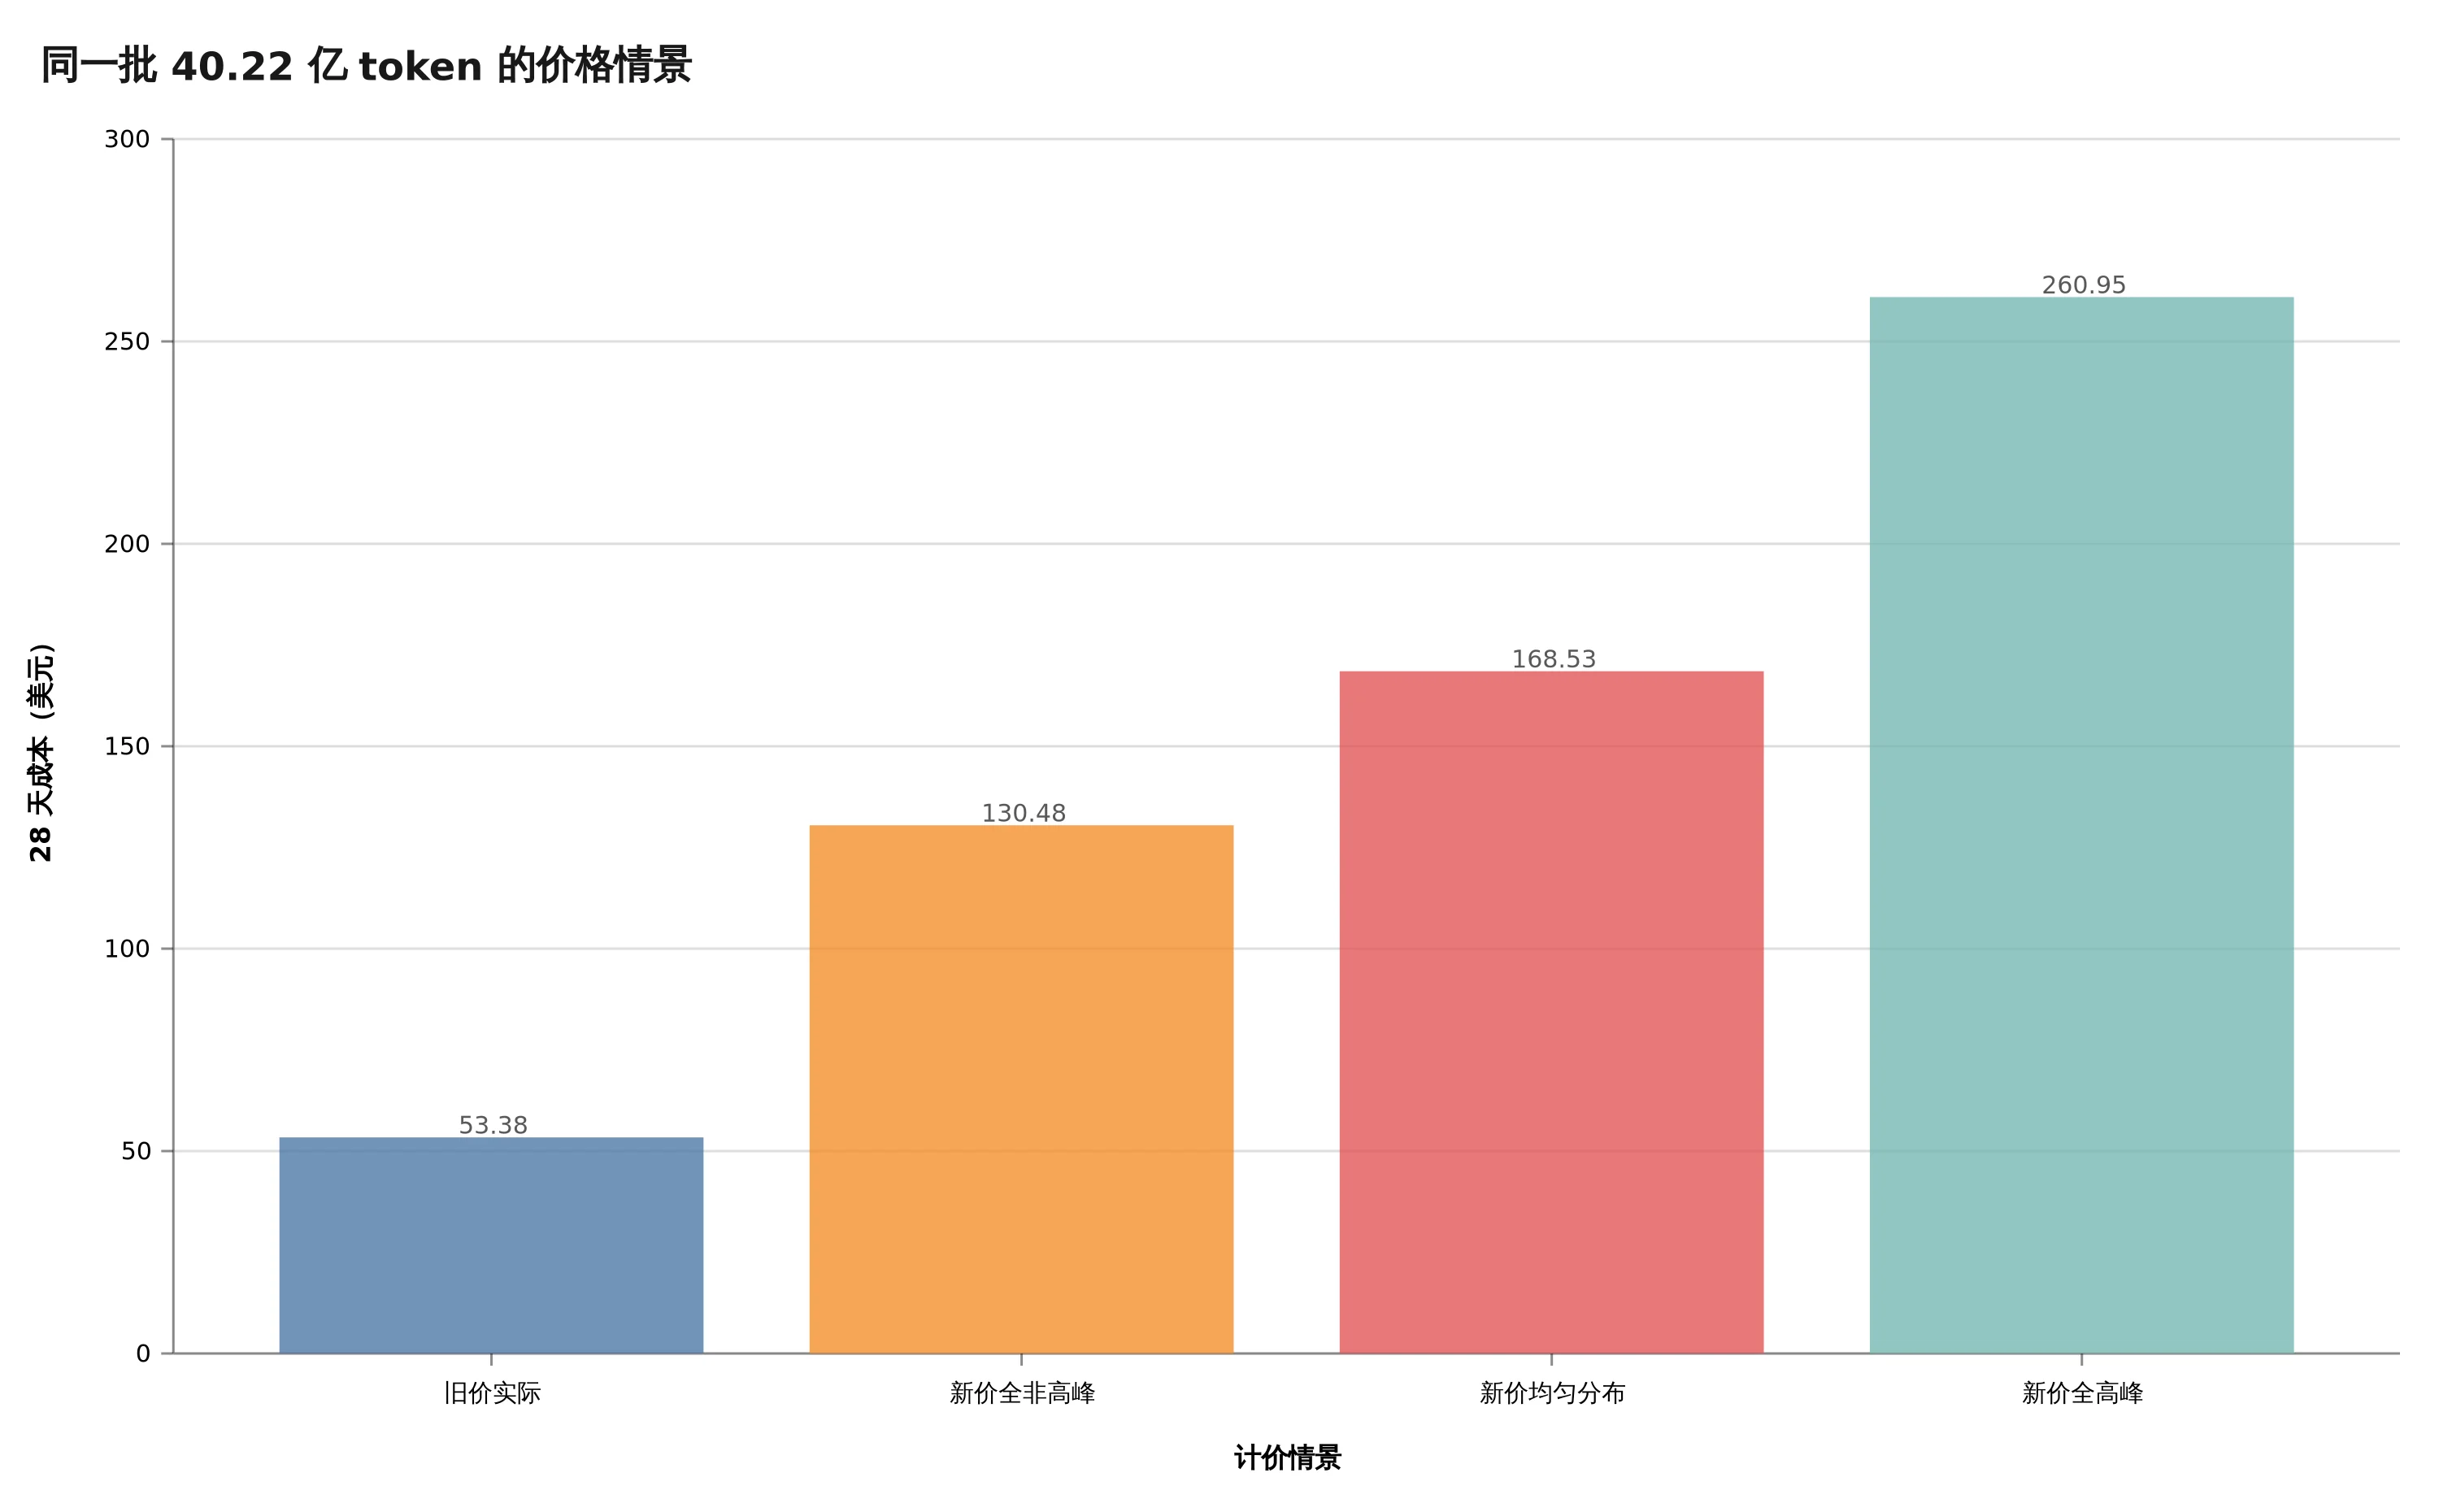
后三根柱是情景复算,不是已经发生的实际账单
这里同样要踩一下刹车。均匀分布和全部高峰是情景计算,不是已经扣掉的钱。那份导出只有每天的聚合数据,没有逐小时分布,谁也不该把 168.53 美元伪装成精确预测。
可它把成本结构照得很清楚。
单看 V4 Pro 的缓存命中输入,旧价约 7.02 美元。相同的 19.38 亿缓存 token,按新价计算,非高峰约 42.63 美元,高峰约 85.25 美元。
同样的调用量,同样的命中率,同样的模型,只改价格和时段,这一项就能多出几十美元。
很多朋友可能会说,几十美元也没多大。
对个人项目,可能确实没多大。对每天跑几百个任务、每个任务多轮重试、上下文动辄几十万 token 的团队,这个倍率会直接改写模型路由、任务排队和月度预算。更麻烦的是,它不是一次请求贵多少,而是你原先以为几乎免费的那部分,在规模上来以后突然开始收费。
有点子牛逼的地方也在这里。DeepSeek 当初用磁盘缓存把重复输入的成本压下来,长上下文 Agent 才能大胆把历史塞回去。如今缓存价大涨,团队必须重新回答一个老问题,哪些历史真的值得每一轮都带着?
模型价格表,反过来开始影响 Agent 的记忆设计。
别再只看每百万 token 单价
我一直觉得,Agent 团队拿模型报价做选型时,最容易犯的错就是把三个单价抄进 Excel,然后选最小的那一列。
普通补全还能勉强这么比。Agent 不行。
一个便宜模型如果经常工具选错、格式校验失败、跑到第三轮才把任务做完,它消耗的不是一次输出价,而是一串输入、输出、缓存、工具调用和重试。一个单价更高但首轮成功率更好的模型,总任务成本反而可能更低。
我会把成本记成下面这组东西。
task_cost
= cache_hit_tokens × cache_hit_rate
+ cache_miss_tokens × cache_miss_rate
+ output_tokens × output_rate
+ tool_cost
+ retry_cost

cost_per_success
= all_task_cost / successful_tasks
别被变量名吓到,真正需要采的就是六类数据。
第一类是模型版本。deepseek-v4-pro 这种别名背后可能更新,版本变化会影响 token 用量、任务成功率和输出长度。
第二类是缓存命中与未命中 token。DeepSeek 已经把两个字段放进 API 返回,不记白不记。
第三类是输出 token。推理模式、思考强度和任务难度都会把它拉长。
第四类是请求发生的峰谷时段。对 DeepSeek 来说,同一种 token 的高峰价正好是非高峰两倍。
第五类是失败重试。超时重发、JSON 不合法后的修复轮、工具报错后的再次推理,全都是真钱。
第六类是最终成功率。只有任务真的完成,前面的成本才有业务价值。
坦率讲,这张表不酷。没有新框架,没有漂亮的多 Agent 拓扑图,也没有模型大战的热闹。
但它能救预算。
现在能做的四个动作
先把 usage 原样落日志,不要只记 total_tokens。至少保留 prompt_cache_hit_tokens、prompt_cache_miss_tokens、completion_tokens、模型名、请求时间和任务 ID。总 token 会把价格差异揉成一团,复盘时什么都看不出来。
再把每个任务的所有请求串起来。一个任务调用模型八次,就按八次算总账,别在控制台里盯一条请求自我安慰。超时与重试也要归到同一个任务 ID 下。
对允许延迟的工作,把高 token 批处理挪到非高峰时段。新加坡和北京时间晚上 6 点以后到第二天上午 9 点,基本都在非高峰。索引构建、离线评测、日报汇总、批量代码审查可以排队,在线用户请求别硬等。
还要给模型路由加预算闸门。不是余额低了才报警,而是任务开始前估算最坏成本,执行中看累计输出与重试次数,超过预算就降级到 Flash、缩短历史、暂停非关键工具,或者把任务交回人。
这里有个容易误会的地方。
缩短历史不等于粗暴截断最近 N 条消息。更稳的做法是把稳定规则、当前目标、已确认事实、未解决问题和必要证据留下,把已经消费完的工具原文、重复日志与旧分支移出主上下文。省 token 只是副作用,降低模型走神才是更直接的收益。
说实话我也不确定 DeepSeek 这套价格会不会再调。官方页面自己就写着,产品价格可能变化,充值应按实际用量,定期检查最新信息。
所以别做一张写死单价的年度预算表。
做一套能换价格、换模型、换时段后自动重算的账本。
便宜模型没有消失,便宜幻觉该消失了
DeepSeek V4 依然是一套很有竞争力的模型。V4 Pro 有 1.6 万亿总参数、490 亿激活参数,支持 100 万上下文;V4 Flash 更小、更快。官方也明确把 Claude Code、OpenClaw、OpenCode 这类 Agent 工具列进适配场景。
我不会因为一张涨价表就说它不能用了。模型值不值,仍要回到你的任务、成功率、延迟和隐私要求。
但那种只看首页单价,默认缓存几乎免费,认为失败多跑两轮也没关系的便宜幻觉,可以结束了。
三个问题花 4.30 美元,未必代表你明天的账单。
它更像一声报警。
报警的不是 DeepSeek 变贵,而是 Agent 已经复杂到不能再靠一行 token 单价做成本判断。模型是租来的,账本得是自己的。