posts/deepseek-v4-pro-0813-ga.md
DeepSeek V4 Pro 正式上线,先锁版本再看跑分
今天上午,DeepSeek 没发新博客,官方更新日志也没有多出一行。
但它的模型与价格页里,有个格子悄悄变了。
deepseek-v4-pro 对应的实际版本,已经写成 DeepSeek-V4-Pro-0813。
OpenRouter 同步上线了这个快照,并直接把它标成 DeepSeek V4 Pro 的 GA 正式版。页面显示请求由 DeepSeek 单一供应商直接承接,不是拿别家的模型套了个名字。
好家伙,等了几个月的 V4 Pro 正式版,就这么静悄悄地来了。
没有发布会,没有铺天盖地的跑分海报。甚至截至我核对时,DeepSeek 的官方 changelog还停在 7 月 31 日,结尾仍然写着 V4 Pro 正式版稍后推出。
所以这篇不准备再抄一遍通稿。眼下根本没有一份新的官方 0813 跑分表可抄,硬写谁碾压谁,多少有点替官方做梦。
我更想聊一个容易被热闹盖住的问题。
API 一行没改,生产环境里的模型已经换了。
这件事,比榜单上的小数点更值得工程团队现在就处理。
正式版来了,调用方式却像什么都没发生
4 月 24 日,DeepSeek 发布的是 V4 预览版。当时已经给出 Pro 和 Flash 两个型号,Pro 是 1.6T 总参数、49B 激活参数的旗舰版本,Flash 更轻、更快,也更便宜。
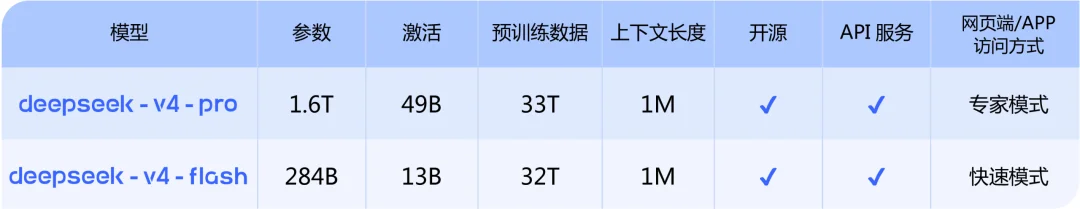
DeepSeek V4 Pro 与 Flash 的官方规格对比
7 月 31 日,V4 Flash 先完成了正式版更新。现在轮到 Pro,快照号是 0813。
真正有意思的地方在调用层。
你不需要把 model 从旧名字改成新名字。代码里继续写 deepseek-v4-pro,base_url 继续用原来的地址,请求就会落到 0813。
对个人开发者,这当然很舒服。配置不用迁,SDK 不用升,连环境变量都懒得动一下。
对生产系统,舒服里藏着一根小刺。
昨天和今天发送完全相同的 prompt,使用完全相同的模型名,背后的权重和后训练版本却可能不同。输出质量变好是变化,工具参数多了一个字段、JSON 偶尔换种写法、推理时延抖了一下,同样是变化。
很多 Agent 的故障并不会优雅地告诉你「模型升级导致」。它只会在日志里留下一串很没礼貌的东西。
tool schema mismatch
max retries exceeded
invalid json
然后值班的人开始查 SDK、查网络、查刚合进去的三行代码,查到午饭凉了,顺着日志排到头才发现上游模型已经换过一轮。
这事儿我太熟悉了。给 AI 搭脚手架,最怕的不是模型会变,模型当然会变。怕的是系统把变化伪装成没变化。
别名很好用,但别名不是版本。
1M 上下文还在,正式版真正补齐的是 Agent 入口
先把目前能确认的东西压缩一下。
按 DeepSeek 当前官方页面,V4 Pro 0813 支持 1M 上下文,最大输出 384K,同时支持思考和非思考模式。JSON 输出、工具调用、Responses API、Anthropic API 都已经打勾。
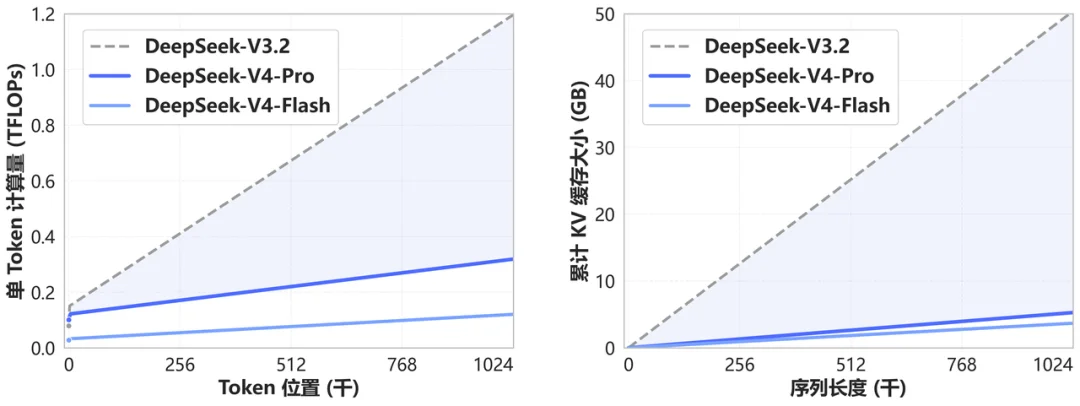
V4 系列在长序列下的单 token 计算量与 KV 缓存占用
价格眼下是每百万 token 缓存命中输入 0.003625 美元,缓存未命中输入 0.435 美元,输出 0.87 美元,并发上限 500。
数字确实有点子牛逼,尤其是缓存命中价。不过先别急着按当前单价把未来一年的预算表填满。官方已经在同一页写明,近期计划上调 API 整体价格,而且预期涨幅显著,具体方案另行通知。
便宜是真的,价格还没定型也是真的。
比价格更值得 Agent 开发者注意的,是 DeepSeek 已经把 V4 Pro 放进完整的工具链入口。
它的 Codex 接入文档现在同时包含 deepseek-v4-flash 和 deepseek-v4-pro。Codex CLI、桌面端和 VS Code 扩展共用一份配置,底层走 DeepSeek 原生支持的 Responses API。
这不是多挂一个聊天窗口那么简单。
Responses API 面向的是会调用工具、会改文件、会在仓库里连续工作很多轮的 Agent。模型一旦进入这里,评估对象就不能只剩一道算法题答对没有。
你得看它能不能稳定选对工具,补丁能不能套上,命令失败后会不会恢复,长任务跑到第 20 步还能不能记得最初的约束。模型能力只占一半,另一半是 harness,也就是让模型真正干活的那层脚手架。
7 月 31 日的 V4 Flash 公告其实已经给过提示。DeepSeek 当时列出的 Agent 跑分,是在自家的 minimal harness 和 max 推理强度下测的。模型、推理档位、工具协议、重试策略绑在一起,共同决定了那个数字。
所以眼下拿 V4 Pro 0813 跑一次通用聊天测试,然后宣布它已经替代 Claude Code,我觉得太早了。
不是说它不行,而是测试对象都没对齐。
同一辆发动机,装在自行车和四驱车上,百公里成绩没有可比性。AI 圈现在经常只拍发动机铭牌,剩下的车架、轮胎和司机,假装不存在。
生产环境现在该补的,是模型发布工程
如果你的应用只是自己聊天,今天直接用起来就行。不好用就切回 Flash,没什么心理负担。
如果 deepseek-v4-pro 已经接进客服、代码审查、数据分析或自动化 Agent,我建议把它当成一次正式依赖升级,而不是一次无感知的云服务维护。
最小动作,是把实际模型快照写进每次评测和发布记录。
{
  "provider": "deepseek",
  "model_alias": "deepseek-v4-pro",
  "resolved_version": "DeepSeek-V4-Pro-0813",
  "verified_at": "2026-08-13T03:15:00Z",
  "prompt_hash": "...",
  "harness_version": "..."
}
API 如果没有在响应里返回快照号,也至少要记录你最近一次从官方模型页核对到的版本和时间。以后质量曲线突然拐弯,团队还有一根线可以往回追。
接着把黄金集重跑一遍。
黄金集不需要很宏大,就是你线上最怕出错的几十到几百个真实任务,去掉敏感信息后固定下来。工具调用成功率、结构化输出解析率、任务完成率、平均 token、首 token 延迟和总耗时,一起看。
别只比答案分数。
一个代码 Agent 的正确率涨了 3%,但平均多跑 6 轮工具、输出 token 翻倍,最终账单和排队时间可能更难看。一个客服 Agent 文风更自然,却开始偶尔漏掉退款政策里的限制条件,也不能叫升级成功。
然后做小流量 canary,也就是先让极少量真实请求走新模型,观察稳定后再扩大。模型供应商替你把别名切了,你自己的路由层仍然可以保留开关。真出问题时,能不能在几分钟内切到 Flash 或其他供应商,比群里讨论哪个模型更聪明实用得多。
再加一道成本闸门。
官方已经提前说要涨价,那就别等账单跳起来才开会。把每个成功任务的平均输入、输出、缓存命中率和重试次数记下来,按当前价格和涨价情景各算一遍。模型便宜不便宜,不是看价目表的一行数字,要看完成一个真实任务花多少钱。
这一套听起来没跑分刺激,甚至有点像给浪漫的新模型办入职手续。
但生产环境就是这样。简历再漂亮,门禁卡、工位权限、试用期目标和回滚预案,一个都不能少。
我自己的判断是,DeepSeek V4 Pro 0813 真正有杀伤力的地方,不是某张榜单暂时高过谁,而是它把 1M 上下文、原生工具协议、Codex 接入和极低 token 单价装进了同一个可用入口。
这会让很多团队认真考虑把它放进 Agent 的主力路由。
也正因为它足够便宜、足够顺手,版本治理才更不能省。
今天那个悄悄变化的表格单元格,很可能会成为不少生产日志里的一条分界线。分界线之前和之后,代码里的模型名完全相同。
模型发布已经结束了。
你自己的发布,才刚开始。