posts/deepseek-v4-pro-h20-serving.md
H20 跑 DeepSeek-V4-Pro,万能配置不存在
峰值 Tensor Core 算力差 45.6 倍,真实解码速度差 1.42 倍。
这两个数字同时出现在 LMSYS 最新的 DeepSeek-V4-Pro 服务复盘 里。前者比较 B300 的 FP4 与 H20-141GB 的 FP8 峰值计算,后者比较两边公开测到的最高生成速度,383.7 tok/s 对 271 tok/s。
好家伙,纸面上隔着一条江,跑起来像只隔了一条马路。
但先别急着把 271 抄进采购汇报。它不是一条神参数跑出来的,也不是 H20 突然学会了硬件炼金术。团队为同一个 1.6 万亿参数的 DeepSeek-V4-Pro 准备了多套服务配置,短上下文走一条路,长上下文换一条路,低延迟和高吞吐又各走各的。
这篇复盘最值钱的判断,反而有点朴素。
推理服务没有万能配置。
271 tok/s 只是一张切面
先把这张成绩单摊平。
单节点 8×H20-141GB 在 batch size 1 下跑到 271 output tokens/s。LMSYS 之前公布的 B300 参考值是 383.7 tokens/s,两者的观测差距是 1.42 倍。
同一篇文章里还有另外几组数字。优化后的预填充每节点达到 8.45k input tokens/s,百万 token 的提示词用 43.7 秒处理完。吞吐优先的 DP16-EP16 配置达到每节点 4.67k output tokens/s,平均 TPOT,也就是每生成一个 token 的耗时,约 27.4 ms。
看起来像一台机器三头六臂,对吧?
其实这些成绩来自不同配置。271 tok/s 是单请求极限延迟的参考,43.7 秒对应长上下文预填充,4.67k tok/s 对应吞吐优先的高并发解码。把它们剪下来贴成一张万能服务器海报,就跟拿短跑冠军的起跑、马拉松冠军的耐力和举重冠军的力量,拼成一个不存在的人差不多。
这块很容易踩坑。模型发布时我们爱盯一个总分,部署时也会下意识找一套「最佳参数」。可真实流量不长一个样。有的请求只有 4K 输入,用户盯着光标等第一句话。有的请求塞进几十万 token,晚十秒并不要命。有的业务只有一两个并发,有的队列里几百个请求排着。
这些负载压的不是同一块肌肉。
预填充主要受 TTFT,也就是首 token 时间约束。解码要考虑 TPOT、KV cache 容量和并发。短输入怕流水线填不满,长输入反而有足够多的工作喂满更深的流水线。你如果强迫它们共用一套拓扑,省下的是几份配置文件,付掉的可能是整条延迟曲线。
所以 271 这个数字可以看,但别只看它。更该看的是团队为什么敢维护不止一套配置,以及每次切换到底在换什么。
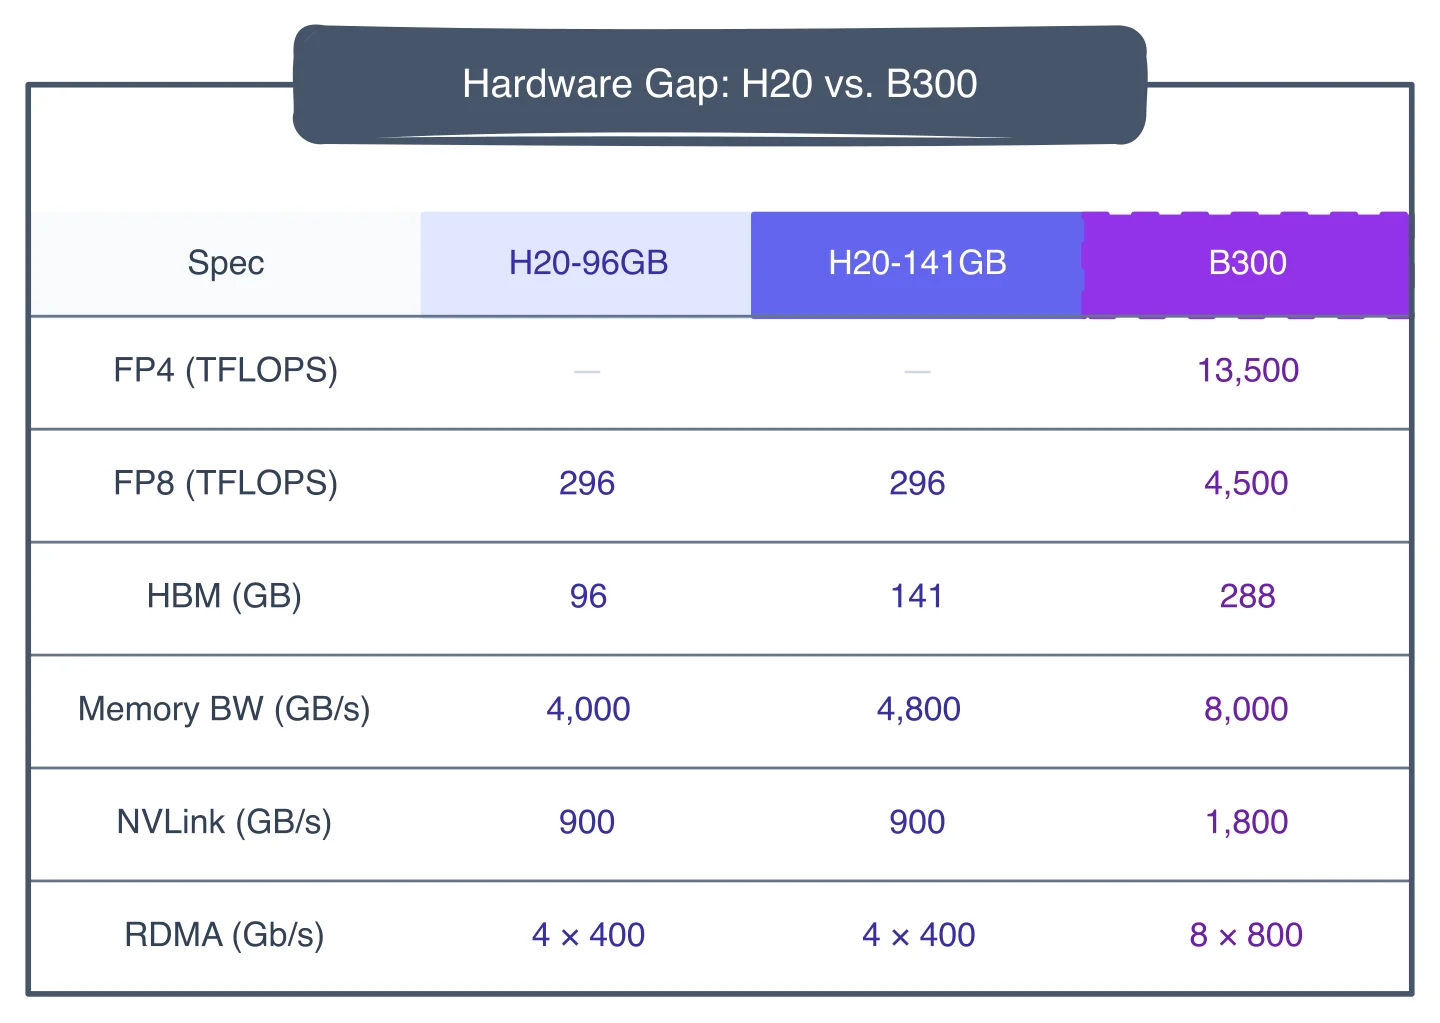
峰值规格决定上限,真实负载决定你能摸到哪一段上限。
短上下文和长上下文,连流水线都不该一样
预填充阶段,团队准备了 PP2-CP8-TP8 和 PP4-CP8-TP8 两种配置。缩写看着像机房门禁密码,我用人话捋一下。
PP 是流水线并行,把模型层切到不同阶段。CP 是上下文并行,把长序列拆开算。TP 是张量并行,让多张卡一起处理同一层。PP2 是两级流水线,PP4 是四级流水线。
两级还是四级,没有谁天然高级。
短输入能切出来的工作块少。四级流水线刚把前几级填进去,后面还没完全忙起来,任务可能已经快结束了。填充、排空和跨阶段传输的固定开销显得很重,所以 PP2 更省事。
长上下文不一样。几十万 token 能提供足够多的工作块,四级流水线一直有活干,每一级分到的模型层又更少,额外节点终于能变成有效并行。
数据很诚实。4K 和 32K 输入下,PP2 的首 token 时间分别比 PP4 低 16.7% 和 19.5%。到了 128K,方向反过来,PP4 领先 26.2%。输入拉到 1M,PP4 的优势扩大到 44.8%。
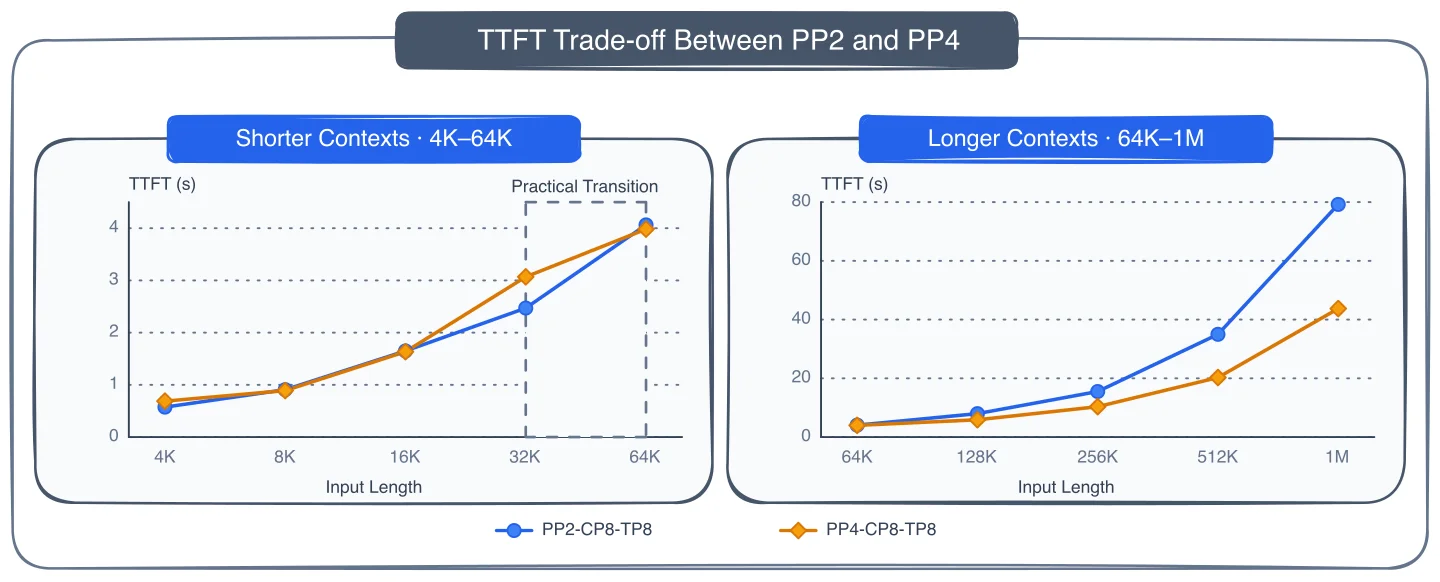
短输入怕流水线过深,长输入才能把更多阶段真正喂饱。
很多团队看到这条曲线,会马上问切换阈值是不是 128K。
不是。
128K 是这次硬件、模型、实现和请求分布下测出来的结果。换一个模型版本,换一组节点互联,甚至只把线上输入长度分布改掉,交叉点都可能移动。真正可抄的不是 128K 这个常量,而是把真实流量按长度分桶,分别测 TTFT,再让路由策略服从测量结果。
同样的选择还出现在 MoE,也就是混合专家模型的并行方式上。
按直觉,专家并行只把 token 发给被选中的专家,通信量更少,应该更快。可真实预填充流量会让 384 个专家冷热不均。拿到热门专家的 rank 忙到冒烟,其余 rank 在合并阶段一起等它。通信省了,长尾却冒出来了。
团队最终选 MoE-TP。它做的集合通信更多,但流量走 900 GB/s NVLink,成本稳定而且可预测。所有 TP rank 分担同一批路由 token,不再让某个热门专家把全局拖住。相关实现已经放进 SGLang PR 24947。
少传数据,不一定少花时间。
这一刀有点子牛逼。优化对象从「通信量最小」换成了「尾延迟可控」。跑在线服务的人看到这里,应该会非常熟悉。平均值漂亮不难,难的是别让一小撮怪请求把整条队列拖下水。
低延迟与高吞吐,买的是两种东西
到了解码阶段,配置继续分叉。
追求单请求低延迟时,单节点 TP8 的执行链最短。模型层都在一台 8 卡 H20-141GB 节点上,不用跨流水线阶段同步,跑到 271 tok/s 的就是它。
代价也直白。模型权重和服务状态挤在同一节点,KV cache 能用的空间变少。到 1M 上下文时,它只够 batch size 1,再来一个并发就塞不下。
PP2-TP8 多用一个节点,把模型权重摊到两级流水线,给 KV cache 腾出更多显存。单请求速度会付一点流水线税,但它更像一套能接真实流量的低延迟服务,而不是只跑一条请求的实验室冲刺。
为了把这条路再往前推,团队接入了 DSpark 投机解码。它先让轻量 drafter 猜接下来几个 token,再由目标模型批量验证。优化后,batch size 1 的峰值 TPOT 在 8K 到 1M 输入范围内下降 74.8% 到 78.0%。公开代码在 DSpark PR 30261。
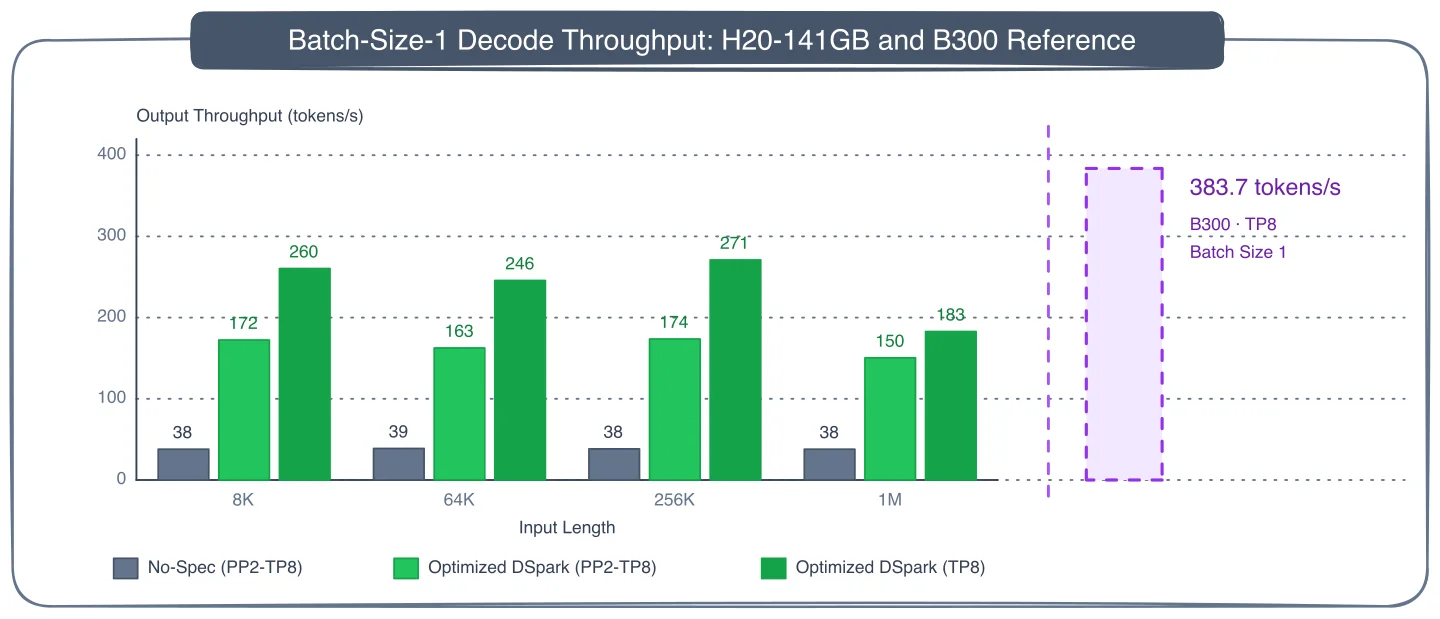
271 tok/s 是单节点低延迟参考,不是所有并发与上下文都能复制的默认值。
高吞吐是另一门生意。
DP16-EP16 追求每张卡的效率,DP32-EP32 把专家权重摊到更多 GPU,给 KV cache 留出更大空间,能接更多并发。可更多专家流量要跨节点,单卡吞吐反而可能下降。
厉害了,扩容并不保证每张卡更快。你买到的有时不是效率,是容量。
这个区分对成本估算很要命。只拿 tok/s/GPU 排序,DP16-EP16 可能更香。把 256K、512K、1M 上下文和并发目标放进来,能不能把请求装下,比单卡效率高几个点更先决定系统能不能跑。
团队还把显存账本抠得很细。Humming MXFP4AFP8 用 MXFP4 专家权重和在线 FP8 激活减少权重占用,Online C128 再缩掉一部分辅助状态,把空间还给 KV cache。两者叠加后,DP32-EP32 的 full-token capacity 达到 FP8 基线的 3.88 倍,PP2-TP8 达到 10.14 倍。SGLang 的接入实现也已经公开在 PR 23754。
注意,这不是免费午餐。量化要验精度,更多配置要维护,路由策略要监控,模型版本一换还得重新测。文章给出的 GSM8K1000 验证是 95.5%,刚过团队设定的 95.0% 接受线。公开对比用的是 DeepSeek-V4-Flash,不是同一个 Pro 模型,不能拿来装作一组严格配对实验。
把这些边界写出来,反而让 271 更可信。
普通团队真正能抄走什么
看到 PP、CP、TP、DP、EP 一路排开,很多人可能已经准备关页面了。别慌,普通团队不需要明天就维护四套巨型集群。能抄走的是做决策的顺序。
先把请求分布量出来。至少要知道输入长度、输出长度、并发、首 token 目标、单 token 延迟目标,以及高峰期队列长什么样。没有这些数据,讨论最佳拓扑跟看星座配服务器差不多。
再按场景建最小基线。短上下文低延迟、长上下文预填充、高并发吞吐,哪怕只先分两类,也比把所有请求塞进一套配置强。测试时保留硬件、模型权重、精度、batch size、输入输出长度和并发,少一项,数字都可能没法复现。
然后找当前真正卡住的资源。是算力不够,HBM 装不下,内存带宽吃满,还是跨节点通信拖尾?瓶颈不同,答案可能是量化、增加流水线阶段、换并行方式、做投机解码,也可能只是把两类请求分开。
把路由放到最末。路由规则别写成祖传常量,要跟 profiling 一起版本化。模型升级、流量变化或硬件混部后,重新测交叉点。原文连 基准命令和日志裁剪方法 都放出来了,这部分比一张柱状图耐用得多。
我自己的感受是,AI 基础设施这两年越来越像数据库。没人会问一个数据库索引能不能同时把所有查询都优化到最好,可到了模型服务,我们还是会期待一份参数表包治百病。
没有这种好事。
H20 能把 DeepSeek-V4-Pro 推到离 B300 参考值只差 1.42 倍,不是因为硬件差距消失了,而是工程师承认了负载有差异,然后让每类请求走更合适的路。
模型只有一个,服务配置可以不止一个。
那条看似多出来的岔路,往往才是旧硬件继续航行的水道。