posts/deepseek-v4-vision-agent-gap.md
DeepSeek 视觉接近 Opus 4.8,生产还差一条链
DeepSeek 今天给 V4-Flash 装上了一双眼睛。
名字挺长,DeepSeek-V4-Flash-Vision-Exp。官方在更新日志里写得很直接,纯文本能力和 V4-Flash 正式版持平,遇到需要视觉理解的 Agent 任务则大幅提升,多模态 Agent 能力已经接近 Opus 4.8。
好家伙,「接近 Opus 4.8」这几个字放出来,传播素材算是齐了。
不过我更在意后半段。DeepSeek 没把它叫成一个更会看图的聊天模型,而是在强调视觉 Agent。前者是你扔一张图,它告诉你图里有什么。后者是它看着截图、图表、报错弹窗和网页状态,继续决定下一步该点哪里、该调哪个工具、什么时候该停。
这不是多加一种输入格式那么简单。它把 Agent 原来缺掉的一段反馈回路补上了。
我还没拿这个实验模型跑真实任务,所以这篇不装实测。只看官方已经公开的跑分、接口和限制,我有一个可能有点扫兴的判断,DeepSeek 这次补上的确实是一块关键拼图,但「模型看得见」离「任务交得出去」仍然隔着一整条工程链。
先把最容易误会的能力边界说清楚。它支持的是视觉理解,包括识别图片内容、读取截图文字、分析图表、同时处理多张图片,再把观察结果交给工具链继续行动。它不是生图模型,官方没有提供文生图或图片编辑能力;它也不接收或生成语音,更不生成视频。文档虽然允许上传 GIF,但这只是受支持的图片文件格式,不能据此把它写成视频理解或视频生成模型。名字里的「多模态」,目前准确地说就是文本加图像输入,文本输出。
跑分涨了,真正的变化不在数字最大那一格
先看官方给的数字。
和 7 月 31 日的 V4-Flash 正式版相比,Vision 实验版在几项重合的 Agent 评测上都在涨。Terminal Bench 2.1 从 82.7 到 83.9,NL2Repo 从 54.2 到 57.7,DeepSWE 从 54.4 到 59.3,DSBench-Hard 从 59.6 到 63.6,AutomationBench 从 25.1 到 25.7,Agents’ Last Exam 从 25.2 到 27.3。
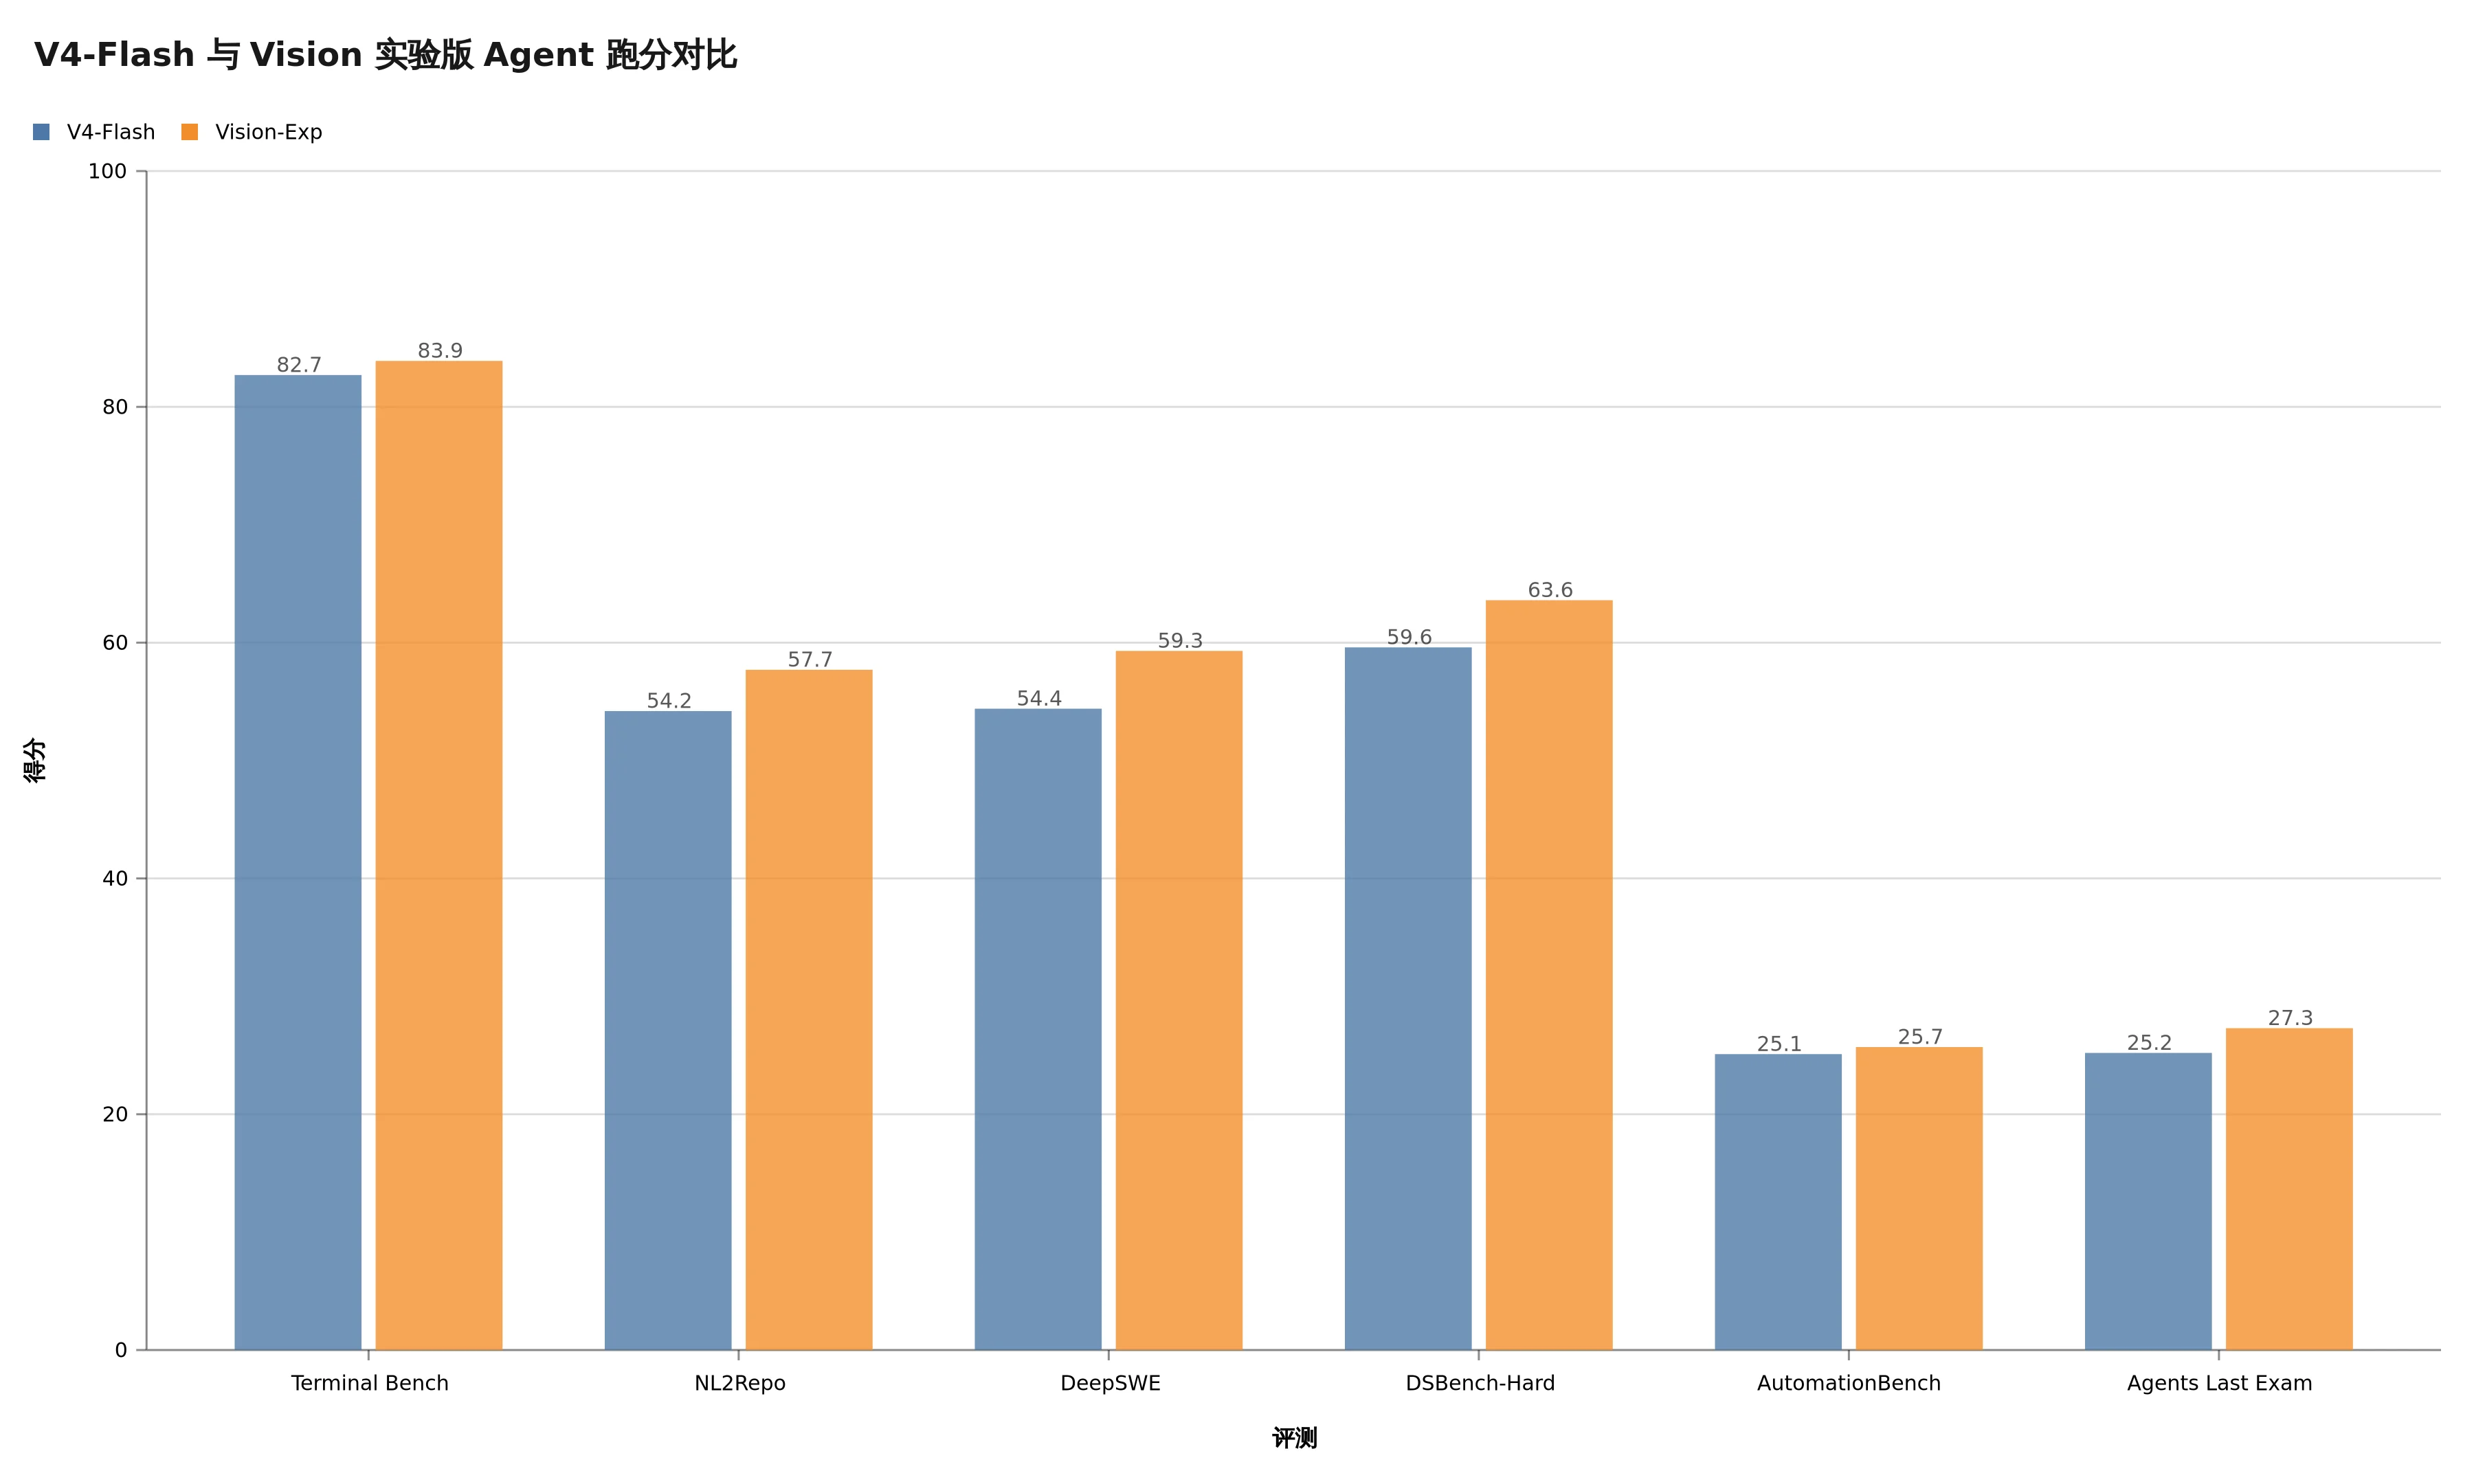
六项重合评测都在上涨,但增幅并不均匀,数据来自 DeepSeek 官方更新日志。
最显眼的单项增幅是 DeepSWE 的 4.9 分,可它并没有把纯文本模型直接甩出一条街。这个结果反而挺合理。官方自己也说了,两者在 Agent、推理和世界知识这些纯文本能力上持平。
视觉版本真正多出来的价值,不是把原来的脑子再磨亮一点,而是让原来被丢掉的环境状态进入上下文。
想想一个网页操作 Agent。没有视觉时,它很依赖 DOM、可访问性树、接口返回值这些结构化信息。页面上的按钮如果藏在画布里,图表只剩一张像素图,弹窗覆盖了原来的元素,或者远程桌面压根不给你干净的节点树,Agent 就像隔着门听屋里的动静。它也许知道下一步理论上该做什么,却不知道此刻屏幕到底变成了什么样。
有了视觉,截图可以成为一次工具调用后的观察结果。模型点击,页面变化,再看一眼,再决定下一步。这才是 Agent 回路里那个朴素又难缠的 observe。
厉害的地方在这里。
但麻烦也从这里开始。
一张截图,不是一份可靠状态
很多演示会让人产生一种错觉,只要模型能读图,浏览器和桌面操作就自然能用了。真到生产环境里,截图其实是最不稳定的状态载体之一。
同一个按钮可能因为窗口尺寸换了位置,因为深色模式换了颜色,因为动画还没结束只露出一半。页面滚动两百像素,坐标就失效。网络慢半秒,模型看到的还是骨架屏。更别提验证码、浮层、权限弹窗、远程桌面的压缩噪点。
全局图负责找方向,局部图负责读细节,动作还要经过安全闸。
于是第一个工程问题不是「看懂了吗」,而是「你看到的这一帧,能不能代表当前状态」。
一个能落地的视觉 Agent,至少要给每次观察绑定时间戳、页面标识、窗口尺寸和动作序号。动作执行后不能只等一个固定的 sleep(2),而要等 DOM 稳定、网络空闲、目标区域不再变化,或者由视觉模型确认页面已经进入预期状态。否则 Agent 很可能拿旧截图做新决定,接着非常自信地点向空气。
这种 bug 最烦。日志里每一步都像有道理,合在一起就是没做成。
DeepSeek 的图像理解文档给了 OpenAI Chat Completions、Responses API 和 Anthropic 兼容端点三种接法,也允许图片出现在 function_call_output 或 custom_tool_call_output 里。这个设计对 Agent 很关键,浏览器工具可以把截图作为执行结果原样送回模型,不用再绕一层描述文本。
可接口兼容只解决了「怎么送进去」。谁来截屏、截哪块、什么时候截、上一张图要不要保留、模型看错后怎么恢复,这些仍然归调用方。
棒棒的,最难的部分又回到了工程师手里。
384 个 token 的上限,省钱也会藏细节
这次文档里有个很实用的数字,每张图片进入模型前会被自动缩放,图片 token 消耗上限是 384。小图会按比例放大,大图会缩到大约 800×800 像素对应的规模。2000×2000 和 5000×5000 的图片,缩放后的 token 消耗可以一样。
对账单是好消息。对视觉 Agent 却得多想一步。
一个 4K 桌面截图里,按钮文字、表格小数、终端报错和浏览器地址栏全挤在同一张图上。压到这个尺度后,模型可能看懂页面布局,却读不清一行关键错误。你把 detail 设成 original,并不等于原始像素会一粒不少地进入推理,官方的缩放规则仍然存在。
所以别把整块屏幕无脑塞给模型。更稳的做法是先用便宜的全局截图判断区域,再按目标控件、图表或错误窗口裁剪局部图。全局图负责导航,局部图负责读细节。遇到重复使用的图片,可以走Files API,避免每轮都把 base64 塞进请求体。具体图片成本则应接进用量计算和调用日志,跟文本 token 一起看。
这套方法听着不酷,甚至有点像在给模型配老式双筒望远镜。先找方向,再调焦。
但生产系统靠的往往就是这种不酷的约束。
还有一个容易漏掉的成本,视觉观察会让上下文增长得很快。一次任务如果截了几十张图,哪怕单图有上限,图像 token、动作历史、工具返回值和模型推理仍会一起累积。保留所有历史截图很安心,直到延迟和费用开始提醒你,安心也有单价。
调用层需要把旧截图压成结构化状态,只保留最近一两帧原图。哪些字段已经确认,哪些区域仍不确定,哪些动作已经失败,可以写进一个小型状态对象。模型需要的是可继续决策的信息,不是任务从出生到现在的家庭录像。
能看见之后,权限边界更重要了
视觉模型让 Agent 能处理以前读不到的界面,也让它更容易碰到以前看不到的敏感信息。
截图里可能有邮箱、客户名称、内部报表、访问令牌,甚至一个刚弹出来的验证码。浏览器工具把整张屏幕回传时,这些内容会一起进入模型上下文。模型再调用工具时,风险就从「看见」走到了「行动」。
这块不能靠一句系统提示词兜底。
截图采集前要做窗口白名单和区域遮罩,工具侧要限制可访问域名,涉及转账、购买、验证码、隐私授权和公司资料外发的动作要卡人工确认。每次工具调用还得带上截图 ID 和决策理由,审计时才能还原模型到底看到了什么。
DeepSeek 已经支持工具调用、Responses API以及图像工具输出,这让接口拼装轻松不少。真正的安全边界却不在模型返回的那段 JSON 里,而在执行器是否拒绝越权动作。
我一直觉得,视觉 Agent 最危险的幻觉不是把猫认成狗,而是把「按钮好像在这里」变成了一次真实点击。识别错了,最多答案难看。动作错了,可能已经发出邮件、删掉文件,或者把内部截图传到了不该去的地方。
所以视觉 Agent 的评测不能只问结果有没有完成。还要看它点错了几次,是否在不确定时停下,能否从错误页面恢复,敏感动作有没有触发审批,以及失败后留下的状态能不能接着跑。
这也解释了为什么我不愿把「接近 Opus 4.8」直接换算成生产结论。官方跑分很有价值,它证明能力边界往前推了。但厂商自己的同一套测试条件、max 思考档位和极简 Harness,不能替你回答真实网站延迟、权限策略、截图噪声与成本预算。
真要接入,先跑一条窄任务
如果你已经在用 DeepSeek API,这个实验模型很适合做一次小范围影子测试,别急着把原来的 Agent 全部替换掉。
挑一条有明确起点和终点的视觉任务。可以是从固定格式的监控截图里读取异常区域,再打开对应日志页面;也可以是检查后台表格某一列是否出现红色告警,但不要一上来就让它自由操作整个桌面。
给这条任务留三份记录。第一份是原始截图和裁剪图,第二份是模型观察到的结构化状态,第三份是工具动作与结果。然后盯四类数字,任务成功率、平均动作数、错误点击数、人工接管率。费用和延迟单独记,不要混成一个漂亮的总分。
再做两个故障版本。故意让页面加载慢一点,看看模型会不会对骨架屏动手。故意加一个无关弹窗,看看它能不能识别遮挡并恢复。视觉 Agent 的价值不只在顺风局能走多快,更在环境变脏以后会不会安静停船。
如果你需要频繁复用图片,改走 file ID。如果只关心大致布局,用 detail=low。如果要读小字,先裁剪再传。模型不确定时,把下一步工具权限降成只读。连续两次观察没有状态变化,就让看门狗终止任务,而不是继续点击同一个位置。
这些规则没有一条会出现在发布海报正中央。可它们决定了模型是一个好看的演示,还是一个凌晨告警后还能让人放心的系统。
DeepSeek-V4-Flash-Vision-Exp 目前还是实验版本,价格页也需要在接入时重新确认。实验模型最适合拿来测边界,不适合被一个漂亮分数直接送进核心流程。
坦率讲,我对这次更新是兴奋的。低价、兼容现有接口、视觉输入和 Agent 能力放在一起,确实会让更多团队有机会把屏幕反馈接进自动化系统。那扇门已经开了。
只是门后面不是终点,是状态管理、图像预算、权限控制、评测和失败恢复组成的一段长廊。
模型终于看见了。
接下来,得让它学会在看不清的时候别乱动。