posts/dots3-note-active-parameters.md
dots3-note 只激活 16B,普通显卡还是跑不动
280B 总参数,16B 激活参数,512K 上下文。
三个数字挨在一起,很容易让人产生一种错觉,模型每次只用 16B,那它大概就是个 16B 模型,量化一下,塞进工作站,兴许还能留点显存开浏览器。
然后把 dots3-note Preview 的官方模型卡 翻到部署章节,画风立刻变了。
官方建议用 SGLang 或 vLLM,在单个 8 卡节点上部署 FP8 权重。给出的 vLLM 配方 更直白,8 张 NVIDIA H100,张数写得明明白白。
好家伙,「轻量」和「本地能跑」中间,原来隔着一个机柜。
这不是 dots 团队玩文字游戏。dots3-note 的轻量,是放在 dots3 家族内部比较能力、时延和推理成本后得出的定位。它采用 MoE(Mixture-of-Experts,混合专家)架构,总参数 280B,每个 token 只路由到其中一部分专家,激活约 16B 参数。和每次都把全部参数拉出来算的稠密模型相比,这个设计确实能少做很多乘法。
但少算,不等于少装。
这几个字,可能比发布页上所有跑分都更影响普通开发者的部署决定。
16B 只管这一拍
理解 MoE,可以想象一个有 256 个专科医生的医院。每位患者进来,分诊台挑 8 个专家会诊,再加上一位共享专家。真正参与这一次会诊的人不多,所以单次计算量降下来了。
问题在于,医院不能只给今天被叫到的 8 位医生租办公室。下一位患者可能会被路由到另一组专家,256 组专家的资料都得随时可取。对应到模型,未被当前 token 激活的权重没有参加这一步计算,却通常仍要驻留在 GPU 显存或能被快速访问的内存里。
官方架构表 写得很细,模型有 1 个稠密层和 45 个 MoE 层,每层包含 256 个路由专家与 1 个共享专家,采用 Top-8 激活。视觉编码器自己也是 MoE,总参数 7B,激活 1.2B,旁边还挂着一个 800M 的稠密音频编码器。
所以 16B 回答的是「生成当前 token 时,有多少参数参与主要计算」,不是「把模型装进机器最少需要多少显存」。
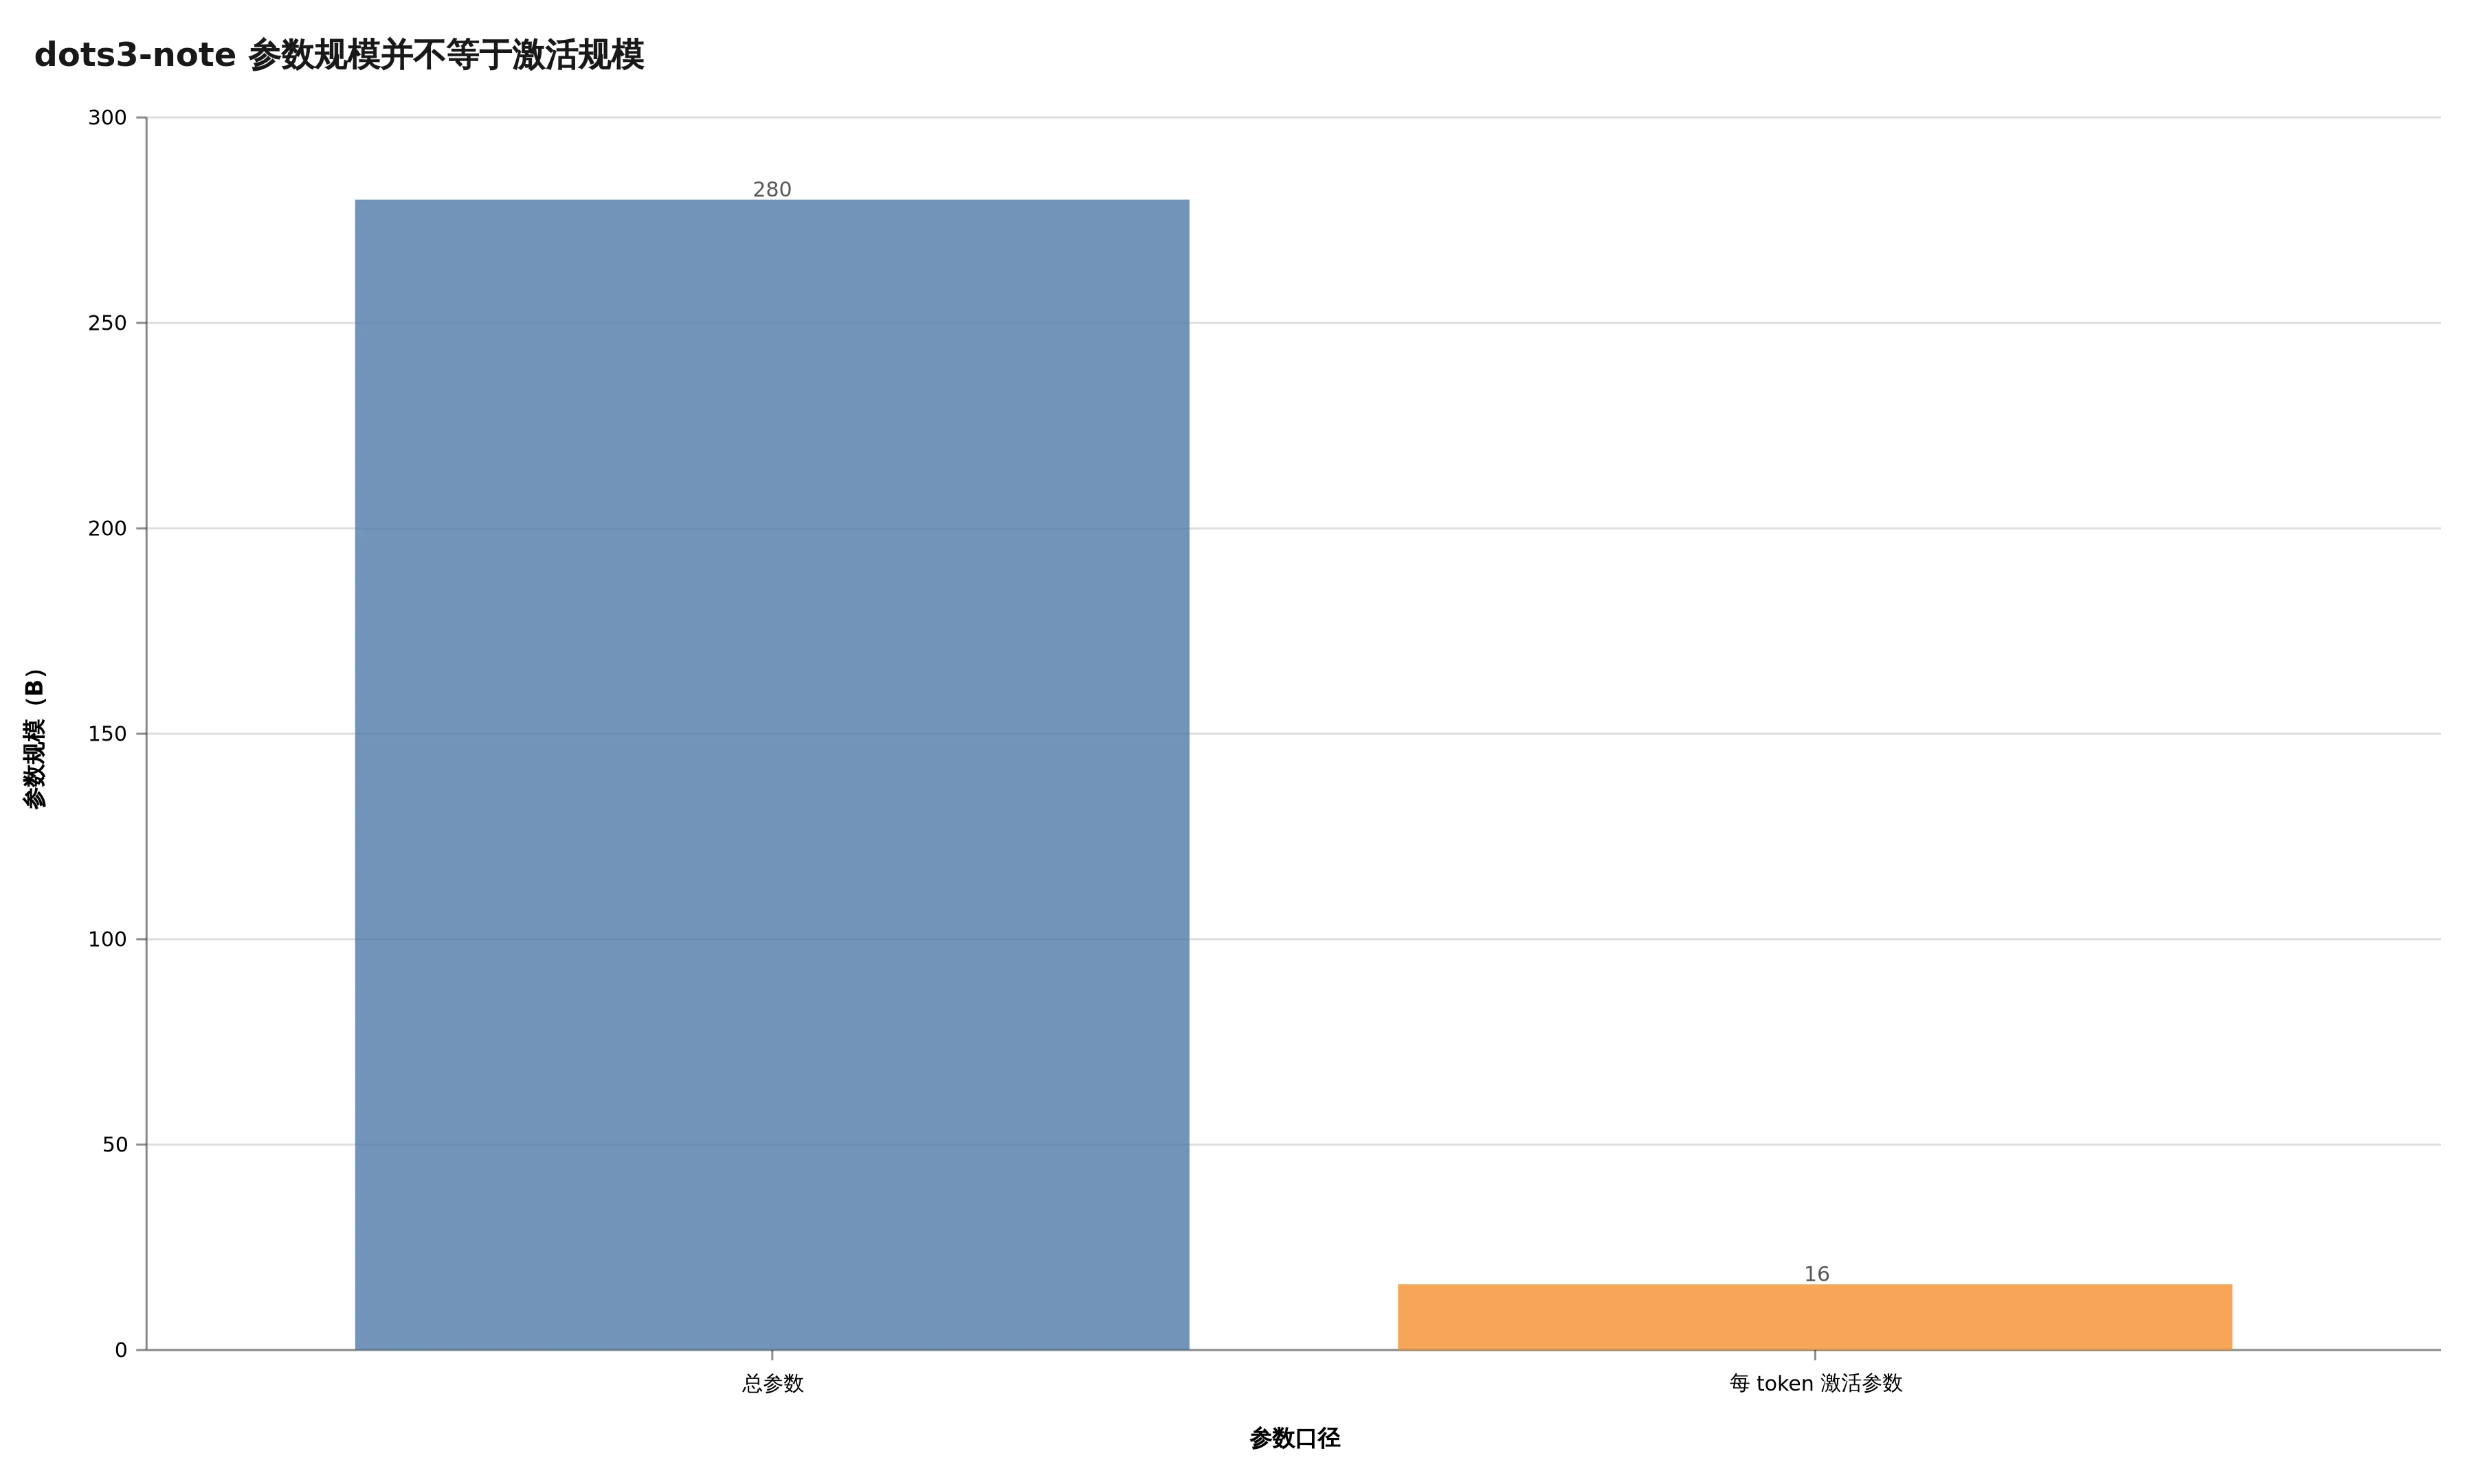
图 1,280B 总参数与 16B 激活参数来自官方模型卡,少算不等于少装。
把 280B 权重按最粗的纸面算法估一下,BF16 每个参数约 2 字节,仅权重就接近 560GB。FP8 每个参数约 1 字节,纸面值也在 280GB 左右。真实部署还要留出量化元数据、运行时缓冲、通信空间和上下文缓存,绝不会刚好卡着纸面值落地。
这也解释了官方为什么把 FP8 的起步方案写成 8 卡节点。8 张 80GB H100 合计 640GB 显存,不是为了让 16B 模型摆阔,而是要同时容纳整套权重和推理现场。
坦率讲,激活参数是衡量 MoE 计算效率的好指标,却是衡量「我的机器能不能跑」的坏捷径。只看 16B 就去下载权重,进度条走到一半,硬盘可能先开始跟你谈人生。
还有两本更贵的账
静态权重只是第一本账。第二本叫 KV cache(键值缓存),它保存前文经过注意力层计算后的中间状态,让模型生成下一个 token 时不必把整段历史重新算一遍。
dots3-note 支持 512K 上下文,差不多可以把一本很厚的技术书、一个中型代码仓库的关键文件,或者一条长时间运行的 Agent 轨迹塞进同一轮任务。听着有点子牛逼,实际部署时却不能把 512K 当成赠品。
上下文越长,预填充阶段要读的 token 越多,首个 token 出现得越慢。并发越高,需要同时保留的 KV cache 越多。再叠加图像、视频和音频输入,编码器也会占用显存与算力。于是同一套 8 卡机器上,单会话 512K、四个并发 128K、十几个短会话,完全是三种生意。
官方文档对此很诚实,部署章节明确要求按可用显存、并发量和输入模态调整上下文长度。SGLang 示例把上限开到 524288,vLLM 的 8 卡 H100 示例却先设成 262144。模型能力上限是 512K,示例服务上限只有一半,这个细节比宣传页上的大数字更像生产环境。
厉害了,真正懂成本的人,连示例命令都在劝你克制。
第三本账来自长程 Agent 本身。一个 Agent 不是问一句答一句,它会搜索、读文件、调用工具、观察结果、改计划,再跑下一轮。轨迹越长,历史越肥。中间一次工具超时、一个错误页面、一次无效搜索,都可能变成后续每一轮要反复携带的上下文。
512K 可以推迟上下文溢出的时刻,却不会自动替你管理上下文。要是运行框架把所有工具输出原封不动往提示词里堆,窗口越大,它反而越敢囤垃圾。结果模型没有因为上下文不够而停下,账单先因为上下文太够而起飞。
做长任务时,更稳的办法仍然是给轨迹分层。最近几轮保留原文,旧工具输出只留结构化结果,网页与日志保存引用位置,需要时再取。失败重试要记录失败类型,别把同一个 404 页面塞回模型五次。512K 应该用来保留真正跨阶段的状态,不是拿来给坏习惯扩容。
这块需要注意一下,模型窗口是仓库面积,上下文治理才是库存管理。仓库从 128K 扩到 512K,乱堆货的人只会获得一间更大的乱仓库。
跑分很强,工程栈还在长
dots3-note Preview 并不是一台只有参数故事的巨兽。官方给出的评测里,它在 Claw-Eval、WildClawBench、Terminal-Bench、SWE-bench、BrowseComp 和多模态理解等任务上都交出了一张挺能打的成绩单。模型支持文本、图像、视频、音频输入,输出文本,还把工具调用、多步骤工作流、探索与记忆更新列为重点任务。
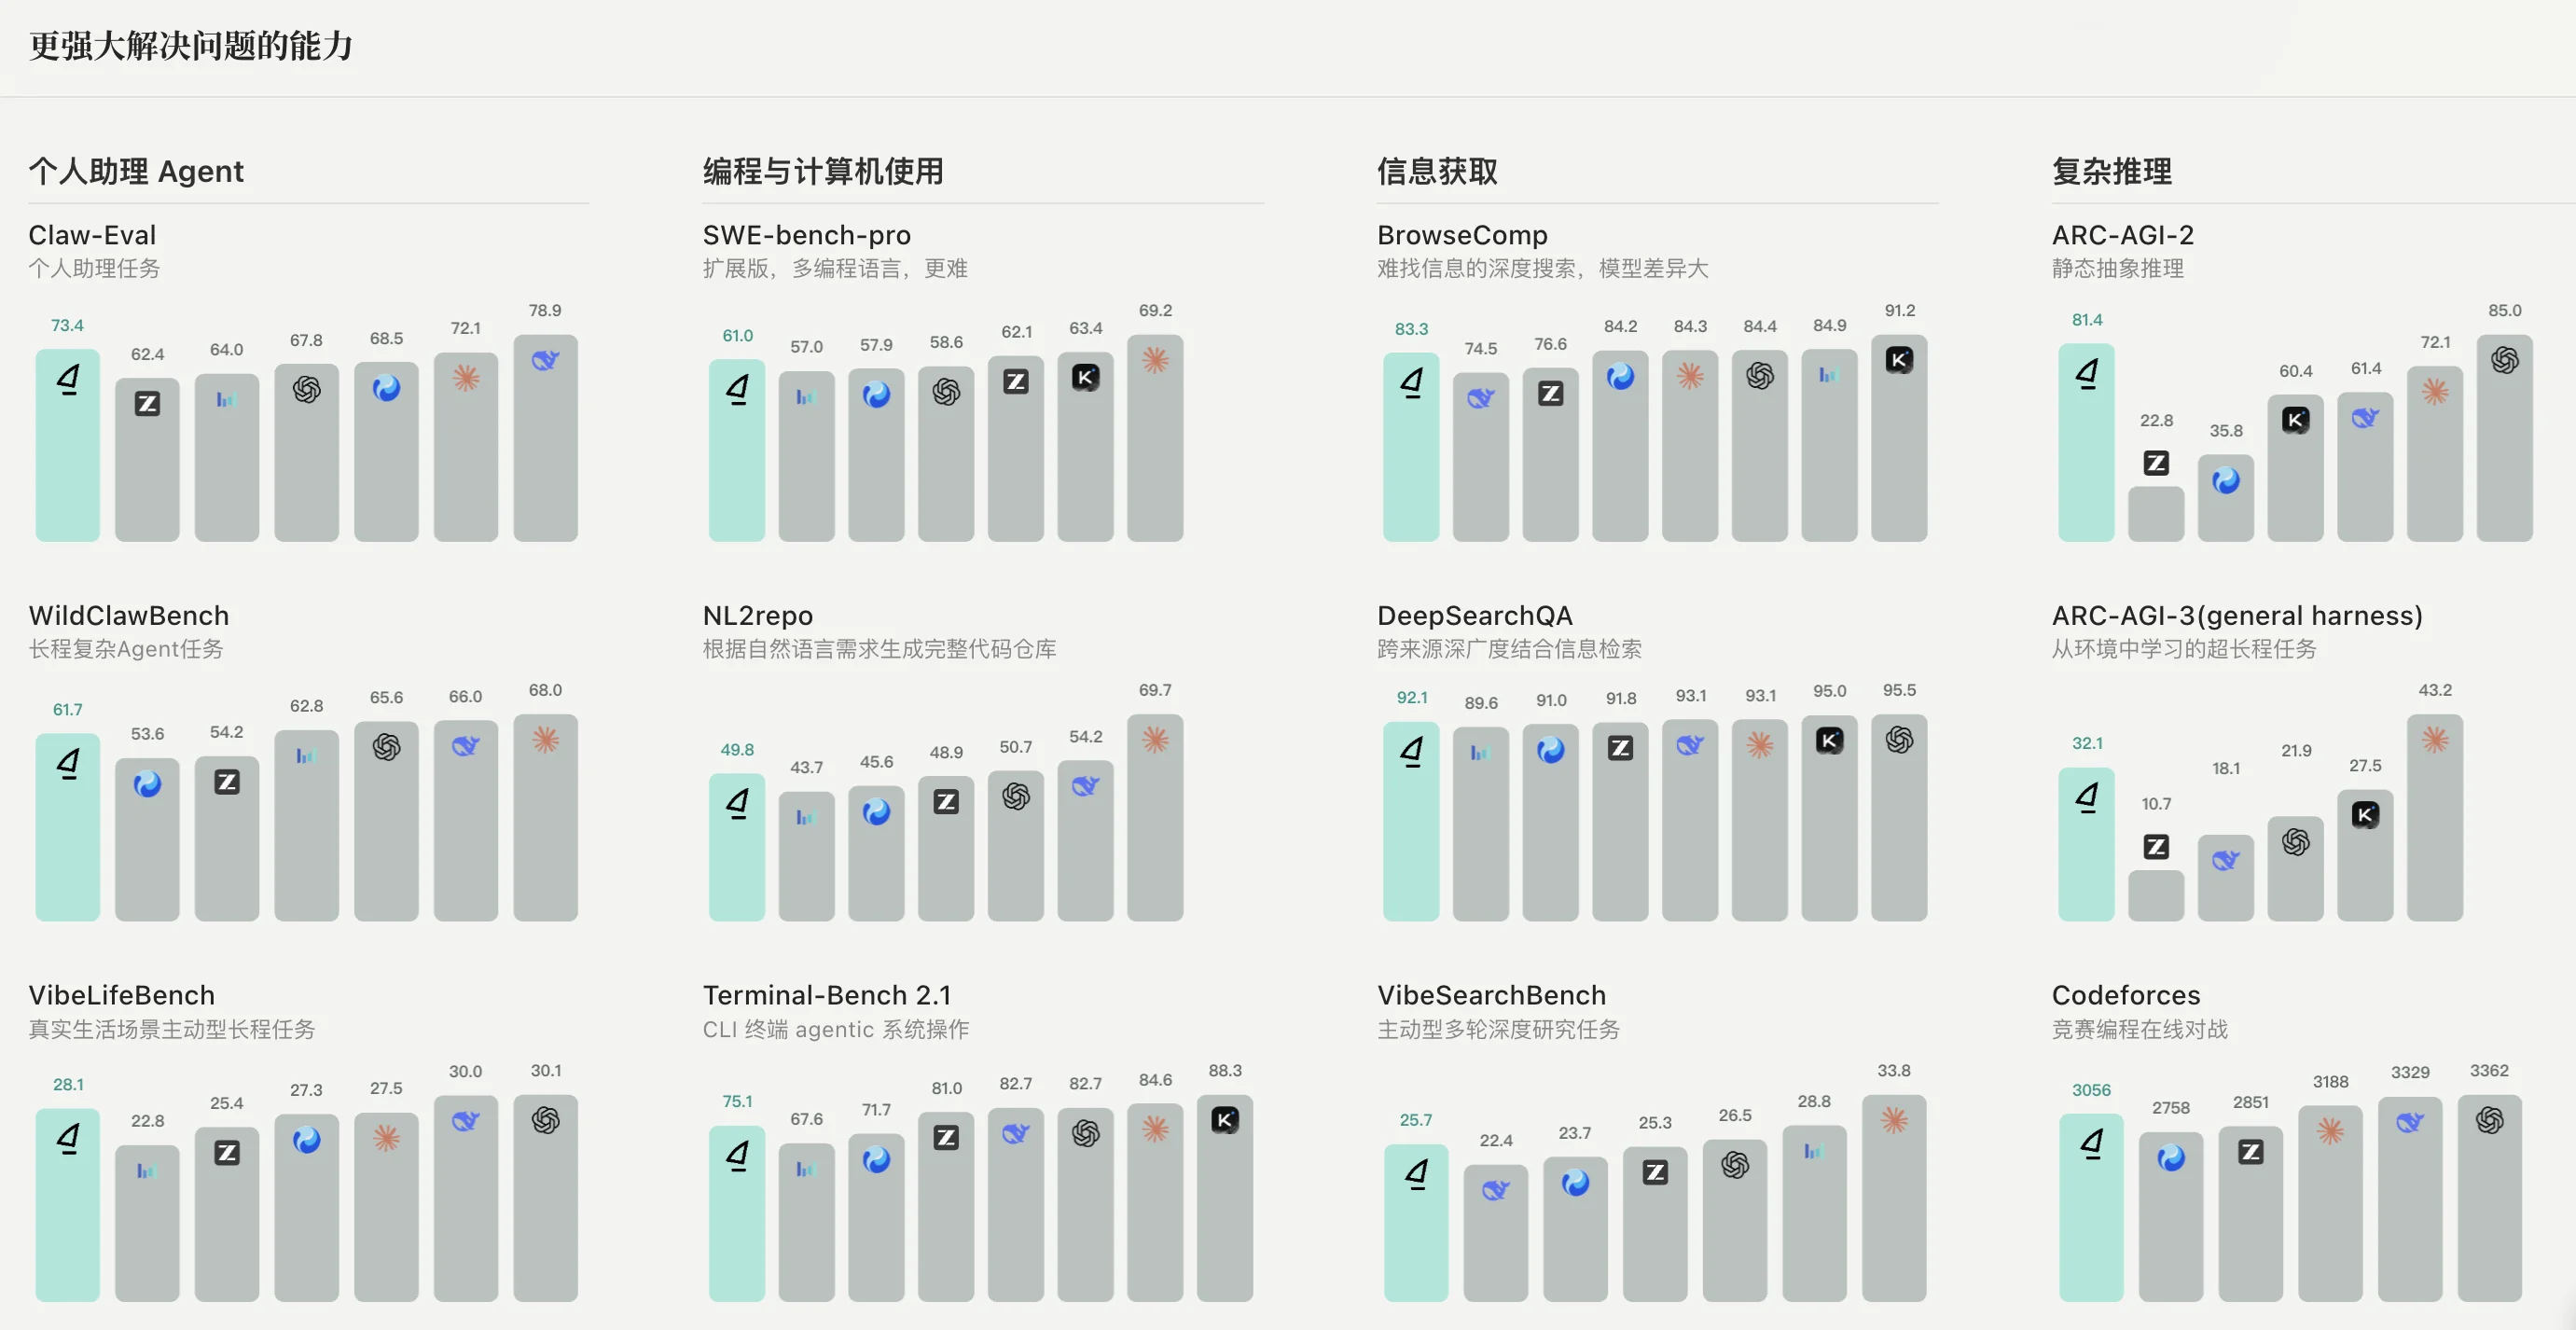
图 2,官方公开的推理与智能体评测,绿色柱为 dots3-note Preview。
但这些数字目前主要来自官方模型卡。完整技术报告仍标着「即将发布」,部分表格里的星号也代表团队自己的测试,不是所有结果都来自公共榜单。模型开源让复现成为可能,不等于复现已经发生。把官方成绩当成值得验证的起点,比当成盖章结论更稳。
工程支持也处在典型的发布首日状态。
vLLM 的 main 分支已经原生支持,稳定版还要等后续发布。Transformers 的支持 PR 与 SGLang 的支持 PR 仍在审核。官方建议优先用专门的 SGLang 镜像,音视频还要配 torchcodec 和 FFmpeg。你当然能今天就跑,前提是愿意接受 nightly build、指定 PR 版本和容器镜像这些新模型开荒套餐。
这事儿我觉得很正常。开放权重的第一天,权重往往比生态先到站。真要上生产,除了看模型会不会答题,还得看服务框架能不能稳定做张量并行和专家并行,看监控能不能拆出预填充与解码耗时,看自动工具调用的 parser 会不会在边界格式上翻车。
官方给了一个挺有意思的优化,MTP(Multi-Token Prediction,多 token 预测)投机解码,能把 TPOT(Time Per Output Token,每个输出 token 的耗时)降低 50% 以上。这个数字很亮眼,不过文档同时写着预填充阶段暂不支持 CUDA Graph。也就是说,长输入的首包延迟与连续输出的速度是两道题,优化了后者,不代表前者一起消失。
我寻思了一下,这反而是 dots3-note 最值得看的地方。它没有假装一个开源权重文件等于一套成熟产品,模型卡把未合并的 PR、推荐镜像、8 卡配置和上下文折中都摆在了台面上。发布页很热闹,部署页很清醒。
谁现在适合上车
如果你有 8 卡 H100 或同级节点,正在做长程 Agent、多模态文档理解、代码仓库级任务,dots3-note 很值得进入评测池。Apache 2.0 许可也够友好,团队可以把权重、服务框架和自己的工具链放在同一个实验里,认真量 TTFT(Time To First Token,首 token 延迟)、TPOT、峰值显存、并发吞吐和任务成功率。
如果你只有一两张消费级显卡,想把它当成一个 16B 本地模型,现在先别急。等社区做出更激进的量化、CPU 或 NVMe 分层卸载、稳定的 llama.cpp 或 MLX 路线,再看速度是否落进可用区间。能启动和能工作不是一回事,能工作和能稳定跑长任务,又隔着一层看门狗、重试预算与上下文清理。
如果你只需要调用能力,不执着于持有权重,等可靠的托管 API 往往更划算。280B 权重常驻的机器成本很硬,低并发团队自己养卡,利用率很容易难看。把任务成功率、延迟和月度总成本一起算,别只盯每百万 token 的牌价。
给准备评测的团队,我更建议从 32K 或 64K 上下文起步,先跑自己的真实任务集。记录每一步工具调用、失败原因、重试次数与最终成功率,再逐级把窗口拉长。要是从 64K 到 256K 只多装了几百页日志,却没有提高任务完成率,那部分上下文就是昂贵的电子阁楼。
dots3-note 的 16B 激活参数很重要。它让 280B 规模的 MoE 在每一步不用付出 280B 稠密模型同等的计算代价,也让多模态和长程任务有了更现实的吞吐可能。
只是屏幕前的你,在看到「16B」时最好把手从下载按钮上挪开半秒。
模型每次叫 8 位专家来干活,机房却得给整所医院留位置。这个反差,才是 dots3-note 发布里最该被记住的数字。