posts/envharness-adaptive-agent-environments.md
Agent 练不出来,先别急着换模型
一个已经学会开门的 Agent,还在训练场里开同一扇门。
开一遍,成功。
再开一遍,还是成功。
排行榜看着挺绿,Agent 也很配合。可你把它放进另一间屋子,门把手换个方向,旁边多一张会挡住视线的椅子,它又开始对着墙点鼠标。
这画面有点荒诞,但很多 Agent 训练就是这么干的。模型在进步,环境却停在发布那天,反复给同一套状态、动作和反馈。大家看到成功率不涨,习惯性动作是换模型、加 prompt、补 skill、扩大 rollout。
Google Research 刚开源的 EnvHarness 往另一个方向拧了一把。
它没改模型权重,也没重写底层环境,而是在环境的接口外包一层可编程组件,让训练场追着 Agent 的弱点变化。官方结果里,ALFWorld 分布外任务最高多了 9.0 个百分点,SWE-bench Verified 的平均执行步骤少了 5.40 步,汇总下来大约少走 9.8% 的步骤。
好家伙,模型没动,考场动了。
我觉得这篇论文最有意思的地方,不是又发明了一个带 Harness 的名字。它把一个常被忽略的问题摆到了桌面上。
Agent 练不出来,可能不只是模型不会,也可能是环境已经教不会了。
模型会变,训练场不会
聊天模型主要从文本里学。Agent 不一样,它还要在浏览器、代码仓库、办公软件和模拟器里反复行动。
每一步都在回答四个问题。现在是什么状态,能做哪些动作,动作之后看见什么,做到什么程度才算成功。
这四件事拼起来,才是 Agent 真正面对的世界。
很多公开基准为了可复现,会把这个世界冻住。任务集固定,初始状态固定,动作接口固定,成功条件也固定。这样评测不同模型很方便,同一份测试跑十遍,至少考场没有半夜换卷子。
可一旦它被拿来训练,静态就开始变成代价。
Agent 早就学会某类简单任务,环境仍会继续生成它。Agent 总在长链路的第 27 步丢状态,环境也不会多给几组专门打这个弱点的变体。训练预算花出去了,新的信息量却越来越少。
你想想看,一个后端服务的超时只在并发升高时出现,我们不会拿单请求压一万遍,然后宣布系统已经稳定。可 Agent 训练很容易落进同一个坑,用更多相似轨迹假装覆盖率在增长。
EnvHarness 论文给出的办法,是把 Agent harness 的思路搬到环境这一边。Harness 第一次出现时可以理解成脚手架,模型本身不动,外面那层负责工具、记忆、权限和调度。EnvHarness 也不动底层环境,只在标准的 reset 和 step 接口之间加一层。
reset 决定一局从哪里开始,step 接住 Agent 的动作,再返回新的观察和状态。
只要守住这两个接口,外层就能改起点、限制动作、调整观察,甚至把另一段任务接进来。底层代码不用跟着每种 Agent 重写。
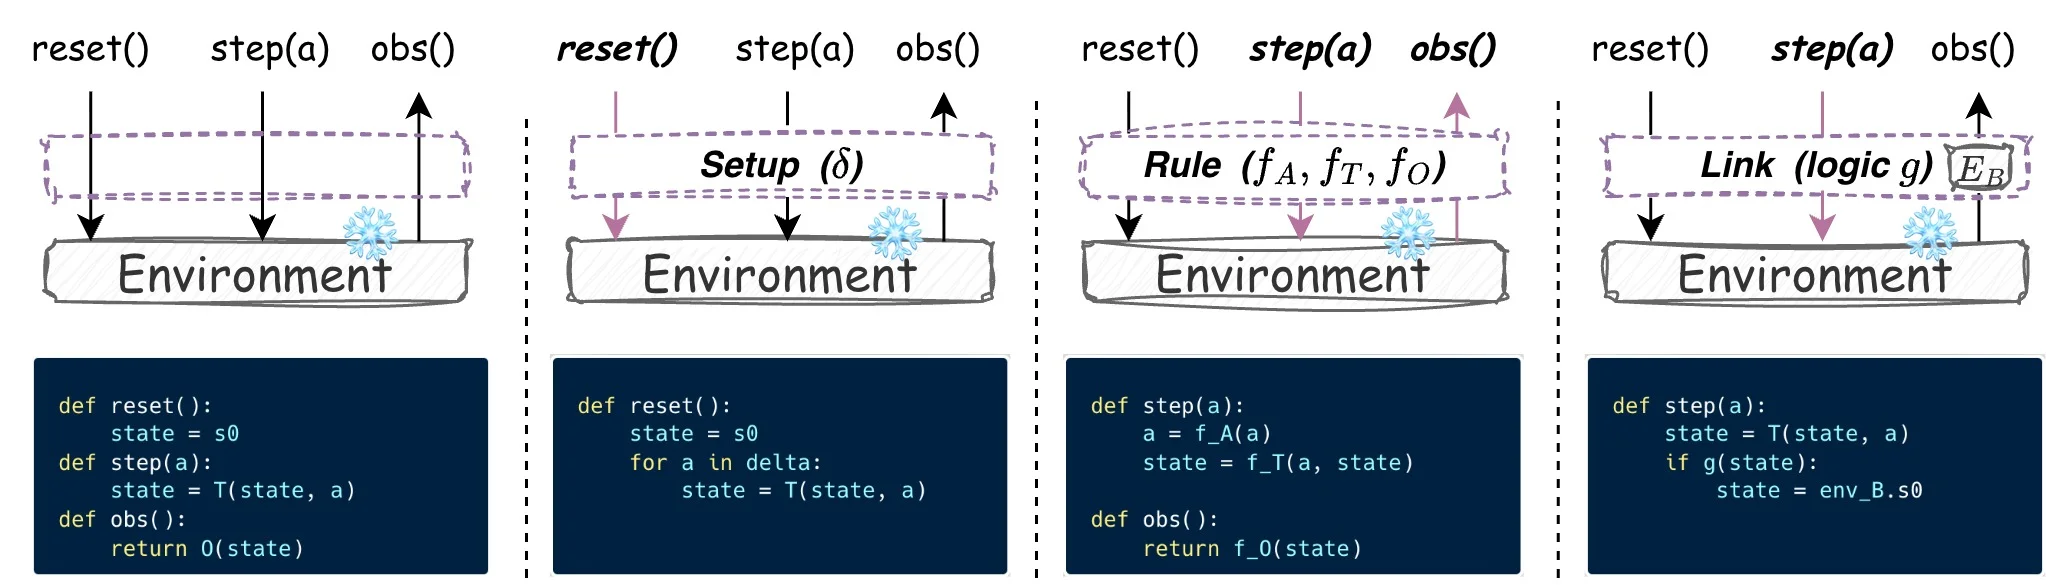
官方结构图里,三类组件只拦截标准接口,底层环境与成功判定保持冻结。
这手设计有点子牛逼。
它不是凭空再造一个模拟世界,而是承认已经有人花了很多时间做出可信环境,然后只改最容易产生训练信号的交互边界。
三层组件,真正值钱的是没动的那一层
EnvHarness 把变化拆成三种组件。
Setup 改初始状态。它可以在每次重置后重放一段固定动作,把 Agent 直接送到更值得练的位置。一个浏览器 Agent 总在结算页翻车,就没必要每轮都从首页搜索商品开始。
Rule 改交互规则。它能拦截动作、状态转移和观察结果,让某条捷径暂时失效,或者把一个原本藏得很深的错误暴露出来。官方实现里,设计 Agent 直接生成 Python 的 Rules 子类,不是从几十个开关里拼配置。
Link 把另一个环境的任务串进来。会修代码只是半程,修完还要更新文档、处理 CI、回复 review,任务链一长,状态和责任边界才会露出真问题。
这三种变化听起来都挺猛,但项目真正克制的部分,是它不碰原来的 verifier。
Verifier 就是判卷器。SWE-bench 里通常是测试套件,网页任务里是环境定义的成功条件,表格任务里可能是目标单元格和公式结果。EnvHarness 可以改 Agent 从哪里出发、能看见什么、允许怎么走,最终有没有完成任务,还是交给原来的确定性逻辑判断。
厉害了,这比让另一个 LLM 看一眼轨迹,然后拍脑袋打个 8.7 分靠谱得多。
很多生成式训练环境最难的不是生成页面和任务描述,而是生成一个不会被钻空子的判卷器。奖励写歪一点,Agent 很快就能学会讨好指标。你以为它学会了做事,它只是学会了让分数变绿。
EnvHarness 留住原 verifier,相当于允许训练场重新摆桌椅,但终点线不能偷偷挪。
不过这里别读过头。
判卷器没变,不等于新卷子一定有教学价值。
一段自动生成的 Rule 仍可能把任务改得太简单、太怪,或者只针对当前 Agent 的偶然失误。代码能编译,测试能跑,也不能证明这个环境变化值得拿来训练。
因此项目还做了 EnvRigger。它把目标 Agent 当成黑盒,先看执行轨迹,诊断某个具体弱点,再写 EnvHarness 组件。生成的 Python 会放进隔离子进程里编译和执行,坏代码变成一条失败记录,不把整次实验拖死。新环境还要跑新一轮 rollout,确认它真的提供了有效信号。
整个过程更像动态出题老师。不是看到学生错了就把答案塞进提示词,而是找出他总在哪类条件下犯错,再出一道能复现这个弱点、又有老判卷器兜底的新题。
坦率讲,这个分寸比组件名字更值得学。
最高多拿 9 分,先看数字后面的小字
官方在五个基准上做了实验,覆盖具身任务、网页操作、软件工程、办公问答和电子表格。用 EnvHarness 环境诱导出的 skill,最终会回到没被改动的原测试环境里验收。
这点很关键。它测的不是 Agent 在定制考场里能不能拿高分,而是定制考场学到的东西,能不能迁回原题和 held-out 任务。
结果最亮的是 ALFWorld。Agent 从原始环境学习 skill,分布外任务是 61.4,换成 EnvHarness 环境后到 70.4,正好高 9.0 个百分点。平均分从 62.4 到 68.3。
WebArena 的平均分从 38.5 到 41.6。Shopping Admin 子集从 44.6 到 50.8,但 GitLab 子集只从 35.4 到 37.7。
SWE-bench Verified 的实验里,成功率从 49.88 到 52.58,平均步骤从 55.01 降到 49.61。OfficeQA 和 SpreadsheetBench 也有提升,只是幅度没有 9 分那么戏剧。
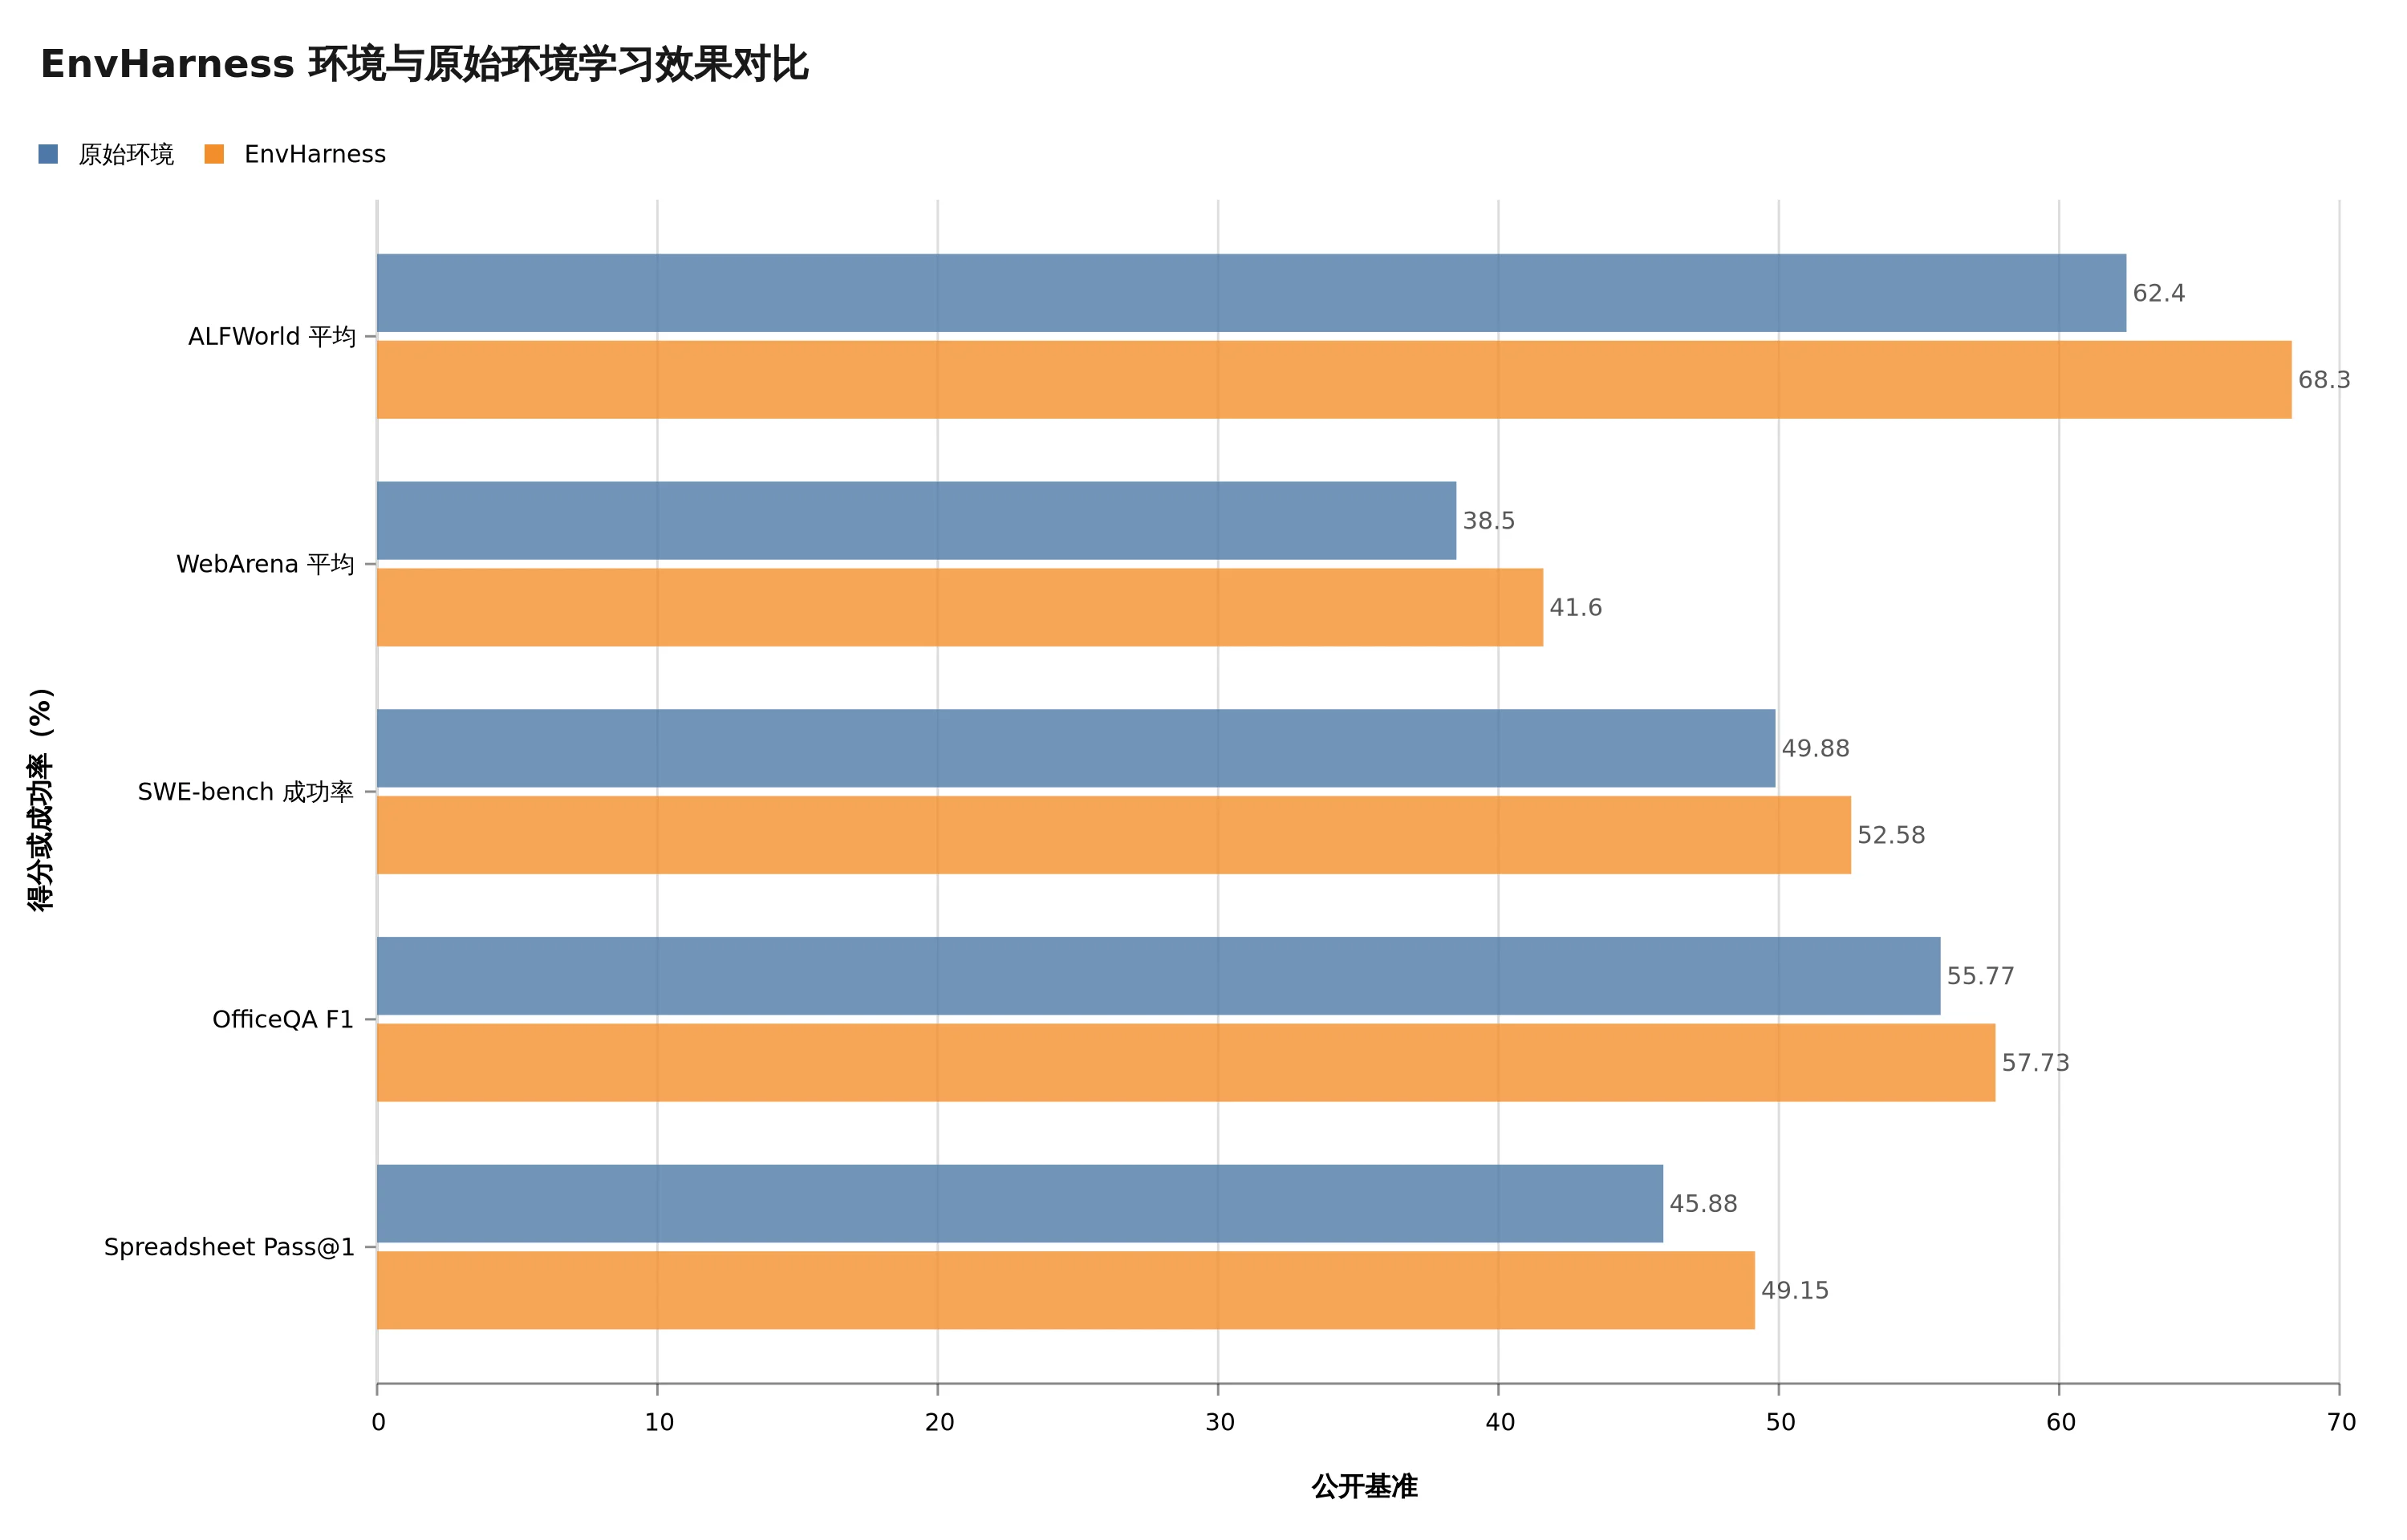
五项指标都来自官方同模型对照,量纲均为得分或成功率,不能跨基准直接比较绝对高低。
所以标题里那个「最高」不能掉。它不是每个环境白送 9 分,更不是给生产 Agent 套个 wrapper 就能立刻涨 9 分。
论文里的对照关系也要看清。所有条件在固定模型下比较,表里的结果由 Gemini 系列模型产生,而仓库当前默认配置已经可以切到别的模型。官方 README 明说,换模型会移动绝对分数,真正要看的,是同一个模型在不同 skill 来源下的差异。
还有个很工程的问题。官方复现说明提醒,并发数跟模型供应商的 token 配额走,不是 CPU 核越多越好。并发开猛了会遇到 429,episode 可能中途被截断,结果表现成成功率异常低,而不是一个醒目的启动错误。
不是哥们,环境还没开始教,压测脚本先把老师限流了。
Skill 检索也依赖固定的 embedding 空间。换供应商可能连向量维度一起换,旧 skill bank 需要重建。否则你看到的下降,可能来自检索库宽度不一致,而不是 EnvHarness 没用。
这些小字没有削弱论文,反倒让它更可信。研究结果最怕只剩一个漂亮平均值,设备、模型、流量和失败口径全掉在传播路上。EnvHarness 的仓库把这些约束摊开了,普通开发者才知道哪些值得抄,哪些只能当研究信号。
生产 Agent 该抄哪一半
很多朋友可能会问,能不能让 EnvRigger 直接盯着线上 Agent,然后自动改生产环境。
我劝你先把手从回车键上拿开。
论文依赖一个很强的前提,环境可以重置,状态可以恢复,成功条件可以重复执行。ALFWorld 能重新开一局,SWE-bench 能重建容器,网页基准也有受控账号和任务快照。
真实付款、删除数据、发外部消息和操作物理设备不一样。钱转出去没有 reset(),客户收到邮件也不能当作 rollout 没发生。让另一个 Agent 自动改线上动作规则,等于把出题权和生产权限绑在了一起,风险比普通 prompt 漂移大得多。
因此,生产系统真正该抄的不是「让环境在线自我改写」,而是「让失败轨迹反过来改测试环境」。
一条 Agent 轨迹失败后,先把它归因到环境合同。它究竟看不见关键状态,动作空间缺了能力,工具返回不稳定,还是成功判定太粗。别急着在 system prompt 末尾补一句「请务必注意」。
如果是状态问题,就在评测环境里生成不同起点和缺失信息的变体。如果是动作问题,就临时禁掉捷径,看 Agent 能不能走另一条路。如果是长链路问题,就把两个原本分开的任务串起来,专门打状态交接和中途恢复。
这些变化都应该留在隔离环境里,继续用原来的业务断言验收。订单有没有创建,数据库有没有符合约束,CI 有没有通过,文件内容是否满足 schema。能写成代码的判断,别交给模型凭感觉评分。
新增基准的官方接口也很值得抄。环境要明确实现 reset、step、observe、evaluate、save_state 和 from_state。浏览器页面对象、Docker client 这种运行时句柄不能塞进跨进程状态,只保存能重建环境的数据。
这看着像框架细节,实际是一份不错的生产自检。
你的 Agent 环境能不能从任务 ID 重建?一次失败能不能完整回放?成功判定能不能脱离模型独立执行?外部资源有没有明确释放?坏的环境变体会不会被隔离,还是会拖垮整条训练流水线?
这些问题答不出来,先别谈环境和策略一起进化。
说真的,我喜欢 EnvHarness 的地方,是它没有再劝大家换一个更大的模型。它提醒我们,模型每次伸手能摸到什么、摔倒后会收到什么反馈、练习难度会不会跟着增长,同样决定了 Agent 最终学成什么样。
模型是船,harness 是甲板上的绳索、仪表和工具。训练环境则是每天遇到的风和浪。
总在港口里练同一个转弯,再好的船也学不会穿过陌生海峡。
所以 Agent 练不出来,先别急着换模型。
看看那片水,是不是早就不动了。