posts/fable-5-1-agent-cost-migration.md
Fable 5.1 把缓存砍了 75%,却给迁移埋了 3 个雷
Anthropic 这次在价目表上只改了一格。
Claude Fable 5.1 的输入还是每百万 token 10 美元,输出还是 50 美元。缓存写入也没动。真正挨了一刀的是缓存读取,从 1 美元降到 0.25 美元,正好砍掉 75%。
然后官网给了一个更诱人的数字,高度 Agent 化的工作负载,整单成本最多约少 45%。
好家伙,旗舰能力更强,跑几小时的 Agent 还能接近半价,听起来像是把模型 ID 从 claude-fable-5 改成 claude-fable-5-1,账单就会自己瘦下来。
可我把 Anthropic 发布公告、Fable 产品页 和 迁移指南 放在一起看,最扎眼的反而不是跑分。
官方在 模型规格页 上明写了三项 breaking changes。旧 Agent 直接换 ID,轻一点会悄悄丢掉思考块重新规划,重一点当场给你一个 400。更尴尬的是,有些写法还会顺手把刚省下来的缓存钱烧回去。
所以这篇不复读发布通稿。咱们就算两笔账,一笔是长时 Agent 到底能省多少,另一笔是从 Fable 5 迁过去要还多少工程债。
75% 只落在一格价目表上
先把 prompt caching 讲成人话。
一个 Agent 跑久了,每一轮请求都会带上大量相同前缀。系统提示、工具定义、仓库说明、前几轮对话和已经读过的文件,模型并不是只看一次。下一轮继续干活时,它还得把这些旧上下文重新接回来。
如果这些内容命中缓存,计费就不再按普通输入价走,而是走 cache read,也就是缓存读取价。长任务越久,同一段前缀被反复读取的次数越多,这一栏在账单里就越显眼。
官方价格表 里,Fable 5.1 每百万 token 的几项价格是这样的。
- 普通输入 10 美元
- 5 分钟缓存写入 12.5 美元
- 1 小时缓存写入 20 美元
- 缓存读取 0.25 美元
- 输出 50 美元
跟 Fable 5 比,前后四项都没变,只有缓存读取从 1 美元变成 0.25 美元。
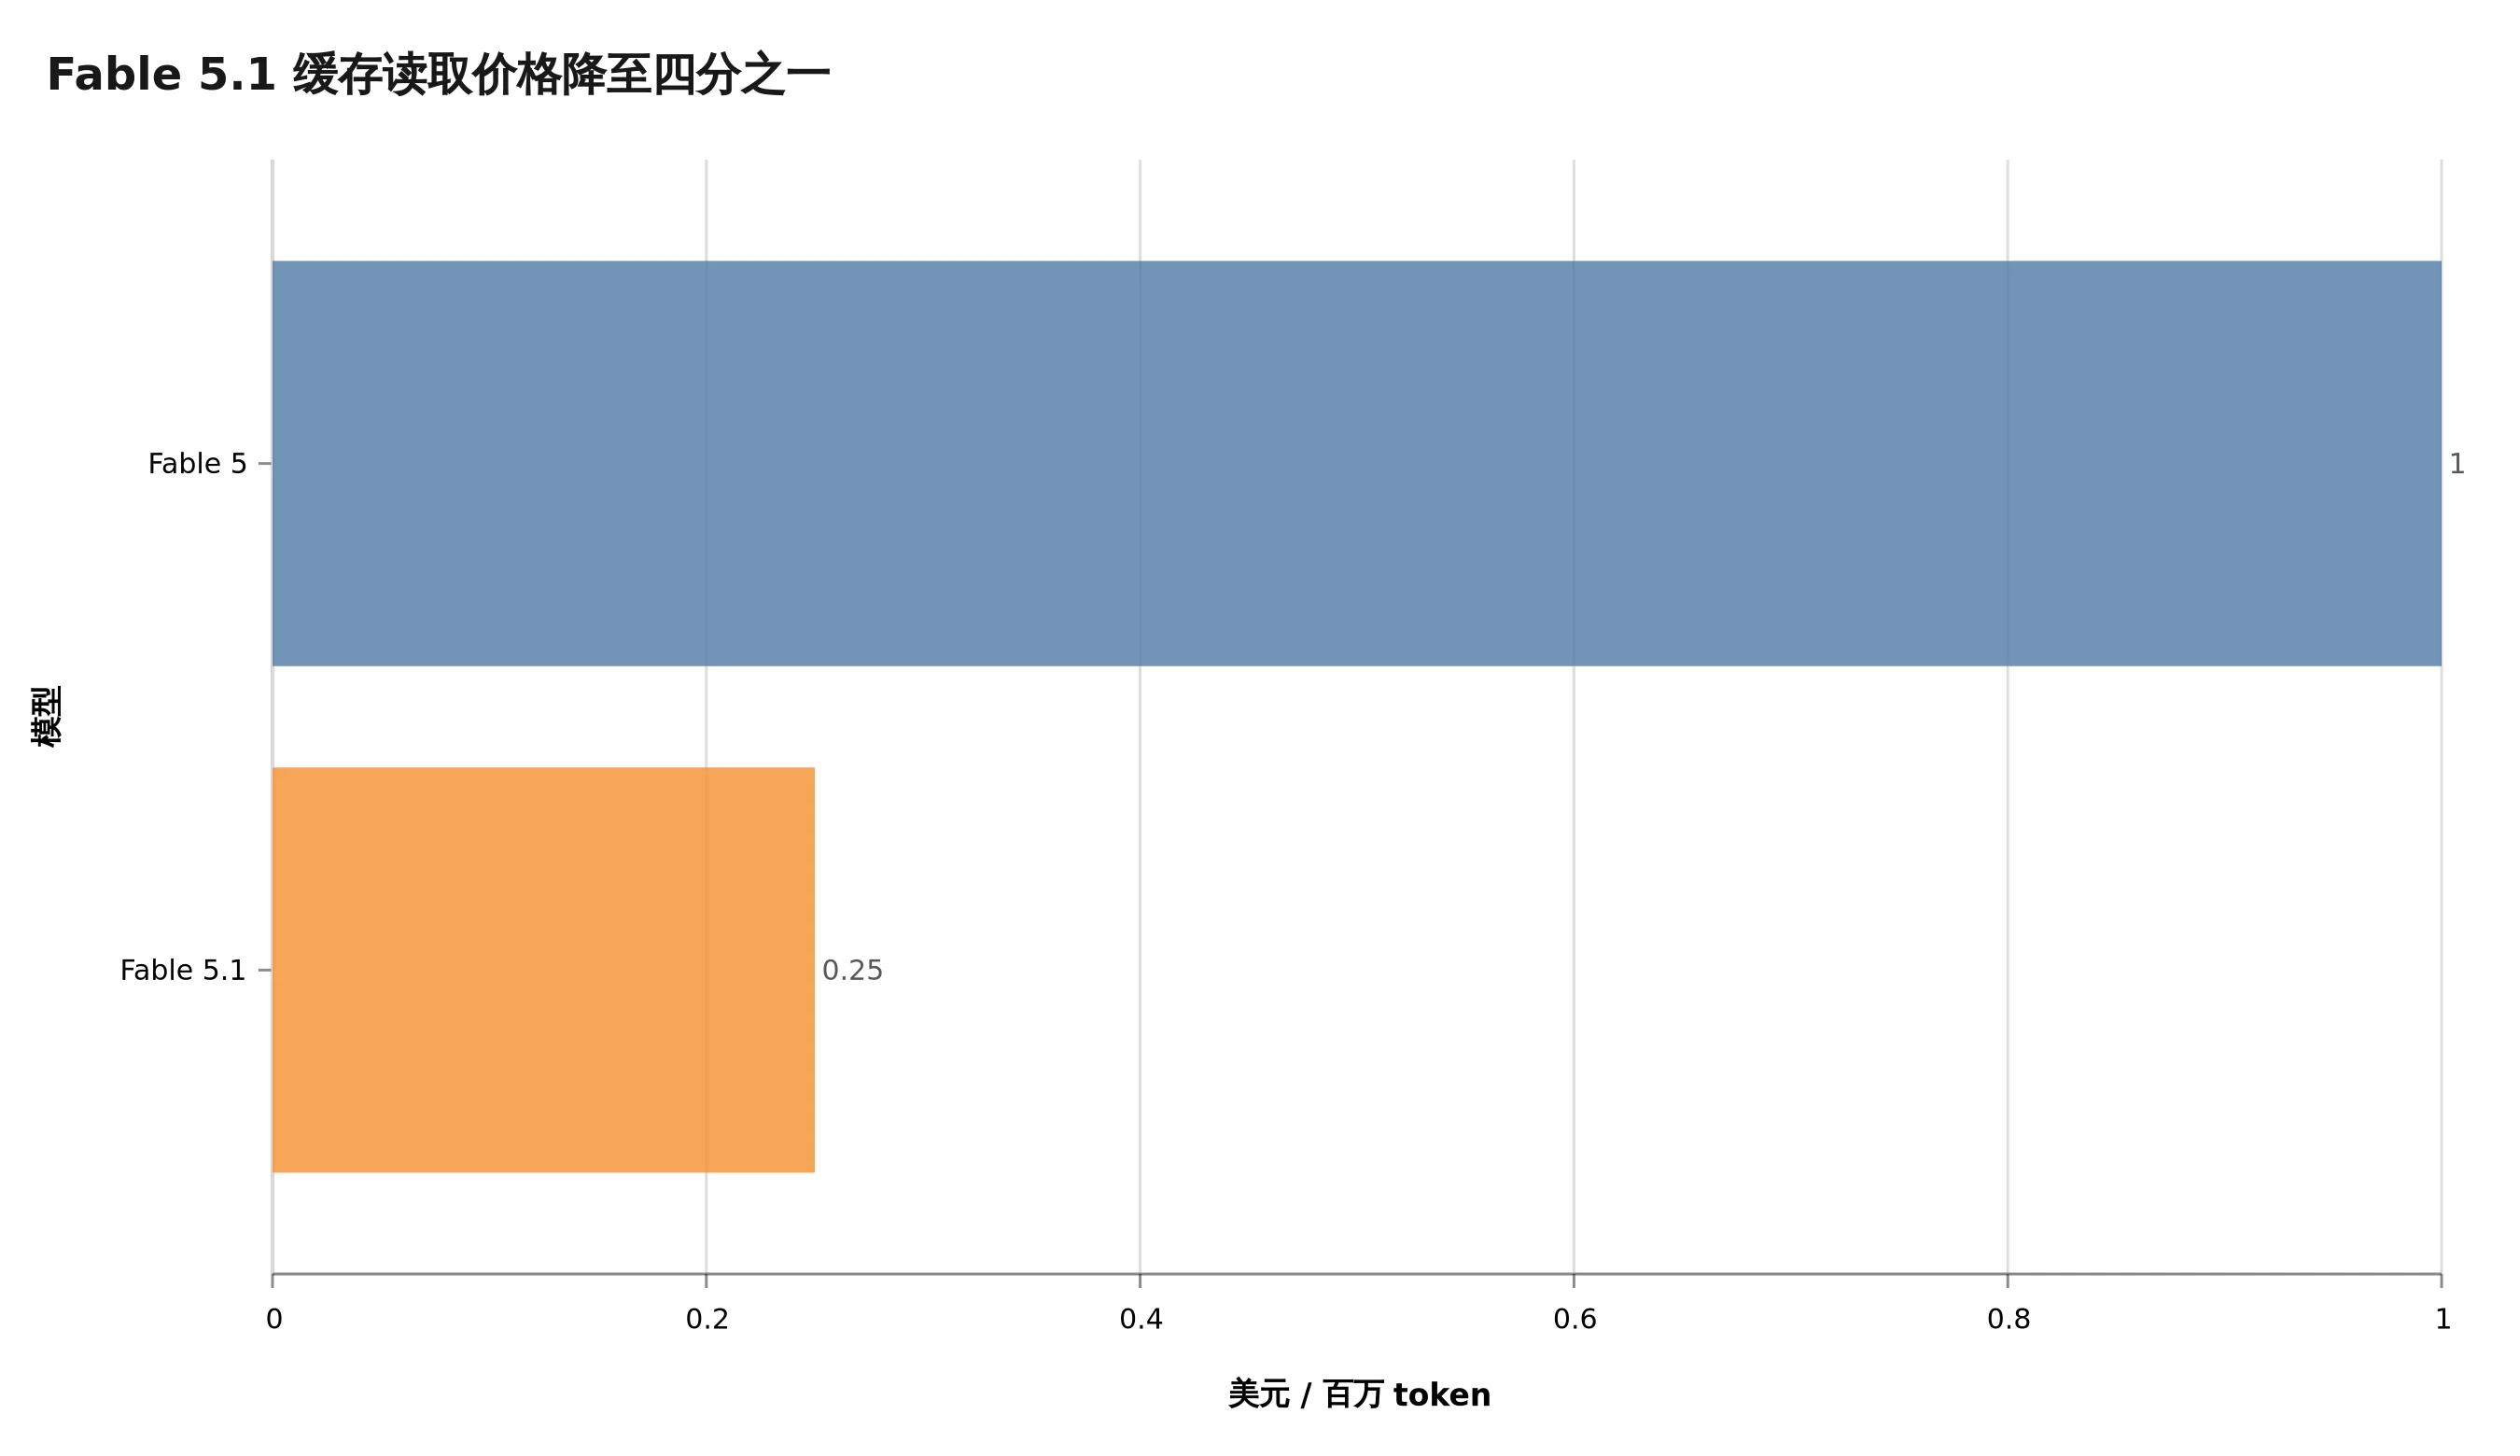
这刀为什么专门砍在缓存读取上,其实挺好理解。普通聊天来回几轮,缓存命中量未必大。可编码 Agent 一跑就是几十轮,工具 schema 和长对话前缀会一遍遍回来报到。Anthropic 想让 Fable 这种最贵的档位真正进入长任务,最该降的不是首轮输入,而是反复回看的成本。
拿一个明确标成假设的算例。
假设 Agent 有 20 万 token 的稳定前缀,接下来 100 轮都命中缓存。缓存读取总量就是 2000 万 token。按 Fable 5 的旧价,这一项要 20 美元。换成 Fable 5.1,只要 5 美元,省 15 美元。
厉害了,单看这一栏确实是 75%。
但整单不会只剩这一栏。首次缓存写入还在,没命中的新输入还在,模型生成的文字、代码和工具参数按每百万 token 50 美元收,搜索、重试和多出来的轮次也不会凭空消失。
官方自己的口径很克制,按 token 计费的典型负载,整单估计少约 25%;高度 Agent 化、上下文很重的负载,最多约少 45%。这里有两个词不能偷懒,一个是「估计」,一个是「最多」。
如果你的 cache_read_input_tokens 本来只占账单一小截,别指望 75% 会平移到总价。如果 Agent 每轮都改 system prompt、刷新工具数组、重写历史,缓存根本暖不起来,降价跟你关系更小。
真正该看的不是宣传页上的折扣,而是你自己日志里的四个数,普通输入、缓存写入、缓存读取和输出。再加上任务成功率,才是一笔完整的账。
跑分领先,长任务的账却不能只看跑分
能力这边,Fable 5.1 的提升不是挤牙膏。
Anthropic 的官宣表格里,Terminal-Bench-Science 0.1 从 Fable 5 的 24.7% 涨到 52.6%,Terminal-Bench 4.0 从 42.0% 涨到 55.8%,AutomationBench 从 17.1% 涨到 31.4%,CursorBench 3.2.0 从 70.5% 涨到 73.4%。表格里同时列出的 Opus 5 和 GPT-5.6 Sol,在这四项上也都低于 Fable 5.1。
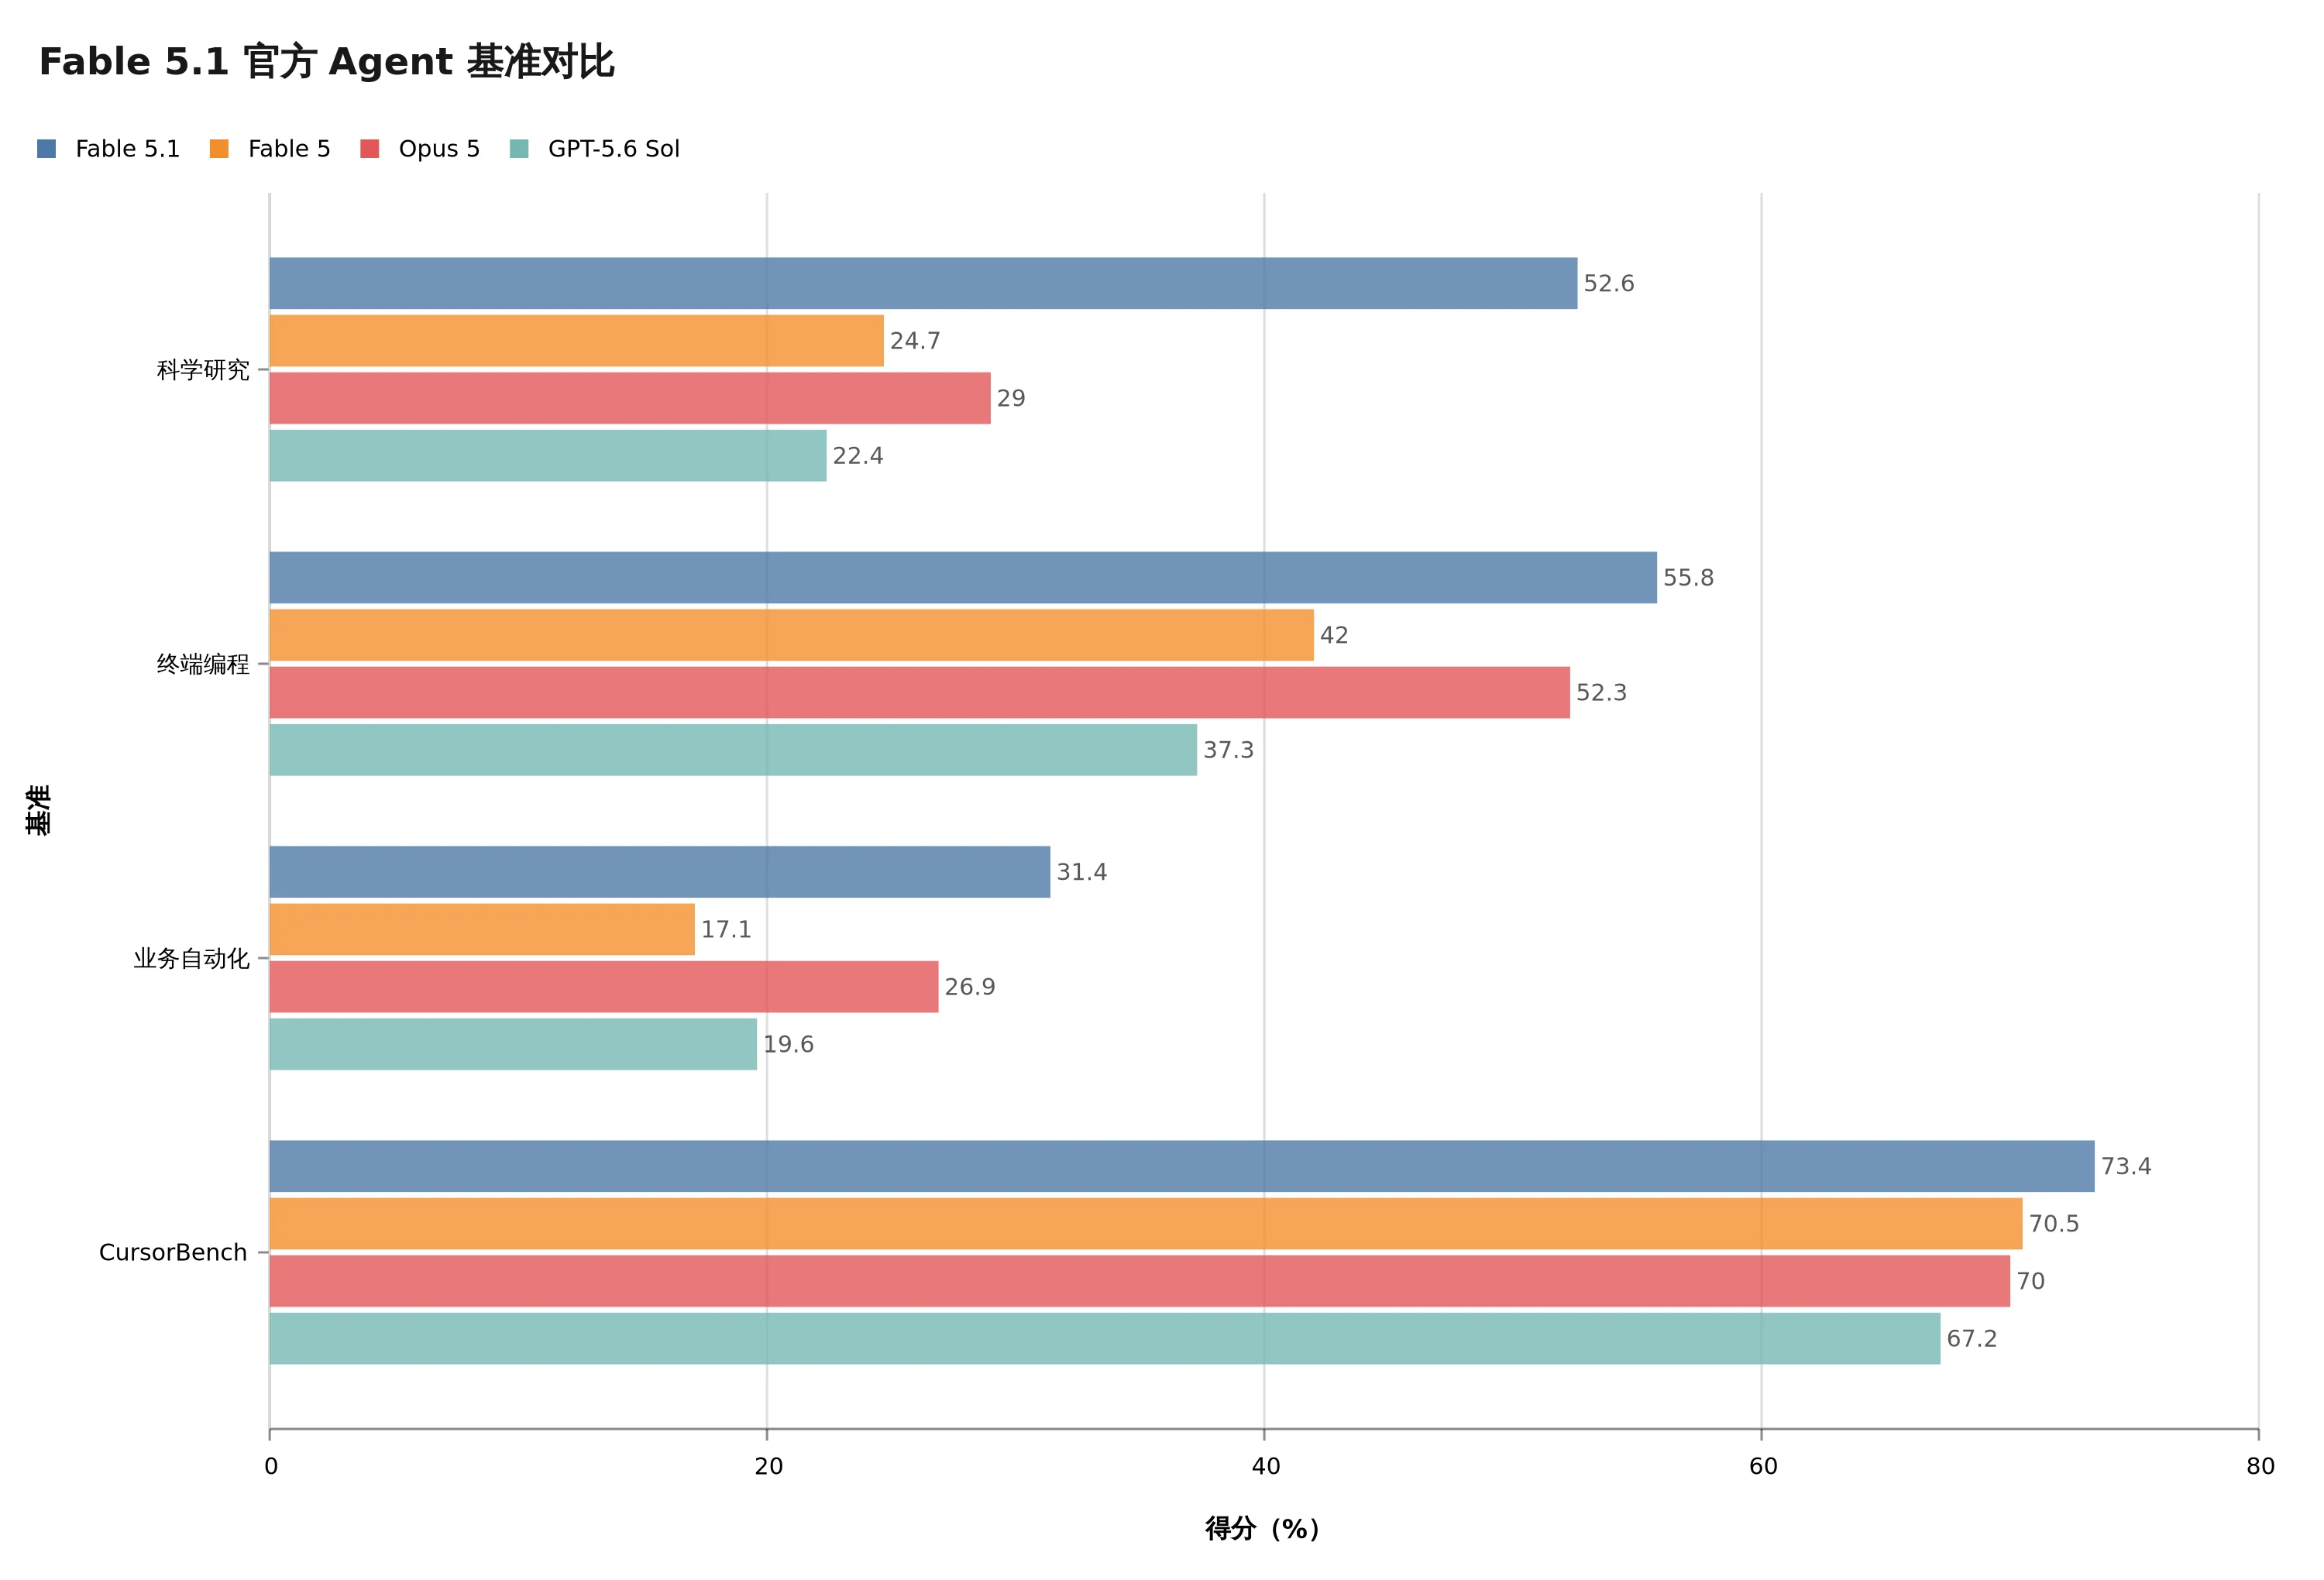
这张图能支持「官方表格领先」,却不能自动推出「所有生产任务都第一」。这些是 Anthropic 自己公布的评测,Terminal-Bench-Science 单模型还有正负 3.5 到 4.5 个百分点的标准误差。安全防护介入也会影响部分基准。严谨一点,跑分是值得试的信号,不是替你签字的验收单。
更有意思的是 effort,也就是让模型在一条请求上投入多少推理力度。
Anthropic 在 Fable 5.1 提示指南 里说,medium 大致能用更低成本追平 Fable 5,low 在一些任务上能跟更小模型的高 effort 竞争。能力增幅在 xhigh 和 max 最大,可延迟和思考 token 也会一起上去。
这下就有意思了。Fable 5.1 的省钱不是一个开关,而是两个旋钮。
一个旋钮是缓存命中率,决定旧上下文能不能按 0.25 美元读。另一个是 effort,决定每轮愿意花多少推理和等待时间。两个旋钮一起调,才有机会把更高成功率和更低单任务成本同时拿到。
反过来,盯着每百万 token 单价选模型,很容易选错。真正跑 Agent 时,贵模型一次做对,可能比便宜模型重试三次更省;也可能因为输出太长、工具调用串行化,单价没变却把墙钟时间拉爆。
我一直觉得,Agent 成本最容易骗人的地方就在这里。发票按 token 开,业务却按任务交付。你该比较的是「一个通过验收的任务花了多少钱」,不是「某个 token 便宜了几毛」。
三个雷,都埋在旧集成的习惯里
Fable 5.1 的迁移文档写得相当直白,三项破坏性变化不是小字备注。它们共同指向一件事,Anthropic 开始要求长对话的历史更稳定,工具调用更少依赖强制开关,思考块也不再是一段能随便搬来搬去的普通文本。
强制工具调用会直接吃 400
Fable 5 支持把 tool_choice 设成 any,或者指定某一个 tool。很多 Agent 框架靠这招保证当前轮一定进工具,不许模型只回一段文字。
到了 Fable 5.1,这两种写法都会返回 400 invalid_request_error。auto 和 none 还能用,强制指定不行。
旧写法大概长这样。
tool_choice={"type": "tool", "name": "record_summary"}官方给的替代方向,是把 tool_choice 留在 auto,在当轮指令里明确要求调用哪个工具,再把工具设成 strict: true 保证参数符合 schema。只是为了拿结构化 JSON 的场景,可以直接用 JSON outputs。
record_summary_tool = {
    "name": "record_summary",
    "strict": True,
    "input_schema": {...},
}

tool_choice={"type": "auto"}
若业务规则要求某一轮必须先查工具,Fable 5.1 支持在最新 user turn 后追加一条中途 system message,把本轮要求写进去。重点在「追加」,不要为了改指令重建最前面的 system prompt。后面那个动作,会撞上第三个雷。
思考块只能向新模型单向流动
Fable 5.1 能读取 Fable 5、Opus 5 和更早 Claude 模型生成的 thinking block。把一段旧会话升级到 5.1,先前的推理还能接上。
反方向不行。
除了同能力层的 Mythos 5.1,旧模型读不了 Fable 5.1 的 thinking block。你的路由器若在高峰期切回 Opus 5,或者安全分类器触发 fallback,API 会把目标模型读不了的 block 删除掉,再把请求交过去。
请求通常还能成功,你也不会为被删掉的输入 token 付费。听着挺友好,对吧。
可旧模型看不到前面的推理,只能重新规划。首轮延迟会增加,工具可能重查,输出可能重写。省下的是被删除的那一点输入,补回去的是一轮新的思考和动作。对于跑了几十轮的 Agent,这种「静默成功」有时比报错更难查。
如果系统有模型路由、客户端重试或自动 fallback,迁移测试不能只验证 HTTP 200。还得看切换后的任务轨迹有没有突然重读文件、重复搜索、丢失计划。
改过的历史,会让后续思考块失效
第三个雷最容易炸到自己拼 messages 数组的人。
Fable 5.1 的每个 thinking block 都跟它之前看到的 system、tools 和消息前缀绑定。前缀里的任何一块发生变化,原来的签名就可能失效。
删掉旧 tool result,危险。把中间几轮剪掉,危险。每轮请求前把当前日期写回最前面的 system prompt,危险。动态增删工具数组,还是危险。客户端在后台做好摘要,再把摘要插到旧历史前面,同样会让后面的 thinking block 对不上。
新账号的检查更严格。官方写明,2026 年 8 月 31 日及之后创建的账号默认执行校验,命中时返回 400。老账号目前可能只记录不拦截,但 Anthropic 已经说了,未来模型会普遍执行。
自动重试在这里有个屁用。请求体没变,失效的签名也不会自愈,只会再撞一次墙。
正确方向是把会话做成 append-only,旧前缀保持字节级不变。中途改指令就追加 system message,增删工具走对应的 tool change block,压缩历史优先用服务端 compaction 或 context editing。坚持客户端摘要也可以,但别把旧 thinking block 原样塞到新摘要后面。
官方还给了 prefix_mismatch_behavior,可选 error 或 drop_block。前者适合在 CI 里把历史污染直接打红,后者适合生产环境先丢掉失效思考继续跑。不过别把 drop_block 当免死金牌。每轮都失效一次,缓存也会跟着一轮轮重启,75% 的折扣很快被你自己的历史编辑吃掉。
便宜的缓存,也可能被更多轮次吃回去
除了三项 breaking changes,迁移指南还列了几个不会报错、却会改变成本曲线的行为差异。
Fable 5.1 在长 Agent 循环里可能减少并行工具调用。任务只暗示多个读取互相独立时,它有时一轮只发一个工具。每多一轮,就多一次网络往返、多一段上下文读取,也多一点墙钟时间。
它在工具之间给的进度消息更少。界面依赖这些状态更新的话,要设置 thinking.display 为 updates 或 summarized,并明确要求可读进度。
在 low effort 下,它也更愿意凭记忆回答,搜索和检索调用可能变少。对普通问答,这也许更快。对要求所有结论必须回到数据库或知识库的系统,这就不是省钱,是漏证据。
有点子牛逼的是,Anthropic 连这些细枝末节都写进了迁移指南。它们提醒我们,Agent 账单从来不是一条价格乘一串 token。模型每轮怎么决定、工具是否并行、历史能否命中缓存、fallback 后要不要重做,都会改变单任务成本。
所以别只做一次 happy path。至少跑一段真实的长循环,把下面这些东西按任务记录下来。
cache_creation_input_tokens与cache_read_input_tokens- 普通输入和输出 token
- 工具调用轮次与并行度
- fallback、重试和 400 次数
- 墙钟时间、成功率与验收得分
然后从 high effort 起步,按自己的评测往 medium 和 low 扫。能力敏感的任务再试 xhigh 与 max。不要把 Fable 5 的 effort 配置原封不动搬过来,模型的档位已经重新校准。
真要迁,先把这几处钉死
如果你的 Agent 只是单轮问答,迁移大概率很平静。真正需要提前动手的是有长历史、动态工具、模型路由和客户端压缩的系统。
上线前我会按这个顺序验。
先全局搜索 tool_choice,把 any 和指定 tool 找出来。能改 JSON outputs 的改 JSON outputs,其余换 auto、清晰指令和 strict tools。
再抓几轮真实请求体,比较相邻请求的 system、tools 和共享消息前缀。除了末尾新增的 turn,前面应该完全一致。日期、临时提醒和工具变化都用追加消息表达。
接着故意触发一次模型切换,确认旧模型接手时有没有重新搜索、重复读文件或丢计划。只看成功码不够,得看任务轨迹。
然后跑一次压缩。服务端 compaction 最省心;客户端压缩则检查摘要后有没有携带旧 thinking block。必要时在测试环境把前缀不匹配设成 error,让 CI 替你抓现行。
再测工具并行度。几个独立读取如果被拆成多轮,就加一条明确的 batching instruction,再比较总轮次和总成本。
收尾才是 effort sweep。棒棒的,不是把 max 打开看最高分,而是找出你自己的质量门槛下,哪一档每个通过任务最便宜。
聊回那张只改了一格的价目表。
Fable 5.1 确实让长时 Agent 更值得算账了。缓存读取只剩四分之一,官方评测里的长任务能力又明显上涨。对那些反复读取大代码库、长文档和历史轨迹的系统,这不是小优惠,可能真的把一类以前嫌贵的任务拉回可用区间。
可价格表只改了一格,集成合同却改了三格。
把缓存用好,45% 才可能靠近。把历史改乱、工具串行、fallback 当普通重试,省下来的钱会从另一头溜走。
模型是 5.1 了,Agent 的账本也得跟着升一版。