posts/fable5-biology-guardrail-false-positives.md
Fable 5 护栏误伤太多,也是一场生产事故
85%。
Anthropic 刚把 Claude Fable 5 的生物相关回退压低了约 85%。所谓回退,就是安全分类器觉得一条请求可能越界,于是不让 Fable 5 继续处理,改道给能力较弱的 Opus 5。
在 Anthropic 的官方公告 里,这次更新被写成了一次安全防护精炼。日常健康、检验结果解读和生物教育问题,以后会更少触发降级。高风险的专业请求仍然会被拦住。
数字很好看,但我觉得更值得看的是另一层。
护栏误伤太多,同样是一场生产事故。
它不会让服务器立刻冒烟,却会悄悄换掉模型、改变回答质量,让用户怀疑自己是不是问错了话。更麻烦的是,如果这条路由没有被记录清楚,团队连体验为什么忽然变差都说不出来。
好家伙,安全没出漏洞,产品却先把正常用户赶跑了。
拒绝之外,还有一次看不见的改道
Fable 5 的设计不是简单吐回一句「抱歉,我不能帮你」。按官方描述,它前面还站着一个更小的安全分类器。分类器判断请求是否落入受保护范围,命中后再由路由层把任务交给 Opus 5。
这是一套典型的「分类器加路由器」架构。Claude Platform 的回退文档 也把这个机制写得很直白,客户端可以识别拒绝与回退,API 还提供服务端回退选项。
听起来挺香。前面有人守门,后面有模型兜底,不至于一棍子把所有用户打回去。
可对用户而言,这是一次模型身份切换。同一条对话里,前一句还是 Fable 5,后一句可能已经由 Opus 5 接手。如果回答深度、格式、延迟或成本发生变化,他感受到的往往只是「怎么突然没那么好用了」。
这就是安全回退最容易被低估的地方。
它不只是一次安全判断,还是一次流量调度、质量降级和成本决策。
如果产品完全不告知用户,他会把降级后的表现全算在 Fable 5 头上。如果告知得太粗暴,又会把正常用户吓得以为自己问了危险问题。比较稳妥的做法,是明确提示当前由兼容模型继续处理,同时给出可反馈、可重试的入口,别让一次安全决策顺手把用户的自尊心也路由掉。
Anthropic 在 Fable 5 的发布说明 中就公开了这个取舍。公司希望尽快开放模型在其他领域的能力,于是先用很宽的分类器包住生物领域,再慢慢把良性请求放出来。
不是哥们,这不就是安全版的先全量限流,再一点点放宽吗。
这条路很现实。也很贵。
85% 不是一张免责卡
官方的脚注比头条数字更有意思。
生物相关回退整体减少约 85%,但所有原因造成的总回退量,在不同产品上降幅完全不一样。Claude.ai 约为 67%,Cowork 约为 55%,Claude Code 约为 17%,Claude Platform 只有约 7%。
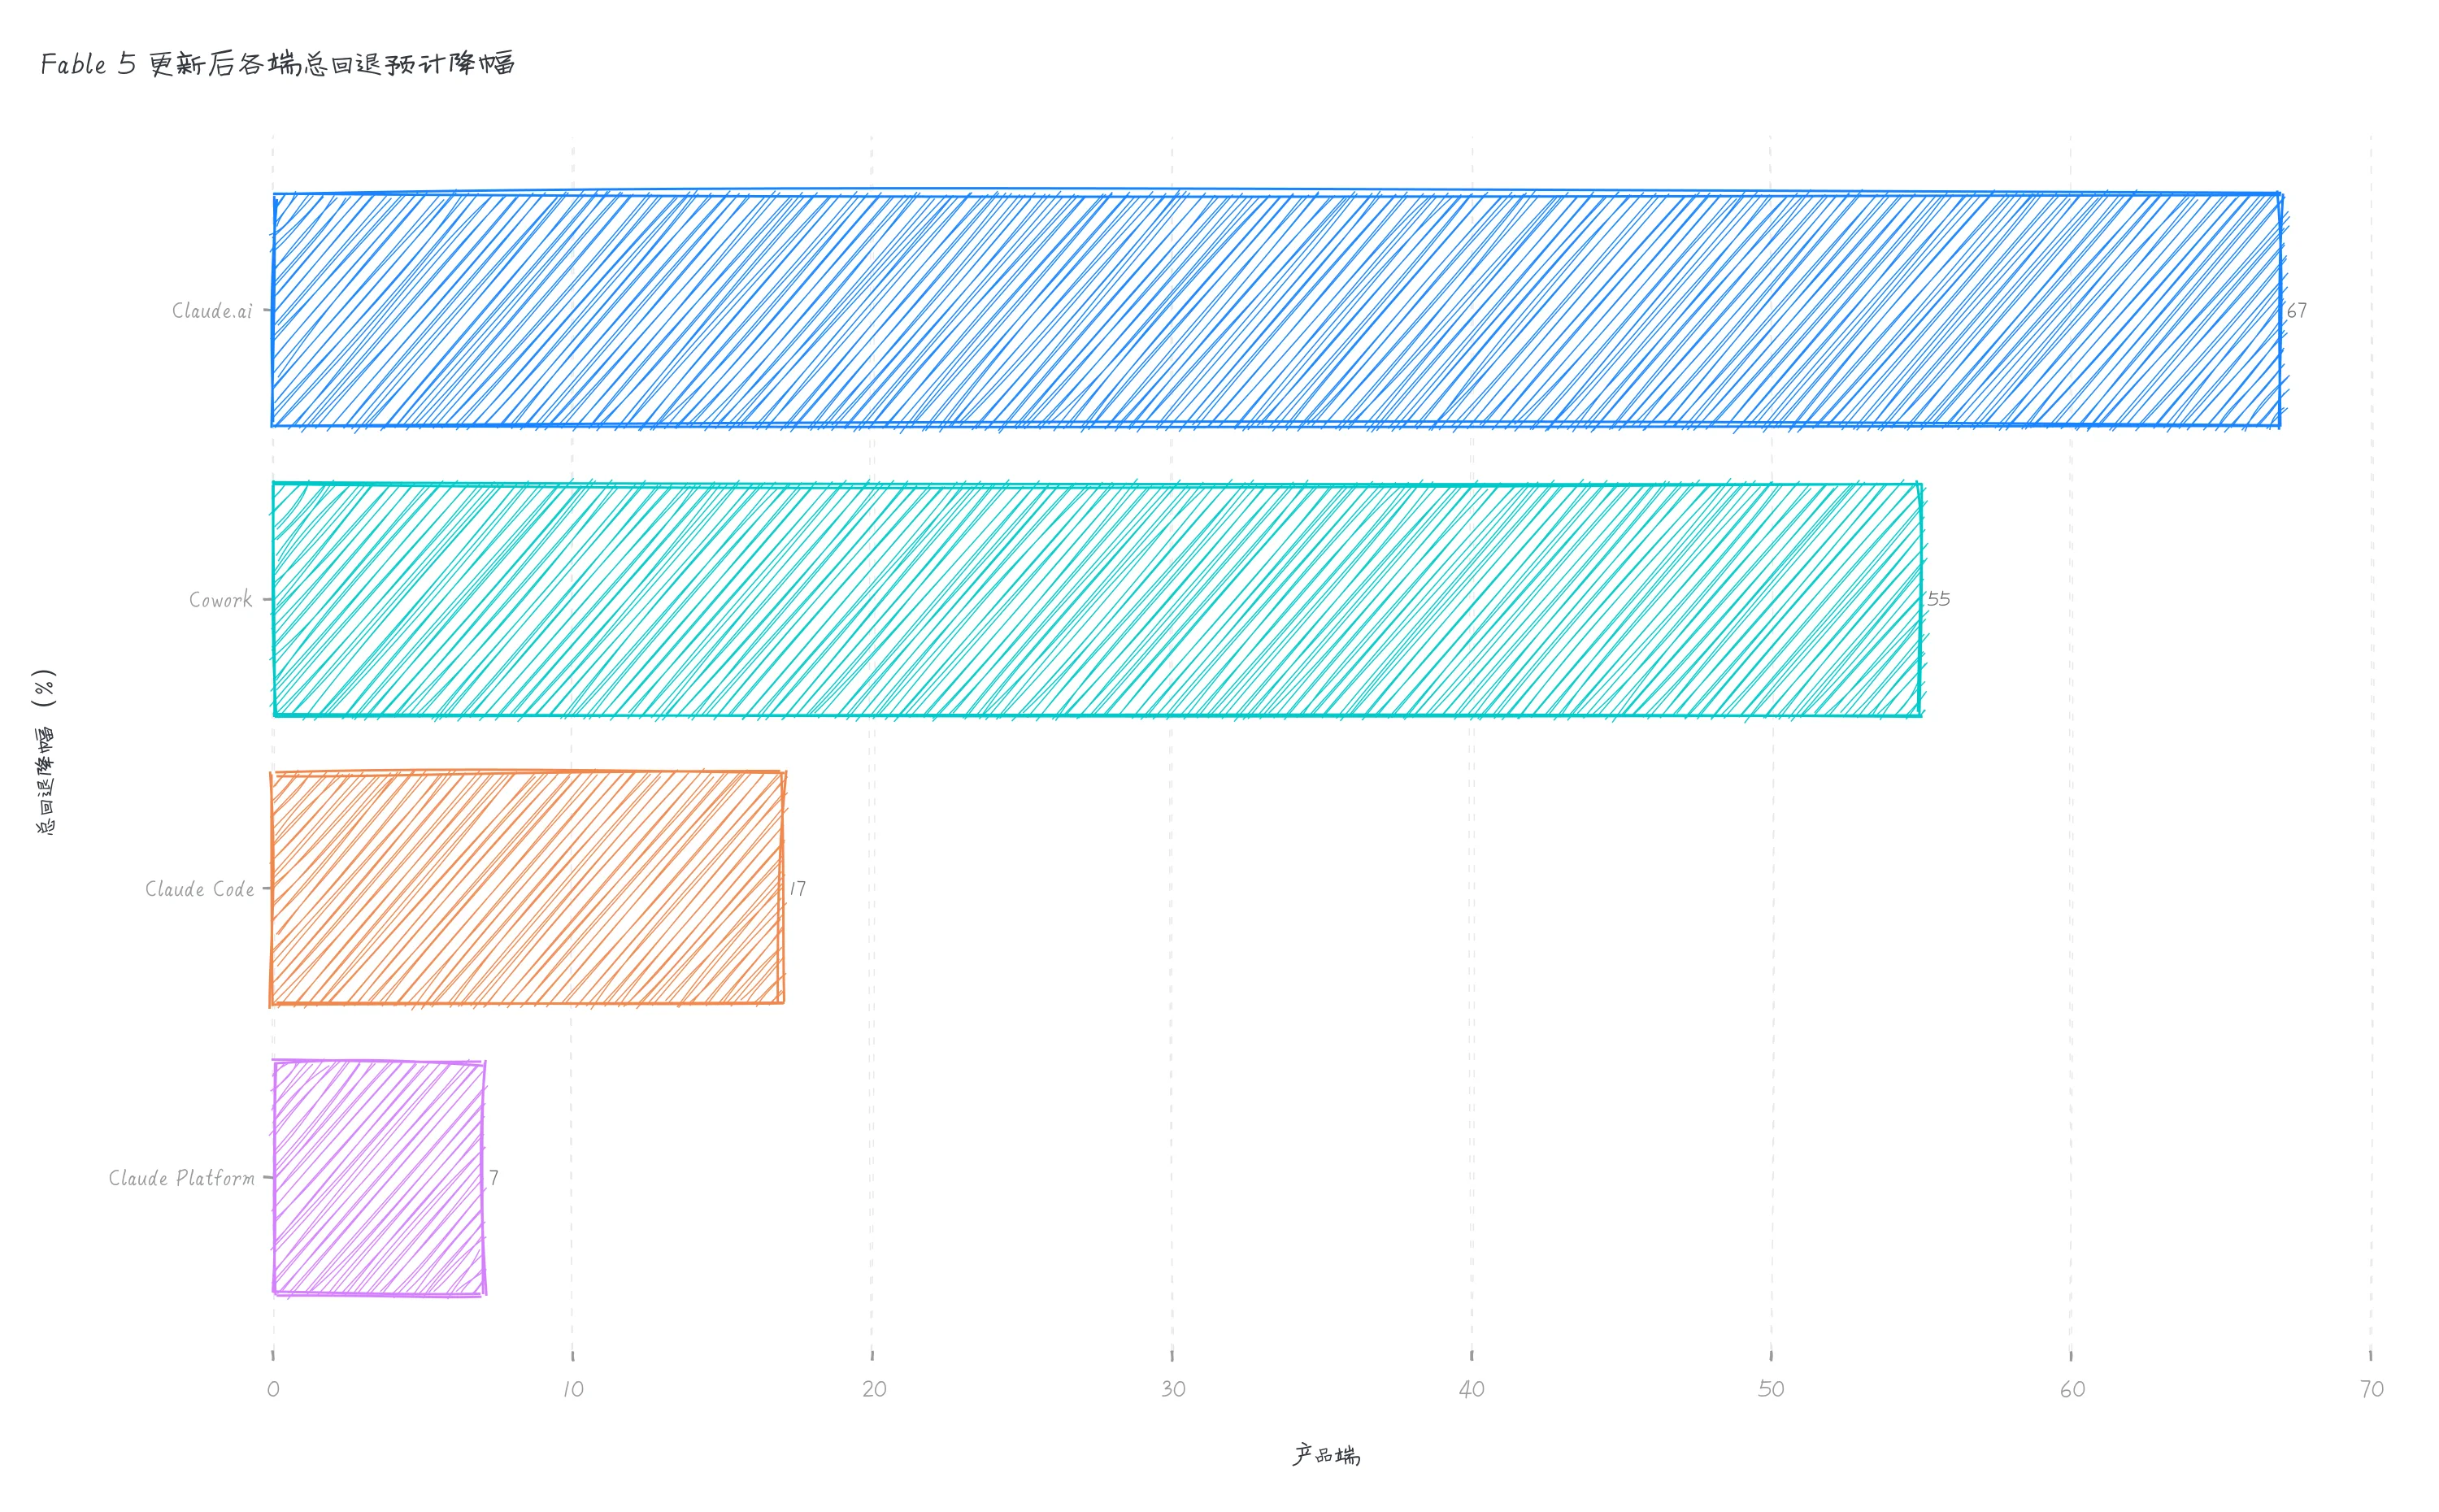
Claude.ai 到 Claude Platform 相差将近十倍,数据来自 Anthropic 官方公告脚注。
同一次分类器更新,从 67% 一路掉到 7%。
厉害了。
这组数字不能直接证明哪个产品的护栏更准。更合理的理解是,四个产品的任务构成、用户类型和原有回退原因不一样。一个分类器的更新落到聊天、桌面协作、代码与 API 上,影响当然不会整齐划一。
这也刚好提醒了做生产系统的人。
别只报一个全局数字。
如果你在做内容审核、风险分类、模型路由或降级系统,总体拦截率常常很会骗人。它可能在普通问答里表现棒棒的,一进入代码仓库或长任务,就把正常工作流打得稀碎。
真正有用的仪表盘,至少要按产品面、任务类型、语言、客户层级和路由结果切片。然后把四类东西放在一起看,有害请求拦住了多少,良性请求误伤了多少,回退后任务是否完成,以及用户为这次改道多等了多久。
少一样,都可能把「安全了」误读成「产品好了」。
还有一个要紧的问题,85% 的误报降幅有没有换来更多漏报。
Anthropic 说,团队重写了分类器的规则集,重做训练数据并重新训练,还邀请内外部专家参与反馈。新版在放行更多良性请求的同时,仍要对有害与双重用途的专业研究触发。公司早先发布的 网络安全分类器与绕过评测框架 也能看出,抵抗绕过不是附加项,而是分类器上线的一部分。
但官方并没有在这篇公告里给出完整混淆矩阵,也没有把误报率、漏报率、绕过成功率和各端样本量摆到同一张表上。所以 85% 是一个很重要的改进信号,却不是「安全与可用性已经两全」的免责卡。
这话听着有点刺耳,但安全数字就得这么看。
边界不是一张静态名单
这次更新还有一个很工程的细节。
Anthropic 不是在原分类器上随手调了一个阈值。官方说,团队重写了分类器的规则集,将原本含混的良性用途划得更细,征询内外部专家意见,然后重做训练数据、重新训练与验证。
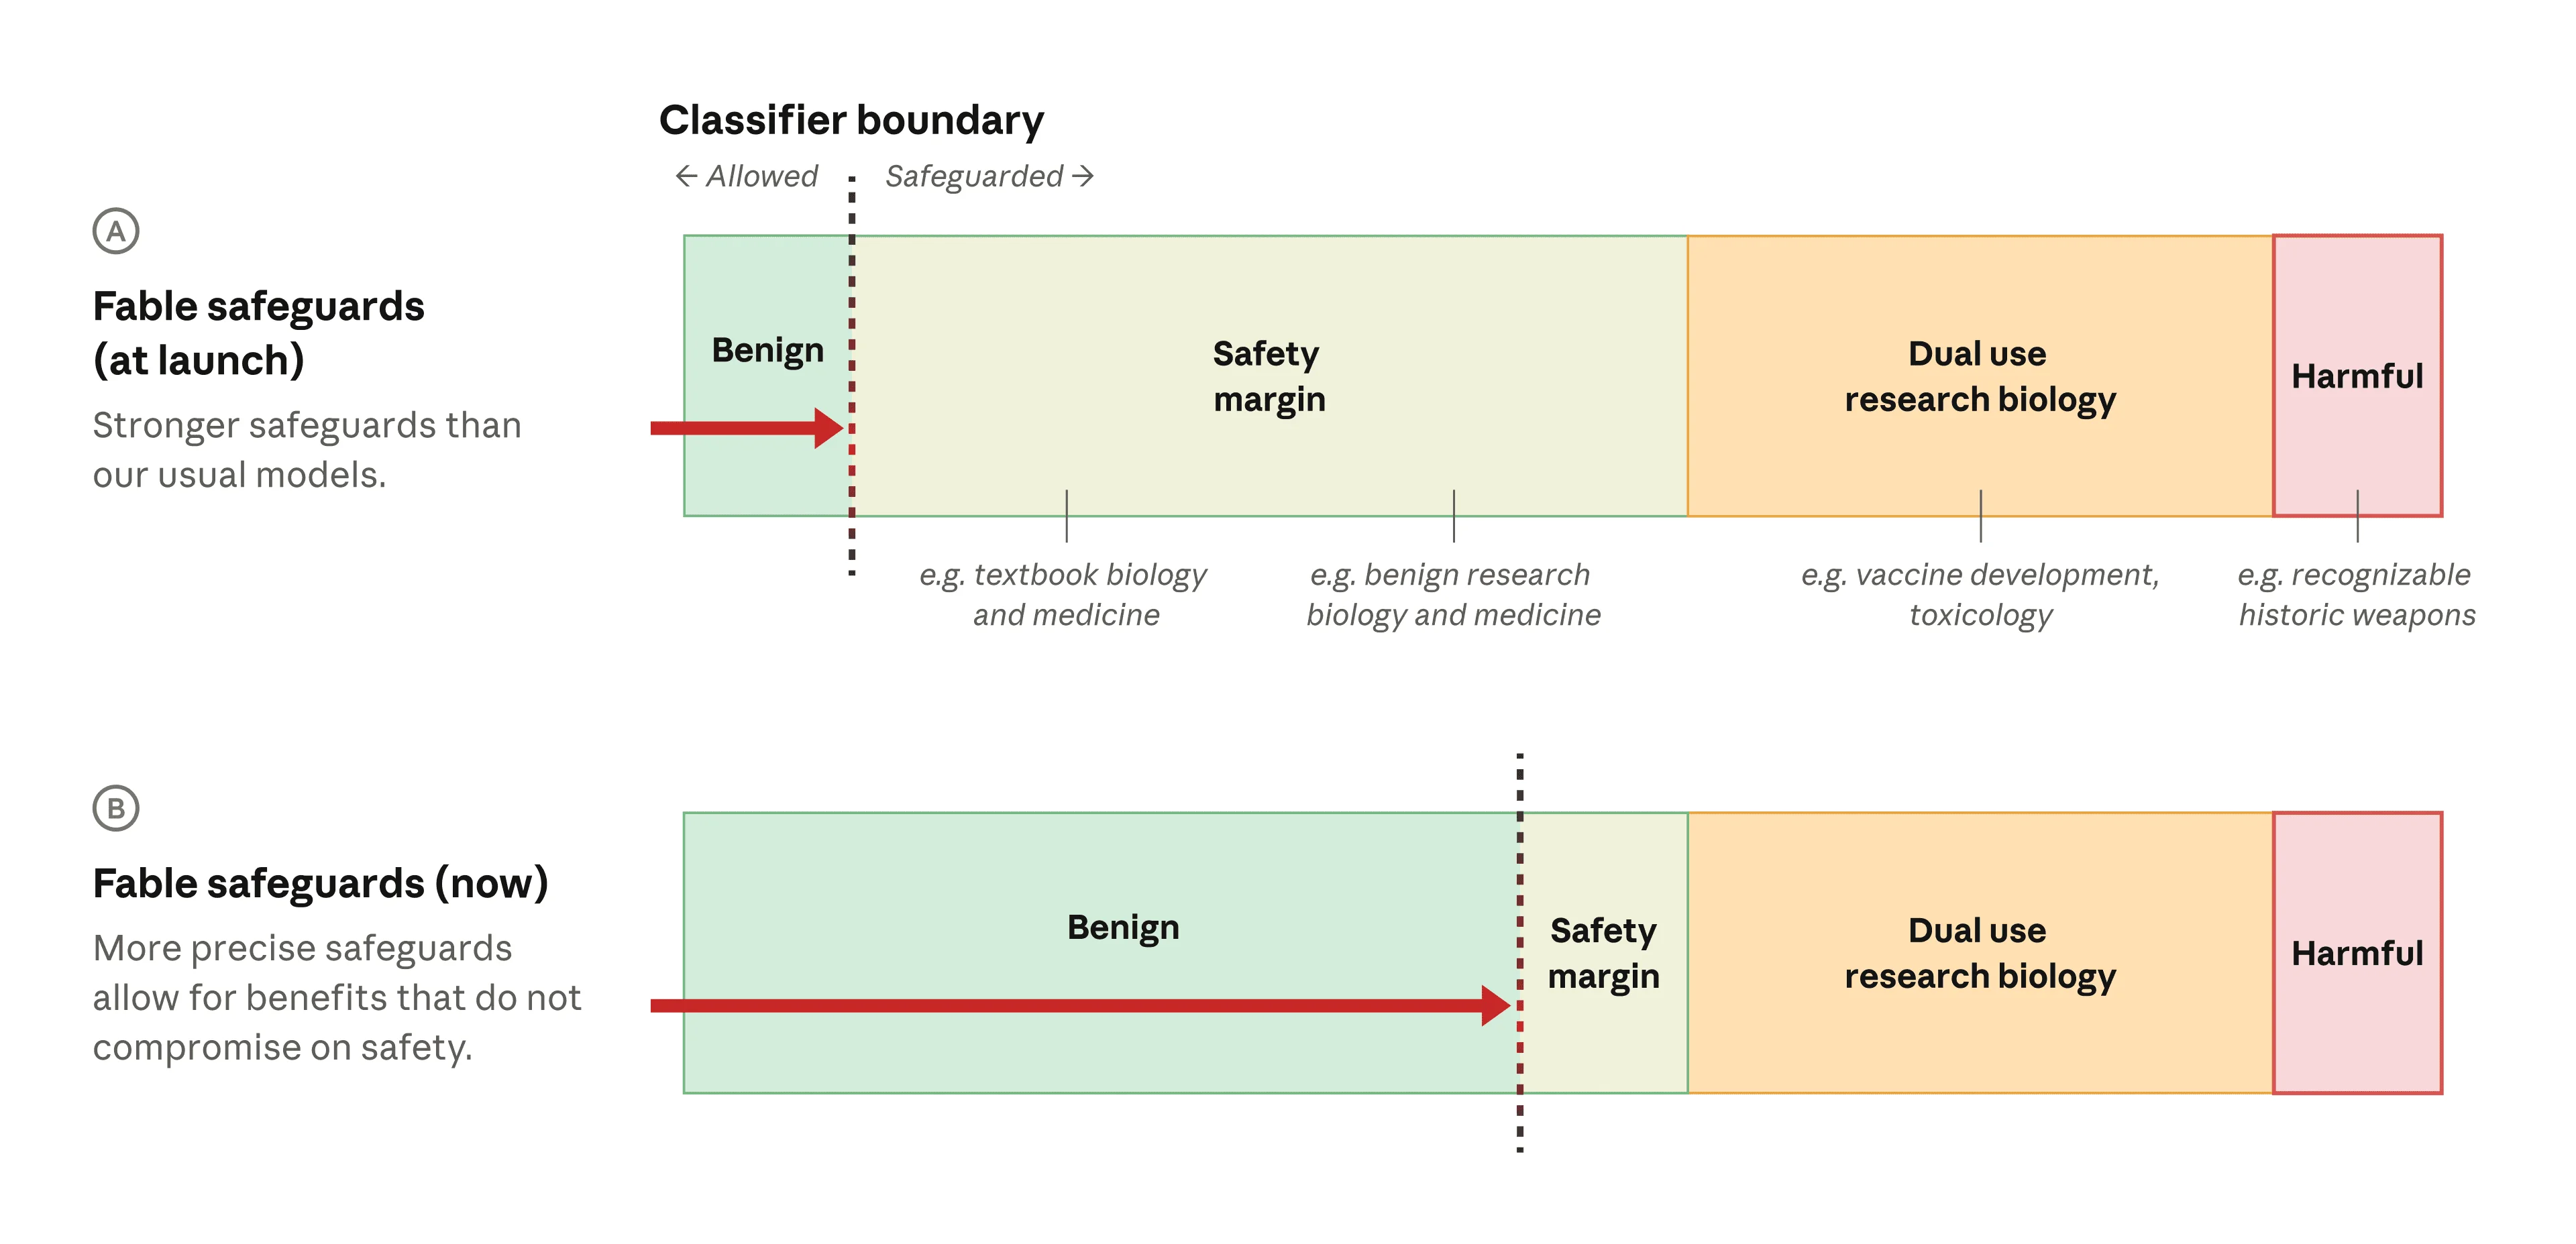
Anthropic 官方图示,新边界放行了更多良性请求,双重用途与有害区域仍然受保护。
这条链路里,政策规则、训练集、分类器、路由器和兜底模型其实是一个联动版本。只修一处,下游行为就可能全变。今天放宽一批良性请求,回退流量会下降,主模型的使用量会上升,原来给兜底模型做的容量预估也会被改写。
所以规则不能只是一份被人悄悄改掉的文本。分类决策至少应该带着规则版本、分类器版本和路由版本。否则用户投诉某条正常请求被拦,工程师只能对着当前系统发呆,连当时是哪条边界做的决定都追不回来。
线下评测也不能只放明显的好问题和坏问题。最值钱的样本往往卡在浅绿与橙色之间,看起来专业、实际合法,或表面日常、上下文却很可疑。Anthropic 公开的能力评估 解释了为什么要为这类能力加安全余量,而 Anthropic 透明度中心 则把模型能力与防护放在同一条发布逻辑里。
真正上线时,还得按产品面做灰度。Claude.ai 与 Claude Platform 的降幅差了将近十倍,这已经足够说明一次全端同步切换有多粗暴。先让小比例流量跑新版,对比误伤、漏报、任务完成与延迟,再逐步扩大。一旦某个端的边界样本异常,只回滚那个端,不用把所有用户一起拉回旧版。
再往前一步,每个新版本都应该保留回放集。把已经人工确认的误伤和高风险样本做去标识化处理,在新规则上重放一遍。要看的不是新版能不能把今天的分数刷高,而是它有没有把昨天已经解决的错又犯一遍。
这一整套做下来不炫。没有新模型的跑分曲线,也没有一键开启的宣传图。它只是让一条分类边界能被追踪、能被验证、出错时能退回去。
可这才是护栏真正进入生产环境的样子。
给安全路由补一本完整账本
做模型路由时,我一直觉得最怕的不是系统明着失败,而是它看起来成功,中间却悄悄换了一整套行为。
请求返回 200,界面也出了答案,监控全绿。可实际上,安全分类器已经触发,主模型没有执行,兜底模型给了一个不那么好的结果。如果团队只盯着错误率,这类失败会永远隐身。
所以无论是自己做审核层,还是调用 Claude 的服务端回退,我都建议把每次路由当成一条一等公民事件。不要只在日志里写一句 fallback happened,最少要记下原始模型、实际模型、分类理由、产品界面、端到端延迟和任务结果。
实际的事件可以长这样。
{
  "requested_model": "fable-5",
  "served_model": "opus-5",
  "route_reason": "safety_classifier",
  "surface": "api",
  "latency_ms": 1840,
  "task_completed": true
}
这不是 Anthropic 公开的真实日志格式,只是一个明确标注的设计示例。重点也不是字段名,而是别让降级变成一段无法追踪的黑箱。
接着才是发布门禁。新分类器上线前,需要同时对比安全命中、良性误伤、绕过测试、回退任务成功率与用户投诉。任何一项突然抬头,都应该能回滚到上一版规则与训练数据。
再给用户一个反馈入口。误伤本来就是边界数据的来源,如果用户只能无语地关掉窗口,团队丢掉的不只是一次会话,还有下一轮分类器最值钱的样本。
怎么说呢,护栏的价值从来不是把门焊死。
它是在不放过高风险请求的前提下,尽量让正常人少撞几次墙。这种工程没有永久正确的边界,只有可验证、可观测、能回滚的版本。
Fable 5 这次把边界往良性用户那边让回去了一大步。有点子牛逼。
但真正值得我们带回自己系统的,不是那个 85%。
是从今往后,安全拦截率与正常用户的误伤率,得写在同一页发布报告里。
守住边界是责任。不让每个路过的人都被误当成坏人,也是。