posts/fastmetal-mac-local-video.md
FastMetal 最狠的不是 30 秒,是 3.2GB
一台没有独立显卡的 Mac,正在本地生成五秒视频。
不用 CUDA,不把提示词和素材发到云端,1.3B 模型跑快速模式,峰值只吃掉 3.20 GiB 统一内存。
FastVideo 团队在社交媒体上的演示把最抓眼的数字写成了 30 秒。官方技术博客里的完整基准更克制,M4 Max 上的 1.3B 快速模式约 45.19 秒,5B 的 720p 快速模式约 47.24 秒,快速加 Refine 的 1.3B 约 39.43 秒。
数字不完全一样,反而把这次发布最值得聊的地方露了出来。
本地视频生成已经不能只问一句「跑一次要多久」。同一台机器,冷启动还是热启动,用 1.3B 还是 14B,生成完整帧还是补中间帧,默认解码器还是完整 Wan VAE,答案能差出好几倍。
好家伙,30 秒很适合做标题,真正能把它变成工作流的,却是那 3.2GB 背后一整套内存调度。
先别把 30 秒当成一把万能秒表
FastMetal-QAD一次发布了三款模型。1.3B 面向 480p,5B 支持 720p,14B 追求更高的本地画质。它们都生成约五秒、81 帧的视频,但跑法并不相同。
官方在 M4 Max、36 GB 统一内存上给出的冷启动基线里,1.3B 端到端要 110.14 秒,5B 要 151.42 秒,14B 则要 601.82 秒。切到快速模式以后,三者分别落到约 45 秒、47 秒和 211 秒。
这里有个特别容易被短视频演示藏起来的细节。
端到端时间不只有模型去噪。它还包含提示词编码、权重加载、视频解码和文件导出。5B 的一次冷启动里,umT5 文本编码器大约要花 47 秒,真正的去噪循环约 98 秒。相同提示词再次生成时,内容寻址缓存能跳过这段编码,体感立刻换一张脸。
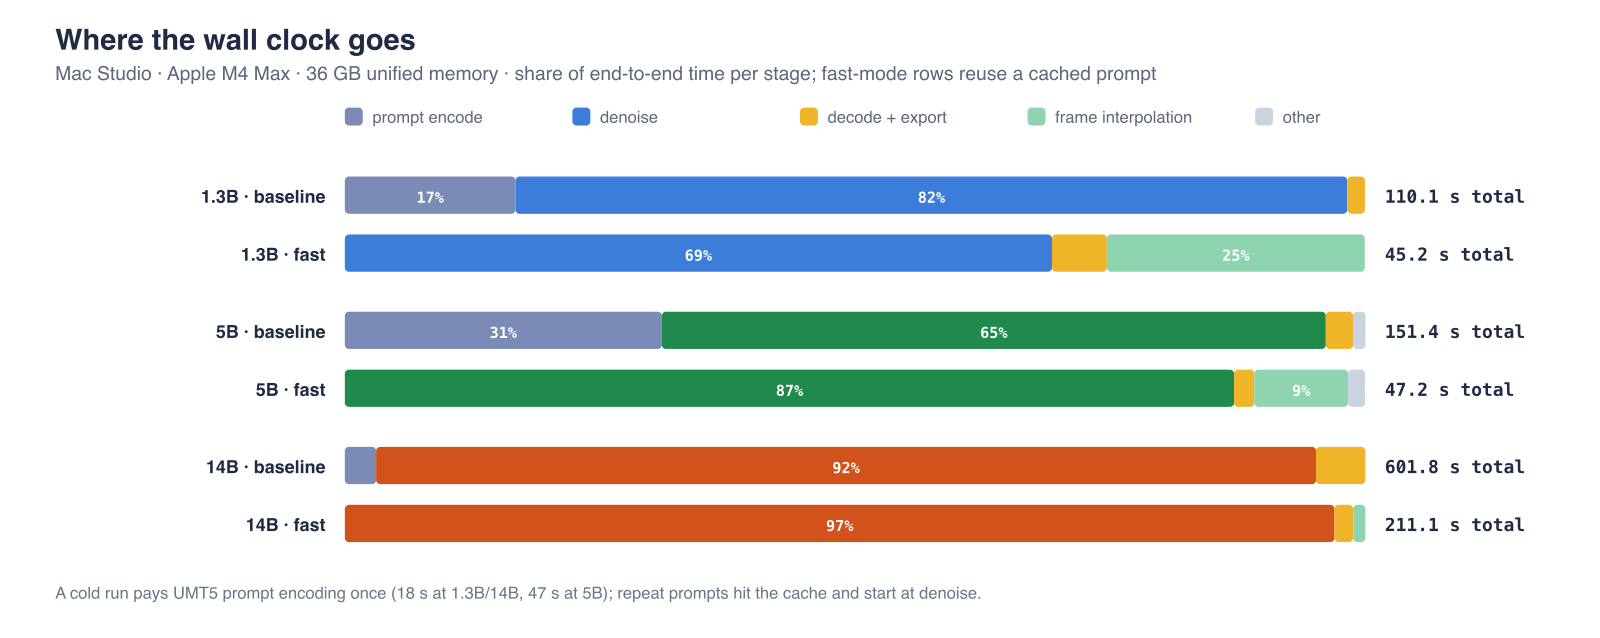
冷启动要支付提示词编码,缓存后的重复生成才直接进入去噪。
所以看到任何「Mac 本地多少秒出视频」,先补四个问题。机器是哪一档,计时从哪里开始,提示词缓存有没有命中,视频到底用了什么生成模式。
这不是挑刺,是基本的性能合同。
很多程序员遇到过类似的坑。服务压测写着 P50 只要 80 毫秒,上线后用户却等了两秒,查到末尾才发现图里没算冷启动、鉴权、网络和序列化。视频生成也一样,只晒去噪速度,跟只晒数据库执行计划不晒整个请求链路,味道差不多。
坦率讲,我没有在同配置 Mac 上复现这组数字,也不会替官方把 30 秒扩大成所有机器都能达到的承诺。眼下能确认的是,团队把完整表格、运行参数与脚本一起放了出来,读者至少可以看清楚每一秒花在了哪里。
3.2GB 不是模型突然变小了
FastMetal 真正有点子牛逼的设计,是没有把文本编码器、DiT 和解码器同时堆在内存里开会。
它先用 bf16 加载 umT5 文本编码器,完成一次提示词编码,然后把这部分释放,再加载负责视频去噪的 DiT。解码阶段默认使用 22 MB 左右的 TAEHV,而不是把完整 Wan VAE 常驻在那里。
于是峰值内存取决于最重的单个阶段,而不是三个阶段简单相加。
对 Apple Silicon 来说,这个差别太关键了。统一内存不是凭空多出来的一块显存,它要和 macOS、浏览器、IDE、Docker 以及你没舍得关的几十个标签页一起分家产。标称 24 GB 的机器,换成二进制单位只有约 22.35 GiB,再扣掉系统和其他应用,可用空间还会继续缩水。
官方测得 5B 在所有模式下都低于 11 GiB,因此 16 GB Mac 可以跑 720p。14B 的峰值约 21.7 GiB,已经贴近 24 GB 机器的真实上限,所以团队把它放到了 36 GB 及以上的档位。
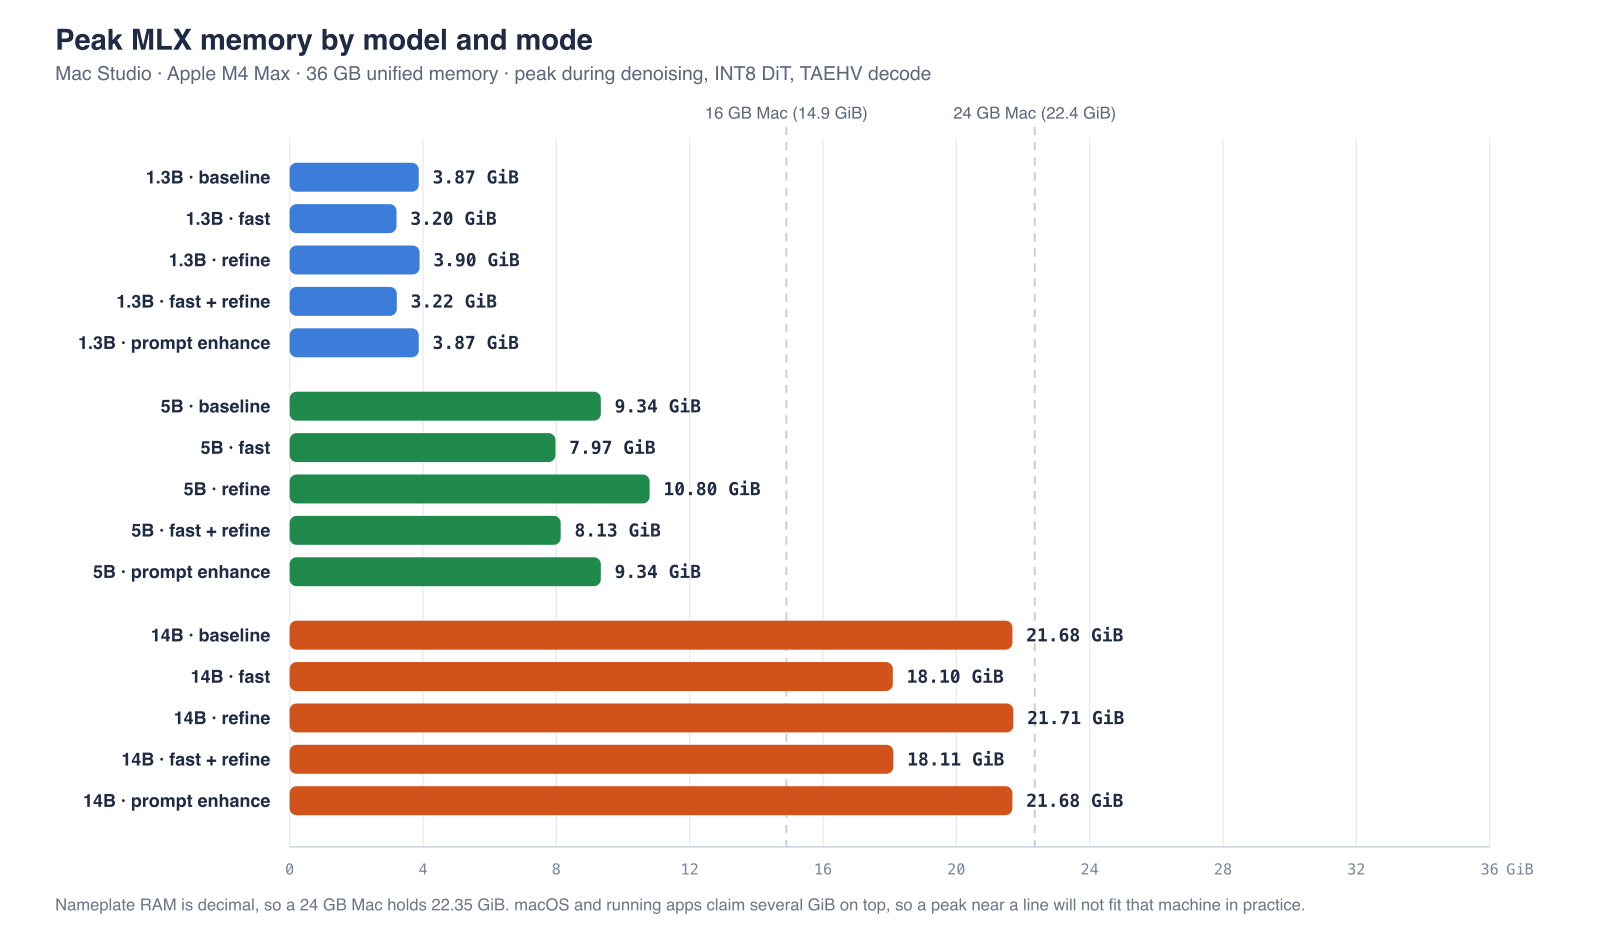
标称内存不是模型预算,14B 已经贴近 24 GB Mac 的真实天花板。
看到这里,16 GB 用户先别急着欢呼,24 GB 用户也不用觉得自己被背刺。能装下模型和能舒服地工作,是两套标准。
如果只是关掉一堆应用,等几十秒生成一段草稿,5B 跑进 16 GB 已经很厉害了。如果希望一边开着剪辑软件,一边让本地服务排队生成,还要长时间维持稳定延迟,内存余量、热降频和并发才是下一张成绩单。
官方目前给了单次与重复运行的平均数据,没有给几个小时批量生成后的温度、功耗和 P95 延迟。不是说它一定扛不住,而是这部分还没有证据。
这块需要注意一下。无风扇 MacBook Air 能跑,跟它适合当一台全天候视频服务器,中间还隔着散热设计。
INT8 省下的内存,不是白捡
很多本地模型发布喜欢把量化写成一个压缩按钮,仿佛从 fp16 切到 INT8,体积少一截,速度快一截,质量还能原地不动。
现实没这么配合。
FastMetal 没有下载模型以后随手做一次训练后量化。三款检查点在训练阶段就对齐了最终要交付的 affine INT8 网格,组大小为 64。矩阵权重走 mx.quantized_matmul,归一化层与调制表继续保留 fp16,注意力也没有硬塞进全整数路径。
团队还真做了一版 int8×int8 的融合 Metal 内核。数值误差可以控制到 3×10⁻⁶ 以内,可在当前 MLX 和 Metal 的内核表面上,它面对 DiT 的矩阵形状并没有跑赢 fp16。
厉害了,数学上做对,不等于硬件上更快。
所以他们选择用 INT8 解决内存问题,用 dense fp16 注意力保住当前速度和稳定性。MXFP4 与 NVFP4 也试了,在相近内存成本下,权重重建误差高一个数量级以上,暂时没有为了「更低比特」这个标签硬上。
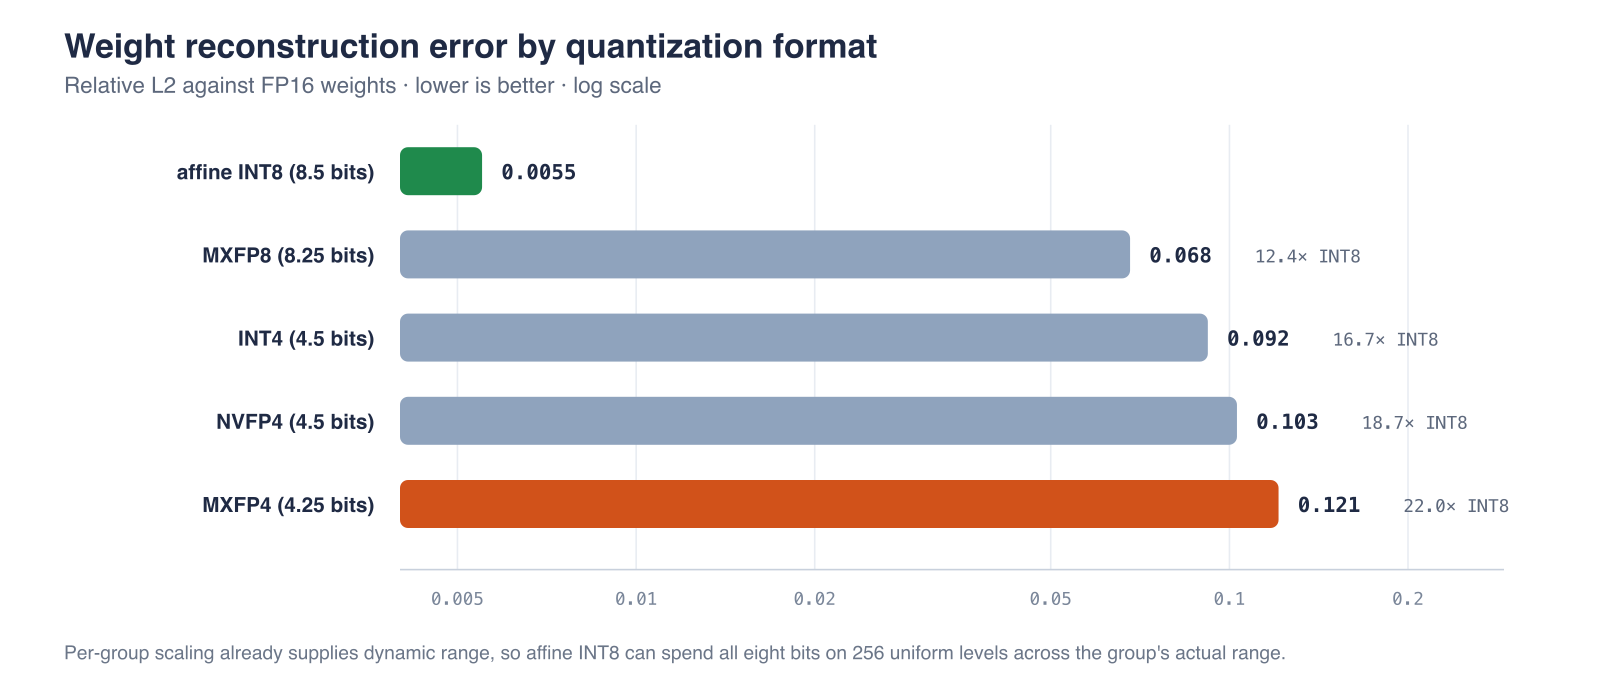
团队最终选 INT8,不是因为位数越低越先进,而是它在当前 Metal 路径上更稳。
1.3B 的配对测试里,QAD 检查点相对自身 FP16 输出的 MS-SSIM 为 0.933,普通训练后量化为 0.907。MS-SSIM 是衡量结构相似度的一项指标,越接近 1 越相似。它不是人类审美的完整替身,官方也补了人工视觉网格筛选。
我自己的判断是,这一段比 30 秒更有参考价值。
它承认了平台优化不是选一个最炫的数值格式,而是在模型、框架、芯片和质量门之间找当前能交付的组合。今天 W8A8 没更快,就不假装它更快。明天 MLX 的内核表面变了,再重新验。
工程就是这么朴素。
快速模式省掉的,终归要用质量来还
FastMetal 的快速模式并没有让每一帧都凭空提速 2.5 倍。
它使用 --fast --fast-factor 2,只生成间隔中的关键帧,其余帧交给 Apple Silicon 原生的 rife-mlx 插值。生成的帧少了,扩散工作大约减半,再用 --fast-sharpen 把边缘锐度拉回来。
这套做法很实用,代价也很明确。
镜头运动平缓、主体变化连续时,插值能省下大量时间。快速动作、遮挡、突然出现的新物体,或者需要逐帧准确的画面,插值更容易露出破绽。你拿它做分镜草稿和社交媒体素材,容忍度很高。你拿它生成要逐帧合成的镜头,验收标准就完全不同。
Refine 模式走的是另一条路。先在基础分辨率生成,再用同一个 DiT 做一次高分辨率去噪,不额外加载第二份模型。它增加约 5% 到 7% 的去噪时间,换回更多细节。快速加 Refine 组合起来,仍然比基线快很多,却不是无损魔法。
问题来了,用户该选哪个开关?
别从模型名字开始选,从要交付的画面开始。创意探索看生成吞吐,先用 1.3B 或 5B 快速模式铺候选。准备交付时,再对入选提示词开 Refine 或完整 Wan VAE。需要局部动作精度的镜头,把快速模式和基线放在同一组提示词上做成对比较。
这就像编译时的 debug 与 release。不是谁永远更好,而是不同阶段交不同的账。
无风扇 MacBook Air 才是更狠的边界测试
M4 Max Mac Studio 跑视频模型很精彩,但离多数人的桌面还有点远。团队因此又在一台 13 英寸 M5 MacBook Air 上重跑了 1.3B 与 5B。这台机器有 24 GB 统一内存和 10 核 GPU,没有风扇,GPU 核心数大约只有测试用 Mac Studio 的四分之一。
结果很有意思。
相同设置下,输出质量接近,峰值内存只差几百 MiB,耗时变成 Mac Studio 的约 1.3 到 2 倍。1.3B 快速模式平均 58.2 秒,峰值 2.71 GiB。5B 快速模式平均 90.7 秒,峰值 8.11 GiB。14B 在 81 帧设置下装不进这台机器。
这组数据把 Apple Silicon 的优势和边界一起摆出来了。
统一内存让模型可运行性跨过了门槛,芯片规模和散热仍然决定你要等多久。模型能启动,棒棒的。连续生成二十条之后还能不能保持同样速度,才是做本地产品的人该继续补的测试。
如果真准备把 FastMetal 放进自己的工作流,我会建议先固定十条黄金提示词,覆盖慢镜头、快速动作、多主体、遮挡和文字元素。每条同时跑冷启动、缓存命中、快速、快速加 Refine 和基线,记录端到端时间、峰值内存、失败率与人工画质判断。
然后连续跑一小时。
别只看平均值,盯住最慢的那几次,看看温度上来以后延迟有没有飘,内存有没有持续长,导出进程有没有留下孤儿文件。提示词缓存也要单独验,内容相同但空格、大小写或附加负面提示变化时,命中规则是否符合预期。
这些测试不性感,做完以后,30 秒才会从演示数字变成你自己的容量计划。
真想跑起来,先从 1.3B 开始
FastVideo 仓库已经加入 Apple Silicon 路径,源码使用 Apache-2.0 许可证。官方建议 macOS 14 或更新版本、Python 3.12,并通过 MLX extra 安装。最小路径并不复杂。
git clone https://github.com/hao-ai-lab/FastVideo.git
cd FastVideo
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install -e '.[mlx]'
hf download FastVideo/FastMetal-1.3B-QAD \
  --local-dir ./FastMetal-1.3B-QAD
先用 1.3B 跑通 480p,再决定要不要下载 5B。14B 直接按 36 GB 及以上准备,别拿标称 24 GB 去贴着系统红线碰运气。完整参数可以对照官方 Apple Silicon 指南,模型背后的三步采样路线来自 DMD2,运行时则建在苹果开源的 MLX 之上。
说真的,FastMetal 还没有把云端视频生成整个搬回个人电脑。14B 依然慢,快速模式有质量交换,图生视频还在后续计划里,无风扇机器的长时间稳定性也需要更多数据。
可它已经把一个很重要的门推开了。
以前 Mac 本地视频的问题是「能不能跑」。现在开始变成「冷启动多久、缓存怎么命中、内存怎么排班、哪种模式值得交质量」。问题从玄学愿望,落成了可以测量的工程参数。
所以我更愿意记住 3.2GB,而不是 30 秒。
30 秒让人点开演示。
3.2GB 才让人开始想,下一条本地工作流该怎么搭。