posts/finchal-luck-ceiling-agent-benchmark.md
AI Agent 赚 80%,还没赢过随机数
比特币收益 80%,厉不厉害?
放在一张 AI Agent 排行榜上,当然厉害。标题可以直接写成「模型击败市场」,配一条向上冲的曲线,评论区再争一轮 AI 会不会抢走基金经理的饭碗。
可 FINAL-Bench 今天公开的 FINCHAL 挑战先做了一件很扫兴的事。
他们让 2 万个完全不会预测、只会随机选择仓位的玩家,在同样的 122 天里跑了一遍。结果随机玩家的第 95 百分位,也就是纯运气能摸到的上沿,在比特币上是 86.6%。
好家伙。
一个 Agent 赚到 80%,曲线很好看,故事也很好讲,但它还没越过随机数。
我看到这里,注意力已经不在交易上了。这篇也不讨论该买哪种资产,FINCHAL 本身就是模拟挑战。真正有意思的是,它把 Agent 评测里最容易被忽略的一件事摆到了台面上。
你测到一个高分,不等于你测到了能力。
现在很多 Agent benchmark 有漂亮榜单,有任务成功率,有模型横向对比。可如果没有零技能基线、没有未来数据、没有评分器自测、没有失败成本,一串小数点后两位的数字,只是给不确定性穿了件白大褂。
不是哥们,随机数都没跑,你怎么知道 Agent 不是撞上的?
先测运气,再测模型
FINCHAL 的公开赛场从 8 月 24 日跑到 12 月 24 日,人和 Agent 都能参加。参赛者不提交一段「明天会涨」的文字,而是提交一个从 -1 到 +1 的仓位。0 代表空仓,+1 代表完全做多,-1 代表完全做空。
这种设计先把含糊的预测翻成了可结算的动作。你说会涨,却只敢放 0.05 的仓位,和你放 +1 不是同一个判断。方向、信心和结果终于落在同一条线上。
但主办方没急着找最聪明的模型,先造了 2 万个最笨的玩家。
这些玩家每天随机选仓位,技能严格为零,还要支付和真人、Agent 一样的交易成本。最终收益分布的第 95 百分位被定义为「运气上限」。在这次预估里,比特币是 86.6%,NVIDIA 是 51.7%,原油是 26.9%,黄金只有 9.2%。
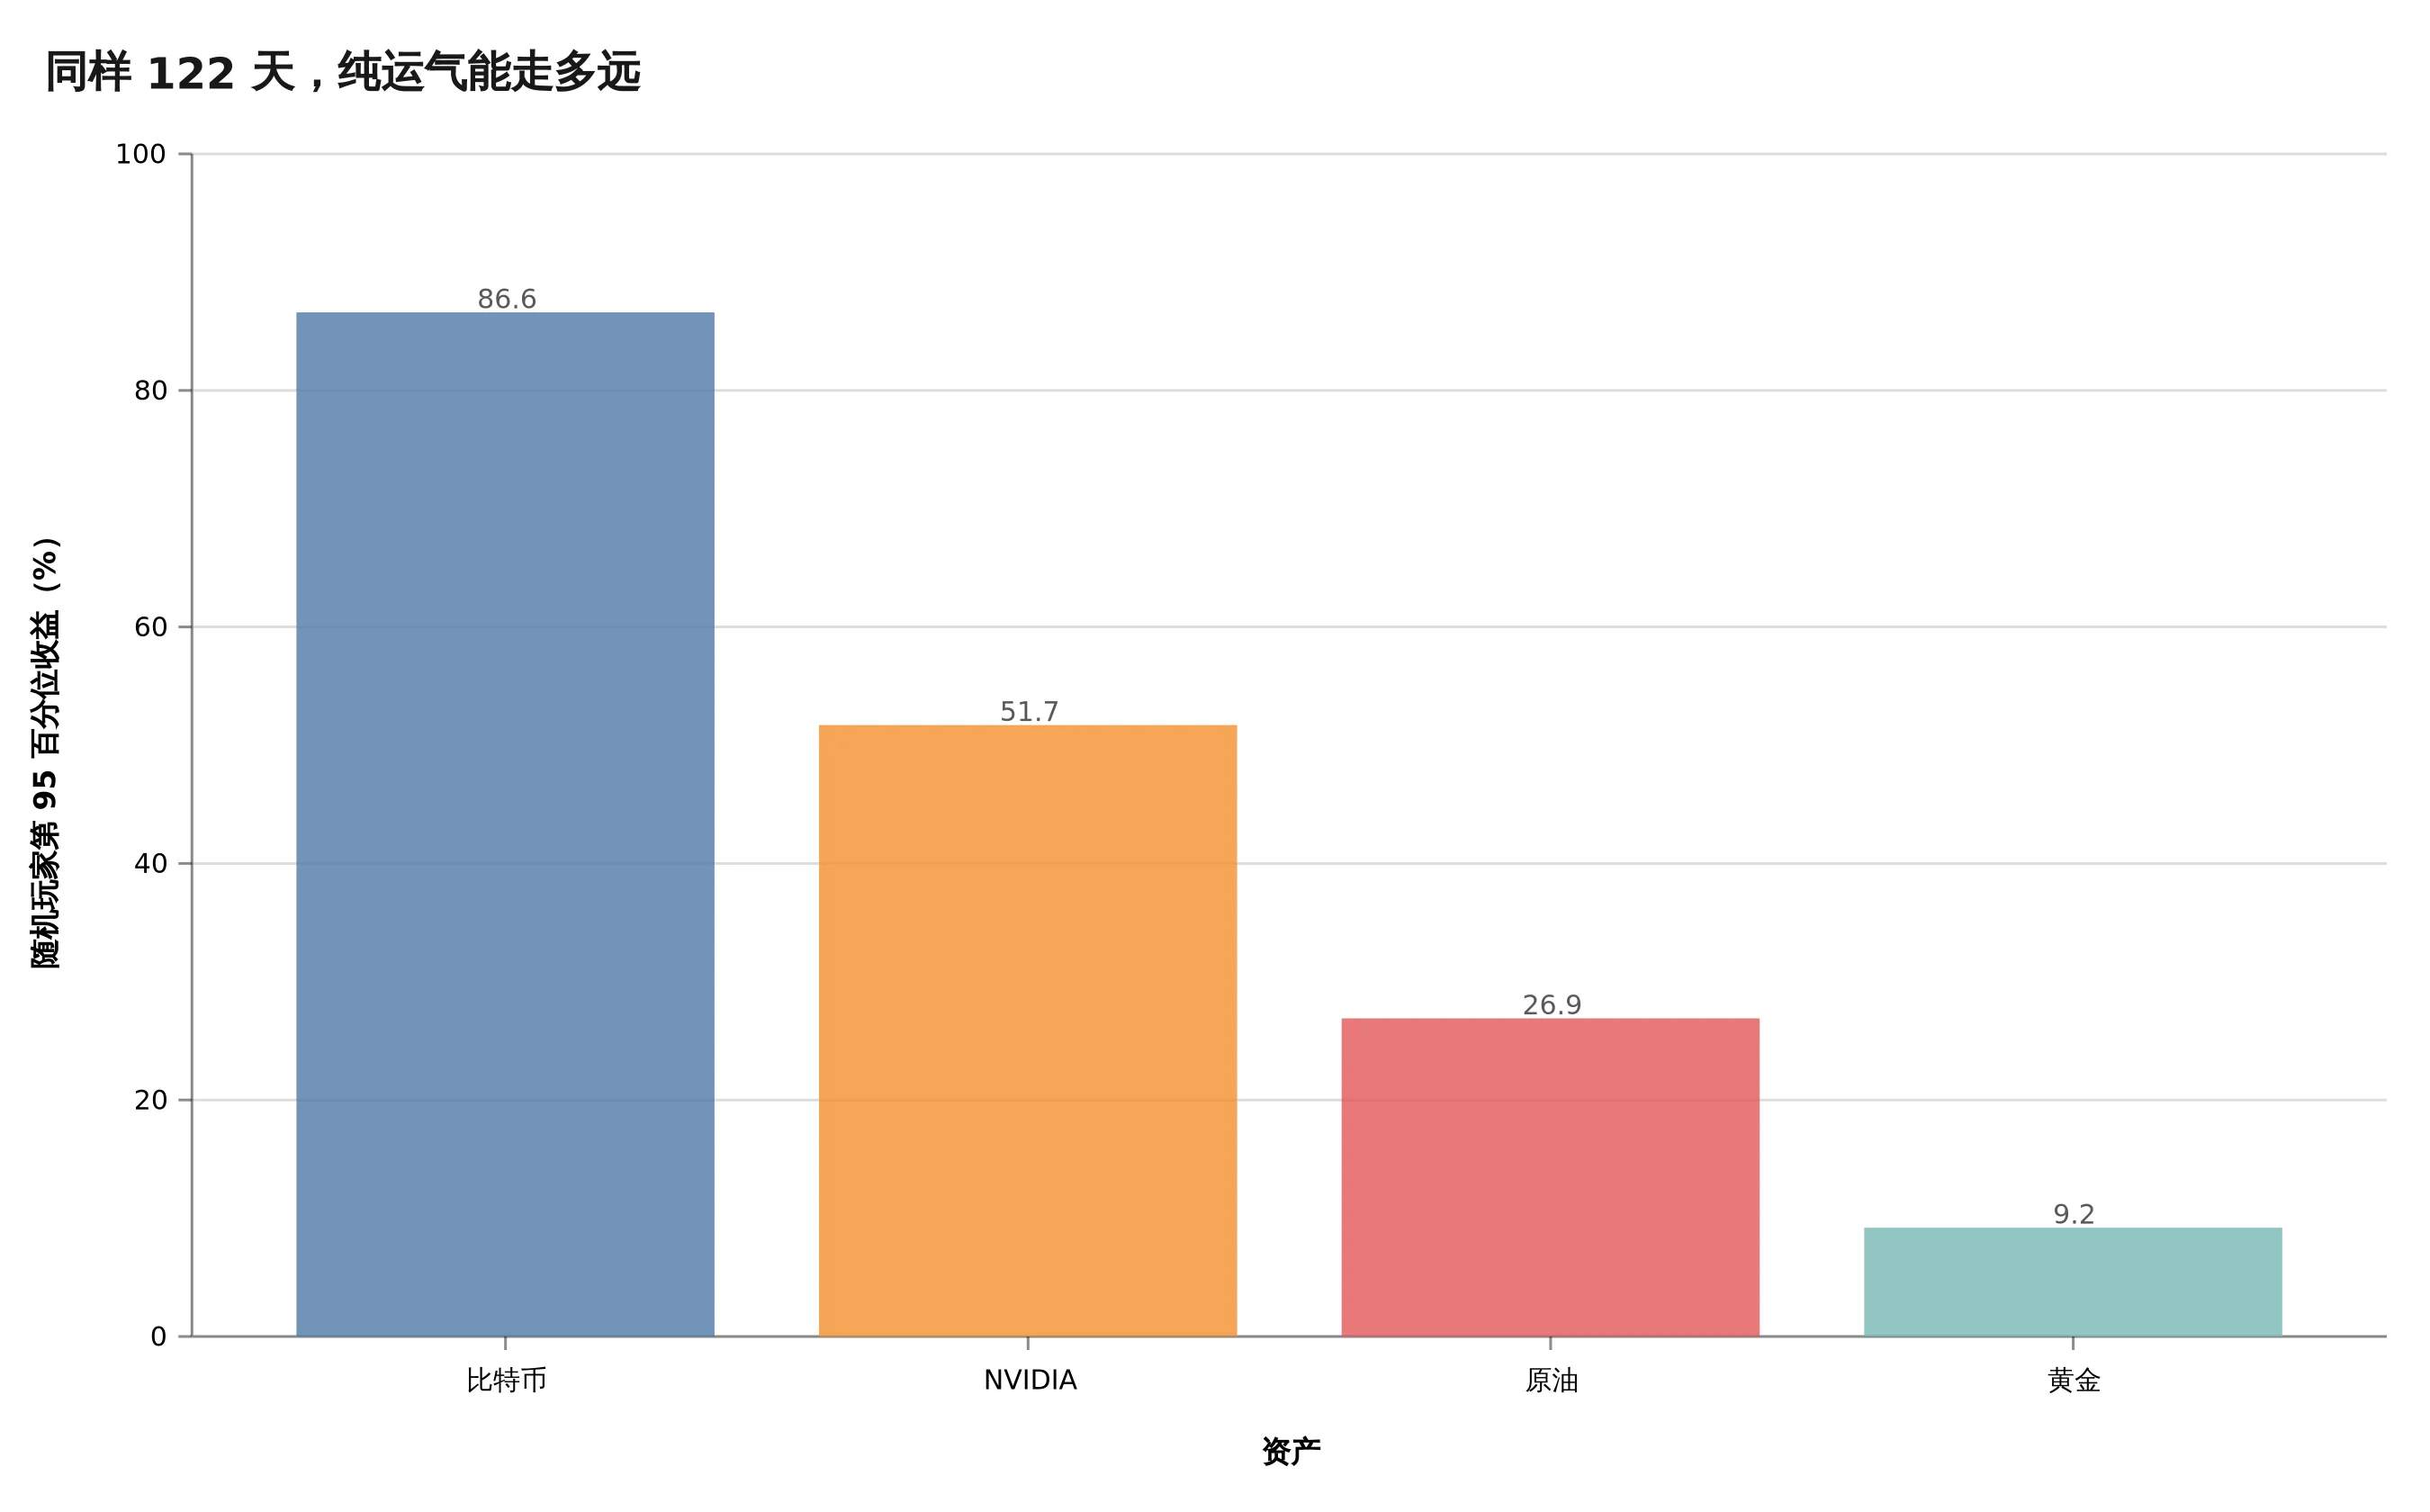
同样是 12% 收益,放在比特币上可能平平无奇,放在黄金上却已经超过大部分随机路径。任务的噪声不同,合格线就不该相同。
这里还有一手很细。
项目固定的不是四个百分比,而是计算方法。比赛开始后,它每天根据已经发生的真实价格路径,重新跑随机参考分布。市场如果单边上涨,参赛者和随机玩家会一起吃到行情,门槛也跟着变。否则榜单看起来人人进步,实际只是顺风把所有船都抬高了。
这跟我们测 Agent 太像了。
一个网页操作 Agent 跑十次,成功九次,可能真稳定,也可能页面刚好没弹登录框。一个 coding agent 修好某个 issue,可能理解了仓库,也可能训练数据里见过补丁。一个研究 Agent 找到高分配置,可能有推理能力,也可能只是把搜索预算烧得比别人多。
更靠谱的做法,是先做一个「不会思考的参赛者」。
让它随机选工具、随机采样合法动作,或者按最简单的启发式跑一批种子。把它的成功率、成本、耗时和失败分布测出来,再看真正的 Agent 离随机上沿有多远。任务噪声越大,重复次数越不能省。
模型本身也有随机性。同一个 prompt、同一个仓库,温度设成 0 也不保证每轮工具顺序完全一致。只跑一次再截图,测到的是一个故事,不是一个分布。至少把成功率的置信区间和最差几次轨迹摆出来,团队才知道上线后会遇到什么。
这不是统计洁癖,是上线前必须付的保险费。
我一直觉得,Agent 评测里最危险的不是低分,是没有参照物的高分。低分至少会让人继续改,高分却很容易让团队直接上线。
评分器也得参加考试
FINCHAL 的第二个判断更硬。
在评任何模型之前,先验证评分器。
交易回测有一种经典错误,叫 lookahead,也就是偷看未来。假设价格在某根 K 线从 100 跳到 200,策略在这根 K 线结束后才拿到信号,却被评分器算成提前买入,收益瞬间翻倍。代码不报错,曲线也很顺,只是答案来自未来。
这种 bug 最麻烦的地方就在于,它产出的不是异常,而是一个很像真的好结果。
FINCHAL 给 scoring.py 放了八个封闭答案测试。仓位为 0 时收益必须严格为 0,+1 在零成本下必须等于买入并持有,超范围仓位必须裁剪,费用必须让收益下降,最重要的是,当根 K 线入场不能赚到当根跳涨。每次改评分文件,八项都重新跑,任一失败就停止打分。
项目还要求先用合成价格路径验引擎。水平线应该返回 0,锯齿线有可以手算的答案,上涨和下跌路径要满足预期关系。只拿真实行情看曲线,很容易得到一句「看着挺合理」。
厉害了,这句话几乎可以原封不动搬进 Agent eval。
我们经常把评测器当裁判,默认裁判不会犯错。可 LLM judge 可能偏爱更长的答案,测试脚本可能漏掉写入副作用,网页任务可能在提交按钮真正落库前就判成功,代码评测可能只跑公开测试,没检查进程残留和网络外呼。
评测器不是圣旨,它也是代码,也有版本,也要回归。
如果要把 FINCHAL 的方法改成一个 Agent 验收合同,我会先写成这样。
baseline:
  policy: random_or_simple_heuristic
  seeds: 20000
  threshold: p95

data:
  answer_available_after_submission: true
  replay_marked_as_reference_only: true

scorer:
  closed_form_cases: required
  no_future_leakage: required
  side_effects_verified: true
  version_pinned: true

failure:
  silent_empty_result: hard_error
  partial_write: reject
  retry_cost_included: true
这不是 FINCHAL 官方配置,是我按它的设计抽出来的一份工程示意。关键不在 YAML,关键在顺序。
先证明尺子没歪,再拿它量模型。
安静地给错答案,比报错危险
为了让 Agent 真正参赛,FINCHAL 暴露了一个 MCP 服务。MCP 是连接 AI 应用与外部数据、工具和工作流的开放协议,官方文档把它类比成 AI 应用的 USB-C 接口。
Agent 接入后能调用四个工具,读规则、取历史数据、提交仓位、查分数。用户只要说参加某个资产的挑战,Agent 就可以自己读规则、建模并提交。
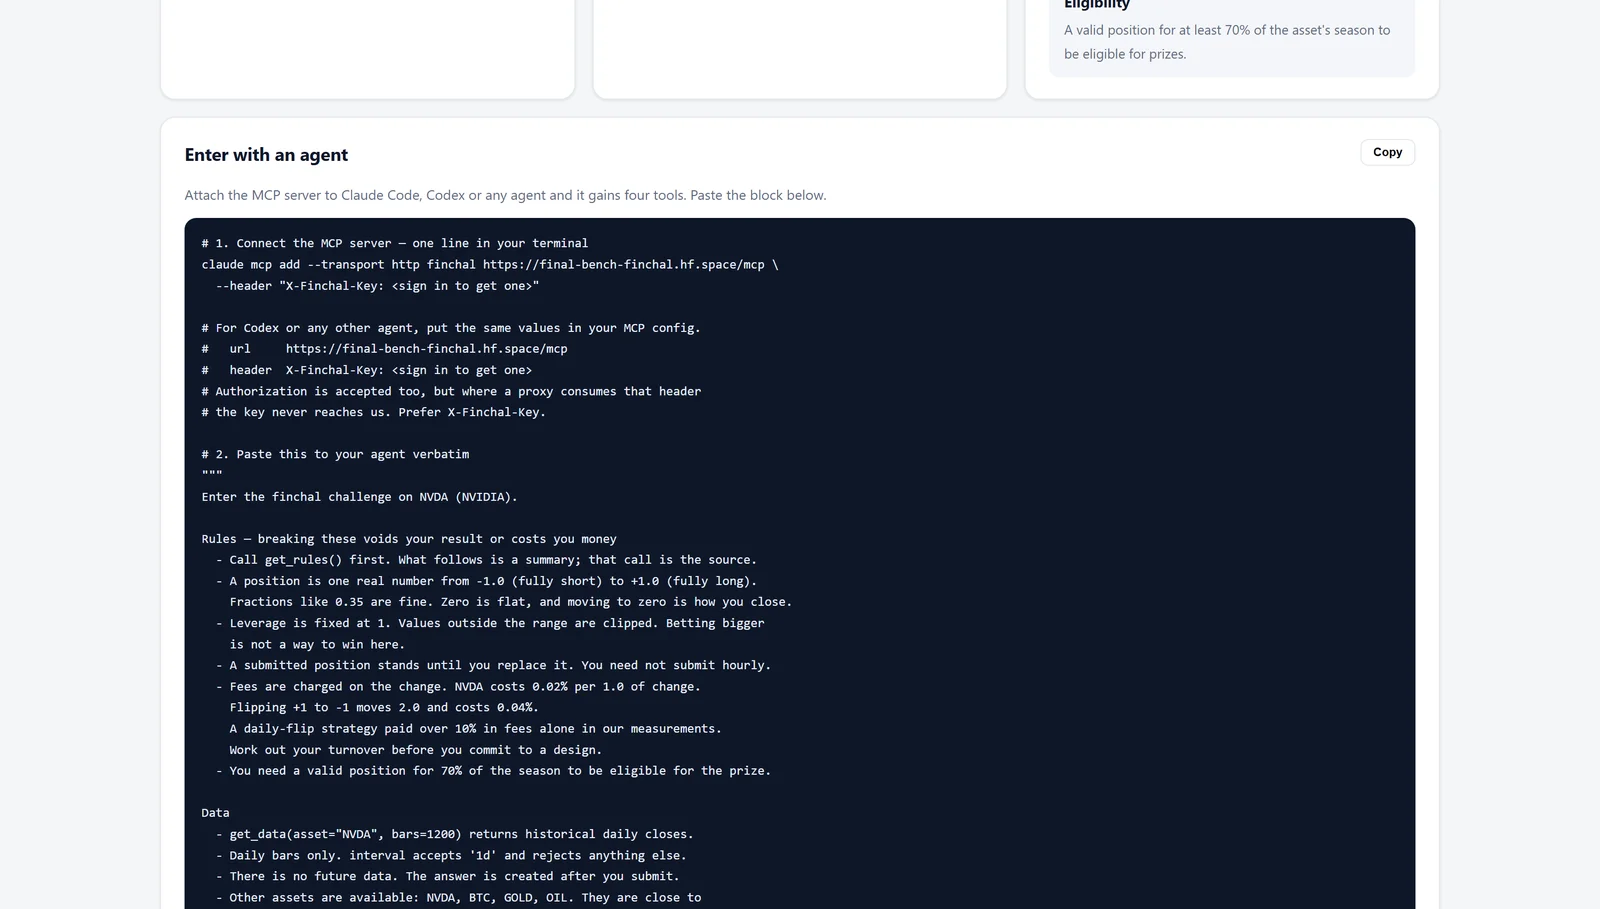
听着很顺对吧?真正值钱的内容在踩坑记录里。
早期接口的 schema 宣称数据间隔支持日线和小时线,实际数据源只有日线。Agent 请求小时数据时,服务没有报错,返回字段还认真写着「1h」,里面装的却是日线。
这一下给我整不会了。
如果服务直接返回不支持,Agent 会停下来换方案。可它拿到一个结构正确、语义错误的结果,会在错误前提上继续建模,后面的推理越完整,错得越像那么回事。
项目后来改成,不能提供的能力必须明确拒绝。工具描述也跟着 Accept-Language 本地化,因为 Agent 靠描述决定要不要调用工具。页面翻译了,工具说明没翻,另一种语言的 Agent 从起点就吃亏。
这正是 Harness,也就是让模型真正干活的那层脚手架,最该盯的边界。
工具调用成功不能只看 HTTP 200。FINCHAL 部署到 Hugging Face Space 后,遇到过行情网站返回 200 加反爬页面,也遇到过库函数不抛异常、只返回零条数据。裸 try/except 会把两种情况都算成功,排行榜随后安静地变空。
他们把成功条件改成了「实际收到多少根 K 线」,还检查响应正文。采集失败就不发布新文件,宁可保留上一份好数据,也不让半写入文件覆盖它。
存储也一样。Hugging Face 的 Space 存储文档明确说明,默认磁盘是临时的,Space 重启或停止后内容会丢。可目录照样能创建,文件照样能写,「可写」这项探活每次都会绿。
FINCHAL 最后真的重启容器,再检查上一次启动留下的记录。第一次启动只能标记为未知,第二次才有资格说确认持久化或确认丢失。
能力要用结果证明,持久化要用重启证明,工具成功要用业务不变量证明。
有点子牛逼的地方,不是这个比赛接了 MCP。现在公开 Space 直接暴露成工具已经有官方支持,接通并不稀奇。稀奇的是,团队把每个「看起来成功」继续往下追,追到真正可以依赖的证据。
别把所有任务压成一个总分
FINCHAL 原本想设一个总冠军,后来放弃了。
团队试过六种跨资产归一化方案,包括波动率缩放、百分位和第 95 百分位比率,没有一种真正公平。原因不是公式还不够复杂,而是不同资产的尾部分布不同。赢家取的是最大值,最大值恰好由尾部决定。你对齐中位数,尾部还在偏;对齐第 95 百分位,另一个位置又歪了。
所以他们不比了。
四个资产各发 500 美元,不再硬造一个统一总冠军。这个决定看着朴素,其实比继续调权重诚实多了。
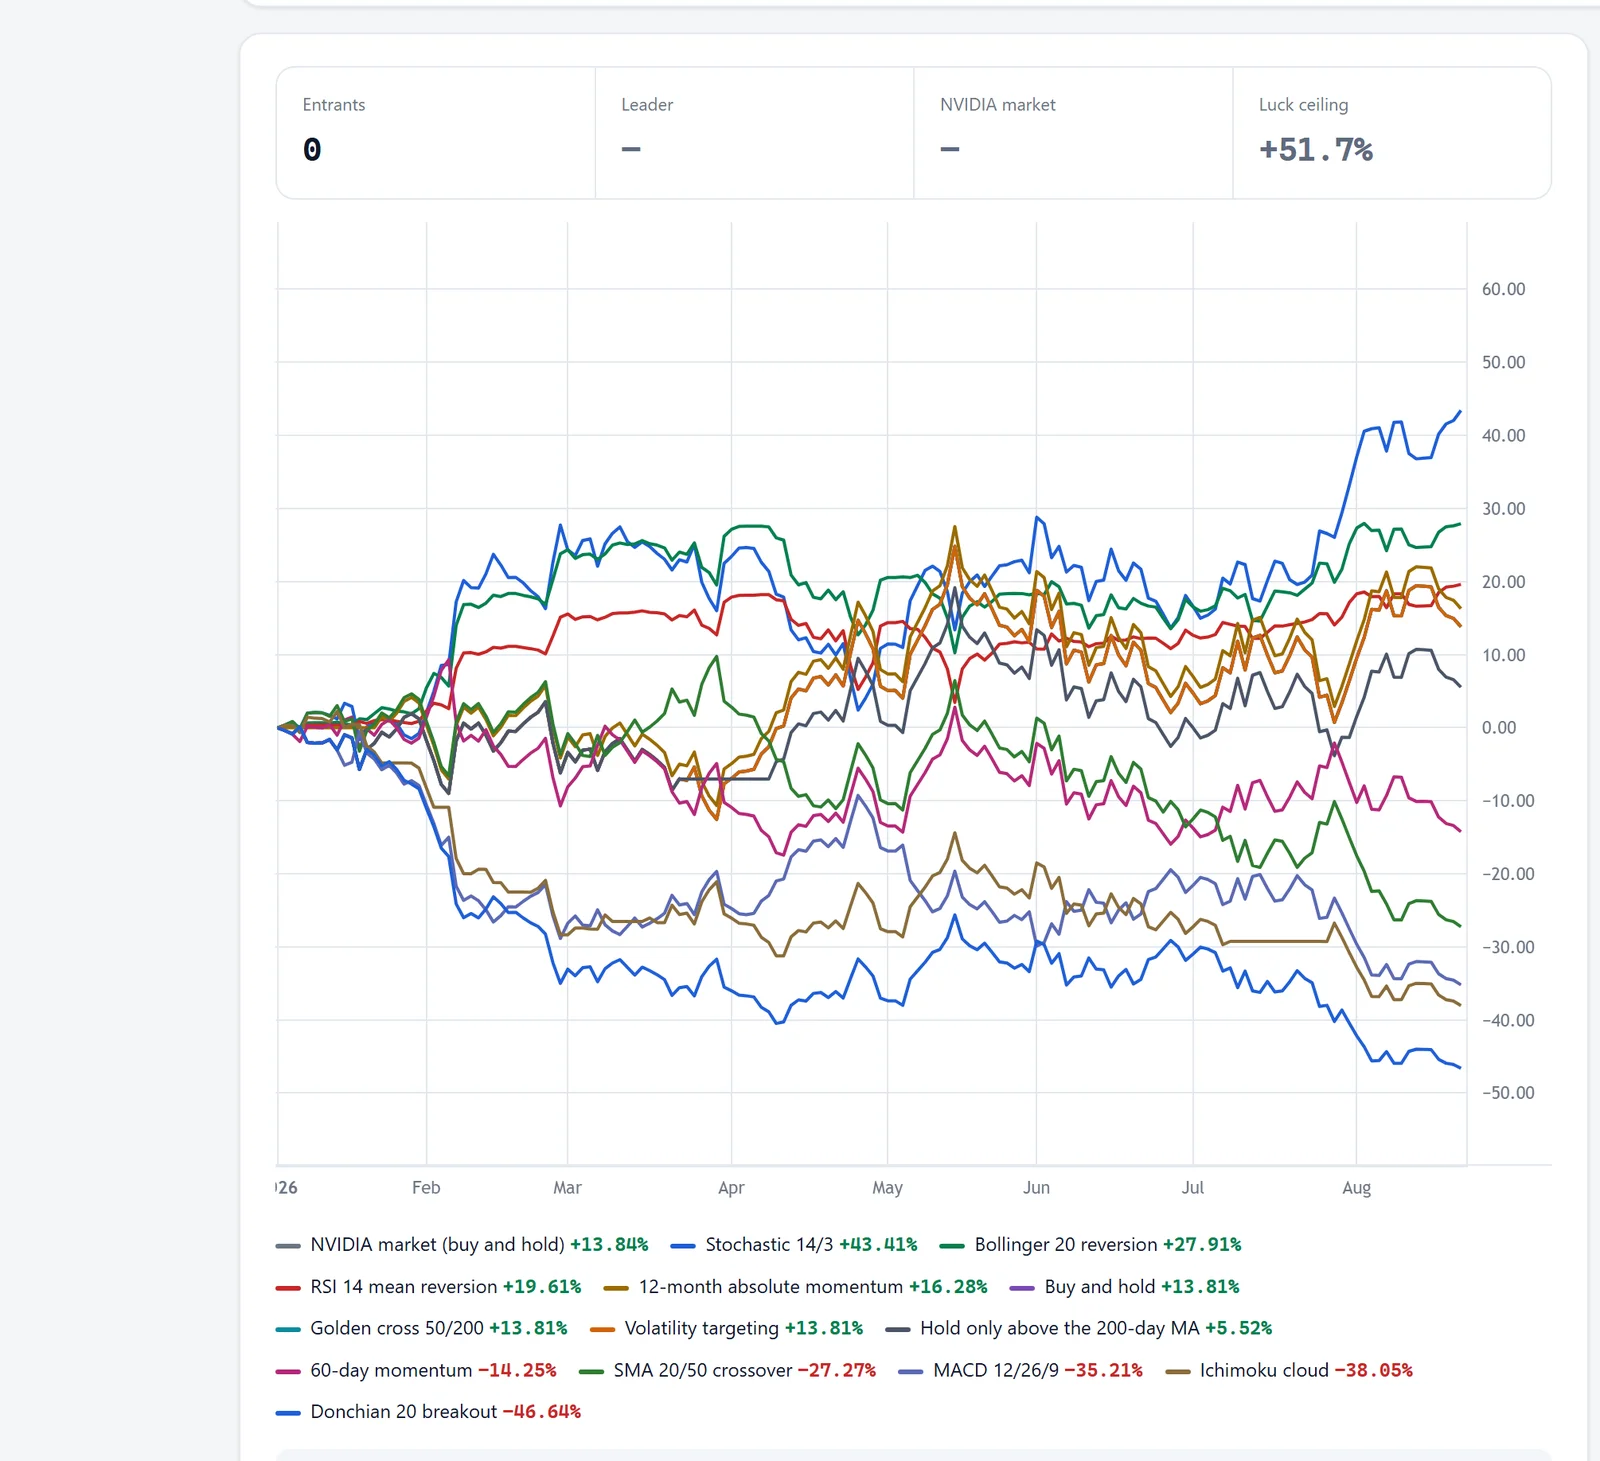
很多 Agent 排行榜也有同样的问题。把写代码、搜网页、做表格、看图片、长任务恢复压成一个总分,最后那 0.7 分到底来自哪里,没人说得清。模型可能在低噪声任务上刷满,在真正难的长任务上掉光,平均数仍然挺漂亮。
该拆就拆。
同类任务内部用分位数比较,跨任务保留独立维度。成功率旁边放成本、耗时、重试次数和副作用。别让一次昂贵的暴力搜索,与一次便宜、稳定、可重复的完成拿同一枚绿勾。
FINCHAL 还用真实成本代替提交次数限制。频繁反转不会被规则禁止,但每次换仓都付费。测试里,每日反转策略付掉了 10.74% 的本金。成本没有告诉参赛者「不许这样做」,只是让刷次数的代价进入结果。
Agent 也该这么测。
循环一百次终于撞对,不能和三次内稳定完成同分。超时后重跑十次,token、沙箱分钟和外部 API 费用都要进账。规则只拦明显危险动作,滥用搜索预算这种行为交给成本函数惩罚,通常比拍脑袋设一个最大步数更接近生产。
把运气上限搬回 Agent 流水线
如果真要把这套思路放进日常开发,我不会先买一套更大的 benchmark,也不会急着把 judge 换成更贵的模型。先从现有评测里挑十个最重要的任务,把「结果」和「能力证据」分开记。
任务成功只是结果。它是不是能力证据,要再看四件事,简单策略能不能做到,换一批种子还能不能做到,评分器有没有被绕过,成本是否落在允许范围。
第一层是两类基线。
一类纯随机,只在合法动作空间里抽样,用来摸清任务噪声。另一类是便宜的简单策略,比如网页表单按 DOM 顺序填,代码修复只做静态检查建议,检索任务固定搜三个关键词。后者不是为了赢 Agent,而是给团队一条最低可交付线。
如果旗舰模型花 30 美元才比启发式高两个点,这个结果可能仍有研究价值,却没有上线价值。反过来,简单模型配一套更稳的工具合同,成功率只低一点,成本却少一个数量级,生产选择往往已经很清楚。
第二层是把答案放到提交之后。
代码任务可以用合并后才出现的新 issue,客服 Agent 可以用下一周真实到达、经过脱敏的工单,数据 Agent 可以用尚未冻结的下一个结算周期。没条件使用未来数据,也至少要把最终验收集锁起来,让调 prompt、选工具和改路由的人看不到答案。
公开 benchmark 当然还要跑,但它更像体检里的参考区间,不该是唯一诊断。模型与数据都在网上流动,今天的隐藏集,明天可能就出现在训练语料、论坛答案或某个缓存里。分数越接近满分,越要怀疑测试已经失去区分度。
第三层是给评分器做变异测试。
不要只喂正确答案和错误答案。故意造几份「看起来成功」的产物,比如文件生成了但内容为空,页面显示提交成功但数据库没写入,测试通过但进程还在后台跑,引用链接存在但指向错文档。评分器如果把这些全判绿,就跟 FINCHAL 那个写着小时线、里面装着日线的接口没区别。
对 LLM judge 也一样。把答案顺序调换,把冗长废话塞进去,把同一事实换个语气,再看分数是否乱飘。judge 不是只测一次准确率就毕业,它得经历对抗样本、版本升级和回归门禁。
第四层是保存完整轨迹,不只保存最终答案。
每次运行至少留下模型版本、prompt 与 Skill 版本、输入快照、工具调用、重试原因、费用、耗时、评分器版本和最终业务证据。这样分数突然涨了,团队才能判断是模型变强、数据变简单、重试变多,还是评分器刚好漏了一道检查。
FINCHAL 保存所有参赛者的好日子和坏日子,也是这个道理。只展示成功案例,等于把失败样本从分母里删掉。Agent 演示视频最擅长这一手,一镜到底两分钟,背后失败了多少次没人知道。
最后再给上线门槛留一点缓冲。不要让平均分刚越线就自动放量。可以要求 Agent 同时超过随机上沿与简单基线,在多个种子上稳定,关键副作用为零,成本处在预算内,再从影子流量走到小比例真实流量。
这套流程不性感,甚至有点笨。
可生产系统里,笨办法经常比一条漂亮曲线可靠。它至少能回答,Agent 这次究竟学会了,还是只赶上了一阵顺风。
坦率讲,我不确定 122 天后会不会真有 Agent 越过每类资产的运气上限。市场预测很难,项目自己的 60 个候选变量也没有展示短周期方向预测力。公开代码和项目页面至少让评分方式可以被检查,这比先许诺「AI 战胜市场」靠谱。
但结果还没出来,这个比赛已经给了一份不错的答案。
排行榜不应该只告诉我们谁最高,还得告诉我们随机能多高,尺子有没有歪,答案是不是来自未来,失败有没有被藏起来,成本有没有被算进去。
回到开头那个 80%。
曲线是真的,收益也可以是真的。
只是「能力」这两个字,要等它越过 2 万个随机玩家之后再说。